Apuntes · Capítulo 1De C a C++ y costos
De C a C++
De C a C++
En Introducción a la Programación aprendieron a manejar la memoria a mano y a esconder los detalles de un módulo detrás de un encabezado. También a decidir quién es el owner de cada bloque, es decir, quién debe liberarlo: esa responsabilidad es el ownership. Todo eso sigue valiendo. Este curso lo usa para responder una pregunta práctica: ¿cómo se organizan los datos para que un programa siga siendo rápido cuando los datos crecen?
Vamos a construir las estructuras que las bibliotecas traen hechas, a predecir cuánto cuestan y a medirlas. Lo
haremos en C++, un lenguaje que ustedes todavía no conocen, pero que está hecho sobre C: casi todo lo que saben
sigue igual. Este capítulo enseña lo que cambia, siempre desde lo que ya saben. Vamos a tomar Tally, el tipo
opaco que escribieron en C, y lo vamos a convertir en una clase. Su implementación pasará de 68 líneas a 30, y no
quedará ninguna llamada a malloc ni a free.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): De qué trata el curso, Lo que no cambia desde C y Namespaces.
- En clase: Referencias, De
structcon funciones sueltas a clase,std::string,std::vector,forpor rango yauto, El error común: copiar un vector sin querer y Pruebas:assert, advertencias y sanitizers.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de esta semana y El laboratorio: portar un módulo de C a C++. Opcional: Open Data Structures, secs. 1.1 (The Need for Efficiency) y 1.2 (Interfaces), gratis en https://opendatastructures.org/. El calendario completo y las reglas del curso están en el programa del curso.
Código. Los programas de este capítulo están en
code/week-01. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
De qué trata el curso
Una estructura de datos es una forma de organizar datos en la memoria, junto con las operaciones que se pueden hacer sobre ellos. La misma información admite muchas organizaciones, y la que se elija puede cambiar el tiempo de un programa por órdenes de magnitud. No hablamos de escribir mejor un ciclo, sino de qué ciclo hace falta.
Veamos un ejemplo. Una lista tiene n códigos de estudiantes, y hay que buscar cada uno de los n códigos en ella.
Conocen dos formas de buscar:
algoritmo busqueda_lineal(codigos, n, codigo)
    para i desde 0 hasta n - 1 hacer
        si codigos[i] = codigo entonces
            devolver i
        fin si
    fin para
    devolver -1
fin algoritmo
algoritmo busqueda_binaria(codigos, n, codigo)
bajo ← 0
alto ← n - 1
mientras bajo ≤ alto hacer
medio ← bajo + (alto - bajo) div 2
si codigos[medio] = codigo entonces
devolver medio
sino si codigos[medio] < codigo entonces
bajo ← medio + 1
sino
alto ← medio - 1
fin si
fin mientras
devolver -1
fin algoritmoLa binaria exige que la lista esté ordenada. Ese es justo el punto: organizar los datos de otra forma permite otro
algoritmo. El programa lookup.cpp hace las n búsquedas de las dos formas y cuenta cuántos elementos mira. Contar
comparaciones tiene una ventaja sobre medir tiempo: el resultado es el mismo en cualquier computadora.
$ build/lookup 1000 linear
n = 1000, encontrados = 1000, comparaciones = 500500
$ build/lookup 1000 binary
n = 1000, encontrados = 1000, comparaciones = 8987
Con otros tamaños:
n |
Comparaciones, lineal | Comparaciones, binaria |
|---|---|---|
| 1 000 | 500 500 | 8 987 |
| 10 000 | 50 005 000 | 123 631 |
| 100 000 | 5 000 050 000 | 1 568 946 |
| 1 000 000 | 500 000 500 000 | 18 951 445 |
| 20 000 000 | 200 000 010 000 000 | 466 445 594 |
Las de la búsqueda lineal son exactas por una cuenta simple: para el código en la posición i mira i + 1 elementos, y
1 + 2 + ... + n = n(n + 1) / 2. Las de la binaria salen de correr el programa. Al multiplicar n por 10, la lineal se
multiplica por 100 y la binaria por algo más de 10.
Ahora en segundos. Estos tiempos se midieron con make measure: el programa compilado con -O2, sin sanitizers, tomando
la mediana de 5 corridas, con measure.py. Dependen de la máquina y de lo que esté corriendo a la vez. Lo que importa es
cómo crecen, y eso se repitió igual en las tres veces que lo medimos.
| Búsqueda | n |
Comparaciones | Tiempo |
|---|---|---|---|
| Lineal | 40 000 | 800 020 000 | 0.291 s |
| Lineal | 80 000 | 3 200 040 000 | 1.146 s |
| Binaria | 10 000 000 | 223 222 809 | 0.514 s |
| Binaria | 20 000 000 | 466 445 594 | 1.062 s |
Con 80 000 estudiantes, la búsqueda lineal hace unas 2 800 millones de comparaciones por segundo en esta máquina. A ese
ritmo, sus 200 billones de comparaciones con n = 20 000 000 tomarían unos 71 000 segundos: casi 20 horas. No la corrimos:
es una estimación. La binaria, con la misma n, tardó un segundo, sin contar lo que cuesta ordenar la lista si
no viniera ordenada.
Ese es el curso. Un mismo programa puede tardar un segundo o un día según cómo guarde sus datos.
Idea clave. Primero se pregunta qué operaciones necesita el programa y cuántas veces las hará. Después se elige la estructura. No hay una estructura mejor en general: la lista ordenada busca rápido, pero insertar en ella es caro.
Interfaz e implementación
Una idea atraviesa todo el curso, y ya la conocen de los módulos de C. La interfaz dice qué operaciones hay y qué
hace cada una. La implementación dice cómo se hace. tally.h era una interfaz, y en el curso anterior vieron dos
implementaciones para ella: una que guardaba todos los valores y otra que solo guardaba un resumen.
Quien usa una estructura debería pensar en la interfaz, y quien la elige debe conocer el costo de cada implementación. Por eso aquí construimos las dos cosas. En la semana 2, esta idea tendrá un nombre formal: tipo abstracto de datos.
Cómo está organizado
El curso tiene cuatro partes: de C a C++ y costos, secuencias y ordenamiento, diccionarios, y prioridades y grafos. Cada semana tiene 2 horas de teoría y dos sesiones de laboratorio de 2 horas. Cada laboratorio es un programa real que necesita la estructura de la semana. Hay cuatro prácticas (semanas 4, 7, 11 y 14), un examen parcial y uno final. Los detalles están en el programa del curso.
Lo que no cambia desde C
C++ nació como una extensión de C, y casi todo lo que saben se escribe igual: int, double, char, arreglos, if,
for, while, switch, funciones, punteros, struct, const y encabezados con guardas. Este programa no tiene nada
que no conozcan:
#include <cstdio>

struct point {
    int x;
    int y;
};

int manhattan(const point *p) {
    int dx = p->x < 0 ? -p->x : p->x;
    int dy = p->y < 0 ? -p->y : p->y;
    return dx + dy;
}
El archivo se llama c_style.cpp, y se compila con g++, que es a C++ lo que gcc es a C:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined c_style.cpp -o build/c_style
$ build/c_style
0
7
Las opciones son las de siempre. Solo cambian -std=c++20, que pide el estándar C++20 que usa este curso, y la extensión
.cpp de los archivos. Compilar y enlazar es igual: cada .cpp se compila por separado a un .o, y el enlazador los
une. También son iguales make, gdb, valgrind y los sanitizers:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined -c tally.cpp -o build/tally.o
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined -c tally_demo.cpp -o build/tally_demo.o
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined build/tally.o build/tally_demo.o -o build/tally_demo
$ build/tally_demo
3 valores, suma 40, mayor 17
Lo mismo con el modelo de memoria: pila, heap, marcos, tiempo de vida, ownership, comportamiento indefinido. Nada de eso es distinto. C++ agrega herramientas para que varias de esas reglas las revise el compilador en vez de ustedes.
Diferencias pequeñas
C++ no es exactamente un superconjunto de C. Estas diferencias aparecen desde el primer día:
| En C | En C++ | Por qué importa |
|---|---|---|
#include <stdio.h> |
#include <cstdio> |
Los encabezados de C llevan una c adelante y no llevan .h. Sus nombres están en std::: std::printf. |
int o stdbool.h para verdad |
bool, true, false |
Son parte del lenguaje, sin encabezado. |
NULL |
nullptr |
Un puntero nulo con tipo propio. Es el único que usamos. |
struct point p; |
point p; |
El nombre del struct ya es un tipo. No hace falta typedef. |
int main(void) |
int main() |
Los paréntesis vacíos ya significan “sin parámetros”. |
(double) x |
static_cast<double>(x) |
Una conversión explícita, y más fácil de buscar. |
void * se convierte solo |
Hay que convertirlo | Ver el error de abajo. |
El programa small_changes.cpp muestra varias de ellas. Fíjense en la división, que funciona igual que en C:
std::cout << total / count << "\n";
std::cout << static_cast<double>(total) / count << "\n";
$ build/small_changes
1 0
1
14
14.5Al imprimir un bool sale 1 o 0. Dos enteros se dividen como enteros: 29 / 2 es 14. Para obtener 14.5 hay que
convertir uno de los dos antes de dividir.
La diferencia que más se nota al traer código de C es esta. En C, void * se convierte solo a cualquier puntero. En C++ no:
int *block = std::malloc(4 * sizeof *block);$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/malloc_no_cast.cpp -o build/malloc_no_cast
errors/malloc_no_cast.cpp: In function 'int main()':
errors/malloc_no_cast.cpp:5:29: error: invalid conversion from 'void*' to 'int*' [-fpermissive]No hace falta arreglarlo, porque en este curso no se usa malloc: esta semana no se reserva memoria a mano, y desde la semana 2 se
usará new dentro de las clases. El punto es otro: C++ es más estricto con los tipos, y es a propósito.
También hay palabras reservadas nuevas. Un programa en C puede tener una variable llamada class o new; uno en C++, no
(errors/keyword_name.cpp).
Imprimir con std::cout
printf sigue funcionando, pero en C++ normalmente se escribe así:
#include <iostream>

int main() {
    int students = 32;
    std::cout << "Hola, Estructuras de Datos\n";
    std::cout << "Somos " << students << " estudiantes\n";
    return 0;
}
$ build/hello
Hola, Estructuras de Datos
Somos 32 estudiantesstd::cout es la salida estándar, lo que en C era stdout, y << le manda un valor. Se pueden encadenar varios. No hay
%d ni %s: el compilador conoce el tipo de cada valor y sabe cómo escribirlo. En C, un %d con un double compilaba, con
suerte con una advertencia, y daba basura. Aquí ese error no se puede cometer.
Para los errores se usa std::cerr, lo que en C era stderr. Para leer se usa std::cin >> variable, que se salta los
espacios y deja de leer al encontrar el siguiente. Esa expresión sirve también como condición: while (std::cin >> value)
sigue mientras haya algo que leer.
Namespaces
En C, todos los nombres de un programa comparten un solo espacio. Por eso sus módulos usaban prefijos, como tally_add y
image_new: si dos módulos tenían un add, el programa no enlazaba.
Un namespace es esa misma idea, hecha parte del lenguaje:
namespace circle {
double area(double radius) {
    return 3.14159 * radius * radius;
}
}  // namespace circle

namespace square {
double area(double side) {
    return side * side;
}
}  // namespace square

int main() {
    std::cout << circle::area(2.0) << "\n";
    std::cout << square::area(2.0) << "\n";
    return 0;
}
$ build/namespaces
12.5664
4Las dos funciones se llaman area, y no chocan: sus nombres completos son circle::area y square::area. El operador ::
se llama operador de alcance. La biblioteca estándar de C++ pone todo en el espacio std, y de ahí std::cout,
std::string y std::vector.
Verán en muchos ejemplos de internet una línea que parece ahorrar trabajo:
using namespace std;Trae todos los nombres de std al alcance actual. Son miles, y ustedes no los conocen todos. Este programa es correcto a simple
vista, y usa un nombre muy razonable para su contador:
using namespace std;

int count = 0;

int main() {
    vector<int> values = {1, 2, 3};
    for (int value : values) {
        count += value;
    }
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/using_std_collision.cpp -o build/using_std_collision
errors/using_std_collision.cpp: In function 'int main()':
errors/using_std_collision.cpp:13:9: error: reference to 'count' is ambiguous
13 | count += value;
| ^~~~~
...
errors/using_std_collision.cpp:8:5: note: 'int count'<algorithm> declara una función std::count, y el compilador ya no sabe cuál de las dos pidieron. El programa podría compilar
hoy y romperse mañana, cuando una versión nueva de la biblioteca agregue un nombre. Y en un encabezado es peor: el problema se
contagia a todo archivo que lo incluya.
En C++. En este curso siempre se escribe
std::y nuncausing namespace std. Cuesta cinco letras, y al leer se ve de dónde viene cada nombre.
Referencias
Empecemos por algo que les costó varias semanas de punteros: una función que intercambia dos variables.
void swap_pointer(int *a, int *b) {
    int saved = *a;
    *a = *b;
    *b = saved;
}

void swap_reference(int& a, int& b) {
    int saved = a;
    a = b;
    b = saved;
}
Las dos hacen lo mismo. La primera recibe direcciones y las sigue con *; quien llama debe escribir
swap_pointer(&x, &y). La segunda recibe referencias, y se llama con swap_reference(x, y). No hay & al llamar, ni *
adentro.
$ build/swap_both
2 1
1 2
Definición. Una referencia (reference) es otro nombre para un objeto que ya existe. La declaración int& alias = grade;
no crea otro entero: desde ahí, alias y grade nombran el mismo. Todo lo que se haga con uno se hace con el otro.
En el modelo de entornos, una referencia se dibuja como otro nombre pegado a la misma casilla. Así corre swap_reference(x, y), con x = 2 e y = 1 al entrar:
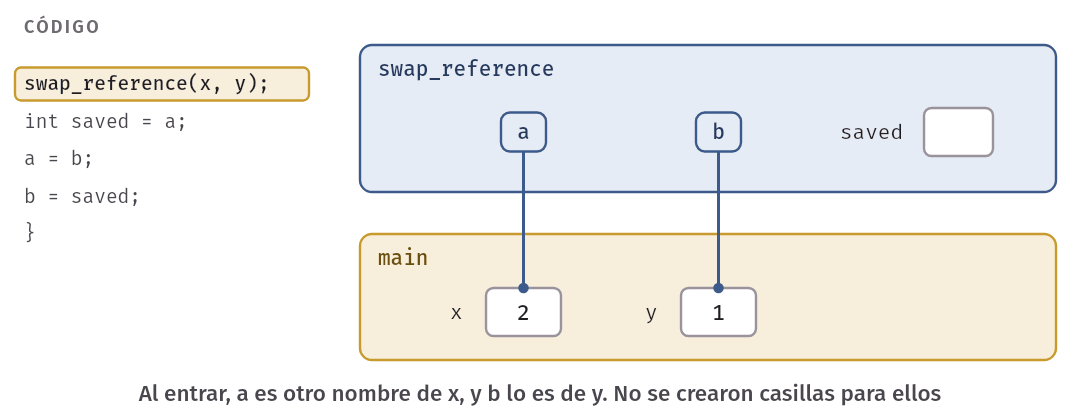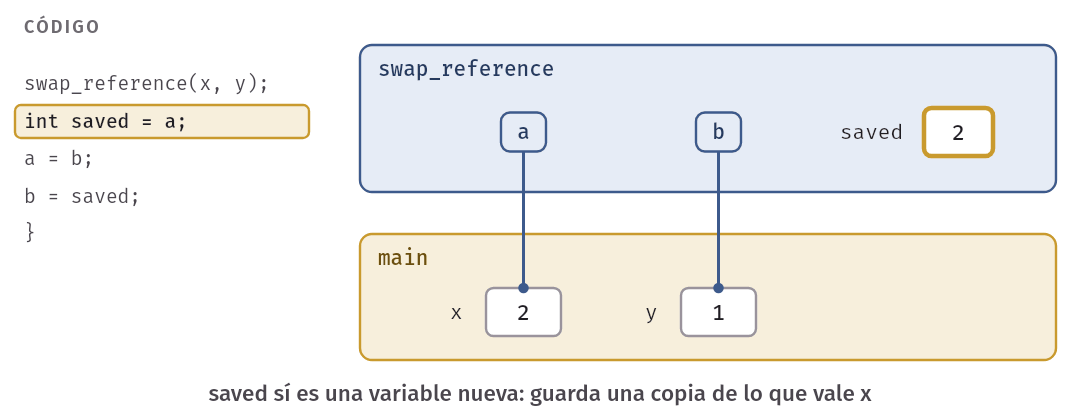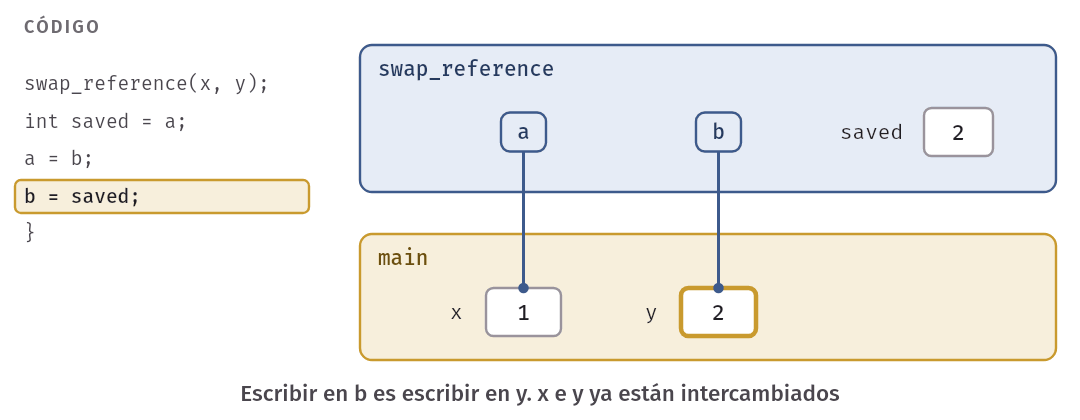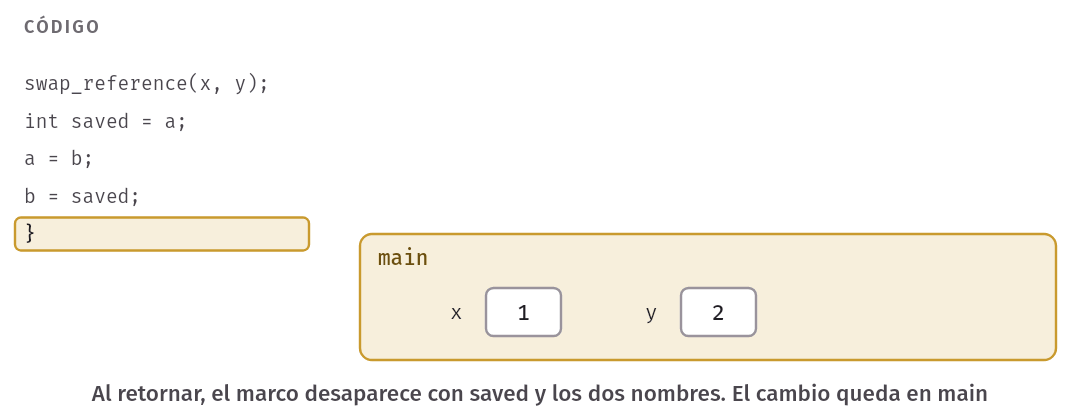
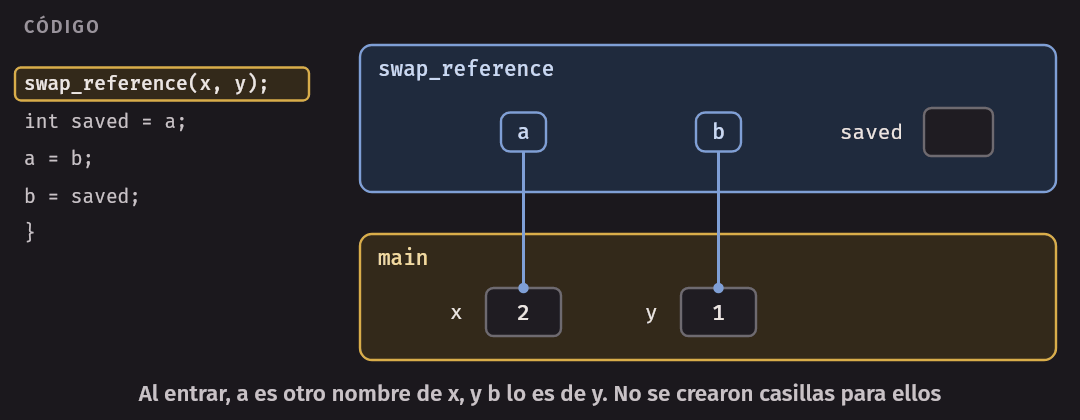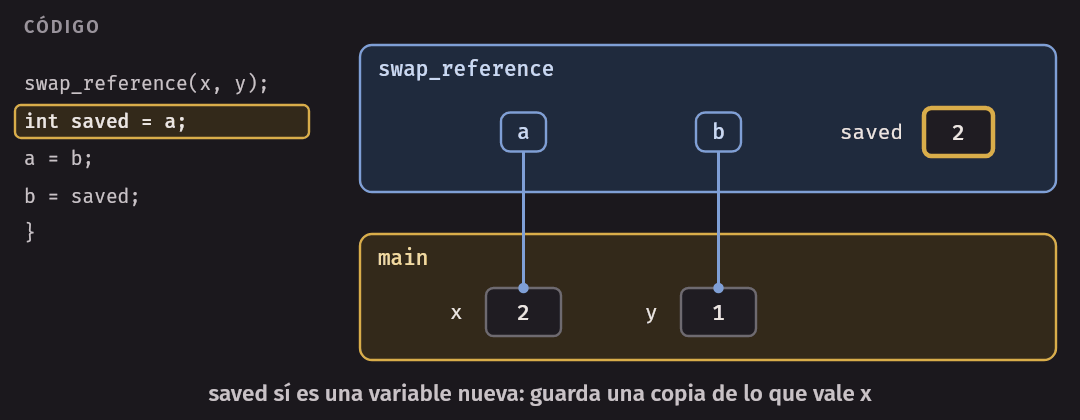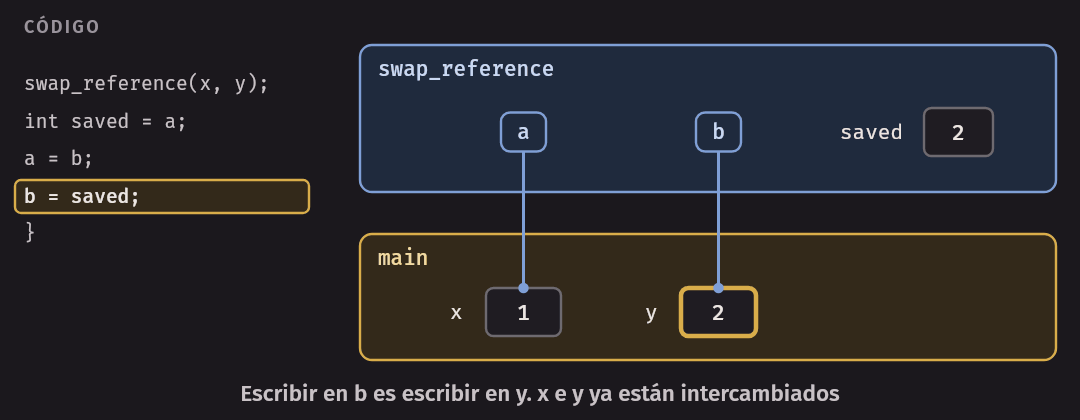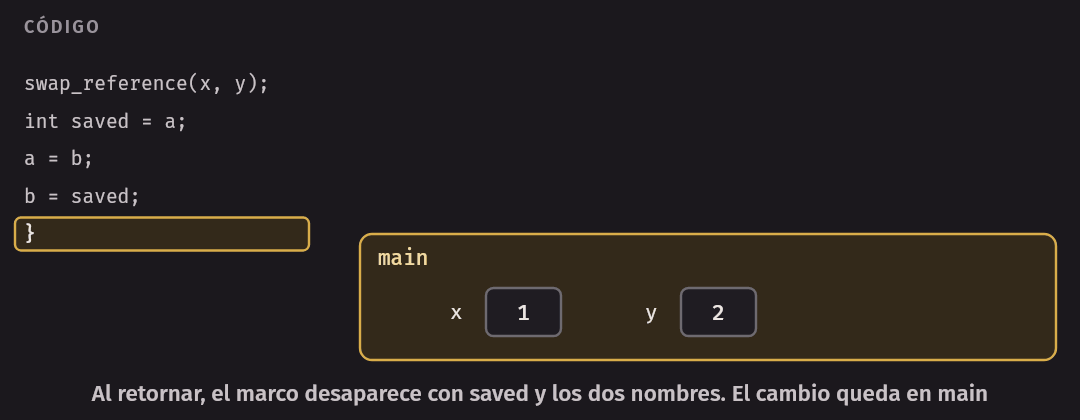
a y b no tienen un valor propio. Son nombres de x y de y.
En C++. El
&tiene dos significados según dónde esté. En un tipo,int& r, declara una referencia. En una expresión,&x, sigue siendo la dirección dex, igual que en C. Este curso escribe el&pegado al tipo:int& r.
En qué se parecen y en qué no
Internamente, un compilador suele implementar una referencia como una dirección. Por eso se parecen tanto. Pero el lenguaje les da reglas distintas:
Puntero int *p |
Referencia int& r |
|
|---|---|---|
| ¿Es un objeto con su propia dirección? | Sí | No: &r da la dirección del objeto al que se refiere |
| ¿Debe iniciarse al declararse? | No | Sí |
| ¿Puede ser nulo? | Sí, nullptr |
No en un programa válido |
| ¿Puede cambiar a qué se refiere? | Sí, p = &y |
No: r = y asigna a lo referido |
| ¿Tiene aritmética? | Sí, p + 1 |
No |
| ¿Cómo se usa? | *p, p->campo |
r, r.campo |
Las reglas de iniciar y de no cambiar son las que más importan. La primera la revisa el compilador:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/ref_uninitialized.cpp -o build/ref_uninitialized
errors/ref_uninitialized.cpp:3:10: error: 'alias' declared as reference but not initialized
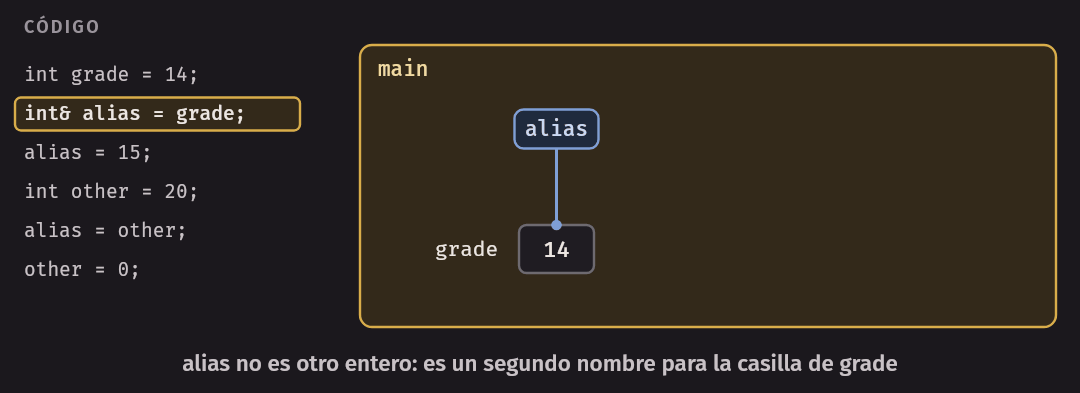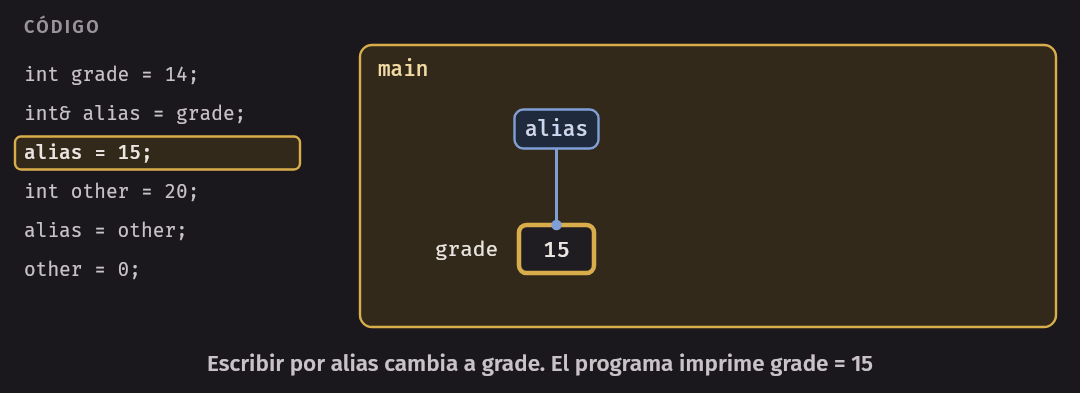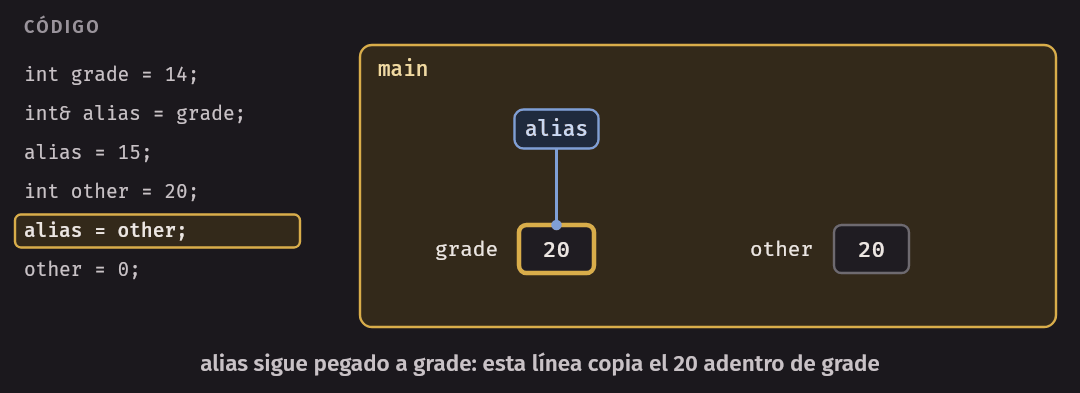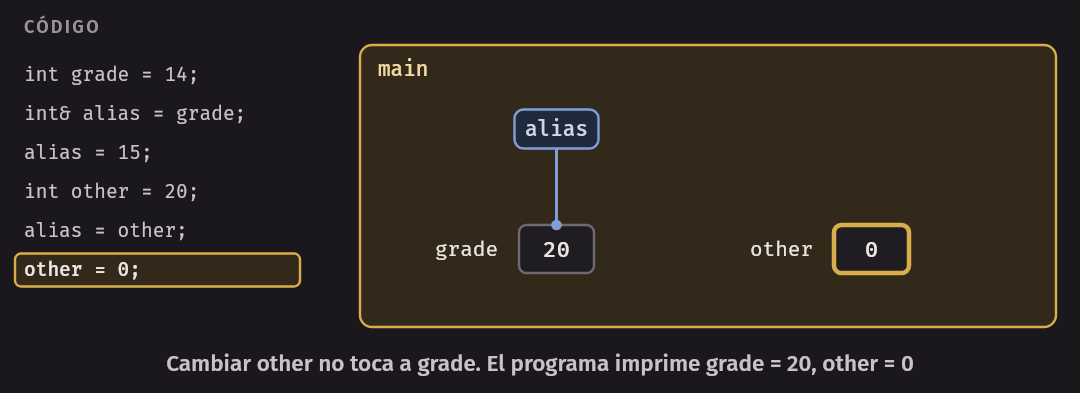
La segunda sorprende al leer código. ¿Qué hace alias = other?
int grade = 14;
int& alias = grade;

alias = 15;
std::cout << "grade = " << grade << "\n";
std::cout << "misma dirección: " << (&alias == &grade) << "\n";

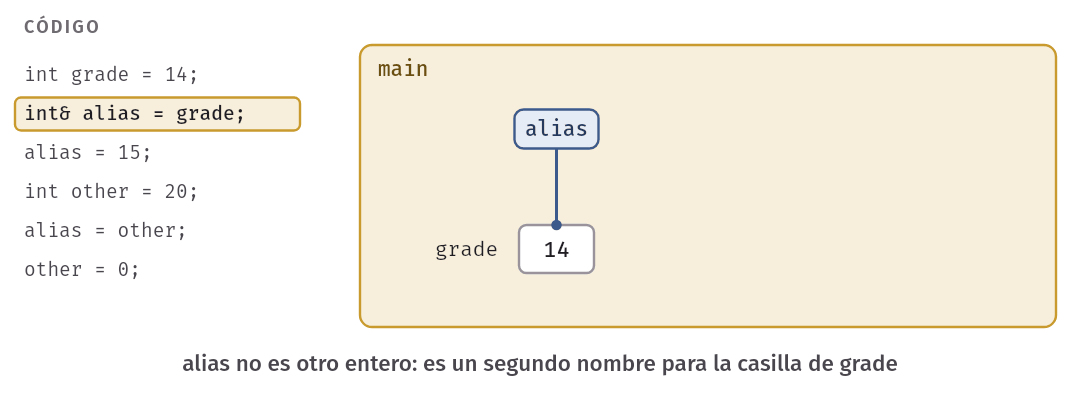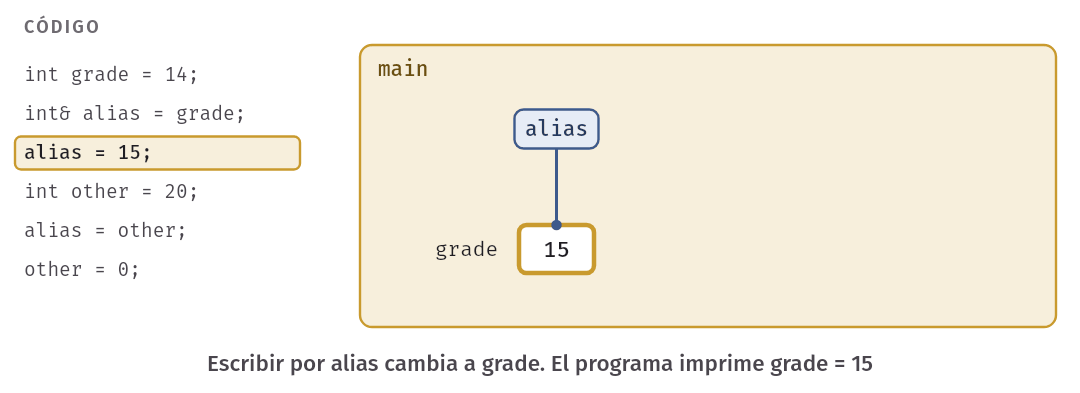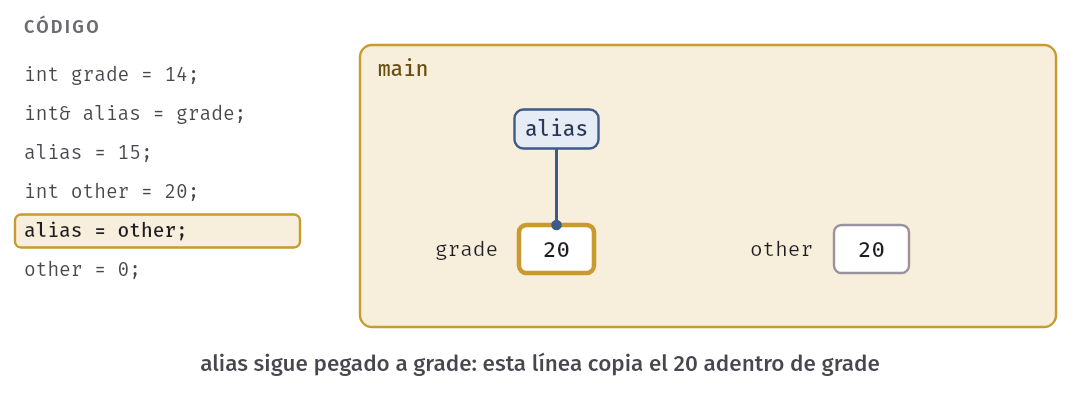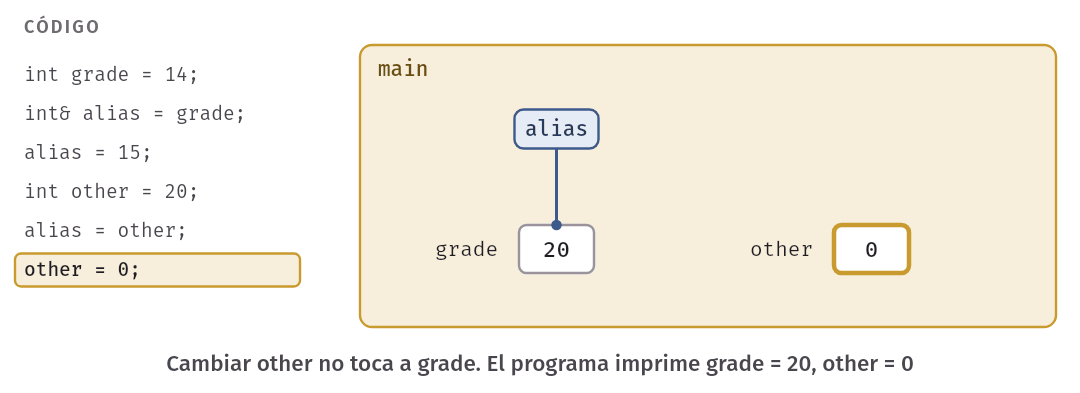
// Esto no cambia a quién se refiere alias: copia 20 dentro de grade.
int other = 20;
alias = other;
other = 0;
std::cout << "grade = " << grade << ", other = " << other << "\n";
$ build/reference_basics
grade = 15
misma dirección: 1
grade = 20, other = 0Después de alias = other, alias sigue siendo otro nombre de grade. Por eso grade recibió el 20, y por eso cambiar
other a 0 después no le hizo nada.
Una referencia no puede ser nula, pero sí puede quedar colgando
En un programa válido, una referencia siempre se ata a un objeto al crearse. No hay forma de pedir una referencia “a nada”, y
por eso una función que recibe int& no tiene que revisar si es nula. Eso es una ventaja real sobre un puntero. Escribir
int& r = *p con p nulo no crea una “referencia nula”: seguir ese puntero ya es comportamiento indefinido.
Lo que sí puede pasar es que el objeto muera antes que la referencia. Queda una referencia colgante (dangling reference), el mismo problema que el puntero colgante:
int& next_code(int code) {
    int result = code + 1;
    return result;
}
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/return_local_ref.cpp -o build/return_local_ref
errors/return_local_ref.cpp: In function 'int& next_code(int)':
errors/return_local_ref.cpp:6:12: warning: reference to local variable 'result' returned [-Wreturn-local-addr]
6 | return result;
| ^~~~~~
errors/return_local_ref.cpp:5:9: note: declared here
5 | int result = code + 1;
| ^~~~~~result vive en el marco de next_code, y ese marco desaparece al retornar. El compilador avisa, y por eso compilamos siempre con
-Wall. Si el programa se corre igual, el resultado es comportamiento indefinido, sin que importe lo que salga. g++ no
detecta todos los casos, sobre todo cuando el objeto muere de una forma más indirecta.
Error común. Devolver una referencia a una variable local. Una función puede devolver una referencia a algo que sobreviva a la llamada, como un campo del objeto o un elemento de un
std::vectorque recibió por referencia. A una local, nunca: en ese caso, devuelvan por valor.
Referencias constantes
Igual que en C existe const int *p, en C++ existe const int& r: una referencia a través de la cual no se puede escribir.
void reset(const int& value) {
    value = 0;
}
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/const_ref_write.cpp -o build/const_ref_write
errors/const_ref_write.cpp:3:11: error: assignment of read-only reference 'value'const es una promesa de esa vista, no del objeto. El objeto puede cambiar por otro camino, y la referencia lo verá. Las
formas de const se leen de derecha a izquierda:
const int *to_const = &a;    // no se puede escribir *to_const
to_const = &b;               // sí se puede cambiar el puntero
int *const fixed = &a;       // no se puede cambiar el puntero
*fixed = 5;                  // sí se puede escribir a través de él
const int& view = a;         // no se puede escribir a través de view
a = 7;                       // a sí cambia, y view lo ve
$ build/const_forms
2 7 7
3La primera línea de la salida imprime *to_const, *fixed y view. El 2 es porque to_const terminó apuntando a b. Los otros
dos son a, que terminó en 7. La segunda línea sale de la función que viene.
Una referencia sin const no se puede atar a un valor temporal, como el resultado de una expresión o un literal. Una con const,
sí. Por eso una función que recibe const std::string& acepta una literal:
std::size_t count_letter(const std::string& text, char letter) {std::cout << count_letter("banana", 'a') << "\n";Para hacer esa llamada, el compilador crea una std::string temporal con "banana" y ata text a ella. La temporal vive hasta que
termina la expresión de la llamada. Si el parámetro fuera std::string&, sin const, la función podría modificar una temporal que
nadie verá, y C++ lo prohíbe:
std::size_t length(std::string& text) {$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/ref_to_temporary.cpp -o build/ref_to_temporary
errors/ref_to_temporary.cpp:10:36: error: cannot bind non-const lvalue reference of type 'std::string&' {aka 'std::__cxx11::basic_string<char>&'} to an rvalue of type 'std::string' {aka 'std::__cxx11::basic_string<char>'}Un lvalue es algo con nombre y lugar en la memoria; un rvalue, un valor temporal. Los verán más en la semana 2. Por
ahora: el mensaje dice que intentaron atar una referencia sin const a una temporal.
Cómo pasar un argumento
Con referencias hay más formas de pasar un argumento que en C, y hay una regla simple para elegir:
| Qué necesita la función | Cómo se declara | Ejemplo |
|---|---|---|
| Leer un valor pequeño | Por valor | int grade, double x, char c |
| Leer algo que puede ser grande | Por referencia constante | const std::string& name, const std::vector<int>& values |
| Modificar lo que le pasan | Por referencia | std::vector<int>& values |
| Quedarse con su propia copia para cambiarla | Por valor | std::string text, si va a modificarla por dentro |
| Recibir algo que puede faltar | Por puntero, y revisar nullptr |
const Node *node |
Una referencia no ahorra nada con un int: un int cabe en un registro, y copiarlo es tan barato como copiar una dirección. Con
una std::string o un std::vector, en cambio, la diferencia es enorme, como veremos.
Idea clave. Por defecto: los tipos pequeños, por valor. Lo demás,
const&. Si van a modificar el argumento,&, y que se note en el nombre de la función.
De struct con funciones sueltas a clase
Ahora la parte central del capítulo. Recuerden el módulo Tally de C. Quien lo usa ve esto:
typedef struct tally Tally;

// Crea un acumulador vacío. Devuelve NULL si no hay memoria.
// Owner: quien llama, que debe liberarlo con tally_free.
Tally *tally_new(void);

// Libera el acumulador. Acepta NULL. Después de esto, tally ya no se puede usar.
void tally_free(Tally *tally);

// Agrega un valor. Devuelve 1 si pudo y 0 si no hay memoria; en ese caso, no cambia nada.
int tally_add(Tally *tally, int value);

// Devuelve cuántos valores se agregaron.
int tally_count(const Tally *tally);
Y lo usa así:
Tally *tally = tally_new();
if (tally == NULL) {
    return 1;
}
int ok = tally_add(tally, 14) && tally_add(tally, 9) && tally_add(tally, 17);
if (!ok) {
    tally_free(tally);
    return 1;
}
printf("%d valores, suma %d, mayor %d\n", tally_count(tally), tally_sum(tally), tally_max(tally));
tally_free(tally);
El diseño es bueno, pero miren lo que cuesta: el prefijo tally_ en cada función, el tally como primer parámetro en cada llamada,
revisar NULL, y acordarse de liberar en cada salida. Y esconder los campos obliga a guardar el struct en el heap, porque quien
usa el tipo no sabe cuánto mide. En C++, todo eso lo resuelve una clase:
class Tally {
public:
    // Agrega un valor.
    void add(int value);

    // Devuelve cuántos valores se agregaron.
    std::size_t count() const;

    // Devuelve la suma de los valores. Con cero valores, es 0.
    int sum() const;

    // Devuelve el mayor valor. Exige: count() > 0.
    int max() const;

private:
    std::vector<int> values_;
};
Tally tally;
tally.add(14);
tally.add(9);
tally.add(17);
std::cout << tally.count() << " valores, suma " << tally.sum() << ", mayor " << tally.max() << "\n";$ build/tally_c_demo
3 valores, suma 40, mayor 17
$ build/tally_demo
3 valores, suma 40, mayor 17El comportamiento es idéntico. Vamos pieza por pieza.
Métodos
Definición. Una clase (class) es un tipo que junta datos con las funciones que trabajan sobre ellos. A esas funciones se les llama métodos, y a los datos, campos. Un valor de ese tipo es un objeto.
Un método es una función que recibe, sin que se escriba, un parámetro más: el objeto sobre el que se llama. La traducción es directa:
| C | C++ |
|---|---|
int tally_add(Tally *tally, int value) |
void Tally::add(int value) |
tally_add(tally, 14); |
tally.add(14); |
tally->values adentro de la función |
values_ adentro del método |
Adentro de un método, los campos se nombran directamente. El parámetro oculto se llama this, y es un puntero al objeto. Pocas veces
hace falta escribirlo, pero sirve saber que está ahí: la llamada tally.add(14) funciona como si fuera Tally::add(&tally, 14).
Los nombres de los campos terminan en _. Es una convención de este curso, para distinguirlos de las variables locales y
parámetros de un vistazo.
Público y privado
public: marca lo que cualquiera puede usar, y private: lo que solo pueden usar los métodos de la clase. El compilador lo revisa:
tally.values_.clear();$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/private_access.cpp -o build/private_access
errors/private_access.cpp: In function 'int main()':
errors/private_access.cpp:6:11: error: 'std::vector<int> Tally::values_' is private within this context
6 | tally.values_.clear();
| ^~~~~~~
In file included from errors/private_access.cpp:2:
errors/../tally.h:23:22: note: declared private here
23 | std::vector<int> values_;
| ^~~~~~~En C++.
classystructson la misma cosa, con una sola diferencia que nos importa: enclass, lo que no tiene marca es privado; enstruct, público. La convención del curso:classsi hay algo que proteger, ystructsi solo agrupa datos a la vista, comoScoremás adelante.
private funciona por clase, no por objeto: un método puede ver los campos privados de otro objeto de la misma clase.
// private es por clase: este método puede ver los campos de other.
bool same_credits_as(const Course& other) const {
    return credits_ == other.credits_;
}
private y el tipo opaco
¿Qué parte del tipo opaco de C reemplaza private? La parte de que nadie afuera pueda tocar los campos. Pero lo logra de otra
forma, y eso tiene consecuencias.
Con un tipo opaco, los campos ni siquiera se ven en el encabezado. El compilador, al compilar quien usa el módulo, no los conoce.
Con private, los campos están escritos en el encabezado. El compilador sí los conoce, y prohíbe usarlos. Es control de acceso,
no ocultamiento:
| Tipo opaco en C | Clase con private |
|
|---|---|---|
| ¿Quien usa el tipo ve los campos en el encabezado? | No | Sí, los puede leer |
| ¿Puede usarlos? | No: el compilador no los conoce | No: el compilador lo prohíbe |
| ¿El compilador conoce su tamaño afuera? | No | Sí |
| ¿Se puede declarar una variable local del tipo? | No, solo punteros | Sí |
| ¿Dónde vive el objeto? | Lo decide el módulo: en la práctica, en el heap | Donde quien lo usa decida |
| Si cambian los campos, ¿qué se recompila? | Solo el .c del módulo |
Todo lo que incluya el encabezado |
Como el compilador conoce el tamaño, este programa, que en C daba error con un tipo opaco, ahora funciona:
Tally local;
local.add(4);
std::cout << "sizeof(Tally) = " << sizeof(Tally) << "\n";
std::cout << "cuenta = " << local.count() << "\n";
$ build/sizes
sizeof(Tally) = 24
cuenta = 1El 24 depende del sistema y de la biblioteca: son los bytes del std::vector en el objeto, no los de los valores, que están en un
bloque aparte. La variable local vive en la pila, sin malloc para el objeto. Eso importa para este curso, porque guardar un objeto
directamente, sin un puntero de por medio, ahorra memoria y tiempo.
El precio es la última fila de la tabla: al cambiar los campos, hay que recompilar a quienes usan la clase. Y private no
protege contra alguien decidido a saltárselo. Es una regla para el compilador, no una medida de seguridad.
Constructores
En C, tally_new dejaba el objeto listo. En C++, de eso se encarga el constructor (constructor): un método sin tipo de retorno,
con el nombre de la clase, que corre automáticamente al crear el objeto.
class Course {
public:
    Course(const std::string& name, int credits) : name_(name), credits_(credits) {
        assert(credits > 0);
    }

    void enroll() {
        enrolled_++;
    }
La parte después de : es la lista de inicialización: inicia cada campo con su valor, antes de entrar a las llaves. Úsenla siempre.
Si no, el campo primero se crea vacío y luego se le asigna, lo que es trabajo doble, y un campo const o una referencia no se
podrían iniciar. Un campo también puede tener un valor por defecto en su declaración:
std::string name_;
int credits_;
int enrolled_ = 0;
$ build/course
Estructuras de Datos: 4 créditos, 2 matriculados
Matemática Discreta: 4 créditos, 0 matriculados
mismos créditos: 1Si una clase no declara ningún constructor, el compilador genera uno sin parámetros, que inicia cada campo con su forma por defecto. Por
eso Tally tally; funciona sin que hayamos escrito nada: values_ queda como un std::vector vacío. Pero un campo int sin valor por
defecto queda con basura, igual que una variable local de C. Por eso enrolled_ lleva = 0.
Si se declara cualquier constructor, el compilador ya no genera el que no recibe nada:
Range(int low, int high) : low_(low), high_(high) {}Range range;$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/no_default_ctor.cpp -o build/no_default_ctor
errors/no_default_ctor.cpp:16:11: error: no matching function for call to 'Range::Range()'Tiene sentido: si un rango necesita sus dos extremos, un rango sin ellos no debe poder existir. Esa es la ventaja de un constructor
frente a tally_new: no existe un objeto sin iniciar. Los campos se inician en el orden en que están declarados, sin importar
el orden de la lista. -Wall lo avisa si no coinciden:
explicit Range(int width) : high_(low_ + width), low_(0) {}$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/init_order.cpp -o build/init_order
errors/init_order.cpp:14:9: warning: 'Range::high_' will be initialized after [-Wreorder]La lista de esa clase escribe high_ primero, pero se declaró primero low_, y ese es el que se inicia primero. Por eso este programa
funciona de casualidad. Con los campos declarados al revés, high_ leería un low_ con basura. Declaren y listen siempre en el mismo orden.
explicit delante de un constructor de un parámetro evita que se use como una conversión automática. Sin él, una función que recibe
Range aceptaría un int. Ese mecanismo, sin explicit, es justo el que convierte "banana" en std::string.
Error común.
Tally tally();no crea un objeto. Por una regla heredada de C, esa línea declara una función que no recibe nada y devuelve unTally. Para crear el objeto con el constructor sin parámetros, se escribeTally tally;, sin paréntesis.
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/vexing_parse.cpp -o build/vexing_parse
errors/vexing_parse.cpp:5:16: warning: empty parentheses were disambiguated as a function declaration [-Wvexing-parse]
errors/vexing_parse.cpp:6:11: error: request for member 'add' in 'tally', which is of non-class type 'Tally()'
Métodos const
En C, una función que solo leía recibía const Tally *. En C++, el parámetro está oculto, así que el const se escribe después de
los paréntesis:
std::size_t count() const;Definición. Un método const (const method) promete no modificar el objeto: adentro, this es un puntero a un objeto constante. El
compilador garantiza dos cosas, y las revisa:
- Adentro de un método
constno se puede modificar un campo, ni llamar a un método que no seaconst. - Sobre un objeto
const, o a través de una referenciaconst, solo se pueden llamar métodosconst.
int next() const {
    value_++;
    return value_;
}
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/const_method_writes.cpp -o build/const_method_writes
errors/const_method_writes.cpp:5:9: error: increment of member 'Counter::value_' in read-only objectLa segunda regla es la que hace que todo encaje. Una función que recibe const Tally& solo puede pedirle lo que no cambia el
objeto:
int total_after_add(const Tally& tally) {
    tally.add(1);
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/const_object_call.cpp -o build/const_object_call
errors/const_object_call.cpp:5:14: error: passing 'const Tally' as 'this' argument discards qualifiers [-fpermissive]“Discards qualifiers” significa “le quita el const”. Es el mismo error que le saldrá a quien olvide marcar const un método que
solo lee, en cuanto alguien lo llame sobre un const&. Por eso, todo método que no modifica el objeto se marca const desde el
principio.
¿Qué no garantiza const? Protege los campos del objeto, no lo que hay al otro lado de un puntero. Este método compila, porque no
cambia target_, sino el entero al que target_ apunta:
// Compila: no cambia target_, solo el entero al que apunta.
void reset() const {
    *target_ = 0;
}
$ build/const_shallow
0Hay dos salidas más, que no usamos: los campos mutable y const_cast. Tampoco promete que el objeto no cambie mientras un método const lo mira: otra parte del programa puede tenerlo por una referencia sin
const. Es una promesa de lo que hace ese método, no de lo que hacen los demás. Cuando una clase sea owner de un bloque, en las
próximas semanas, tendrán que cuidar esto ustedes.
Declarar en el .h y definir en el .cpp
Como en C, la interfaz va en el encabezado. La clase entera va ahí, con sus campos privados, porque el compilador necesita conocer el
tamaño. Los cuerpos de los métodos van en el .cpp, con el nombre completo:
void Tally::add(int value) {
    values_.push_back(value);
}

std::size_t Tally::count() const {
    return values_.size();
}

int Tally::sum() const {
    int total = 0;
    for (int value : values_) {
        total += value;
    }
    return total;
}
Tally:: dice de qué clase es el método. El const también va en la definición, porque es parte de su firma. Un método corto también se
puede definir adentro de la clase, como en Course. Los dos estilos son válidos. En el curso, una clase de un archivo
de ejemplo los pone adentro, y un módulo real los separa.
Qué desapareció
Compárenlo con la versión en C:
C (tally_c/) |
C++ | |
|---|---|---|
| Líneas de la implementación | 68 (tally.c) |
30 (tally.cpp) |
| Líneas del encabezado | 27 | 26 |
| Líneas del programa que lo usa | 19 | 13 |
Llamadas a malloc, realloc y free en el módulo |
4 | 0 |
| Chequeos de memoria al usarlo | 2 | 0 |
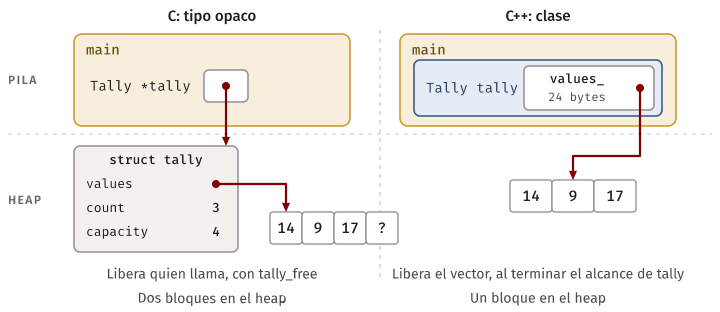
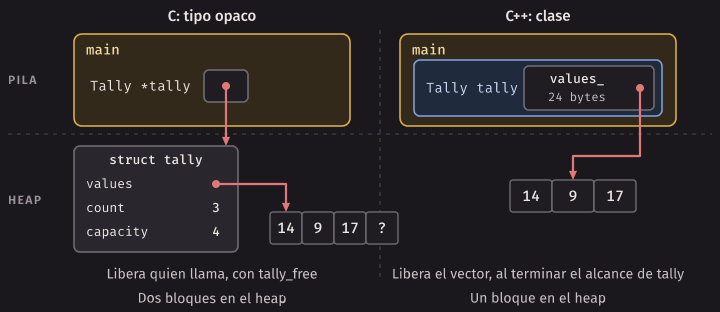
¿Dónde quedó la memoria? Sigue ahí: values_ guarda sus enteros en un bloque del heap. Pero ahora el owner de ese bloque es el std::vector, y
el std::vector es un campo de Tally. Cuando el objeto tally deja de existir, al final de su alcance, su std::vector libera el bloque.
ASan lo confirma: tally_demo corre con sanitizers y no reporta ninguna fuga. La semana 2 explica cómo lo hace, porque es el corazón de C++.
¿Y si no hay memoria? push_back no devuelve NULL: lanza una excepción, un mecanismo para reportar errores que veremos más adelante.
Si nadie la atrapa, el programa termina. Para lo que hacemos aquí, eso es razonable.
Idea clave. Un objeto de C++ se comporta como un valor de C: se declara, se usa y deja de existir. Quien usa la clase no piensa en memoria.
std::string
En C, una cadena era un arreglo de char terminado en '\0', y cada operación pasaba por decidir quién reserva y quién libera.
std::string es una clase de la biblioteca (#include <string>) que es owner de sus caracteres.
std::string first = "Ana";
std::string full = first + " Quispe";
std::string copy = full;
copy[0] = 'E';

std::cout << full << " / " << copy << "\n";
std::cout << "largo: " << full.size() << "\n";
std::cout << "iguales: " << (full == copy) << "\n";
std::cout << "ordenadas: " << (full < copy) << "\n";

std::size_t space = full.find(' ');
std::cout << "apellido: " << full.substr(space + 1) << "\n";
if (full.find('z') == std::string::npos) {
    std::cout << "no hay z\n";
}

full += ", sección A";
std::cout << full << "\n";

// Para una función de C que pide const char *.
std::printf("%s\n", first.c_str());
$ build/strings
Ana Quispe / Ena Quispe
largo: 10
iguales: 0
ordenadas: 1
apellido: Quispe
no hay z
Ana Quispe, sección A
AnaLa traducción desde C:
| En C | Con std::string |
|---|---|
strlen(s) |
s.size(). No recorre: la cadena guarda su tamaño |
strcpy(a, b) |
a = b. Reserva lo que haga falta |
strcat(a, b) |
a += b, o a + b para una nueva |
strcmp(a, b) == 0 |
a == b |
strcmp(a, b) < 0 |
a < b, en orden de bytes |
strchr, strstr |
s.find(...), que devuelve std::string::npos si no está |
Copiar un pedazo con malloc |
s.substr(inicio, largo) |
s[i] |
s[i], sin revisar el índice |
Fíjense en lo que ya no puede pasar. copy = full crea otra cadena, con sus propios caracteres: cambiar copy[0] no tocó full. Con
char *, una asignación copiaba el puntero, y dos nombres apuntaban al mismo bloque. Con == se comparan los caracteres; con char *, se
comparaban las direcciones. Y nunca se escribió un tamaño ni un free.
full.size() devuelve 10 en "Ana Quispe", sin contar ningún '\0'. Cuenta bytes, no letras: "sección" tiene 7 letras y 8
bytes en UTF-8, porque la ó ocupa dos. Lo aprendieron en cadenas de C, y sigue siendo cierto.
Para pasar una std::string a una función de C que espera const char *, se usa c_str(). El puntero que devuelve sigue siendo de la
cadena: no se libera, y deja de servir si la cadena se modifica o deja de existir.
En la biblioteca.
std::stringes la primera de las estructuras de este curso que usan: es un arreglo dinámico de caracteres, con su tamaño y su reserva. En la semana 4 ustedes escriben uno propio y entenderán qué cuesta cada+=.
std::vector
std::vector es un arreglo que crece, y es owner de sus elementos. Es lo que construyeron en C con malloc, realloc y un campo para
el tamaño, ya hecho y para cualquier tipo:
std::vector<int> grades;
grades.push_back(14);
grades.push_back(9);
grades.push_back(17);
std::cout << "tamaño: " << grades.size() << "\n";
std::cout << "último: " << grades.back() << "\n";

grades[1] = 11;
grades.erase(grades.begin());
std::cout << "primero tras borrar: " << grades[0] << "\n";

std::vector<int> zeros(3, 0);
std::vector<int> primes = {2, 3, 5};
std::vector<int> other = primes;
other[0] = 7;
std::cout << primes[0] << " " << other[0] << "\n";
std::cout << "iguales: " << (primes == other) << "\n";
std::cout << "ceros: " << zeros.size() << ", vacío: " << zeros.empty() << "\n";
La parte de <int> dice el tipo de los elementos: std::vector<int> y std::vector<std::string> son tipos distintos, y el compilador
no deja mezclarlos. Eso es un template, código con un hueco para un tipo, y en la semana 2 escribirán los suyos. En C tenían que elegir entre un módulo por cada tipo o
void * sin revisión; aquí no.
$ build/vectors
tamaño: 3
último: 17
primero tras borrar: 11
2 7
iguales: 0
ceros: 3, vacío: 0
Luis tiene 12
tras clear: 0
Las operaciones de esta semana:
| Operación | Qué hace |
|---|---|
std::vector<int> v; |
Crea un vector vacío |
std::vector<int> v(n, x); |
Crea uno con n copias de x |
std::vector<int> v = {1, 2, 3}; |
Crea uno con esos valores |
v.push_back(x) |
Agrega x al final, y crece si hace falta |
v.pop_back() |
Quita el último. Exige que no esté vacío |
v.back() |
Devuelve el último. Exige que no esté vacío |
v.size(), v.empty() |
Cuántos elementos hay, y si no hay ninguno |
v[i] |
El elemento i, sin revisar el índice |
v.at(i) |
El elemento i, revisando el índice |
v.erase(v.begin() + i) |
Borra el elemento i, y corre los siguientes una posición |
v.clear() |
Deja el vector vacío |
v.data() |
La dirección del primer elemento |
v.begin() + i se lee por ahora como “la posición i”. begin devuelve un iterador, que veremos en la semana 5. erase hace lo que
hacían ustedes con un ciclo o memmove: correr los elementos siguientes. Por eso borrar al inicio de un vector grande es caro.
Un vector puede guardar cualquier tipo, también uno propio:
struct Score {
    std::string name;
    int points;
};std::vector<Score> table;
table.push_back({"Ana", 18});
table.push_back({"Luis", 12});
std::cout << table[1].name << " tiene " << table[1].points << "\n";Score no tiene nada privado: solo agrupa datos a la vista, y por eso es un struct.
En la biblioteca. El vector y la cadena son los primeros usuarios de lo que construiremos. Por ahora los usan sin saber cómo crecen. En la semana 4 escribirán un
Vectorpropio, y lo medirán.
El tamaño no tiene signo
size() devuelve std::size_t, un entero sin signo, igual que sizeof en C (se declara en <cstddef>). Comparar con un int da advertencia:
for (int i = 0; i < values.size(); i++) {$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/sign_compare.cpp -o build/sign_compare
errors/sign_compare.cpp:7:23: warning: comparison of integer expressions of different signedness: 'int' and 'std::vector<int>::size_type' {aka 'long unsigned int'} [-Wsign-compare]Esta advertencia no es un adorno. Al restar se puede caer abajo de cero, y un número sin signo no sabe de negativos:
std::vector<int> empty;
std::cout << empty.size() - 1 << "\n";
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/size_minus_one.cpp -o build/size_minus_one
$ build/size_minus_one
18446744073709551615Un ciclo con i < v.size() - 1 y un vector vacío leería fuera del bloque hasta caerse. UBSan no se queja, porque en los enteros sin signo esto
está definido: dan la vuelta. La solución: un for por rango, que viene enseguida, cuando no necesitan el índice. Y si lo necesitan,
std::size_t i, y escribir la resta como suma: i + 1 < v.size().
El índice no se revisa
Igual que en un arreglo de C, v[i] no revisa nada. Un índice fuera de rango es comportamiento indefinido. Si cae fuera del bloque, ASan lo
detecta:
std::vector<int> values = {1, 2, 3};
std::cout << values[3] << "\n";
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/vector_index.cpp -o build/vector_index
$ build/vector_index
=================================================================
==2878==ERROR: AddressSanitizer: heap-buffer-overflow on address 0x50200000001c at pc 0xaaaaba1753d0 bp 0xffffca2a47b0 sp 0xffffca2a47c8
READ of size 4 at 0x50200000001c thread T0
#0 0xaaaaba1753cc in main errors/vector_index.cpp:7
...
0x50200000001c is located 0 bytes after 12-byte region [0x502000000010,0x50200000001c)
...
SUMMARY: AddressSanitizer: heap-buffer-overflow errors/vector_index.cpp:7 in mainSe lee igual que en C: qué tipo de error, en qué línea, y de qué bloque se trata. Pero ASan no ve todo. Un std::vector puede reservar más
de lo que usa, y el índice puede caer fuera de size() y dentro del bloque:
values.reserve(8);
values.push_back(1);
values[5] = 42;
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/vector_reserved.cpp -o build/vector_reserved
$ build/vector_reserved
size = 1, values[5] = 42Es un error aunque el programa no se queje: reserve pide un bloque de 8 enteros, y size() sigue siendo 1. Para ASan esa memoria es válida. Veremos
la diferencia entre tamaño y capacidad en la semana 4. Mientras tanto, v.at(i) sí revisa, contra size():
std::cout << values.at(3) << "\n";$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/vector_at.cpp -o build/vector_at
$ build/vector_at
terminate called after throwing an instance of 'std::out_of_range'
what(): vector::_M_range_check: __n (which is 3) >= this->size() (which is 3)for por rango y auto
El for por rango recorre todos los elementos de un contenedor, sin índice:
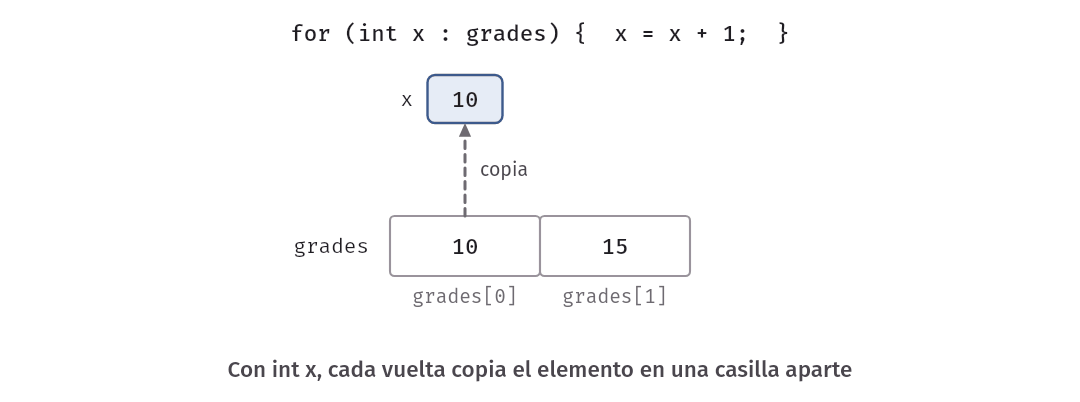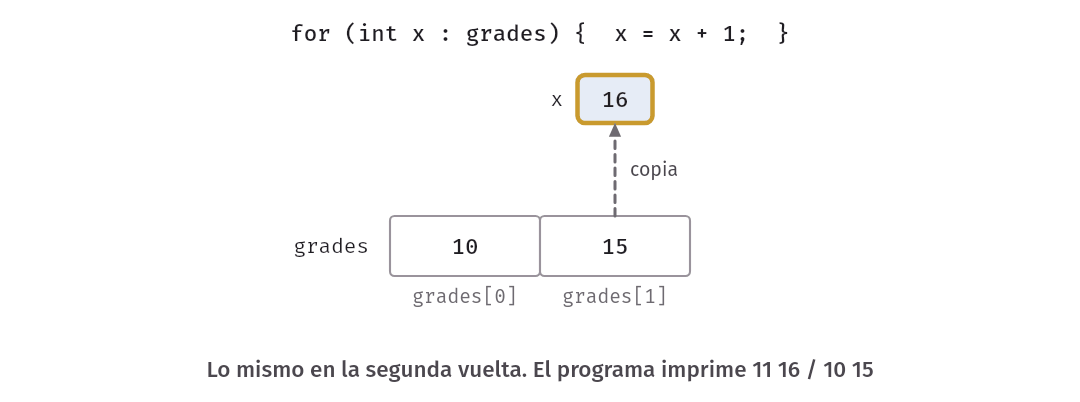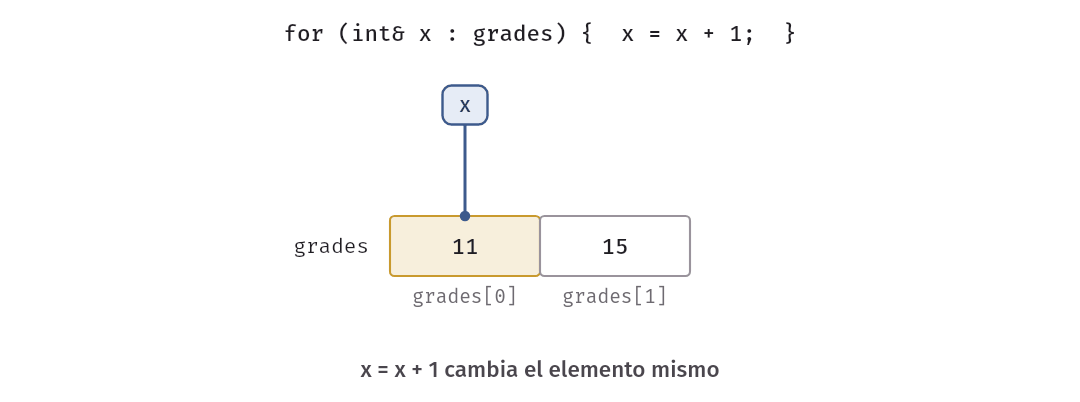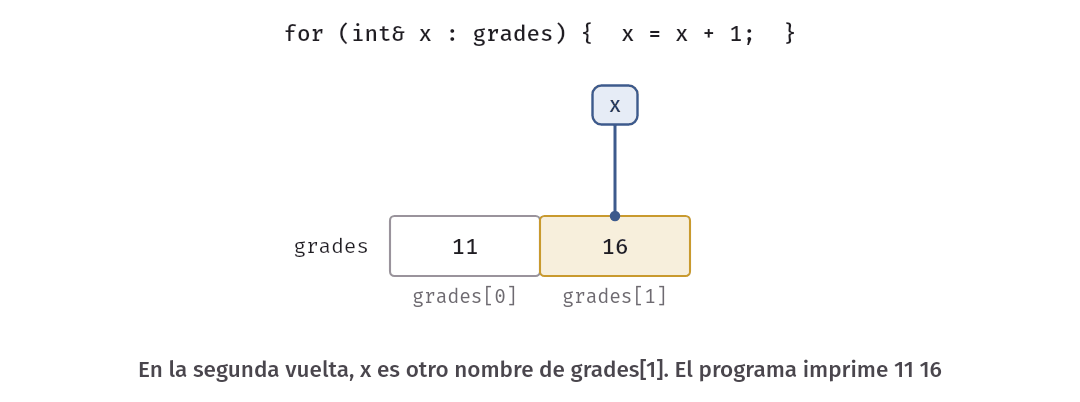
// x es una copia de cada elemento.
for (int x : grades) {
    x = x + 1;
    std::cout << x << " ";
}
std::cout << "/ " << grades[0] << " " << grades[1] << "\n";

// x es otro nombre del elemento.
for (int& x : grades) {
    x = x + 1;
}
std::cout << grades[0] << " " << grades[1] << "\n";

std::vector<std::string> names = {"Ana", "Luis"};
for (const std::string& name : names) {
    std::cout << name << " ";
}
std::cout << "\n";
Las tres formas son la misma regla de los parámetros:
| Forma | Qué hace | Cuándo |
|---|---|---|
for (int x : v) |
x es una copia de cada elemento |
Para leer tipos pequeños |
for (int& x : v) |
x es otro nombre del elemento |
Para modificar los elementos |
for (const std::string& s : v) |
s es otro nombre, de solo lectura |
Para leer tipos grandes |
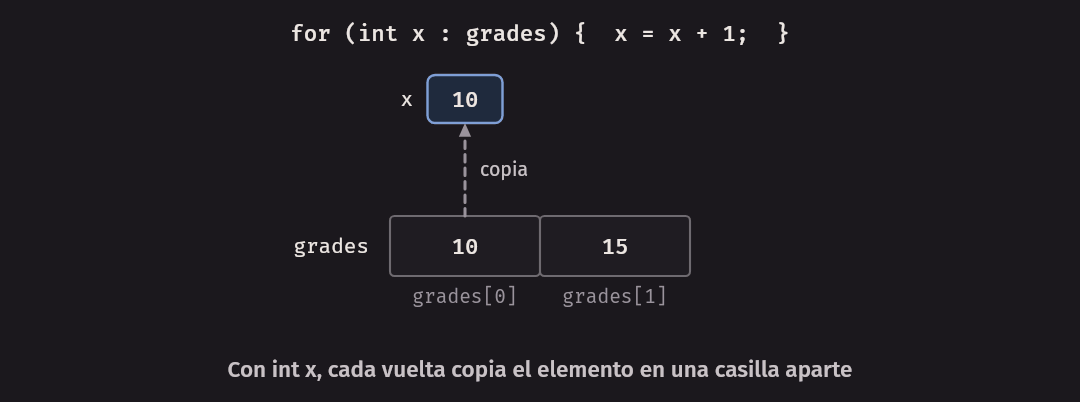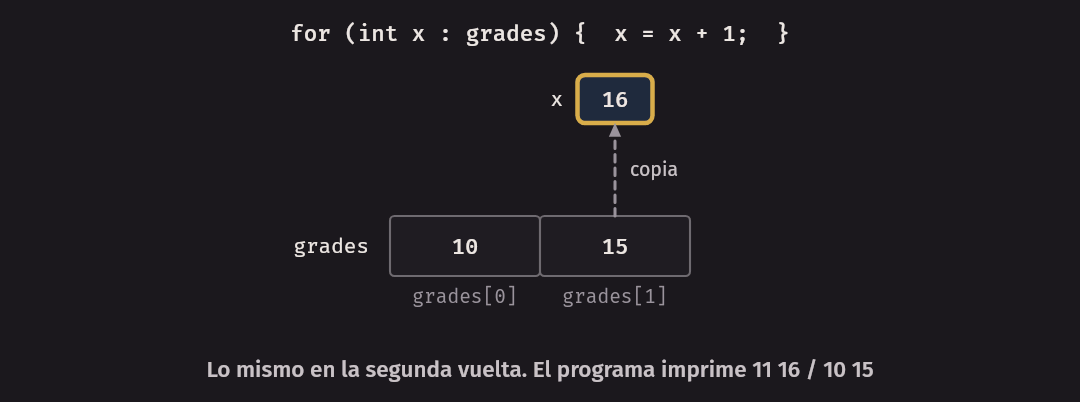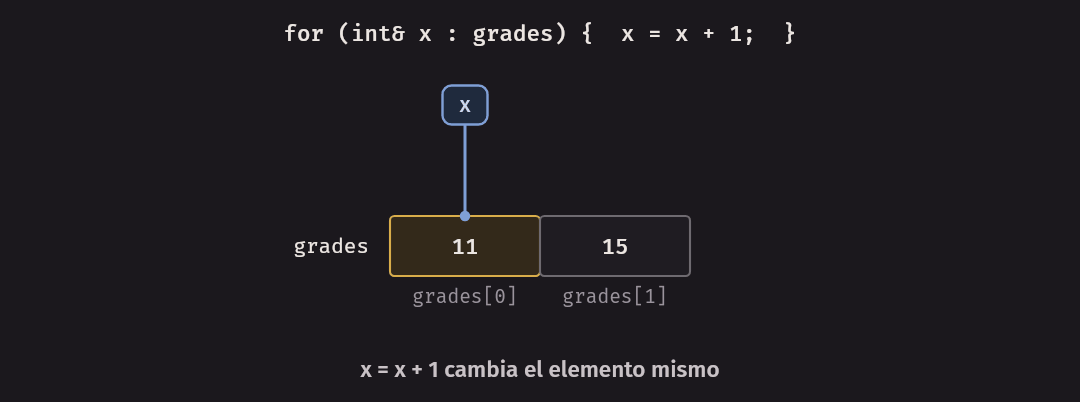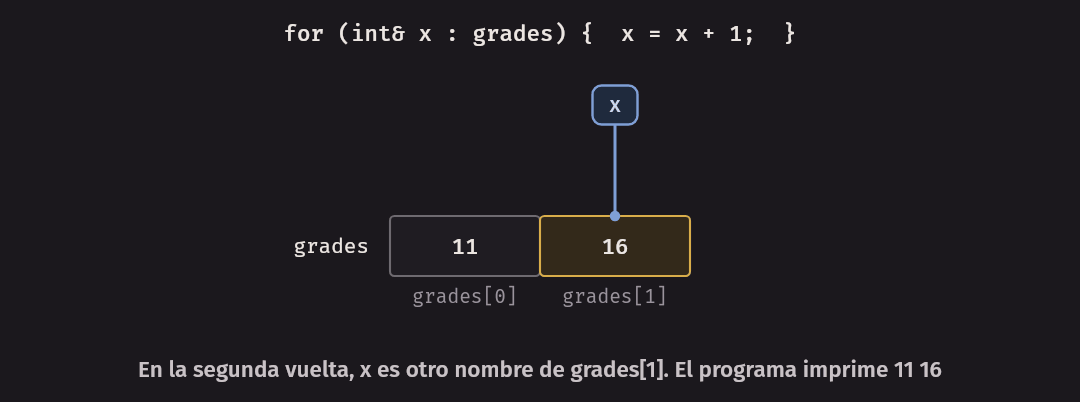
auto le pide al compilador que deduzca el tipo a partir del valor inicial. Es útil cuando el tipo es largo y obvio:
auto size = names.size();
const auto& first = names[0];
La trampa es que auto no conserva & ni const de lo que se le asigna: auto solo, sin más, es una copia. Hay que pedir la referencia.
Por ejemplo, este ciclo modifica copias:
// auto deduce el tipo; sin & sigue siendo una copia.
for (auto name : names) {
    name += "!";
}
std::cout << names[0] << "\n";
for (auto& name : names) {
    name += "!";
}
std::cout << names[0] << "\n";
$ build/range_for
11 16 / 10 15
11 16
Ana Luis
Ana
Ana!
2 Ana!La primera línea muestra que el primer ciclo solo cambió copias. El Ana de la cuarta línea muestra lo mismo con auto: el programa compila
sin aviso, y no pasa nada. El mismo error, con un struct:
for (auto score : table) {
    score.points += 1;
}
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/int_loop_copy.cpp -o build/int_loop_copy
$ build/int_loop_copy
10 15Error común.
for (auto x : v)copia cada elemento. Sivguarda cadenas y solo van a leer, copian todas de gusto. Si van a modificar, modifican la copia y no pasa nada. Por defecto escribanconst auto&, yauto¶ modificar.
En este curso auto se usa con moderación: cuando el tipo se ve en la misma línea o es muy largo. En int total = 0;, escribir int es más claro.
El error común: copiar un vector sin querer
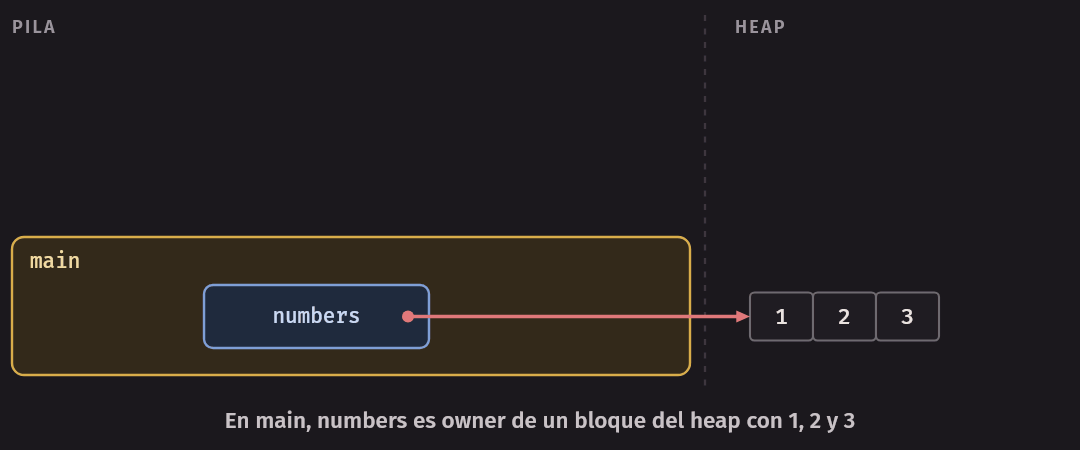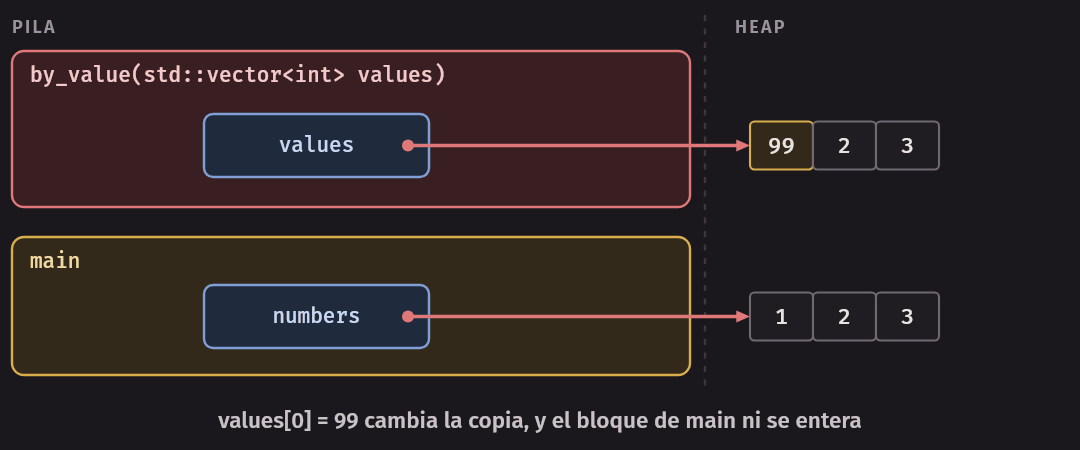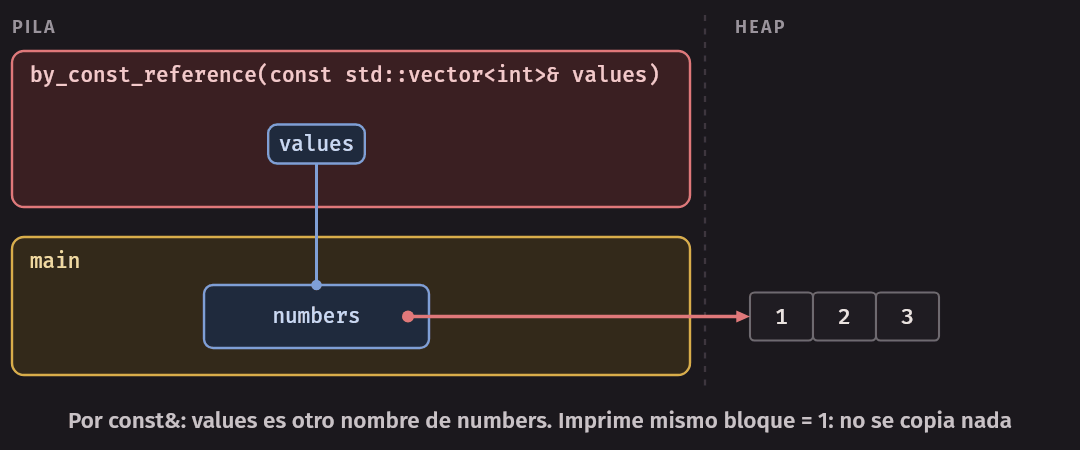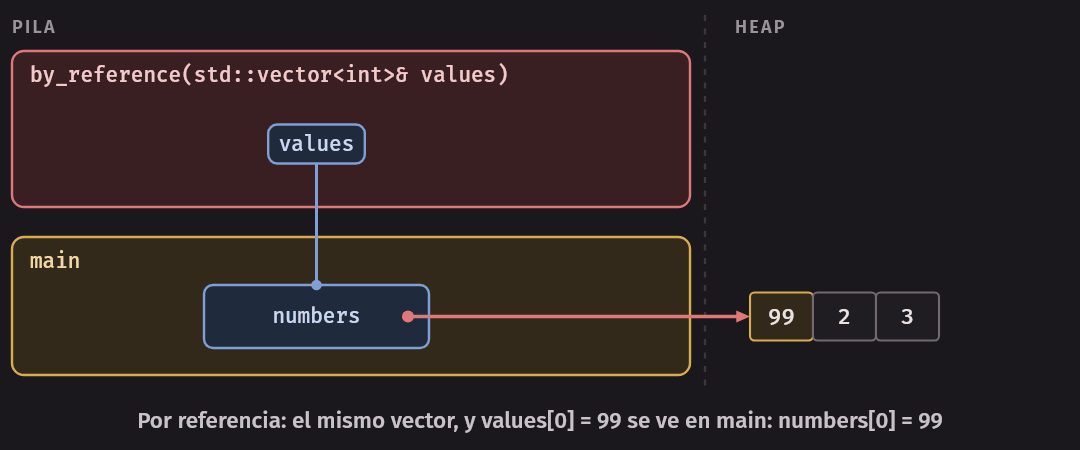
Pasar por valor en C++ copia el objeto, como en C. La diferencia es qué significa copiar. En C, copiar un struct que tenía un puntero copiaba
el puntero. En C++, copiar un std::vector copia todos sus elementos, en un bloque nuevo. Se ve al comparar direcciones con data():
void by_value(std::vector<int> values, const int *original) {
    values[0] = 99;
    std::cout << "por valor:      mismo bloque = " << (values.data() == original)
              << ", values[0] = " << values[0] << "\n";
}

void by_const_reference(const std::vector<int>& values, const int *original) {
    std::cout << "por const&:     mismo bloque = " << (values.data() == original)
              << ", values[0] = " << values[0] << "\n";
}
$ build/copy_or_not
por valor: mismo bloque = 0, values[0] = 99
en main: numbers[0] = 1
por const&: mismo bloque = 1, values[0] = 1
en main: numbers[0] = 1
por referencia: mismo bloque = 1, values[0] = 99
en main: numbers[0] = 99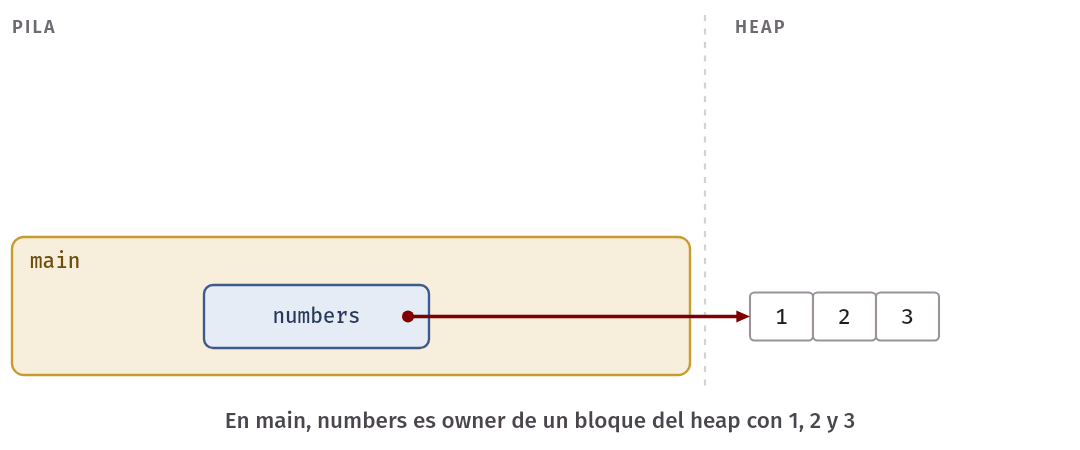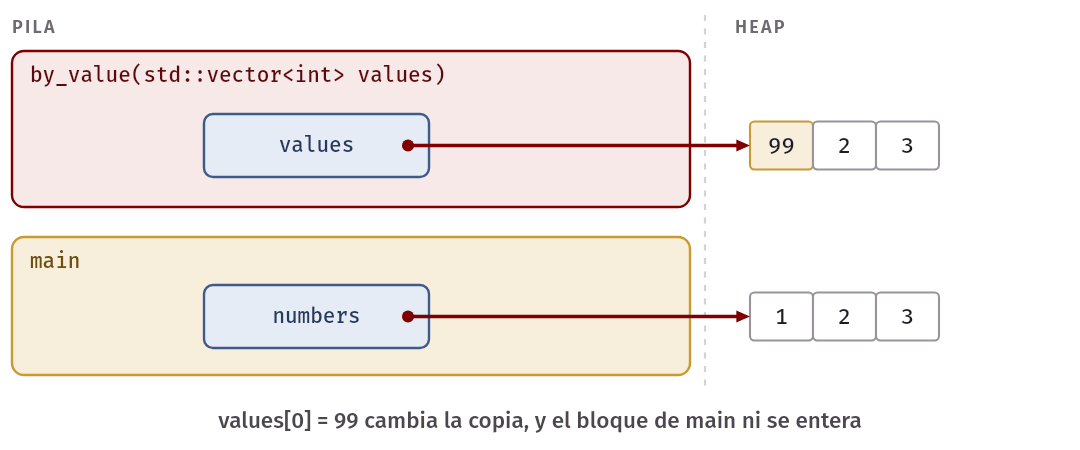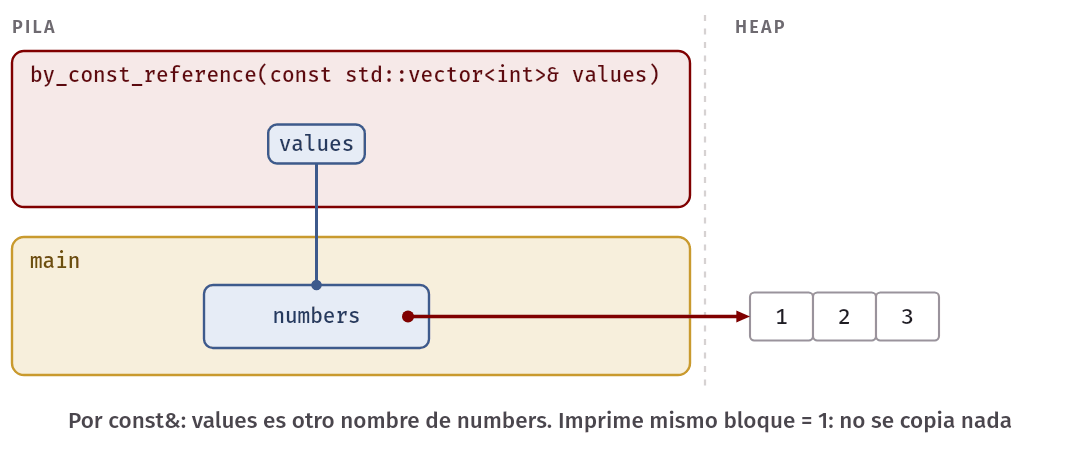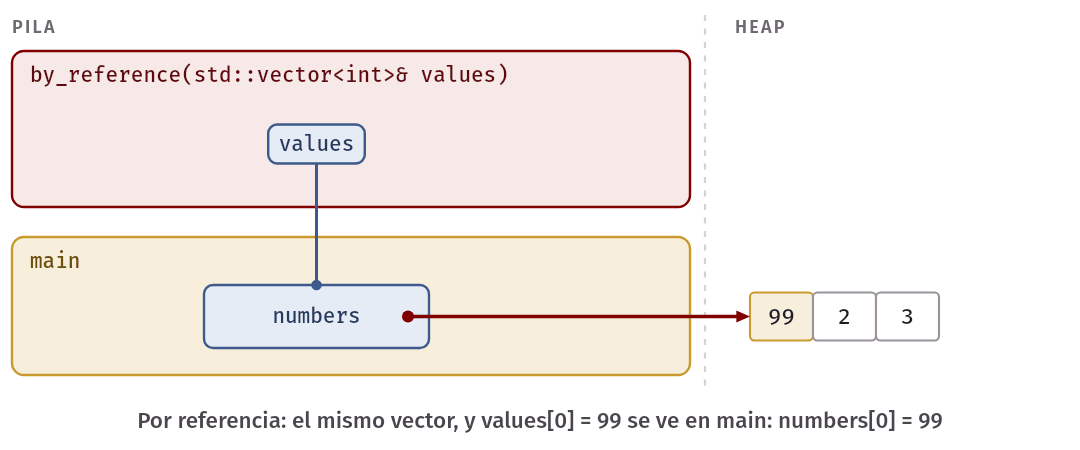
Eso responde la diferencia entre void f(std::vector<int> v) y void f(const std::vector<int>& v):
- Por valor,
ves otro vector, con su propio bloque y una copia de cada elemento. La función puede cambiarlo sin afectar a quien llama, y paga por copiarnelementos al entrar, y por liberarlos al salir. - Por referencia constante,
ves otro nombre del vector de quien llama. No se copia nada, sin importar el tamaño. La función no puede modificarlo.
Para leer un arreglo grande conviene la segunda: hace lo mismo y no cuesta nada. El problema de la primera es que compila sin avisar y funciona bien. Solo es lenta, y más lenta mientras más datos haya. Eso es peor que un error: se descubre en producción. Es peor todavía dentro de un ciclo:
int value_at_copy(std::vector<int> values, std::size_t index) {
    return values[index];
}

int value_at_ref(const std::vector<int>& values, std::size_t index) {
    return values[index];
}
for (std::size_t i = 0; i < n; i++) {
if (mode == "copy") {
sum += value_at_copy(values, i);
copied += values.size();
} else {
sum += value_at_ref(values, i);
}
}La diferencia entre las dos firmas es un const y un &. Con n = 1000, una versión copia un millón de enteros, y la otra ninguno:
$ build/copy_in_loop 1000 copy
suma = 1000, elementos copiados = 1000000
$ build/copy_in_loop 1000 ref
suma = 1000, elementos copiados = 0
Estos números son exactos. Los tiempos no: son la mediana de 5 corridas con make measure, con -O2 y sin sanitizers. Dependen de la máquina, y
por debajo de unos milisegundos lo que se mide es sobre todo el inicio del programa. Lo que se sostuvo en las tres veces que lo medimos es el crecimiento:
n |
Por copia | Por const& |
|---|---|---|
| 20 000 | 0.047 s | 0.001 s |
| 40 000 | 0.183 s | 0.002 s |
| 80 000 | 0.742 s | 0.002 s |
Al duplicar n, la versión por copia tarda casi 4 veces más: son n llamadas que copian n elementos, n² en total. La de const& hace n lecturas,
y es demasiado rápida para medirla con estos tamaños: necesitó n = 40 000 000 para llegar a 0.062 s, y ahí, al duplicar n, el tiempo se duplica.
La semana 3 da el lenguaje para decir esto con precisión.
Idea clave. Un mismo
&puede convertir un programa cuadrático en uno lineal. Antes de escribir un parámetro que no sea un tipo pequeño, pregúntense si de verdad quieren una copia.
Hay un detalle más: pasar por valor copia cuando el argumento es una variable que sigue existiendo. Si es un valor temporal, por ejemplo el retorno de otra
función, C++ puede evitar la copia. La semana 2 lo explica con el movimiento. Lo mismo vale para retornar por valor: una función puede devolver un
std::vector nuevo sin miedo.
Pruebas: assert, advertencias y sanitizers
En C ya usaban assert, y en C++ funciona igual, con #include <cassert>:
void test_one_value() {
    Tally tally;
    tally.add(-3);
    assert(tally.count() == 1);
    assert(tally.sum() == -3);
    assert(tally.max() == -3);
}
Si la condición es falsa, el programa imprime el archivo, la línea y la condición, y se detiene. Si es verdadera, no hace nada.
Hay una regla: lo que está adentro de un assert no debe hacer nada necesario para el programa. Al compilar con -DNDEBUG, assert desaparece
por completo, y con él lo que haga adentro. -O2 no lo define por sí solo: -DNDEBUG hay que pedirlo. Este programa cambia según esa opción:
values.pop_back();
assert((values.push_back(9), values.size() == 3));
std::cout << values.size() << "\n";
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/assert_side_effect.cpp -o build/assert_side_effect
$ build/assert_side_effect
3
$ g++ -Wall -Wextra -std=c++20 -DNDEBUG errors/assert_side_effect.cpp -o build/assert_off
$ build/assert_off
2Qué se prueba
Las pruebas de este curso tienen dos partes:
Casos dirigidos. Uno por cada comportamiento de la interfaz y por cada caso borde: vacío, un elemento, valores en los límites, y cualquier cosa que
el contrato diga que se rechaza. También conviene probar las cosas a través de un const&: una prueba así deja de compilar si olvidan un const.
void test_read_through_const_reference(const Tally& tally) {
    assert(tally.count() == 3);
    assert(tally.max() == 17);
}
Operaciones al azar contra una referencia. Se hacen muchas operaciones, con una semilla fija, y se compara el resultado con algo en lo que confían, como la biblioteca estándar. Si algo falla, la semilla fija hace que falle igual la próxima vez, y lo pueden depurar:
// Compara contra un std::vector, que hace de referencia.
void test_against_reference() {
    std::mt19937 random(2026);
    Tally tally;
    std::vector<int> reference;
    for (int step = 0; step < 2000; step++) {
        int value = static_cast<int>(random() % 201) - 100;
        tally.add(value);
        reference.push_back(value);
        assert(tally.count() == reference.size());
        assert(tally.sum() == std::accumulate(reference.begin(), reference.end(), 0));
        assert(tally.max() == *std::max_element(reference.begin(), reference.end()));
    }
}
std::mt19937 es el generador de números al azar de la biblioteca (<random>), y random() devuelve el siguiente número. std::accumulate y std::max_element
son las versiones de la biblioteca de lo que hace Tally. No se preocupen por memorizarlas: en el laboratorio les damos las pruebas al azar.
$ build/tally_tests
tally: todas las pruebas pasaron
Las opciones que se usan siempre
Cada opción encuentra errores distintos:
| Opción | Qué hace | Ejemplo de esta semana |
|---|---|---|
-Wall -Wextra |
Activa las advertencias | Referencia a una local, int contra size(), orden de iniciación |
-std=c++20 |
Fija la versión del lenguaje | |
-g |
Guarda información para depurar | Los números de línea de los informes y de gdb |
-fsanitize=address |
ASan: accesos inválidos y fugas | v[3] fuera del bloque |
-fsanitize=undefined |
UBSan: comportamiento indefinido | Al correr errors/return_local_ref.cpp: reference binding to null pointer |
Trátenlas como en C: una advertencia es un error que aún no ha ocurrido. En este curso, el código no debe dar ninguna.
El código de esta semana
En code/week-01:
| Archivos | Qué tienen |
|---|---|
hello.cpp, c_style.cpp, small_changes.cpp, namespaces.cpp |
Lo que no cambia, y lo que cambia poco |
reference_basics.cpp, swap_both.cpp, const_forms.cpp |
Referencias y const |
tally_c/ |
El módulo Tally en C, con tipo opaco |
tally.h, tally.cpp, tally_demo.cpp, tally_tests.cpp, sizes.cpp |
El mismo módulo como clase, con sus pruebas |
course.cpp, const_shallow.cpp |
Constructores y métodos const |
strings.cpp, vectors.cpp, range_for.cpp |
std::string, std::vector, for por rango y auto |
copy_or_not.cpp, copy_in_loop.cpp, value_at.h, value_at.cpp |
El costo de copiar sin querer |
lookup.cpp, measure.py |
Búsqueda lineal y binaria, contadas y medidas |
errors/ |
Programas con errores a propósito |
lab/ |
El laboratorio |
make compila los programas y make test comprueba todo: que los ejemplos compilan sin advertencias, que las pruebas pasan, que los errores de errors/ siguen
diciendo lo que estos apuntes dicen y que cada comando de terminal de este capítulo da la salida que aparece aquí. Si todo está bien, termina así:
OKEl laboratorio: portar un módulo de C a C++
En el laboratorio van a hacer con un módulo nuevo lo que acabamos de hacer con Tally. lab/c/ tiene un módulo completo en C, un registro de notas de
estudiantes, con tipo opaco, nombres en bloques propios y un arreglo que crece. Está probado y no tiene fugas: make lab lo compila junto con sus
pruebas.
lab/c/grade_book.h         el encabezado del módulo
lab/c/grade_book.c         su implementación
lab/c/test_grade_book.c    sus pruebas con assert
lab/hello.cpp              un programa corto, para probar el entorno
lab/grade_book.h           la clase que van a completar
lab/grade_book.cpp         sus métodos
lab/test_grade_book.cpp    sus pruebas
lab/comparison.txt         lo que van a responder al final
lab/tests/                 las pruebas públicas
Empiecen por leer el módulo en C entero. lab/grade_book.h ya les da las firmas de los métodos del paso 3. Para cada una, expliquen por qué es así: qué parámetro
desapareció, por qué este se volvió const&, por qué ese método es const y qué pasó con grade_book_new y grade_book_free. Los campos los eligen ustedes, y las
firmas de average y best, en el paso 5, también. make test-lab les irá diciendo cuánto les falta, paso por paso, y make compare cuenta líneas y llamadas a malloc para el último paso. Una de esas
pruebas corre 2000 órdenes al azar en las dos versiones, la de C y la de ustedes, y compara lo que imprimen: un buen port hace exactamente lo mismo.
Una decisión que no es solo traducción. grade_book_name_at devuelve NULL si el índice no existe. Una referencia no puede ser nula, así que la clase cambia el
contrato: exige un índice válido, y lo comprueba con assert. Y al escribir best, piensen si puede devolver una referencia cuando el registro está vacío.
Error común. No traduzcan línea por línea. Si su método tiene un
forque copia caracteres, o un campocapacity_, todavía están escribiendo C. Esstd::vectorel que lleva el tamaño y crece.
Resumen
- Este curso trata de elegir cómo organizar los datos según lo que el programa necesita hacer. Una organización distinta permite un algoritmo distinto: de un día a un segundo.
- C++ conserva tipos, control, funciones, punteros, memoria, y la forma de compilar y enlazar de C. Se compila con
g++ -std=c++20. - Un namespace evita chocar nombres sin prefijos. En el curso se escribe
std::, nuncausing namespace std. - Una referencia es otro nombre de un objeto: se inicia al crearse, no puede ser nula en un programa válido y no cambia de objeto.
r = xasigna al objeto. Sí puede quedar colgando. - Tipos pequeños, por valor. Lo demás,
const&. Para modificar,&. - Una clase junta campos privados y métodos. Un constructor deja el objeto listo. Un método
constno modifica los campos, y es el único que se puede llamar sobre un objetoconst. privatereemplaza la garantía del tipo opaco de que nadie afuera toca los campos, pero los campos siguen visibles: el compilador conoce el tamaño, y el objeto puede vivir en la pila.std::stringystd::vectorson owners de su memoria. Copiarlos copia todo, y==compara el contenido.for (const auto& x : v)lee sin copiar.autosolo es una copia.- Pasar un
std::vectorpor valor compila, funciona, y puede volver cuadrático un programa lineal. - Se prueba con
assert, casos dirigidos y operaciones al azar con semilla fija. Se compila con-Wall -Wextray sanitizers, sin advertencias.
Ejercicios
Ejercicio 1. Sin compilar, digan qué imprime:
int a = 1;
int b = 2;
int& r = a;
r = b;
b = 5;
std::cout << a << " " << b << " " << r << "\n";
Compruébenlo.
Ejercicio 2. Para cada función, escriban la firma más adecuada, según la tabla de cómo pasar un argumento: (a) la raíz cuadrada de un double; (b) cuántas veces
aparece una palabra en una lista de cadenas; (c) ordenar un std::vector<int> en su lugar; (d) devolver una cadena en mayúsculas sin tocar la original.
Ejercicio 3. Reescriban con std::string una función de C que reciba un nombre y un apellido y devuelva, en un bloque nuevo que debe liberar quien llama, la cadena
"Apellido, Nombre". ¿Cuántas líneas tiene cada versión? ¿Qué pasa en cada una si alguien olvida revisar malloc?
Ejercicio 4. Expliquen por qué compila const std::string& s = "hola"; y no compila std::string& s = "hola";. Compruébenlo. ¿Hasta cuándo vive la std::string temporal
del primer caso? Pista: una referencia constante local extiende la vida de la temporal hasta el final de su alcance, lo que no pasa con un parámetro.
Ejercicio 5. Agreguen a Tally un método min y un método average. ¿Cuáles deben ser const? ¿Qué debe exigir cada uno? Agreguen sus pruebas a tally_tests.cpp, incluida una a través de
const Tally&, y comparen el resultado de min con std::min_element.
Ejercicio 6. Cambien Tally para que guarde solo count_, sum_ y max_, sin el vector, como el tally_summary.c del curso anterior. ¿Tienen que cambiar tally_demo.cpp? ¿Tienen que
recompilarlo? ¿Con el tipo opaco de C, tenían que recompilarlo? ¿Qué campos necesitan un valor inicial, y por qué max_ es delicado?
Ejercicio 7. Escriban una clase Temperatures que guarde las lecturas de un sensor, con un constructor que reciba el nombre del sensor,
un método para agregar, otro para obtener la mayor lectura y otro para saber cuántas lecturas pasan de un límite. Decidan qué es privado, qué es const y cómo se pasa cada parámetro.
Pruébenla con casos dirigidos y con operaciones al azar.
Ejercicio 8. Este programa debe subir en 1 todas las notas, pero no lo hace. Encuentren dos formas de arreglarlo:
std::vector<int> grades = {10, 15, 20};
for (auto grade : grades) {
    grade++;
}
Ejercicio 9. Busquen el error de cada función y digan cómo reacciona el compilador, si es que reacciona. Compruébenlo con -Wall -Wextra y con sanitizers.
int& largest(std::vector<int> values) {
    int& top = values[0];
    for (int& value : values) {
        if (value > top) {
            top = value;
        }
    }
    return top;
}

void print_last(const std::vector<int>& values) {
    for (int i = 0; i <= values.size() - 1; i++) {
        std::cout << values[i] << "\n";
    }
}
Ejercicio 10. Escriban un programa que lea palabras con std::cin hasta el final de la entrada, las guarde en un std::vector<std::string> e imprima las que aparecen más de una vez,
usando dos for anidados. Cuenten las comparaciones de cadenas con 1 000 y con 2 000 palabras, sobre una entrada sin repetidas. ¿Cuánto creció? ¿Qué estructura haría falta para que crezca menos? Volveremos
a esta pregunta en la semana 7.
Ejercicio 11. Modifiquen copy_in_loop.cpp para que el vector guarde std::string en vez de int, y midan con make measure cuánto más lenta es la copia que con enteros, con 5 repeticiones. ¿Por qué
la diferencia es mucho más grande que el tamaño en bytes? Pista: cuenten los bloques que hay que reservar en cada copia si las cadenas son largas.
Ejercicio 12. (Desafío) Escriban una versión de Tally en la que add rechace valores repetidos, y que sum y max sigan funcionando. Con la implementación más directa, ¿cuántas comparaciones cuesta
agregar n valores distintos? ¿Y si mantienen el vector ordenado y buscan con búsqueda binaria? Cuenten las comparaciones de las dos formas. ¿Qué otra operación se volvió más cara?