Apuntes · Capítulo 3De C a C++ y costos
Análisis asintótico y medición
Análisis asintótico y medición
La semana pasada construyeron una pila con RAII, sus invariantes y su check_invariants. Ya saben comprobar
que una estructura hace lo correcto. Falta la otra mitad del curso: cuánto cuesta hacerlo. Si dos
implementaciones de una pila dan los mismos resultados, ¿con cuál se quedan? Si un programa tarda un segundo
con mil datos, ¿cuánto tardará con un millón? De aquí en adelante, cada estructura del curso se va a
presentar con los costos de sus operaciones, así que necesitamos un lenguaje preciso para hablar de ellos.
Este capítulo tiene dos mitades, y se apoyan una en la otra. En la primera predecimos: contamos operaciones leyendo el código y describimos cómo crece esa cuenta con las notaciones O, Ω y Θ. En la segunda medimos: usamos un reloj, y vemos todo lo que puede salir mal, porque medir bien es más difícil de lo que parece. Al final las juntamos con el experimento de duplicar, que contrasta la predicción con la medición.
Una aclaración sobre las demostraciones. Matemática Discreta va en paralelo, así que aquí nada se demuestra por inducción. Todo lo que afirmamos se justifica con una cuenta directa, o se comprueba con un programa, o se dice que queda sin demostrar.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Por qué contar operaciones y no segundos, Las clases que se repiten y O, Ω y Θ.
- En clase: Mejor caso, peor caso y caso promedio, Leer código: ciclos, Recursión: el árbol de llamadas, Espacio además de tiempo, Medir: el reloj, Medir: con
-O2y sin sanitizers, Medir: repetir y usar la mediana, Medir: el compilador puede borrar lo que están midiendo, El experimento de duplicar y Lo que O no ve.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de la semana y El laboratorio, paso a paso. Opcional: Open Data Structures, secs. 1.3.3 (Asymptotic Notation) y 1.5 (Correctness, Time Complexity, and Space Complexity); CLRS, capítulo Characterizing Running Times, solo la visión general.
Código. Los programas de este capítulo están en
code/week-03. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/miden mal a propósito y se compilan a mano, como se muestra en cada caso. El medidorbench.htambién se usará en las semanas 4 y 5.
Por qué contar operaciones y no segundos
La pregunta “¿cuánto tarda este programa?” parece tener una respuesta en segundos. Este programa suma un millón de enteros:
$ build/first_timer
una medicion: 359 us
nueve mediciones (us): 350 349 358 349 367 349 349 355 349
media 353 us, mediana 349 us
salto minimo del reloj: 41 ns
Unos 350 microsegundos, en la máquina donde se escribieron estos apuntes. En la de ustedes será otro número. El tiempo depende del procesador, del compilador y sus opciones, de qué más está corriendo y hasta de cómo quedaron los datos en memoria. Un número en segundos describe una corrida, no un algoritmo.
Lo que no depende de nada de eso es la cuenta de operaciones. Si el ciclo da una vuelta por cada elemento, con un millón de elementos da un millón de vueltas en cualquier computadora. Por eso vamos a describir el costo de un algoritmo con una función matemática:
T(n) es la cantidad de operaciones elementales que hace el algoritmo con una entrada de tamaño n.
Una operación elemental es cualquier cosa de costo acotado por una constante, que no depende de n: sumar
dos enteros, comparar, leer values[i], llamar a una función (sin contar lo que hace por dentro). No
importa si “sumar” son una o tres instrucciones de la máquina: eso solo cambia T(n) por un factor constante,
y en un momento vamos a acordar que esos factores no nos interesan.
Falta decidir qué es n. Normalmente es la cantidad de elementos, pero hay que decirlo: en una matriz puede ser el lado o la cantidad de casillas, y eso cambia la fórmula.
Lo que importa cuando n crece
Supongamos que contamos con cuidado y sale T(n) = 3n² + 10n. Miremos cuánto aporta cada término:
| n | 3n² | 10n | parte de 3n² en el total |
|---|---|---|---|
| 10 | 300 | 100 | 75 % |
| 100 | 30 000 | 1 000 | 96.8 % |
| 1 000 | 3 000 000 | 10 000 | 99.7 % |
| 1 000 000 | 3 × 10¹² | 10⁷ | 99.9997 % |
Cuando n crece, el término 10n deja de importar. El 3 sí sigue ahí, pero cambiarlo no cambia la forma de la curva. Con T(n) = 3n², duplicar n multiplica el tiempo por 4; con T(n) = 300n², también. En cambio, nada que le hagan a la constante de un algoritmo lineal le cambia eso: duplicar n solo lo multiplica por 2. Para n suficientemente grande, el lineal gana siempre, aunque tenga una constante horrible.
Esa es la idea del análisis asintótico (asymptotic analysis): describir cómo crece el costo cuando n crece, ignorando los términos de menor orden y los factores constantes.
Ignorar cosas tiene un precio, y lo vamos a pagar al final del capítulo. Por ahora, el trato es este: perdemos las constantes y a cambio obtenemos una descripción que vale en cualquier máquina.
Idea clave. Los segundos describen una corrida. La cuenta de operaciones describe el algoritmo. El análisis asintótico se queda con la parte de la cuenta que manda cuando n crece.
Las clases que se repiten
Casi todo lo que verán en el curso cae en unas pocas clases de crecimiento:
| Clase | Nombre | Dónde aparece |
|---|---|---|
| 1 | constante | leer values[i], push en una pila que ya tiene espacio |
| log n | logarítmica | búsqueda binaria: se descarta la mitad en cada paso |
| n | lineal | recorrer un arreglo una vez |
| n log n | n log n | ordenar bien |
| n² | cuadrática | comparar cada par, ordenar con dos ciclos anidados |
| 2ⁿ | exponencial | probar todos los subconjuntos |
Cuando no se dice otra cosa, log es logaritmo en base 2: log₂ n es cuántas veces hay que dividir n entre 2
para llegar a 1. Vamos a ver enseguida que la base no cambia la clase.
Este programa calcula las funciones para algunos n:
$ build/growth_table
       n   log2 n          n   n log2 n        n^2        2^n
      10      3.3         10       33.2        100   1.02e+03
      20      4.3         20       86.4        400   1.05e+06
      40      5.3         40        213    1.6e+03    1.1e+12
      80      6.3         80        506    6.4e+03   1.21e+24
    1000     10.0      1e+03   9.97e+03      1e+06  1.07e+301
 1000000     19.9      1e+06   1.99e+07      1e+12        inf

con 1000000000 operaciones
         n     1000000000
  n log2 n       39620077
       n^2          31622
       n^3           1000
       2^n             29
El inf es que 2¹⁰⁰⁰⁰⁰⁰ no cabe en un double.
La segunda tabla responde la pregunta práctica: ¿qué tan grande puede ser n si tengo un segundo? Para contestarla hay que suponer una velocidad. Usamos 10⁹ operaciones simples por segundo, que es una suposición redonda, no una medida exacta. El orden de magnitud es razonable: la suma de un millón de enteros de arriba da cerca de 3 × 10⁹ sumas por segundo. Una operación más cara, o una que tenga que ir a buscar el dato lejos en la memoria, puede costar diez o cien veces más. Con esa suposición:
| Clase | n que alcanza en un segundo, con 10⁹ operaciones |
|---|---|
| 1, log n | no hay límite práctico: n = 2⁶⁰ son 60 pasos |
| n | mil millones |
| n log n | unos 40 millones |
| n² | unos 30 mil |
| n³ | mil |
| 2ⁿ | 29 |
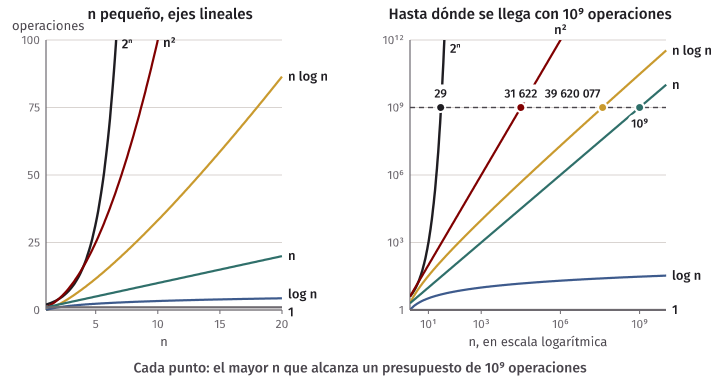
Lean esta tabla al revés. Si un problema tiene un millón de datos, un algoritmo cuadrático no llega: 10¹² operaciones son unos 17 minutos con esa velocidad. Esa cuenta rápida, hecha antes de programar, ahorra mucho trabajo.
¿Y si compran una computadora mil veces más rápida? El presupuesto pasa a 10¹². Con n² el tamaño alcanzable se multiplica por √1000 ≈ 32. Con 2ⁿ, pasa de 29 a 39: mil veces más hardware les da diez elementos más, porque sumar 1 a n ya duplica el costo. Un algoritmo mejor rinde más que una máquina mejor.
O, Ω y Θ
Hasta ahora hablamos de “la parte que manda”. Vamos a definirlo con precisión. Primero la definición, después qué significa, después cómo se usa.
En todo lo que sigue, f y g son funciones de los naturales en los reales no negativos: f(n) es una cantidad de operaciones, o de memoria, para una entrada de tamaño n. Por eso no hace falta poner valores absolutos.
Cota superior. O(g) es el conjunto de las funciones f para las que existen una constante c > 0 y un natural n₀ tales que f(n) ≤ c · g(n) para todo n ≥ n₀.
Cota inferior. Ω(g) es el conjunto de las funciones f para las que existen una constante c > 0 y un natural n₀ tales que f(n) ≥ c · g(n) para todo n ≥ n₀.
Cota exacta. Θ(g) es el conjunto de las funciones f para las que existen constantes c₁ > 0 y c₂ > 0 y un natural n₀ tales que c₁ · g(n) ≤ f(n) ≤ c₂ · g(n) para todo n ≥ n₀.
De las definiciones sale de inmediato que f ∈ Θ(g) si y solo si f ∈ O(g) y f ∈ Ω(g): en un sentido, tomen c₂ como la c de O y c₁ como la c de Ω, y como n₀ el mayor de los dos; en el otro, las dos desigualdades ya están escritas.
Se leen “O grande de g”, “omega de g” y “theta de g”. Se llaman big O, big Omega y big Theta. Cada parte de la definición está ahí por una razón:
- La constante c es lo que nos deja ignorar los factores constantes. 300n² y 3n² quedan en la misma clase, porque basta con elegir otra c.
- n₀ es lo que nos deja ignorar los n pequeños. La desigualdad puede fallar en los primeros valores: solo se exige “de ahí en adelante”. Eso es lo que quiere decir asintótico.
- El orden de los cuantificadores importa: primero se eligen c y n₀, una sola vez, y después tienen que servir para todos los n ≥ n₀. La constante no puede depender de n.
Un dibujo de f ∈ Θ(g). Antes de n₀ puede pasar cualquier cosa. Desde n₀, f queda atrapada entre dos copias de g:
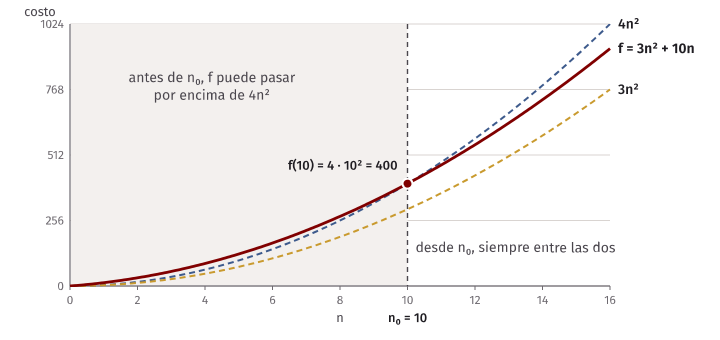
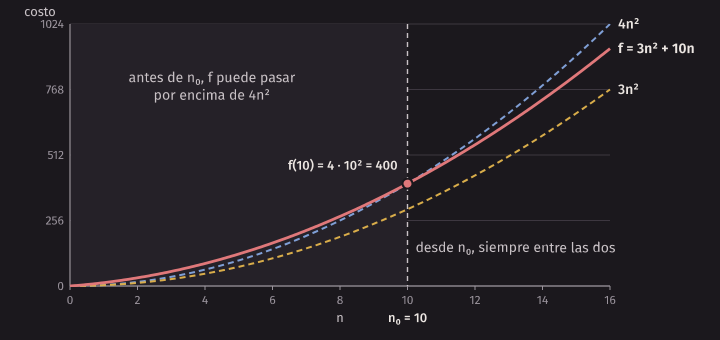
Con la O solo vale la curva de arriba, y con la Ω solo la de abajo.
Un ejemplo completo
Probemos que T(n) = 3n² + 10n está en Θ(n²). Hay que encontrar constantes, nada más.
Cota superior. Queremos 3n² + 10n ≤ c · n². Si n ≥ 10, entonces 10n ≤ n · n = n². Por lo tanto, 3n² + 10n ≤ 3n² + n² = 4n². Sirven c = 4 y n₀ = 10.
Cota inferior. Queremos 3n² + 10n ≥ c · n². Como 10n ≥ 0, se cumple 3n² + 10n ≥ 3n² para todo n. Sirven c = 3 y n₀ = 0.
Juntando, con c₁ = 3, c₂ = 4 y n₀ = 10: 3n² ≤ T(n) ≤ 4n² para todo n ≥ 10. Las constantes no son únicas: c = 13 y n₀ = 1 también sirve para la superior. La definición pide que exista alguna; no hay una “correcta”.
Ahora algo que no está: T(n) = n² no está en O(n). Para probarlo, supongamos que sí. Habría c y n₀ con n² ≤ c · n para todo n ≥ n₀. Dividiendo entre n (para n ≥ 1), sería n ≤ c para todo n suficientemente grande. Eso es falso: basta tomar cualquier n mayor que c y que n₀. Ninguna constante alcanza, porque la que se necesita crece con n. Por eso n² es una clase distinta de n.
O no significa “crece exactamente así”
La O es solo una cota superior. Estas afirmaciones son todas verdaderas:
- 5n ∈ O(n)
- 5n ∈ O(n²)
- 5n ∈ O(2ⁿ)
La segunda se comprueba con c = 5 y n₀ = 1: 5n ≤ 5n² para n ≥ 1. Es verdadera, y también poco útil, como decir “esta clase dura menos de cien horas”. Del mismo modo, 5n ∈ Ω(1) y 5n ∈ Ω(n), pero 5n ∉ Ω(n²).
La única clase de esta lista que describe bien a 5n es Θ(n), porque Θ afirma las dos cotas a la vez. En la práctica, mucha gente dice O cuando quiere decir Θ. En este curso usamos cada una con su significado: Θ cuando conocemos el crecimiento exacto, O cuando solo garantizamos un techo, Ω cuando solo garantizamos un piso.
Error común. Decir “este algoritmo es O(n²), así que es lento”. O(n²) es solo un techo. La búsqueda lineal también es O(n²), y no es cuadrática. Para decir que es lento hace falta una cota inferior.
Sobre la escritura: es muy común ver T(n) = O(n²), con un signo igual. Es una forma abreviada de escribir T(n) ∈ O(n²). No es una igualdad de verdad, porque no se puede leer al revés: n = O(n²) y n² = O(n²) son ciertas, y no por eso n = n². Aquí usamos ∈ cuando estamos definiendo o demostrando, y en el texto corrido decimos “es Θ(n)”.
Reglas para no volver a las definiciones cada vez
Todas salen de las definiciones con una cuenta corta.
Los factores constantes no cuentan. Si a > 0, entonces a · f ∈ Θ(f): sirven c₁ = c₂ = a.
En una suma manda el mayor. Para f y g no negativas:
max(f(n), g(n)) ≤ f(n) + g(n) ≤ 2 · max(f(n), g(n))La izquierda vale porque el otro sumando no es negativo, y la derecha porque cada sumando es a lo más el máximo. Entonces f + g ∈ Θ(max(f, g)). Por eso 3n² + 10n + 7 es Θ(n²), y un polinomio de grado k con coeficientes no negativos y el primero positivo es Θ(nᵏ).
La base del logaritmo no importa. Para a, b > 1, log_a n = log_b n / log_b a, y log_b a es una constante. Así que log₂ n, log₁₀ n y ln n están en la misma clase Θ, y por eso se escribe log n sin base. Tampoco importa el exponente de adentro: log(n²) = 2 log n.
La base de la exponencial sí importa. 2ⁿ⁺¹ = 2 · 2ⁿ está en Θ(2ⁿ), pero 4ⁿ no está en O(2ⁿ): 4ⁿ / 2ⁿ = 2ⁿ crece sin límite, así que ninguna constante c cumple 4ⁿ ≤ c · 2ⁿ.
La cadena. Para n suficientemente grande,
1 < log n < n < n log n < n² < n³ < 2ⁿdonde cada función está en la O de la siguiente, y no al revés. La tabla de arriba lo sugiere. No lo demostramos aquí: las desigualdades como n² ≤ 2ⁿ, que vale desde n = 4, se demuestran bien por inducción en Matemática Discreta.
Una advertencia: no todo par de funciones se puede comparar. Una función que vale n en los pares y n² en los impares está en O(n²) y en Ω(n), pero no en Θ de ninguna de las dos.
Mejor caso, peor caso y caso promedio
Hasta aquí T(n) parecía un solo número para cada n. No lo es: dos entradas del mismo tamaño pueden costar muy distinto. Esta búsqueda se detiene apenas encuentra la key:
int linear_search(const std::vector<int>& values, int key, long long& comparisons) {
    for (std::size_t i = 0; i < values.size(); i++) {
        comparisons++;
        if (values[i] == key) {
            return static_cast<int>(i);
        }
    }
    return -1;
}
Si la key está en la primera posición, hace 1 comparación. Si no está, hace n. Para hablar de “el costo con tamaño n” hay que elegir de cuál entrada estamos hablando. Sea t(x) el costo con la entrada x. Definimos tres funciones de n:
- Peor caso (worst case): T_peor(n) = el máximo de t(x) entre todas las entradas x de tamaño n.
- Mejor caso (best case): T_mejor(n) = el mínimo de t(x) entre todas las entradas x de tamaño n.
- Caso promedio (average case): T_prom(n) = el promedio de t(x) según una distribución de las entradas de tamaño n, que hay que decir cuál es.
Cada una es una función común y corriente de n. El programa cases las cuenta:
$ build/cases
busqueda lineal: comparaciones
       n    mejor     promedio     peor
    1000        1        500.5     1000
    2000        1       1000.5     2000
    4000        1       2000.5     4000
El promedio se calcula buscando cada key del arreglo una vez: se supone que la key está, y que todas las posiciones son igual de probables. Son 1 + 2 + … + n comparaciones entre n búsquedas, o sea, (n + 1) / 2. Si la key pudiera faltar, sería otra cuenta: sin la distribución, “caso promedio” no significa nada.
Con esas funciones: T_mejor(n) = 1, T_prom(n) = (n + 1)/2 y T_peor(n) = n.
Los casos no son las notaciones
Esta es la confusión más frecuente del tema, y hay que deshacerla con cuidado:
- El caso dice qué función estamos describiendo: cuál entrada se elige para cada n.
- La notación dice qué afirmamos de esa función: un techo, un piso, o las dos cosas.
Son dos preguntas independientes. Se pueden combinar todas. Para la búsqueda lineal:
| O | Ω | Θ | |
|---|---|---|---|
| T_mejor(n) = 1 | O(1), O(n) | Ω(1) | Θ(1) |
| T_prom(n) = (n + 1)/2 | O(n), O(n²) | Ω(1), Ω(n) | Θ(n) |
| T_peor(n) = n | O(n), O(n²) | Ω(1), Ω(n) | Θ(n) |
Todas esas celdas son afirmaciones verdaderas. Fíjense en que “O(n²) del peor caso” y “Ω(1) del peor caso” son correctas, y flojas. Y que el mejor caso tiene su propia O: la búsqueda lineal en el mejor caso es O(1), y no hay contradicción en decirlo.
Error común. Creer que O es el peor caso, Ω el mejor caso y Θ el caso promedio. No hay ninguna relación de ese tipo. “El peor caso de la búsqueda lineal es Θ(n)” y “el mejor caso es Θ(1)” son dos afirmaciones exactas sobre dos funciones distintas.
Hay una convención que conviene conocer. Cuando alguien dice “este algoritmo es O(f)” sin nombrar un caso, entiende que la cota vale para toda entrada, lo que equivale a T_peor ∈ O(f). Cuando dice “es Ω(g)” sin nombrar un caso, también entiende toda entrada, lo que equivale a T_mejor ∈ Ω(g). Con esa lectura, la búsqueda lineal es O(n) y Ω(1), y no tiene un Θ sin nombrar un caso, porque su piso y su techo no coinciden. Para evitar la ambigüedad, en el curso vamos a nombrar el caso.
¿Qué dice un peor caso Θ(n)?
Que el peor caso sea Θ(n) significa que T_peor está entre c₁n y c₂n para n ≥ n₀. Desarmemos eso:
- La cota superior habla de todas las entradas: ninguna entrada de tamaño n cuesta más que c₂n.
- La cota inferior habla de alguna entrada: para cada n ≥ n₀ existe una entrada que cuesta al menos c₁n.
Entonces, ¿puede tardar menos que eso en alguna entrada? Sí. La búsqueda lineal tiene peor caso Θ(n), y si la key está al inicio hace una sola comparación. El peor caso no dice nada de las otras entradas, salvo que no pasan del techo.
Un algoritmo con casos muy separados
El ordenamiento por inserción va tomando cada elemento y lo mete en su lugar entre los anteriores, que ya están ordenados:
long long insertion_sort(std::vector<int>& values) {
    long long comparisons = 0;
    for (std::size_t i = 1; i < values.size(); i++) {
        int current = values[i];
        std::size_t j = i;
        while (j > 0) {
            comparisons++;
            if (values[j - 1] <= current) {
                break;
            }
            values[j] = values[j - 1];
            j--;
        }
        values[j] = current;
    }
    return comparisons;
}
Con el arreglo ya ordenado, cada elemento se compara una vez con su anterior y se queda: n − 1 comparaciones. Con el arreglo invertido, cada elemento tiene que pasar por encima de todos los anteriores: 1
- 2 + … + (n − 1) = n(n − 1)/2.
$ build/cases
...
ordenamiento por insercion: comparaciones
       n   ordenado      al azar  invertido
    1000        999       245621     499500
    2000       1999       989741    1999000
    4000       3999      3979189    7998000
Duplicar n duplica la columna de ordenado y cuadruplica la de invertido. Así, el mejor caso es Θ(n) y el peor caso es Θ(n²). La columna del medio es una sola permutación al azar de cada tamaño, con semilla fija; no es un promedio, pero se acerca a él. El promedio sale de un argumento corto: en una permutación al azar, cada par de elementos queda invertido con probabilidad 1/2, y hay n(n − 1)/2 pares, así que hay unas n²/4 inversiones que corregir. También es Θ(n²).
Por qué miramos sobre todo el peor caso
Tres razones. Es una garantía: vale para cualquier entrada, incluso una malintencionada. Es fácil de calcular: el promedio exige suponer una distribución, que quizás sus datos no respeten. Y muchas veces es el caso común: buscar algo que no está es justo el peor caso de una búsqueda.
El caso promedio igual importa, y lo van a usar para analizar tablas hash y quicksort. Siempre va con su supuesto escrito. La próxima semana aparece otra idea distinta, el costo amortizado, que tampoco debe confundirse con el caso promedio.
Leer código: ciclos
Con las notaciones listas, vamos a calcular T(n) mirando el código. Las reglas son pocas:
- Cosas en secuencia se suman. Por la regla de la suma, manda la mayor.
- Un ciclo es la suma de lo que cuesta cada una de sus vueltas. Si todas cuestan lo mismo, es vueltas × costo de una vuelta.
- Una llamada cuesta lo que cuesta la función. Hay que mirar adentro.
El programa count_loops cuenta las vueltas de cinco patrones. Vamos a predecirlos uno por uno, y la tabla
está al final de la sección.
Ciclos en secuencia
long long two_in_sequence(long long n) {
    long long count = 0;
    for (long long i = 0; i < n; i++) {
        count++;
    }
    for (long long i = 0; i < n; i++) {
        count++;
    }
    return count;
}
Son n + n = 2n vueltas: Θ(n). Dos ciclos no significan n². Lo que multiplica es anidar, no poner uno después del otro.
Ciclos anidados
    for (long long i = 0; i < n; i++) {
        for (long long j = 0; j < n; j++) {
            count++;
        }
    }
Cada una de las n vueltas de afuera tiene n de adentro: n · n = n². Es Θ(n²).
El de adentro depende del de afuera
    for (long long i = 0; i < n; i++) {
        for (long long j = 0; j < i; j++) {
            count++;
        }
    }
Aquí las vueltas de afuera no cuestan lo mismo. Cuando i = 0, el de adentro no da ninguna; cuando i = 1, da una; y así hasta i = n − 1. Hay que sumar:
S = 0 + 1 + 2 + ... + (n - 1)Sin inducción: escriban la suma dos veces, una al derecho y otra al revés, y sumen columna por columna.
    S =       0   +     1   + ... + (n - 1)
    S = (n - 1)   + (n - 2) + ... +     0
   --------------------------------------
   2S = (n - 1)   + (n - 1) + ... + (n - 1)    son n términos
Entonces S = n(n − 1)/2. Es Θ(n²): por arriba, n(n − 1)/2 ≤ n²/2 para n ≥ 1, y por abajo, n(n − 1)/2 ≥ n²/4 para n ≥ 2, porque n − 1 ≥ n/2 desde ahí. Es la mitad de los anidados completos, y está en la misma clase.
Error común. Decir que el de adentro “es más corto, así que no llega a n²”. Es más corto, pero en promedio da n/2 vueltas, y n/2 sigue siendo proporcional a n. Una fracción fija no cambia la clase.
Ciclos que dividen entre dos
    for (long long j = n; j > 0; j /= 2) {
        count++;
    }
j vale n, n/2, n/4, …, con división entera. Después de k vueltas, j es a lo más n / 2ᵏ, y el ciclo termina cuando j llega a cero. Eso pasa cuando 2ᵏ > n, o sea, después de ⌊log₂ n⌋ + 1 vueltas, para n ≥ 1. Por ejemplo, con n = 1000, j vale 1000, 500, 250, 125, 62, 31, 15, 7, 3 y 1: son 10 vueltas, y ⌊log₂ 1000⌋ + 1 = 9 + 1 = 10. Es Θ(log n).
Lo mismo pasa si en lugar de dividir un número grande se multiplica uno pequeño: for (i = 1; i < n; i *= 2) también da Θ(log n) vueltas. La señal es que la variable cambia por un factor, y no por una cantidad
fija.
Un ciclo por fuera, y adentro uno que divide
    for (long long i = 0; i < n; i++) {
        for (long long j = i; j > 0; j /= 2) {
            count++;
        }
    }
El de adentro empieza en i. Da 0 vueltas si i = 0, y ⌊log₂ i⌋ + 1 si i ≥ 1. El total es la suma de eso para i de 1 a n − 1. No hace falta una fórmula exacta para saber su clase: basta con acotar, por arriba y por abajo.
Por arriba. Cada una de las (a lo más) n vueltas de afuera da como máximo log₂ n + 1 vueltas adentro. El total es a lo más n (log₂ n + 1), que para n ≥ 2 es a lo más 2n log₂ n.
Por abajo. Nos quedamos solo con la mitad superior, i ≥ n/2. Son al menos n/2 vueltas de afuera, y en cada una el de adentro da al menos log₂(n/2) = log₂ n − 1. El total es al menos (n/2)(log₂ n − 1). Para n ≥ 4 se cumple log₂ n − 1 ≥ (log₂ n)/2, así que el total es al menos (1/4) n log₂ n.
Entonces es Θ(n log n). Este truco de “tirar la mitad de la suma y acotar lo que queda” sirve muy seguido para las cotas inferiores.
Los cinco, contados
$ build/count_loops
patron                 n=1000     n=2000     n=4000     n=8000   razon
secuencia                2000       4000       8000      16000    2.00
anidados              1000000    4000000   16000000   64000000    4.00
triangulo              499500    1999000    7998000   31996000    4.00
divide                     10         11         12         13    1.08
triangulo_divide         8977      19953      43905      95809    2.18
La última columna es la cuenta con n = 8000 dividida entre la cuenta con n = 4000. Coinciden con la
predicción: 2n, n², n(n − 1)/2 y ⌊log₂ n⌋ + 1 son exactos, y el programa lo comprueba con assert. Fíjense
en la fila de divide: cada vez que n se duplica, la cuenta suma 1. Esa es la marca de un logaritmo. La
última fila queda entre las cotas calculadas: con n = 1000, entre (1/4) · 1000 · 9.97 ≈ 2492 y 2 · 1000 ·
9.97 ≈ 19 932.
Lo que un ciclo esconde
Un ciclo se ve barato, hasta que se mira lo que llama adentro:
for (i = 0; i < strlen(s); i++)en C es Θ(n²), si el compilador no logra sacar la llamada del ciclo, porquestrlenrecorre toda la cadena en cada vuelta. Constd::string,s.size()es Θ(1).values.insert(values.begin(), x)en unstd::vectorno es una operación elemental: mueve todo lo que ya hay. Un ciclo que la llama n veces hace Θ(n²) movimientos.- Pasar un
std::vectorpor valor copia todos sus elementos: es Θ(n) antes de empezar. Por eso, en la semana 1 lo pasaban por referencia constante.
Y también hay que fijarse en cómo sale el ciclo. Con un break o un return adentro, ya no tiene una sola
cuenta, sino varios casos: vuelvan a la sección anterior y digan de cuál hablan.
En la biblioteca. El estándar de C++ escribe los costos en sus contratos, y los escribe en cantidades de operaciones, nunca en segundos.
std::vector::sizees de costo constante.std::vector::insertes lineal en la cantidad de elementos que hay entre la posición y el final.std::sorthace O(n log n) comparaciones, ystd::lower_boundhace a lo más log₂ n + O(1). La lista de complejidades es parte de la interfaz, y por eso conviene leerla.
Recursión: el árbol de llamadas
En una función recursiva no se ven las vueltas, pero el método es igual de mecánico. Se dibuja el árbol de llamadas: cada llamada es un nodo, y sus hijos son las llamadas que hace. El costo total es la suma del trabajo de todos los nodos, y se suma por niveles.
Para escribir el costo de una función recursiva se usa una ecuación, por ejemplo T(n) = 2 T(n/2) + 1. Dice:
resolver tamaño n cuesta dos veces el tamaño n/2, más una cantidad constante de trabajo propio. El programa
call_tree cuenta cuatro casos. Para dibujarlos, tomamos n como una potencia de 2, y después vemos qué pasa
con los otros.
Una llamada con n/2
void one_half(long long n, int depth, Tally& tally) {
    tally.calls++;
    tally.work++;
    tally.deepest = std::max(tally.deepest, depth);
    if (n <= 1) {
        return;
    }
    one_half(n / 2, depth + 1, tally);
}
El árbol es una sola rama: 8 → 4 → 2 → 1. Con n = 2ᵏ hay k + 1 = log₂ n + 1 llamadas, y cada una hace trabajo constante: T(n) ∈ Θ(log n). Es el ciclo que divide, escrito de otra forma.
Dos llamadas con n/2 y trabajo constante
Esta es la pregunta que hay que saber responder. Dibujemos n = 8:
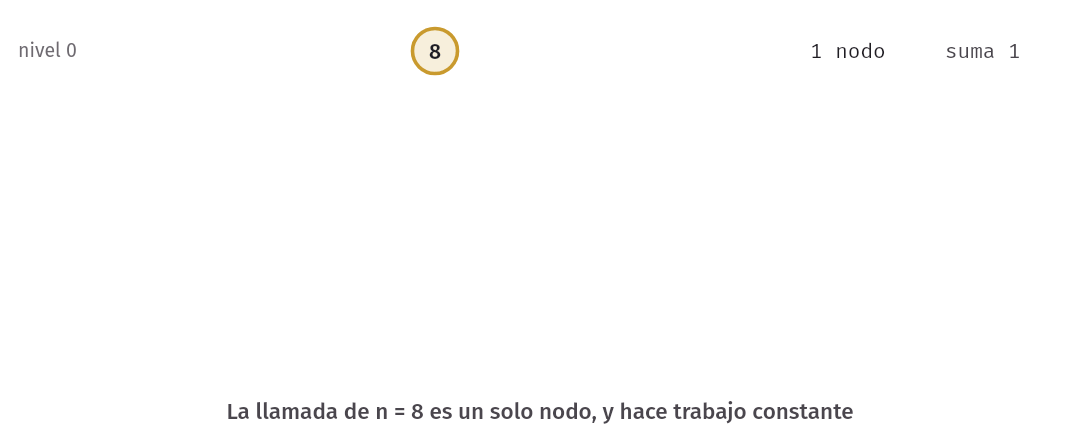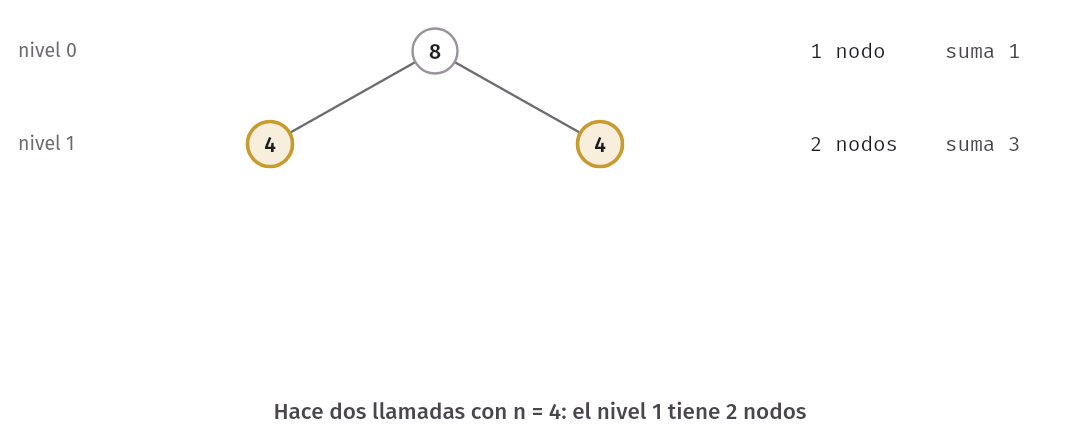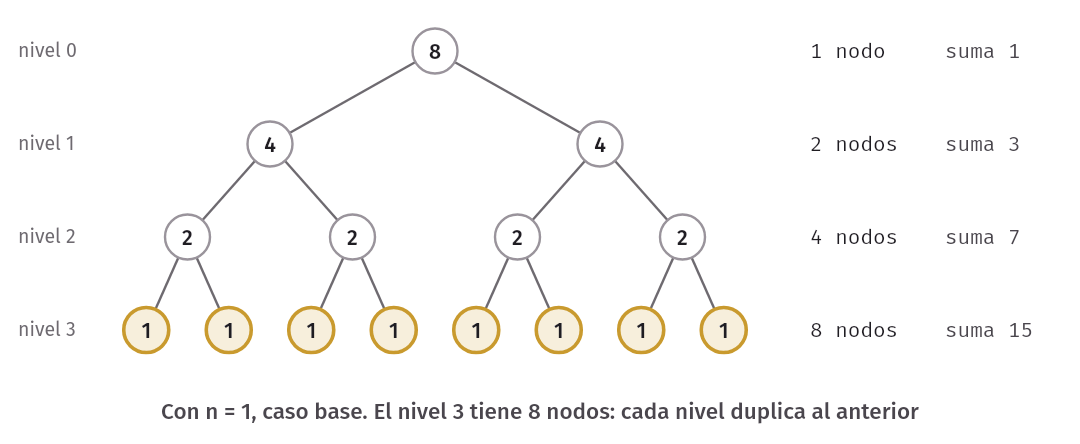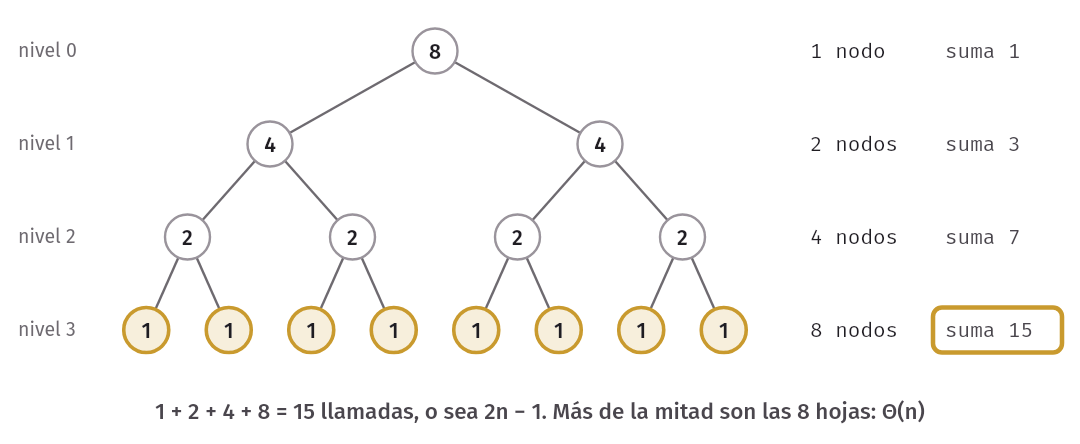
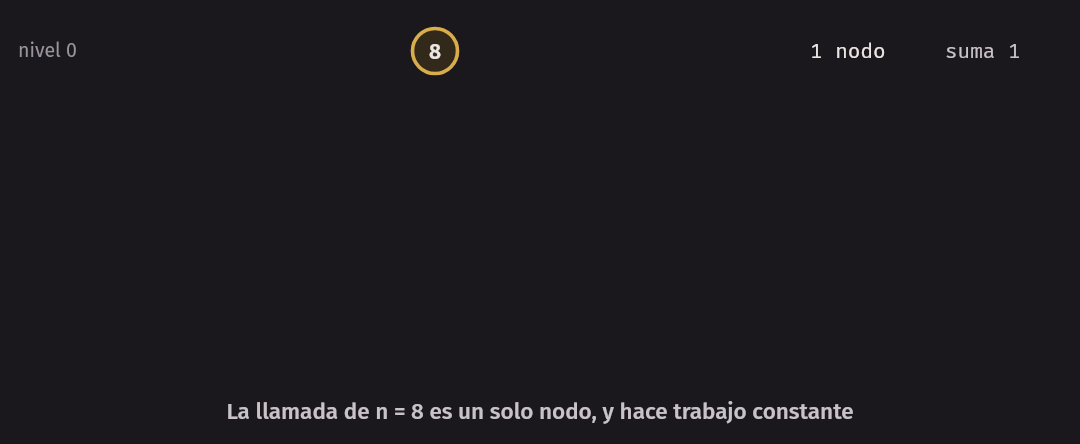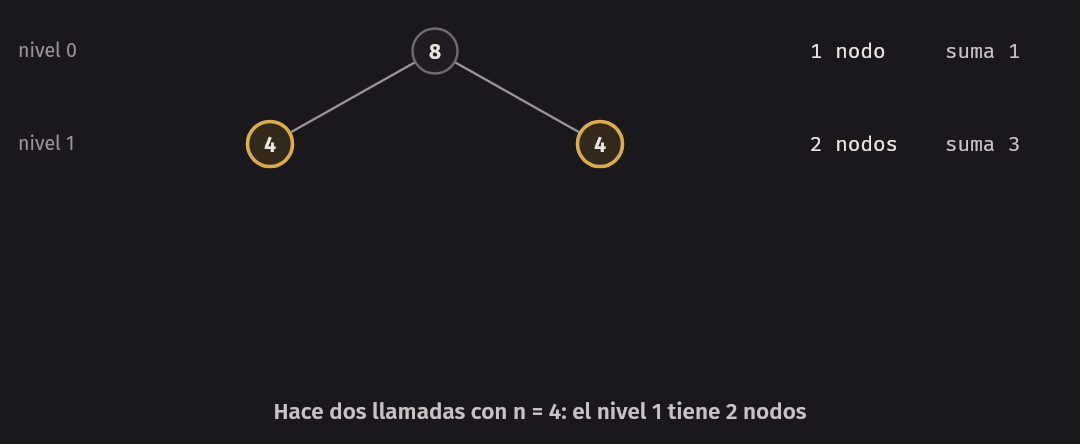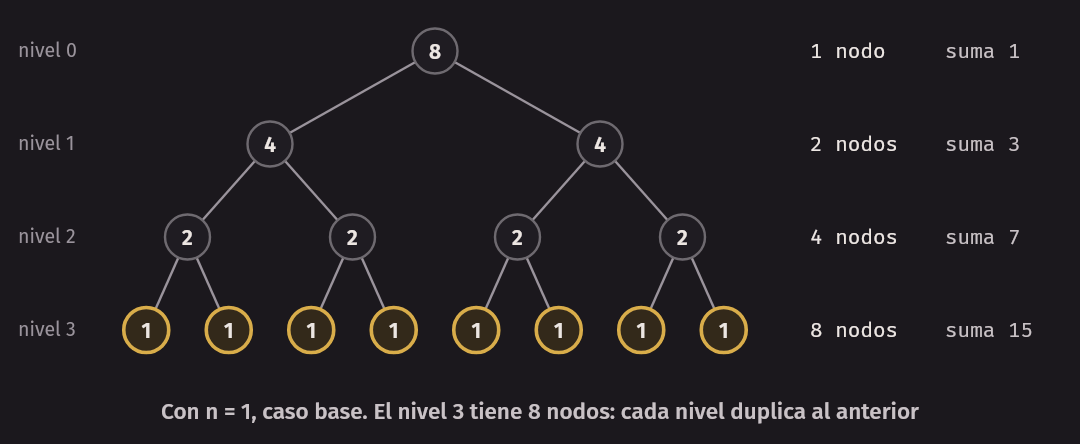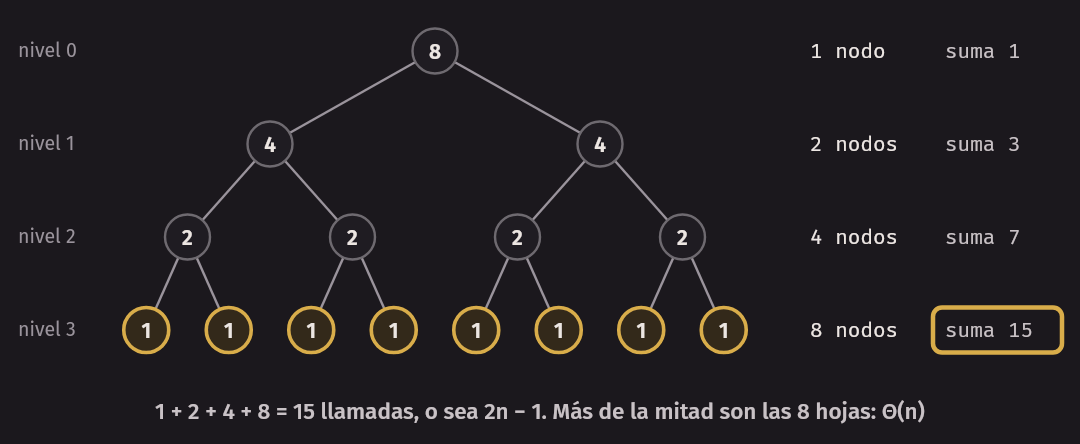
El nivel i tiene 2ⁱ nodos. Hay log₂ n + 1 niveles, numerados de 0 a k = log₂ n. El total de llamadas es:
S = 1 + 2 + 4 + ... + 2^kOtra suma que se resuelve sin inducción. Multipliquen por 2 y resten:
2S =     2 + 4 + ... + 2^k + 2^(k+1)
 S = 1 + 2 + 4 + ... + 2^k
--------------------------------------
2S - S = 2^(k+1) - 1
Todo lo del medio se cancela. Como 2ᵏ = n, resulta S = 2n − 1 llamadas. Con n = 8 son 15, y el dibujo tiene 15 nodos. Como cada llamada hace trabajo constante, T(n) ∈ Θ(n).
Es lo que sorprende: la recursión tiene dos llamadas y da lineal. La suma geométrica está dominada por su último nivel: en una suma de potencias de 2, el último término es más o menos la mitad del total. La mitad de las llamadas son hojas.
$ build/call_tree
...
T(n) = 2 T(n/2) + 1
         n     llamadas      trabajo profund.
         8           15           15        3
        16           31           31        4
      1024         2047         2047       10
      2048         4095         4095       11

T(n) = 2 T(n/2) + 1, n que no es potencia de 2
         n     llamadas      trabajo profund.
         5            7            7        2
         6            7            7        2
         7            7            7        2
         9           15           15        3
      1000         1023         1023        9
      1500         2047         2047       10
¿Y si n no es potencia de 2? Con la división entera, la profundidad es k = ⌊log₂ n⌋, y sigue habiendo 2ⁱ nodos en cada nivel, así que las llamadas son 2ᵏ⁺¹ − 1. Como 2ᵏ ≤ n < 2ᵏ⁺¹, eso queda entre n y 2n − 1, lo que confirma la tabla: la clase sigue siendo Θ(n). Casi siempre pasa lo mismo: hacer la cuenta con potencias de 2 da la clase correcta, y es lo que vamos a hacer.
Dos llamadas con n/2 y trabajo lineal
Ahora cada nodo hace trabajo proporcional a su tamaño: T(n) = 2 T(n/2) + n. Es la forma de mergesort, que veremos más adelante. Sumemos por niveles, con n = 8:
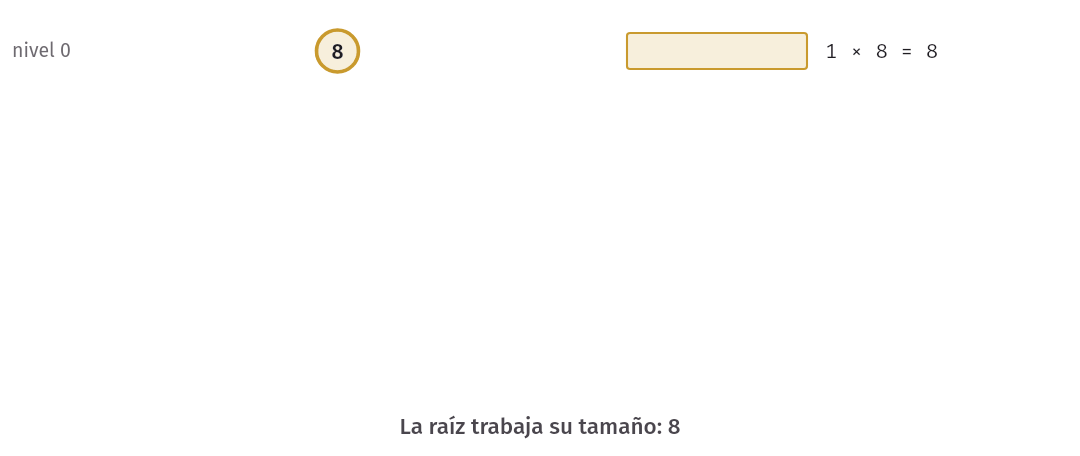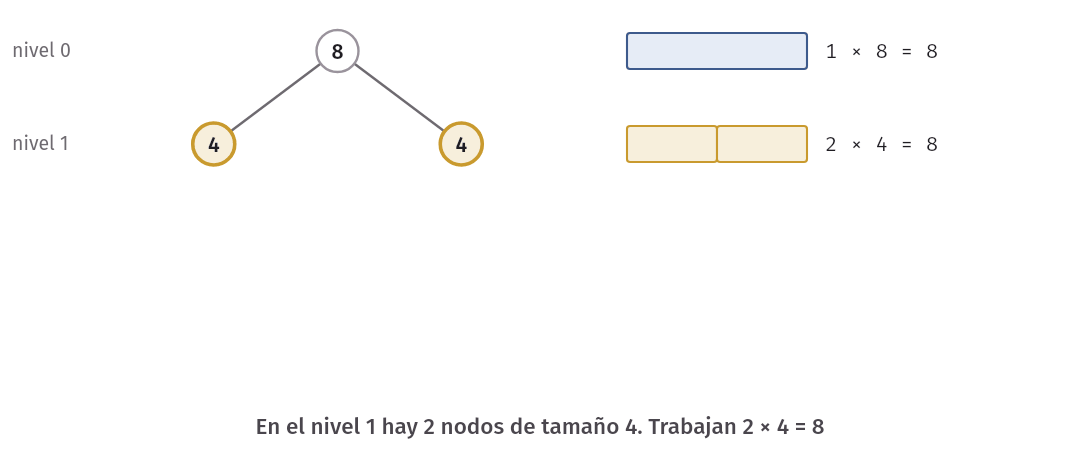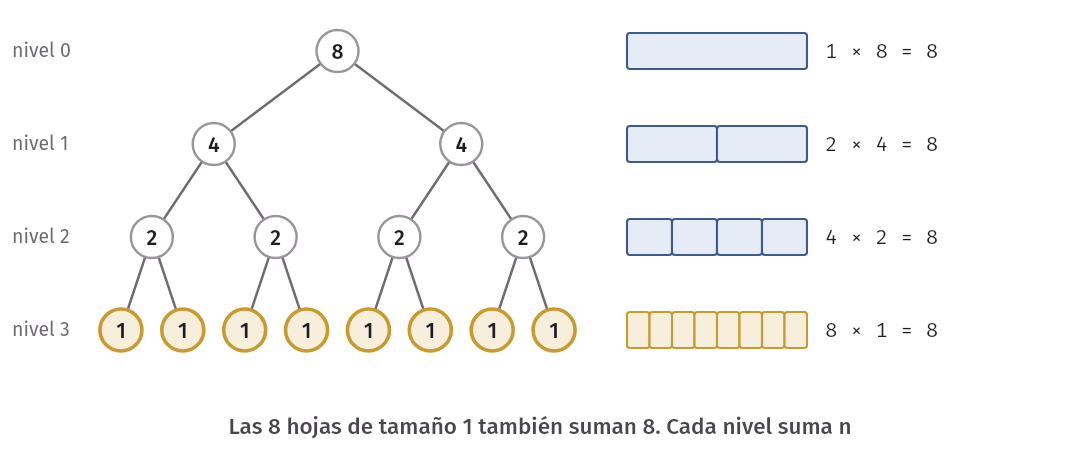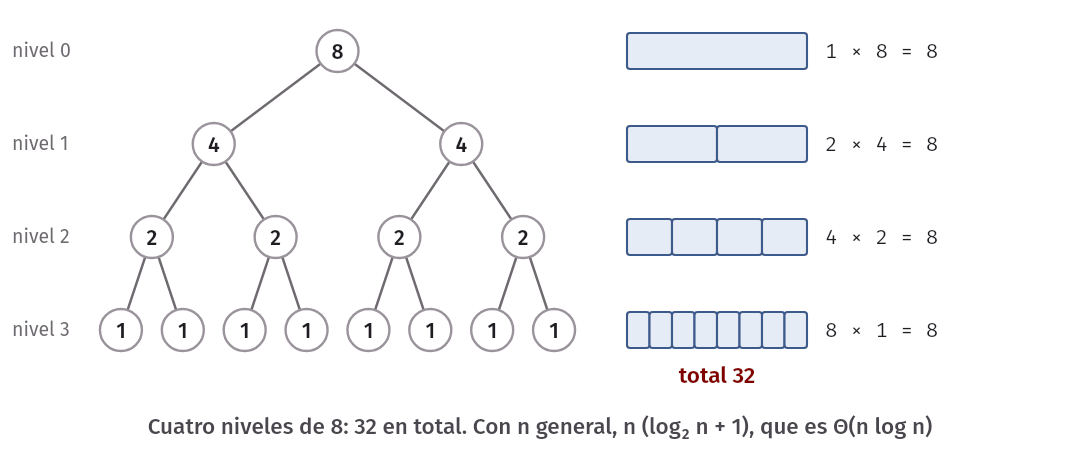
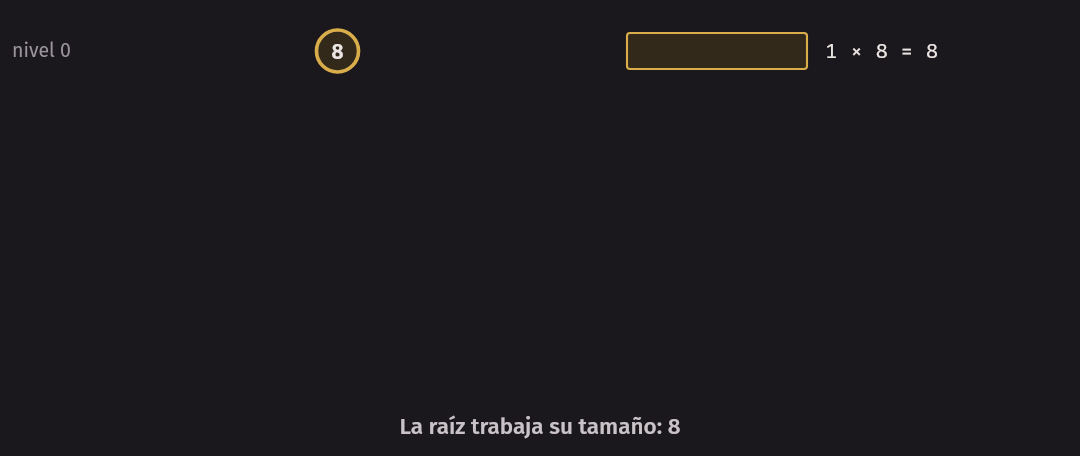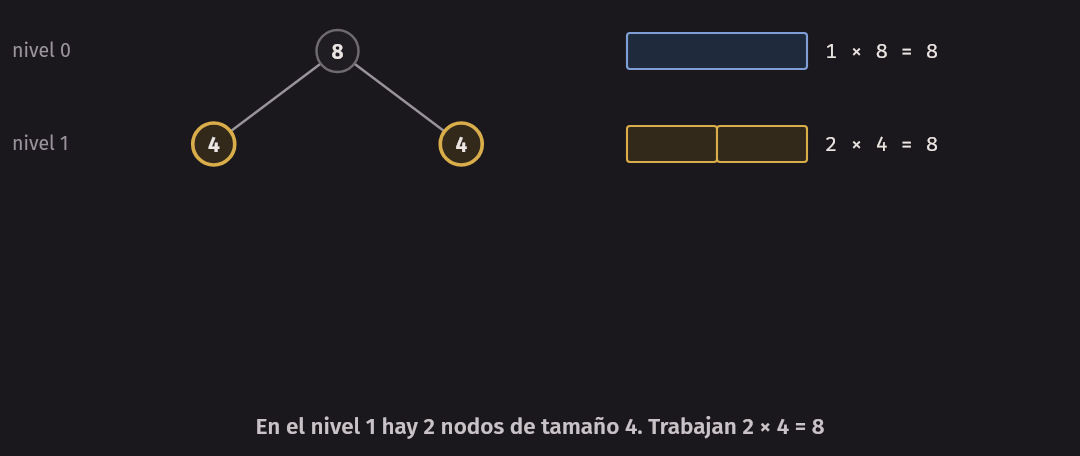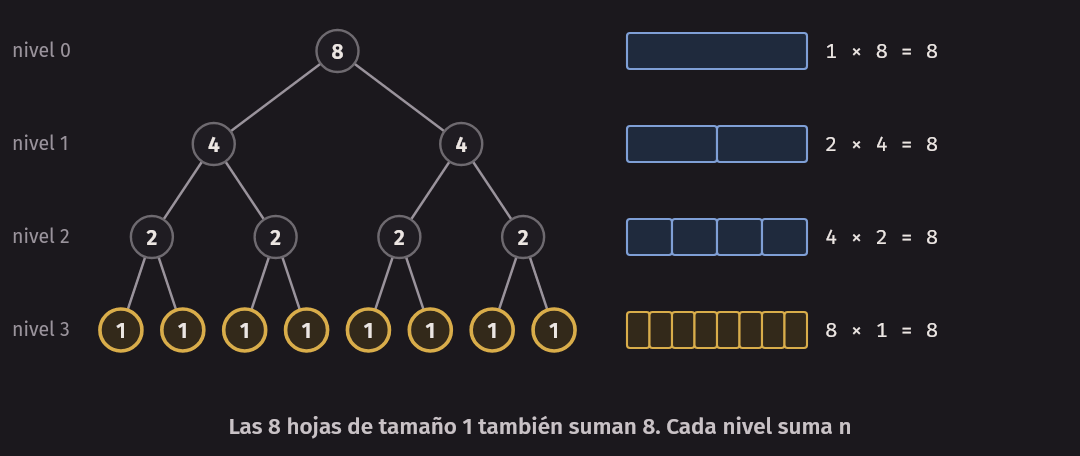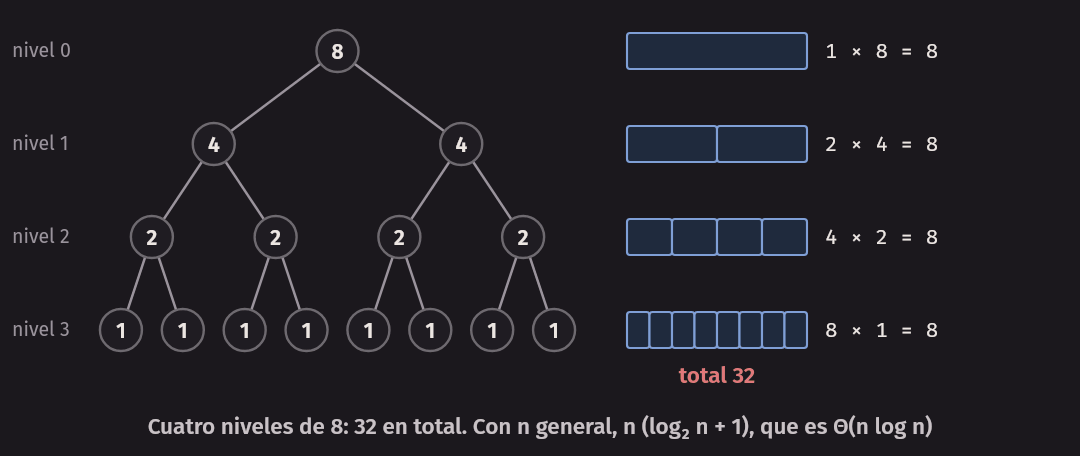
En cada nivel hay el doble de nodos, de la mitad de tamaño: cada nivel suma n. Hay log₂ n + 1 niveles. Total: n (log₂ n + 1), que es Θ(n log n). Con n = 8 da 8 × 4 = 32, y con n = 1024 da 1024 × 11 = 11 264.
$ build/call_tree
...
T(n) = 2 T(n/2) + n
         n     llamadas      trabajo profund.
         8           15           32        3
        16           31           80        4
      1024         2047        11264       10
      2048         4095        24576       11
Las llamadas son las mismas que en el caso anterior. Lo que cambió fue el trabajo por llamada.
Dos llamadas con n − 1
void two_minus_one(long long n, int depth, Tally& tally) {
    tally.calls++;
    tally.work++;
    tally.deepest = std::max(tally.deepest, depth);
    if (n == 0) {
        return;
    }
    two_minus_one(n - 1, depth + 1, tally);
    two_minus_one(n - 1, depth + 1, tally);
}
Parece igual a la de n/2, y es otro mundo. El tamaño baja de 1 en 1, así que el árbol tiene n + 1 niveles en lugar de log n. Los niveles siguen duplicándose: 1, 2, 4, …, 2ⁿ. Con la misma suma geométrica, el total es 2ⁿ⁺¹ − 1: Θ(2ⁿ).
$ build/call_tree
...
T(n) = 2 T(n-1) + 1
         n     llamadas      trabajo profund.
         5           63           63        5
        10         2047         2047       10
        20      2097151      2097151       20
Lo que define el resultado es cuántos hijos tiene cada nodo y qué tan rápido baja el tamaño. Dos hijos con n/2 dan un árbol ancho pero bajo. Dos hijos con n − 1 dan un árbol alto y además ancho.
Idea clave. Para analizar una recursión: dibujen el árbol; digan cuántos niveles tiene y cuántos nodos hay en cada uno; calculen el trabajo de un nivel; y sumen. Con eso se resuelve todo lo que aparece en este curso.
Espacio además de tiempo
La memoria también es un recurso, y se describe con las mismas notaciones. El espacio de un algoritmo es la memoria que usa además de la entrada, como función de n.
Dos formas de invertir un arreglo: crear uno nuevo y copiar al revés usa Θ(n) de espacio; intercambiar los extremos hacia el centro, con dos índices, usa Θ(1). Las dos toman tiempo Θ(n). A esa segunda forma se la llama en el lugar (in place).
Hay un costo de espacio que no se ve en el código: la pila. Cada llamada recursiva activa tiene su
marco, y los marcos solo se liberan al retornar. Por eso, el espacio de una recursión no depende de cuántas
llamadas hay en total, sino de cuántas hay activas a la vez, y eso es la profundidad del árbol. Es la
última columna de call_tree:
| Función | Tiempo | Profundidad, y por lo tanto espacio en la pila |
|---|---|---|
| T(n) = T(n/2) + 1 | Θ(log n) | Θ(log n) |
| T(n) = 2 T(n/2) + 1 | Θ(n) | Θ(log n) |
| T(n) = 2 T(n/2) + n | Θ(n log n) | Θ(log n) |
| T(n) = 2 T(n − 1) + 1 | Θ(2ⁿ) | Θ(n) |
Con n = 20, la última hace más de dos millones de llamadas, pero nunca tiene más de 21 marcos activos: cuando una rama termina, sus marcos ya se liberaron. El tiempo se acumula, y el espacio se reutiliza.
Y al revés: una función que recorre un arreglo recursivamente, con una llamada por elemento, tiene tiempo Θ(n), igual que un ciclo, pero también espacio Θ(n) en la pila. La pila del entorno es pequeña, de unos 8 MB, así que con un n grande esa función cae, y el ciclo no.
Error común. Decir “no reservé memoria con
new, así que el espacio es Θ(1)”. La recursión profunda usa pila, y una copia destd::vectorusa heap aunque no se vea ningúnnew.
Medir: el reloj
Empieza la segunda mitad. Vamos a contrastar las predicciones con un reloj de verdad. En C++, los relojes
están en <chrono>. El que se usa para medir duraciones es std::chrono::steady_clock:
    auto start = std::chrono::steady_clock::now();
    long long total = sum_values(values);
    auto stop = std::chrono::steady_clock::now();
    keep(total);
    double seconds = std::chrono::duration<double>(stop - start).count();
now() devuelve un instante. Restar dos instantes da una duración, y duration<double> la expresa en
segundos con decimales. auto les ahorra escribir los tipos, que son largos.
En C++.
<chrono>trae varios relojes.std::chrono::system_clockes la hora del calendario: se puede ajustar mientras el programa corre, por ejemplo al sincronizarse por la red, y entonces una resta puede dar cualquier cosa, incluso un número negativo.std::chrono::steady_clocknunca retrocede: por eso sirve para medir duraciones, aunque su valor absoluto no signifique nada.
El reloj no es infinitamente fino. first_timer busca el salto más pequeño que se alcanza a ver entre dos
lecturas, y en la máquina de estos apuntes dio 41 ns. Eso importa: una operación que dura 20 ns no se
puede medir con una sola lectura, porque el resultado sería 0 o 41. La solución es medir una tanda de
muchas llamadas seguidas y dividir el tiempo entre el tamaño de la tanda. Lo haremos en el experimento de
duplicar.
Medir: con -O2 y sin sanitizers
Las mediciones se compilan con -O2, la optimización que se usa en un programa terminado. Sin esa
opción, g++ usa -O0: genera código sencillo de depurar, y mucho más lento. Medir con -O0 responde a una
pregunta que no le interesa a nadie: cuánto tarda un programa que nadie ejecutaría así. En el laboratorio
van a comprobar con sus propios números qué cambia y qué no.
Y sin sanitizers. ASan agrega una comprobación antes de cada acceso a memoria, y le da otro manejo al
heap: los bloques liberados quedan un tiempo en cuarentena para detectar usos después de free. Por lo
tanto, el programa instrumentado es otro programa, y no se encarece de manera pareja. Comparemos las mismas
dos operaciones, las dos con -O2, sin sanitizers y con sanitizers:
$ build/sanitizer_cost
suma de 1000000 enteros:       355 us
100000 bloques pequenos:       978 us
bloques / suma:               2.76
$ build/sanitizer_cost_san
suma de 1000000 enteros:      1277 us
100000 bloques pequenos:     11995 us
bloques / suma:               9.40
La suma se volvió unas 3.6 veces más lenta. Los bloques, unas 12 veces. Ese es el problema de fondo. Si fuera solo un factor parejo, daría igual, pero cada operación se encarece distinto: la razón entre las dos pasó de 2.8 a 9.4. Una comparación “¿A o B?” medida con sanitizers puede dar la respuesta equivocada sobre el programa real.
Nada de esto significa que los sanitizers sean malos: son para otra cosa. El flujo es: primero, comprobar
que el programa es correcto, con sanitizers; después, medirlo, sin ellos. Por eso, el Makefile de esta
semana compila con sanitizers lo que cuenta y lo que prueba, y con -O2 lo que mide.
Medir: repetir y usar la mediana
Dos corridas del mismo programa no tardan lo mismo. Estas son nueve mediciones de la misma suma, en
microsegundos, en una corrida de first_timer:
350 349 358 349 367 349 349 355 349Y en otra corrida:
361 349 349 357 349 349 357 349 349Y en una tercera, el ruido se notó más: con 349 356 907 349 349 364 349 349 360, la media dio 415 us y la
mediana 349 us.
El ruido no es simétrico. El sistema operativo puede interrumpir el programa, otro proceso puede ocupar la cache o el procesador puede bajar su frecuencia: casi todo lo que perturba una medición la hace más lenta. Nada la hace más rápida que su tiempo real. Por eso, los valores atípicos están todos de un lado, y la media se deja arrastrar por ellos. La mediana, el valor del medio al ordenar, los ignora: ese 907 no la movió.
Ese es el trabajo de bench.h, nuestro medidor:
inline double median_of(std::vector<double> values) {
    assert(!values.empty());
    std::sort(values.begin(), values.end());
    std::size_t middle = values.size() / 2;
    if (values.size() % 2 == 1) {
        return values[middle];
    }
    return (values[middle - 1] + values[middle]) / 2.0;
}
template <typename Fn>
double median_seconds(int reps, Fn fn) {
assert(reps >= 1);
std::vector<double> times;
times.reserve(static_cast<std::size_t>(reps));
for (int i = 0; i < reps; i++) {
auto start = std::chrono::steady_clock::now();
fn();
auto stop = std::chrono::steady_clock::now();
times.push_back(std::chrono::duration<double>(stop - start).count());
}
return median_of(times);
}median_seconds es un template: Fn es cualquier cosa que se pueda llamar sin argumentos. Se usa con una
lambda, una función sin nombre que se escribe en el lugar:
double seconds = median_seconds(9, [&] { sum_values(values); });El [&] significa que la lambda puede usar por referencia las variables de alrededor. No tienen que saber
más de lambdas por ahora.
Error común. Preparar los datos dentro de la lambda. Todo lo que pasa dentro de
fncuenta como tiempo medido. Si crean el arreglo adentro, están midiendo cuánto cuesta crearlo. Lo que no se quiere medir va antes de llamar amedian_seconds.
Medir: el compilador puede borrar lo que están midiendo
La línea de arriba, la que llama a sum_values dentro de una lambda, tiene un error. Fíjense en qué dice
este programa, compilado con -O2:
$ g++ -Wall -Wextra -std=c++20 -O2 errors/no_keep.cpp -o build/no_keep
$ build/no_keep
n =  1000000   sin keep:          0 ns
n =  1000000   con keep:     351958 ns
n =  2000000   sin keep:          0 ns
n =  2000000   con keep:     714750 ns
n =  4000000   sin keep:          0 ns
n =  4000000   con keep:    1421750 ns
Sumar cuatro millones de enteros en 0 ns no es muy creíble. Y es que no los sumó. El estándar permite al
compilador cualquier cambio que no altere lo que el programa hace por fuera. El resultado de sum_values no
se usa, así que el ciclo no tiene ningún efecto visible, y se puede borrar. Lo que queda son dos lecturas
seguidas del reloj.
Sin el aviso, un resultado así puede parecer una gran noticia: “¡mi algoritmo es instantáneo!”. Si un tiempo no crece con n, o es sospechosamente pequeño, primero duden de la medición.
La solución es usar el resultado. keep le dice al compilador que alguien lo necesita:
template <typename T>
void keep(const T& value) {
    asm volatile("" : : "r"(&value) : "memory");
}
seconds = median_seconds(9, [&] { keep(sum_values(values)); });Esa línea rara es un bloque de ensamblador vacío: no genera ninguna instrucción. Lo que hace es avisarle
al compilador que ese bloque recibe la dirección de value y que puede leer cualquier memoria, así que
value tiene que estar calculado en ese punto. No tienen que aprender a escribir esto. Sí tienen que saber
que es una extensión de g++ y de clang, y no parte del estándar de C++.
La tabla confirma que funciona: con keep, el tiempo se duplica al duplicar n.
keep no alcanza siempre
keep protege el resultado. No protege el camino para llegar a él. Este ciclo anidado cuenta
vueltas, que es justo lo que hicimos en count_loops, y su resultado se guarda con keep:
long long nested_count(long long n) {
    long long count = 0;
    for (long long i = 0; i < n; i++) {
        for (long long j = 0; j < n; j++) {
            count++;
        }
    }
    return count;
}
$ g++ -Wall -Wextra -std=c++20 -O2 errors/closed_form.cpp -o build/closed_form
$ build/closed_form
n = 1000 vueltas = 1000000 41 ns
n = 2000 vueltas = 4000000 41 ns
n = 4000 vueltas = 16000000 0 ns
n = 8000 vueltas = 64000000 0 ns
$ g++ -Wall -Wextra -std=c++20 -O0 errors/closed_form.cpp -o build/closed_form_O0
$ build/closed_form_O0
n = 1000 vueltas = 1000000 1471000 ns
n = 2000 vueltas = 4000000 5889000 ns
n = 4000 vueltas = 16000000 23444084 ns
n = 8000 vueltas = 64000000 93936667 nsEl resultado es correcto, y el tiempo no crece. Con -O2, g++ se dio cuenta de que esos ciclos solo
calculan n · n y los reemplazó por una multiplicación. ¡Con -O2, esta función es Θ(1)! Con -O0 sí da sus
n² vueltas, y el tiempo se cuadruplica.
Es decir, el compilador puede cambiar la clase de crecimiento de un programa concreto. No es una trampa: es
su trabajo. La lección práctica es que para medir, el trabajo debe depender de los datos de una forma
que el compilador no pueda resumir en una fórmula. Por ejemplo, leer los elementos de un arreglo, como en la
suma. Contar vueltas sirve para contar, como en count_loops, que por eso se compila sin -O2. Para medir,
no sirve.
Tampoco repitan siempre los mismos datos
Una última trampa, más sutil. Este programa ordena con std::sort 200 copias del mismo arreglo, cada una
una vez, y luego 200 arreglos distintos del mismo tamaño:
$ g++ -Wall -Wextra -std=c++20 -O2 errors/same_array.cpp -o build/same_array
$ build/same_array
       n     mismo (us) distintos (us)
    1000            7.5           33.6
    4000           37.8          160.3
   16000          467.2          744.5
Ordenar los mismos datos resulta unas cuatro veces más rápido con n pequeño, aunque el algoritmo y el
tamaño son los mismos. Lo más probable es que sea el predictor de saltos del procesador: la parte del
hardware que adivina hacia dónde irá cada if. Con datos que se repiten, llega a aprenderse el recorrido.
No lo demostramos aquí, pero el efecto se repitió en todas las corridas. Por eso, doubling.cpp ordena un
arreglo distinto en cada repetición.
Idea clave. Una medición honesta tiene cinco partes:
-O2y sin sanitizers; varias repeticiones y la mediana; el resultado usado conkeep; trabajo que dependa de los datos, y datos que no se repitan si el algoritmo depende de su orden. Y si el resultado les parece demasiado bueno, sospechen.
El experimento de duplicar
Ya sabemos predecir y ya sabemos medir. El experimento de duplicar (doubling experiment) los conecta: se mide T(n), T(2n), T(4n), … y se calcula la razón entre cada tiempo y el anterior.
Las razones tienen una ventaja sobre los tiempos. Los segundos dependen de la máquina, pero, si T(n) ≈ c · nᵏ, la constante c se cancela:
T(2n)     c · (2n)^k
-----  ≈  ---------- = 2^k
T(n)       c · n^k
Es decir: el exponente se puede leer directamente en la razón, y no depende de c. Esto es lo que predice cada clase:
| Clase | T(2n) / T(n) | Cuando n crece |
|---|---|---|
| 1 | 1 | 1 |
| log n | (log₂ n + 1) / log₂ n | tiende a 1 (con n = 1024, 1.10) |
| n | 2 | 2 |
| n log n | 2 (log₂ n + 1) / log₂ n | tiende a 2 (con n = 1024, 2.20; con n = 2²⁰, 2.10) |
| n² | 4 | 4 |
| n³ | 8 | 8 |
| 2ⁿ | 2ⁿ | crece sin límite |
Dos preguntas de práctica. Un programa tarda 1, 2, 4 y 8 segundos con n = 1000, 2000, 4000 y 8000: las razones son 2, así que sugiere crecimiento lineal o casi lineal. Si tarda 1, 4, 16 y 64 segundos: las razones son 4, y sugiere cuadrático.
Un experimento de verdad
doubling.cpp mide tres cálculos sobre un arreglo de enteros al azar: una suma (Θ(n)), std::sort (que es
Θ(n log n) en comparaciones), y contar los pares desordenados con dos ciclos anidados (Θ(n²)):
long long count_inversions(const std::vector<int>& values) {
    long long count = 0;
    for (std::size_t i = 0; i < values.size(); i++) {
        for (std::size_t j = i + 1; j < values.size(); j++) {
            if (values[i] > values[j]) {
                count++;
            }
        }
    }
    return count;
}
Para la suma y las inversiones usa una tanda, que mide fn repetida hasta durar al menos 2 ms, y toma la
mediana de 7 tandas. Para std::sort usa la mediana de 15 arreglos distintos, cada uno ordenado una sola
vez. Se compiló con -O2, y los tiempos son de una máquina concreta con otras cosas corriendo, así que
los números de ustedes van a ser otros. Las razones deberían parecerse.
$ build/doubling
suma
         n   T(n) en us   razon  T/n (ns)
      8000         2.89       -      0.36
     16000         5.72    1.98      0.36
     32000        11.54    2.02      0.36
     64000        23.41    2.03      0.37
    128000        46.95    2.01      0.37
    256000        93.81    2.00      0.37

std::sort
         n   T(n) en us   razon  T/n (ns)
      8000       348.96       -     43.62
     16000       737.62    2.11     46.10
     32000      1597.29    2.17     49.92
     64000      3387.62    2.12     52.93
    128000      7159.25    2.11     55.93
    256000     15253.46    2.13     59.58

inversiones
         n   T(n) en us   razon  T/n (ns)
      1000       186.79       -    186.79
      2000       727.36    3.89    363.68
      4000      2862.75    3.94    715.69
      8000     11379.79    3.98   1422.47
     16000     45618.62    4.01   2851.16
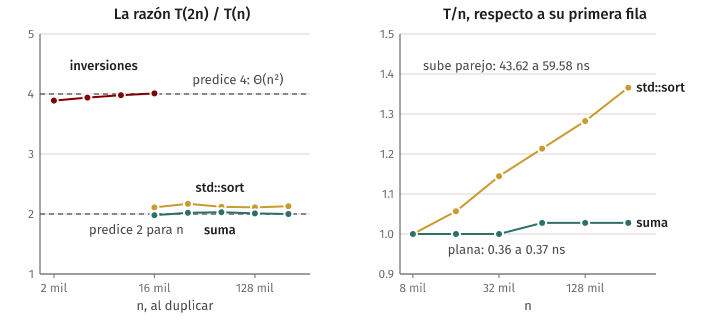
Las predicciones se cumplen. Las inversiones suben hacia 4: la razón 3.89 del inicio se debe a los términos
de menor orden, que todavía pesan con n pequeño. La suma se queda en 2. En std::sort, la predicción para
pasar de n = 8000 a n = 16 000 es 2 · log₂ 16000 / log₂ 8000 ≈ 2.15, y salió 2.11.
Cómo distinguir clases parecidas
Con n log n, la razón es 2.1 o 2.2: muy cerca de 2. Una sola razón no alcanza para separarla de n, sobre
todo con ruido. Para eso sirve la última columna, T/n, el tiempo por elemento: en la suma se mantiene
plana; en std::sort sube un poco en cada fila, y de forma pareja (de 43.62 a 59.58 ns). Si T es
proporcional a n log n, entonces T/n es proporcional a log n, y crece una cantidad fija cada vez que n se
duplica. Es la marca de un logaritmo otra vez.
Lo mismo pasa entre 1 y log n, cuyas razones están ambas cerca de 1. La razón no los separa, pero la
diferencia T(2n) − T(n) sí: con log n, cada duplicación suma lo mismo, mientras que con una constante no
suma nada. Es lo que vieron en la fila divide de count_loops: 10, 11, 12, 13.
| Si la razón está cerca de… | Miren | Para decidir |
|---|---|---|
| 1 | T(2n) − T(n) | cerca de 0: constante; una cantidad fija que se repite: log n |
| 2 | T/n | plano: n; sube una cantidad fija por fila: n log n |
| una razón que sigue creciendo | los n | exponencial, o algo peor que cualquier potencia |
Error común. Mirar solo la última fila. Una tabla se lee entera. Una razón que cambia de un valor a otro dice que el programa cambió de régimen, y eso es información.
Lo que el experimento no prueba
Una medición es evidencia, no una demostración, y por tres motivos:
- Solo ve los n que midieron. Lo que pase después de la última fila no está en la tabla. Un programa puede cambiar de comportamiento en un n que no alcanzaron a medir.
- Solo ve las entradas que probaron. Si midieron el mejor caso, midieron el mejor caso. Elegir la entrada es parte del experimento.
- La cuenta de arriba tiene un supuesto: T(n) ≈ c · nᵏ. Si T(n)/nᵏ tiende a una constante positiva, la razón tiende a 2ᵏ. Pero estar en Θ(nᵏ) no basta para eso. La función T(n) = n cuando ⌊log₂ n⌋ es par, y T(n) = 2n cuando es impar, está en Θ(n), con c₁ = 1 y c₂ = 2, y sus razones en potencias de 2 se alternan entre 4 y 1. No tiende a nada.
Y al revés: tampoco la predicción lo dice todo. Por eso se hacen las dos cosas. Cuando coinciden, confíen. Cuando no coinciden, hay algo que aprender: un error en la cuenta, un error en la medición, o algo que el modelo no estaba viendo. De eso último trata la siguiente sección.
Lo que O no ve
Θ tiró dos cosas a la basura: las constantes y los n pequeños. Además, supuso que todas las operaciones elementales cuestan lo mismo. Las tres cosas pueden morder.
Las constantes: O(n) no siempre gana a O(n²)
Queremos saber si un arreglo de n enteros, cada uno entre 0 y 2²⁰ − 1, tiene algún repetido. Dos soluciones:
bool has_duplicate_pairs(const std::vector<int>& values) {
    for (std::size_t i = 0; i < values.size(); i++) {
        for (std::size_t j = i + 1; j < values.size(); j++) {
            if (values[i] == values[j]) {
                return true;
            }
        }
    }
    return false;
}
bool has_duplicate_table(const std::vector<int>& values) {
std::vector<char> seen(TABLE_SIZE, 0);
for (int value : values) {
std::size_t position = static_cast<std::size_t>(value);
if (seen[position] != 0) {
return true;
}
seen[position] = 1;
}
return false;
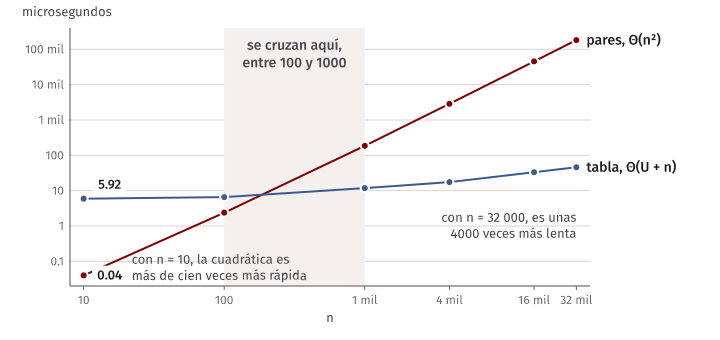
}Llamemos U = 2²⁰ al tamaño de la tabla. Medimos con valores distintos, que es el peor caso de las dos. Eso solo es posible mientras n ≤ U: con más valores que U, alguno se repite a la fuerza. En ese rango, la primera hace n(n − 1)/2 comparaciones, que es Θ(n²). La segunda limpia U casillas, siempre, y hace una pasada: cuesta Θ(U + n).
$ build/small_n
       n     pares (us)     tabla (us)  pares/tabla
      10           0.04           5.92        0.007
     100           2.38           6.54        0.363
    1000         185.46          11.79       15.727
    4000        2868.33          17.38      165.084
   16000       45519.33          33.21     1370.734
   32000      181941.17          45.92     3962.392
Con n = 10, la cuadrática es más de cien veces más rápida. Con n = 32 000, es unas 4000 veces más lenta. Se cruzan en algún punto entre 100 y 1000 en esta máquina. Ni la predicción ni la medición se equivocan: con U fijo, la tabla gana cuando n es grande, y “n grande” es una parte de la afirmación que muchos olvidan.
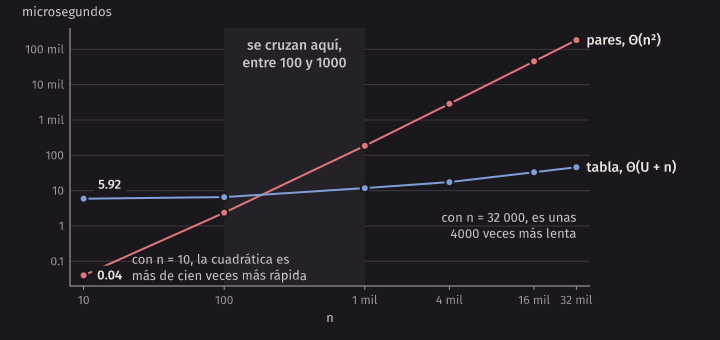
Error común. Decir que un algoritmo O(n) siempre gana a uno O(n²). Solo lo garantiza desde algún n, y antes de eso puede perder. Peor aún: O es solo un techo, y un O(n²) puede ser en realidad mucho mejor. Si sus datos son siempre pequeños, usen lo más simple.
En la biblioteca. Esto se usa de verdad.
std::sort, en la implementación de g++, deja de partir el arreglo cuando quedan pedazos de 16 elementos o menos (la constante_S_thresholddebits/stl_algo.h), y los termina con ordenamiento por inserción: Θ(n²) en el peor caso, y más rápido que el resto con n tan pequeño.
La cache: no todas las operaciones cuestan lo mismo
El modelo dice que leer values[i] cuesta una constante. Es verdad, en el sentido de que hay un techo. Pero
el techo es muy alto. La RAM es lenta en comparación con el procesador, así que este guarda lo que usó hace
poco en memorias pequeñas y rápidas: la cache. Si el dato está en la cache, leerlo es muy rápido. Si no,
hay que traerlo de la RAM, y eso puede costar decenas de veces más. Además, se trae un bloque entero de
datos vecinos, de modo que leer en orden tiene premio.
cache_walk.cpp sigue una cadena dentro de un arreglo: position = next[position], n veces. Es el mismo
código y la misma cantidad de lecturas en las dos columnas, siempre Θ(n). Lo único que cambia es el orden:
en una, cada posición lleva a la siguiente; en la otra, a una posición al azar. Se muestra el tiempo por
salto:
std::uint32_t walk(const std::vector<std::uint32_t>& next) {
    std::uint32_t position = 0;
    for (std::size_t i = 0; i < next.size(); i++) {
        position = next[position];
    }
    return position;
}
$ build/cache_walk
n KiB ordenado al azar razon
4096 16 1.39 ns 1.40 ns 1.0
65536 256 0.39 ns 5.68 ns 14.6
1048576 4096 0.39 ns 15.13 ns 38.9
4194304 16384 0.37 ns 22.55 ns 61.1Con 16 KiB, todo cabe en la cache, y el orden da lo mismo. Con 16 MiB, ir al azar costó decenas de veces más por cada salto (en otras corridas, entre 60 y 105 veces), con el mismo Θ(n). La fila de 256 KiB fue la más inestable: entre 10 y 43 veces, según la corrida. Por eso, no afirmamos nada sobre ella en particular. Lo que sí se repitió es la tendencia. Y estos números dependen mucho del procesador: en su máquina, los saltos pueden aparecer en otros tamaños.
Esto va a volver en todo el curso. Una lista enlazada y un arreglo se recorren en Θ(n), y no tardan lo mismo. La semana 5 lo retoma.
Idea clave. O predice cómo crece el costo, y el reloj dice cuánto cuesta aquí y ahora. O sirve para elegir entre algoritmos cuando n es grande, y para descartar los imposibles. Medir sirve para decidir entre lo que quedó en pie. Se necesitan los dos.
El código de la semana
Todo está en code/week-03:
| Archivo | Qué hace | Cómo se compila |
|---|---|---|
bench.h |
median_of, median_seconds y keep: el medidor del curso |
|
count_loops.cpp |
Cuenta las vueltas de los patrones de ciclos | con sanitizers |
call_tree.cpp |
Cuenta llamadas, trabajo y profundidad de cuatro recursiones | con sanitizers |
cases.cpp |
Mejor caso, peor caso y promedio, en comparaciones | con sanitizers |
growth_table.cpp |
Las tablas de crecimiento | con sanitizers |
first_timer.cpp |
Primera medición, repeticiones y salto del reloj | -O2 |
sanitizer_cost.cpp |
Lo que cuestan los sanitizers | -O2, con y sin ellos |
doubling.cpp |
El experimento de duplicar | -O2 |
small_n.cpp |
Θ(n) contra Θ(n²) con n pequeño | -O2 |
cache_walk.cpp |
El mismo Θ(n), en dos órdenes | -O2 |
test_bench.cpp |
Pruebas de bench.h: cuentan, no cronometran |
con sanitizers |
errors/no_keep.cpp |
Mide un cálculo que el compilador borró | a mano |
errors/closed_form.cpp |
Mide un ciclo que el compilador reemplazó por una fórmula | a mano |
errors/same_array.cpp |
Repite la medición con los mismos datos | a mano |
test_notes.py |
Comprueba estos apuntes y las diapositivas contra el código |
make test corre todo eso:
$ build/test_bench
ok
test_bench no tiene ni una comparación de tiempos: comprueba que median_seconds llama exactamente reps
veces a la función, y que median_of da lo que tiene que dar. Una prueba no puede depender del reloj,
porque fallaría el día que la máquina esté ocupada. Las pruebas cuentan: comparaciones, llamadas, vueltas.
test_notes.py vuelve a correr los comandos de estos apuntes. Si la salida no depende de la máquina, tiene
que ser idéntica; si depende, solo se compara su forma, sin los números.
El laboratorio, paso a paso
El enunciado está en code/week-03/lab/README.md.
Sesión 1. Reciben seis funciones misteriosas en mysteries.cpp, y lo primero es predecir su clase
leyendo el código, sin correr nada, con las técnicas de este capítulo. Anótenlo. Después escriben un
medidor, sobre bench.h, que corre una función con varios n, toma la mediana de las repeticiones y escribe
un CSV (un archivo de texto con los valores separados por comas). Con él hacen el experimento de duplicar y
comparan contra lo que anotaron.
Cada función usa Work, una clase pequeña cuyo método step hace un cálculo que el compilador no puede
resumir en una fórmula: así, la medición dice la verdad. También cuenta los pasos, de modo que van a tener
en la misma tabla la cuenta exacta y el tiempo medido.
Sesión 2. Miden push_back frente a insert al inicio de un std::vector, y búsqueda lineal frente a
binaria sobre el mismo arreglo ordenado. Luego compilan el mismo experimento con -O0 y con -O2, y
explican qué cambió y qué no. Terminan con una conclusión corta, con sus números. ¿Por qué push_back es
tan barato, si a veces tiene que crecer? Eso se responde en la semana 4.
make lab        # compila el laboratorio en build/lab/
make test-lab   # comprueba todo; falla hasta que terminen
Resumen
- T(n) cuenta operaciones elementales en función del tamaño de la entrada. Los segundos describen una corrida; la cuenta describe el algoritmo.
- f ∈ O(g) si existen c > 0 y n₀ con f(n) ≤ c · g(n) para todo n ≥ n₀: un techo. f ∈ Ω(g) es lo mismo con ≥: un piso. f ∈ Θ(g) es las dos cosas a la vez.
- Se ignoran los factores constantes y los términos de menor orden. La base del logaritmo no importa; la de la exponencial, sí.
- Las clases habituales: 1, log n, n, n log n, n², 2ⁿ. Con 10⁹ operaciones, n llega a mil millones, 40 millones, 30 mil y 29 para n, n log n, n² y 2ⁿ.
- Mejor caso, peor caso y caso promedio son funciones distintas de n: mínimo, máximo y promedio entre las entradas. Las notaciones son afirmaciones sobre una función. Son dos preguntas independientes. Un peor caso Θ(n) puede tardar menos en alguna entrada.
- Ciclos: en secuencia se suman, y anidados se suman las vueltas. Un ciclo que divide es Θ(log n). 0 + 1
- … + (n − 1) = n(n − 1)/2.
- Recursión: árbol de llamadas, y sumar por niveles. 2T(n/2) + 1 hace 2n − 1 llamadas con n potencia de 2: Θ(n). 2T(n/2) + n es Θ(n log n). 2T(n − 1) + 1 es Θ(2ⁿ).
- Espacio: la memoria además de la entrada. La recursión usa pila en proporción a la profundidad, no al total de llamadas.
- Medir:
std::chrono::steady_clock,-O2, sin sanitizers, varias repeticiones y la mediana.keepevita que se borre el resultado, pero no que el cálculo se reemplace por una fórmula. Lo que está dentro defnse mide. - Experimento de duplicar: T(2n)/T(n) cerca de 2 sugiere casi lineal, y cerca de 4, cuadrático. Con razones cercanas a 1 o 2, miren T(2n) − T(n) y T/n. Es evidencia, no demostración.
- O no ve las constantes, los n pequeños ni la cache. O(n) no siempre gana a O(n²).
Ejercicios
Los ejercicios 1 a 4 son de definiciones, del 5 al 8 de leer código, y del 9 al 12 de medir.
-
Para cada una, encuentren constantes c y n₀ que lo demuestren: (a) 5n + 20 ∈ O(n); (b) n² − n ∈ Ω(n²); (c) 7 ∈ Θ(1); (d) n log₂ n ∈ O(n²), sabiendo que log₂ n ≤ n para todo n ≥ 1.
-
Digan si es verdadero o falso, y justifiquen: (a) n ∈ O(n²); (b) n² ∈ O(n); (c) 2ⁿ⁺³ ∈ Θ(2ⁿ); (d) 3ⁿ ∈ O(2ⁿ); (e) log₁₀ n ∈ Θ(log₂ n); (f) si f ∈ O(g), entonces g ∈ Ω(f).
-
Demuestren que n³ no está en O(n²), sin usar inducción. Luego den una función f que esté en O(n²) y en Ω(n), pero no en Θ(n) ni en Θ(n²).
-
La búsqueda lineal tiene T_peor(n) = n. Decidan si cada frase es correcta, incorrecta o correcta pero poco útil: (a) “El peor caso es O(n)”. (b) “El peor caso es Ω(1)”. (c) “El mejor caso es Θ(1)”. (d) “Como el peor caso es Θ(n), toda búsqueda hace del orden de n comparaciones”. (e) “O(n) significa que es el peor caso”.
-
¿Cuántas veces se incrementa
count? Den la clase Θ:para i desde 0 hasta n - 1 hacer para j desde 0 hasta 99 hacer count ← count + 1 fin para fin para -
Den la clase Θ de cada fragmento, con n ≥ 1, y expliquen por qué.
a) i ← n mientras i > 0 hacer i ← i - 2 fin mientras b) i ← 1 mientras i < n hacer i ← i * 3 fin mientras c) para i desde 0 hasta n - 1 hacer para j desde i hasta n - 1 hacer count ← count + 1 fin para fin para d) i ← 1 mientras i * i ≤ n hacer i ← i + 1 fin mientras -
Una función recursiva hace 3 llamadas con n/3 y trabajo constante. Con n = 3ᵏ, dibujen el árbol, digan cuántos nodos hay en cada nivel y sumen. ¿Y si son 2 llamadas con n/2 y el trabajo propio es n²? Sumen por niveles, y digan cuál nivel domina.
-
Para
fib(n) = fib(n - 1) + fib(n - 2), con trabajo constante en cada llamada, llamen T(n) a la cantidad de llamadas. Muestren que T(n) ≤ 2 T(n − 1) + 1 y que T(n) ≥ 2 T(n − 2). A partir de eso, argumenten con árboles que T(n) está en O(2ⁿ) y en Ω(2^(n/2)). ¿Con eso pueden afirmar que T(n) es Θ(2ⁿ)? -
Una función tarda 3 ms, 6.1 ms, 12.4 ms, 26.1 ms y 55 ms con n = 10⁴, 2 × 10⁴, 4 × 10⁴, 8 × 10⁴ y 16 × 10⁴. Calculen la razón y T/n en cada fila. ¿Qué clase les parece? ¿Qué harían para estar más seguros?
-
Agreguen a
doubling.cppuna fila con una búsqueda binaria usandostd::lower_bound. ¿Por qué hay que usar tandas, y por qué conviene cambiar la key en cada llamada? Midan. -
Quiten el
keepde la suma endoubling.cpp. ¿Qué pasa con la tabla? Ahora compilen sin-O2. ¿Qué pasa? Expliquen las dos cosas. -
En
small_n.cpp, encuentren por búsqueda binaria, a mano o con un programa, el n donde se cruzan las dos funciones en su máquina. Después bajenTABLE_SIZEa 2¹⁴: ¿dónde se cruzan ahora? ¿Se movió como predice la cuenta 2ᵏ + n contra n²/2?