Apuntes · Capítulo 4Secuencias y ordenamiento
Arreglos dinámicos
Arreglos dinámicos
La semana pasada aprendieron a contar el costo de un programa y a contrastar esa cuenta con un cronómetro.
Hoy aplicamos las dos cosas a la estructura más usada de toda la programación: el arreglo que crece. Desde
la semana 1 vienen usando std::vector sin preguntarse cómo funciona. Le hacen push_back y ya. Pero un
arreglo vive en un bloque contiguo de memoria, y un bloque no se puede estirar: el espacio de al lado puede
estar ocupado. Entonces, ¿qué hace push_back cuando ya no hay espacio?
La respuesta es simple: pide un bloque más grande, traslada todo y libera el anterior. Lo interesante es cuánto más grande. Esa decisión separa un programa que tarda milisegundos de uno que tarda minutos, y para explicarla hace falta una idea nueva de costo: una operación puede ser carísima de vez en cuando y, aun así, ser barata si se mira la serie completa. Eso se llama costo amortizado.
La misma decisión tiene consecuencias que se ven en el código de todos los días: las referencias a un
std::vector dejan de servir cuando crece, y noexcept cambia cuántas copias hace un programa. Al final
del
capítulo usamos lo aprendido para diseñar, en papel, una cola sobre un buffer circular.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Tamaño y capacidad, Crecer de a k: un costo total cuadrático y Duplicar: un costo total lineal.
- En clase: Costo amortizado, Medir: lo que predice la cuenta, Encoger sin oscilar, Mover o copiar al crecer, Las referencias se invalidan al crecer, Un
Vectorpropio:new T[capacity]y sus límites, El tipo abstracto cola y Buffer circular.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de esta semana y El laboratorio. Opcional: Open Data Structures, secs. 2.1 (ArrayStack) y 2.3 (ArrayQueue); CLRS, capítulo Amortized Analysis, el método agregado.
Código. Los programas de este capítulo están en
code/week-04. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Tamaño y capacidad
Un arreglo dinámico (dynamic array) es un arreglo que cambia de capacidad cuando hace falta. Se representa con tres datos:
- un puntero al bloque de memoria;
- el tamaño (size): cuántos elementos tiene;
- la capacidad (capacity): cuántos elementos caben en el bloque antes de tener que crecer.
          data ──▶ ┌────┬────┬────┬────┬────┬────┬────┬────┐
                   │ 10 │ 20 │ 30 │ 40 │ 50 │    │    │    │
                   └────┴────┴────┴────┴────┴────┴────┴────┘
          size = 5  └───────── elementos ──────┘└─ libres ─┘
          capacity = 8
Son dos números distintos y responden preguntas distintas. El tamaño es lo que ve quien usa la estructura:
los
índices válidos van de 0 a size - 1. La capacidad es un detalle de la representación, y decide cuándo toca
pedir memoria. Entre operaciones siempre se cumple este invariante:
0 ≤ tamaño ≤ capacidadMientras haya casillas libres, insertar al final es escribir en data[size] y sumar 1 al tamaño, y quitar
el
último es restar 1. Las dos cosas son Θ(1). Y como el bloque es contiguo, data[i] también es Θ(1): es la
aritmética de punteros que conocen de C.
Qué pasa cuando se llena
Cuando size == capacity, el elemento nuevo no cabe. Lo de al lado del bloque puede pertenecer a otro
objeto,
así que no se puede agrandar en su lugar. Hay que hacer tres pasos:
- pedir un bloque más grande;
- trasladar todos los elementos al bloque nuevo;
- liberar el bloque anterior.
algoritmo crecer(a, nueva_capacidad)
    nuevo ← pedir un bloque de nueva_capacidad casillas
    para i desde 0 hasta a.tamaño - 1 hacer
        nuevo[i] ← a.datos[i]
    fin para
    liberar a.datos
    a.datos ← nuevo
    a.capacidad ← nueva_capacidad
fin algoritmo

algoritmo insertar_al_final(a, valor)
    si a.tamaño = a.capacidad entonces
        crecer(a, una capacidad mayor)
    fin si
    a.datos[a.tamaño] ← valor
    a.tamaño ← a.tamaño + 1
fin algoritmo
El paso 2 cuesta Θ(tamaño): hay que tocar cada elemento. Todavía no decimos cuál es “una capacidad mayor”.
Esa
es justamente la pregunta de las dos secciones que siguen. Mientras tanto, veamos qué hace std::vector en
el
entorno del curso:
$ build/capacity_growth
size 0: capacity 0
size 1: capacity 1
size 2: capacity 2
size 3: capacity 4
size 5: capacity 8
size 9: capacity 16
size 17: capacity 32
size 33: capacity 64
size 65: capacity 128
size 129: capacity 256
size 257: capacity 512
size 513: capacity 1024
Con este g++ la capacidad se duplica. Fíjense en que no cambia en cada inserción: de size 513 a 1000 no
cambió nada.
En la biblioteca. El estándar de C++ exige que
push_backcueste tiempo constante amortizado, pero no dice por cuánto se multiplica la capacidad. Que aquí sea 2 es una decisión de la biblioteca deg++, no una regla del lenguaje. Un programa correcto no debe depender de ese número.
Crecer de a k: un costo total cuadrático
La primera idea que se le ocurre a casi todo el mundo es ahorrar memoria: cuando se llene, pedir solo un poco más. Digamos k casillas más. Contemos.
Para contar con precisión, llamaremos traslado a pasar un elemento del bloque viejo al nuevo, sea copiándolo o moviéndolo. Con crecimiento de a k, el arreglo crece cuando el tamaño llega a k, a 2k, a 3k, y así. Cada vez, traslada todo lo que hay:
| Crece cuando el tamaño es | Traslados | Capacidad nueva |
|---|---|---|
| 0 | 0 | k |
| k | k | 2k |
| 2k | 2k | 3k |
| 3k | 3k | 4k |
| … | … | … |
| mk | mk | (m + 1)k |
Para insertar n elementos, el último crecimiento ocurre con un tamaño mk ≤ n − 1, porque el elemento número mk + 1 es el que ya no cabe. El mayor m posible es m = ⌊(n − 1) / k⌋. El total de traslados es:
k + 2k + 3k + ... + mk = k · (1 + 2 + 3 + ... + m) = k · m(m + 1) / 2La suma 1 + 2 + … + m se calcula emparejando: escríbanla dos veces, una al derecho y otra al revés, y sumen columna por columna.
    1    +    2    + ... +    m
    m    +  (m-1)  + ... +    1
  (m+1)  +  (m+1)  + ... +  (m+1)    →  m veces (m + 1)
Las dos filas juntas valen m(m + 1), así que una sola vale m(m + 1) / 2.
Ahora veamos el orden de crecimiento. Como m ≤ n / k y m + 1 ≥ n / k, para n ≥ 2k se tiene:
traslados ≤ k · (n/k) · (n/k + 1) / 2  =  n(n + k) / (2k)  ≤  n² / k
traslados ≥ k · (n/k − 1) · (n/k) / 2  =  n(n − k) / (2k)  ≥  n² / (4k)
El total es Θ(n²/k). Si k es una constante, es Θ(n²). Con n = 1 000 000 y k = 1000, m = 999 y la fórmula da 1000 · 999 · 1000 / 2 = 499 500 000 traslados. Casi quinientos traslados por cada inserción.
Idea clave. Dividir entre k no cambia la forma de la curva. Una constante grande en el denominador solo retrasa el momento en que duele: duplicar n sigue multiplicando el costo por 4.
Duplicar: un costo total lineal
La otra idea es multiplicar la capacidad en vez de sumarle algo. Partimos de capacidad 0, el primer
push_back
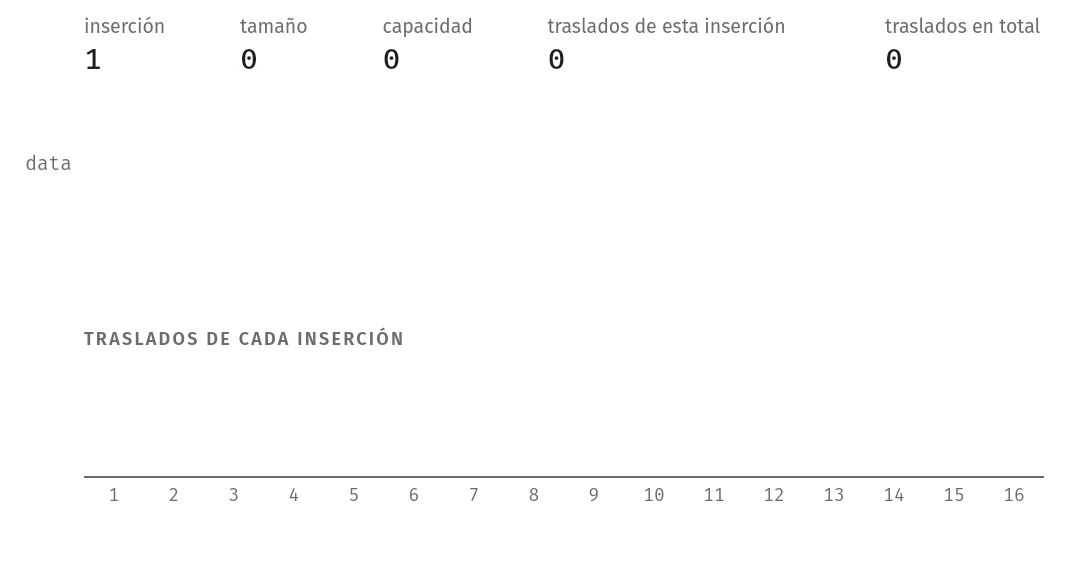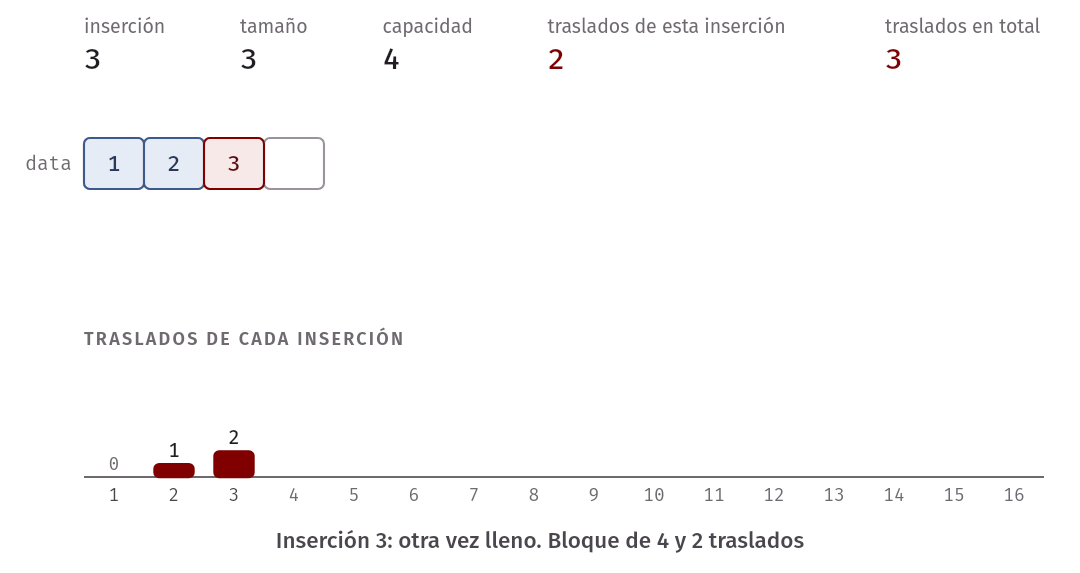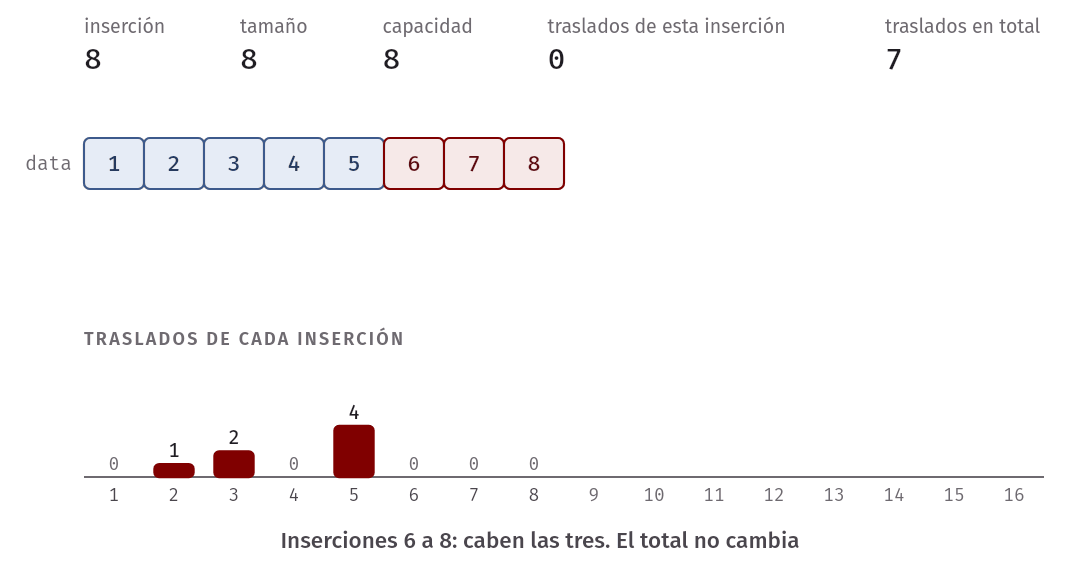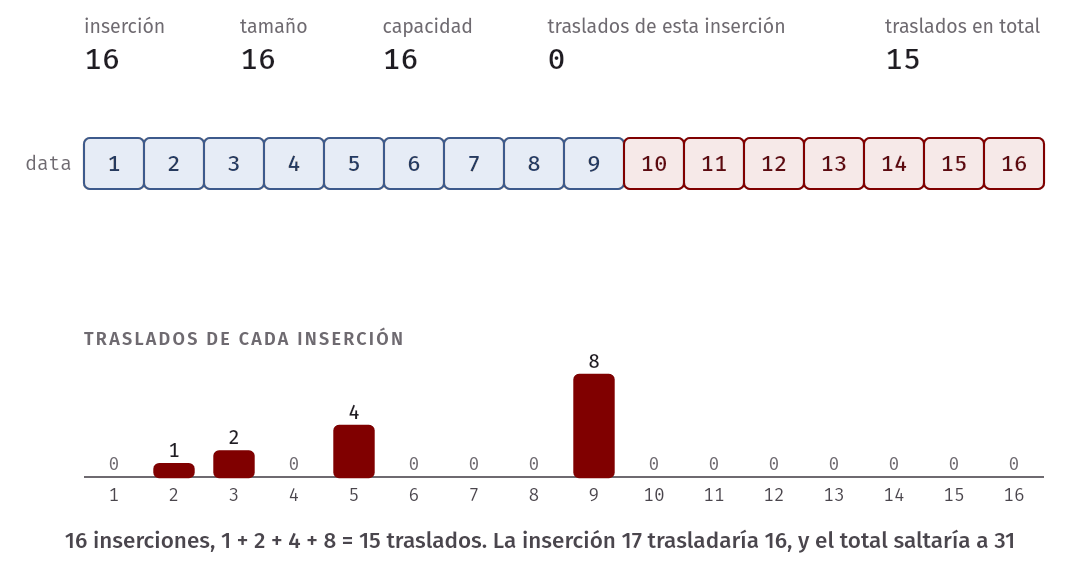
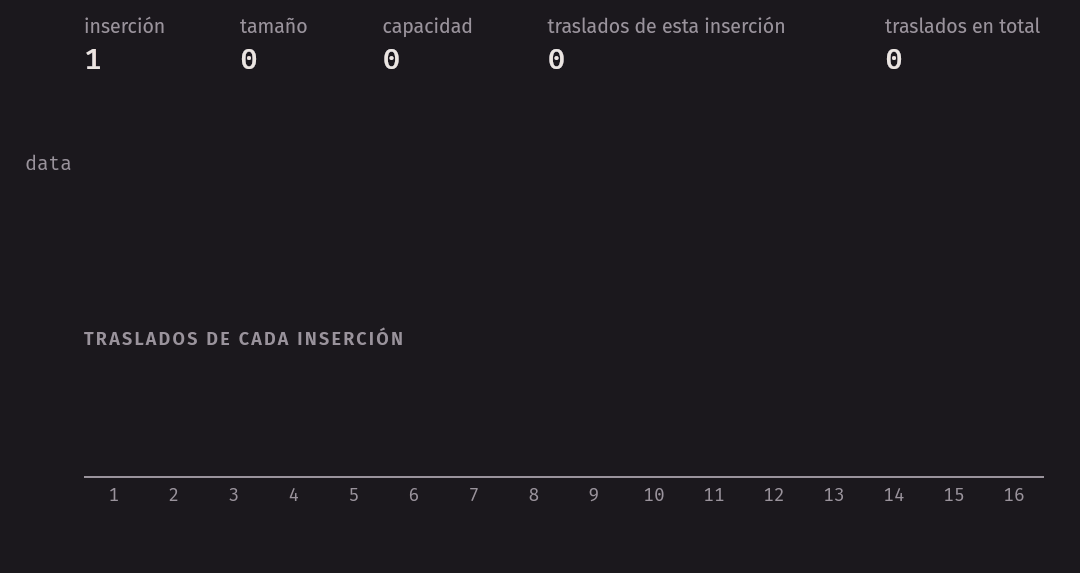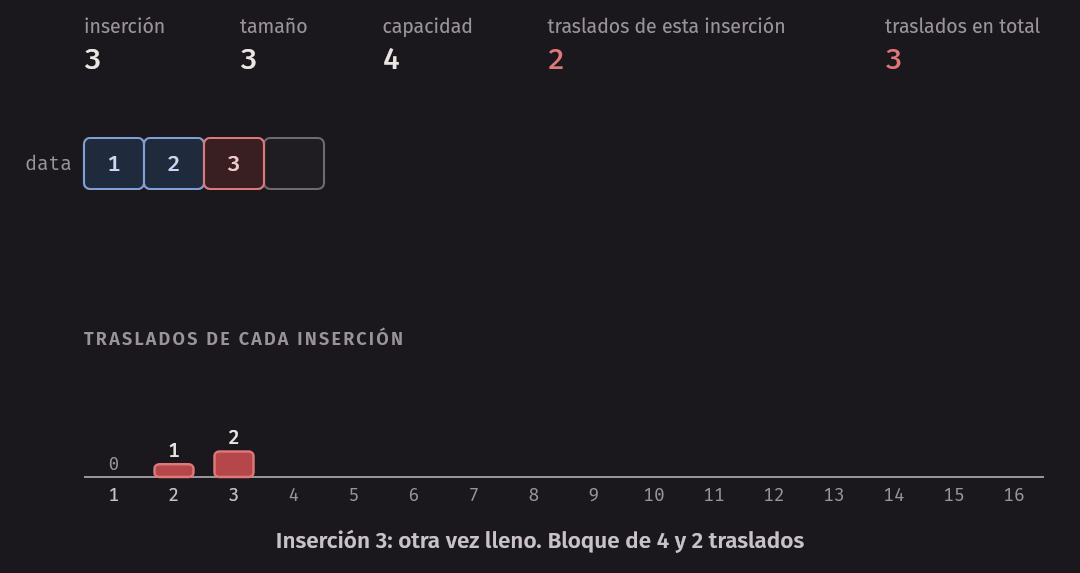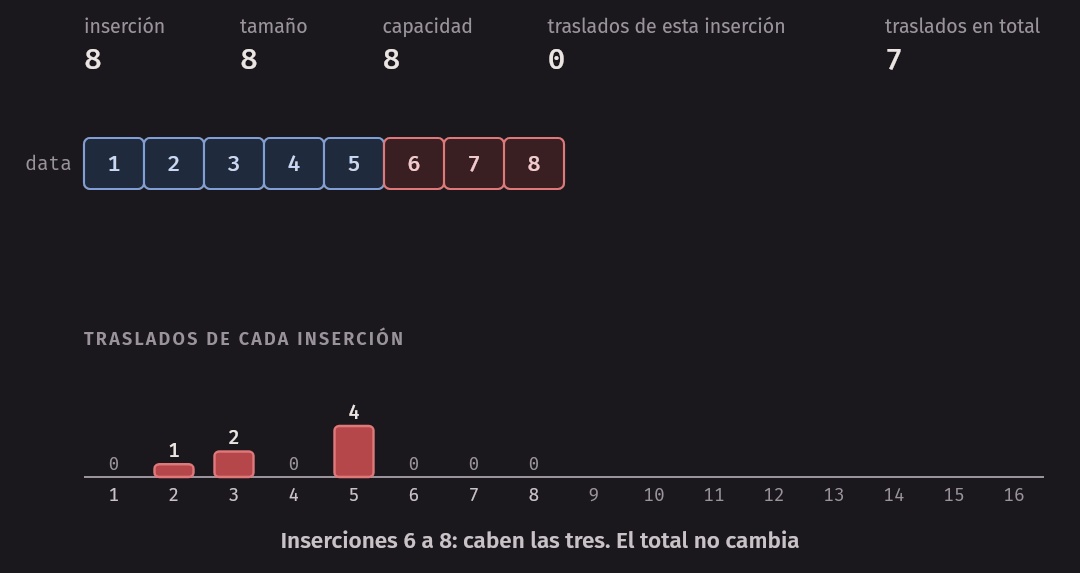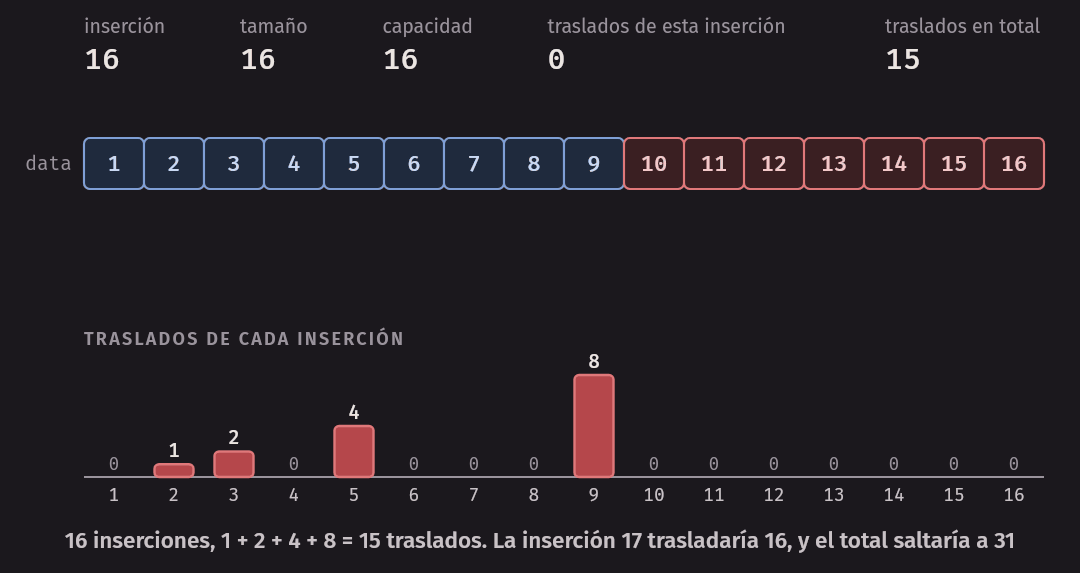
la lleva a 1, y luego se duplica cada vez que se llena. Sigamos 16 inserciones, paso a paso:
| Inserción | Tamaño antes | Capacidad antes | ¿Crece? | Traslados | Capacidad después | Traslados acumulados |
|---|---|---|---|---|---|---|
| 1 | 0 | 0 | sí | 0 | 1 | 0 |
| 2 | 1 | 1 | sí | 1 | 2 | 1 |
| 3 | 2 | 2 | sí | 2 | 4 | 3 |
| 4 | 3 | 4 | no | 0 | 4 | 3 |
| 5 | 4 | 4 | sí | 4 | 8 | 7 |
| 6 a 8 | 5 a 7 | 8 | no | 0 | 8 | 7 |
| 9 | 8 | 8 | sí | 8 | 16 | 15 |
| 10 a 16 | 9 a 15 | 16 | no | 0 | 16 | 15 |
Para insertar 16 elementos se hacen 1 + 2 + 4 + 8 = 15 traslados. El elemento 16 cabe justo, sin crecer. El elemento 17 ya cuesta 16 traslados más, y el total salta a 31.
La cuenta general
Sea n ≥ 2. Los crecimientos que trasladan algo ocurren con tamaños 1, 2, 4, …, 2^j, donde 2^j es la mayor potencia de 2 que cumple 2^j ≤ n − 1. El total de traslados es
S = 1 + 2 + 4 + ... + 2^jEsta suma se resuelve sin inducción, con un truco: se duplica y se resta.
 2S =     2 + 4 + 8 + ... + 2^j + 2^(j+1)
  S = 1 + 2 + 4 + ...       + 2^j
 ────────────────────────────────────────
 2S − S = 2^(j+1) − 1
Casi todo se cancela, y queda S = 2^(j+1) − 1 = 2 · 2^j − 1. Como 2^j ≤ n − 1:
S ≤ 2(n − 1) − 1 = 2n − 3 < 2nY como 2^j es la mayor potencia que no pasa de n − 1, se cumple 2^(j+1) ≥ n, así que S ≥ n − 1. En resumen:
n − 1 ≤ traslados ≤ 2n − 3 (para n ≥ 2)Las dos cotas se alcanzan. Con n = 16 hay 15 traslados, que es n − 1. Con n = 17 hay 31, que es 2n − 3. Por eso no se puede decir “menos de n copias”: es falso para n = 17. Lo correcto es menos de 2n.
Idea clave. Cada bloque nuevo es más grande que todos los anteriores juntos. Por eso la última copia domina la suma, y la suma completa no llega ni al doble de ella.
Lo comprobamos
growth_count no guarda ningún elemento. Solo sigue el tamaño y la capacidad durante n inserciones, y suma
los
traslados con cada regla:
$ build/growth_count
         n     duplicar      por 3/2      de a 1000
        16           15           38              0
        17           31           38              0
      1000         1023         2137              0
     10000        16383        24284          45000
    100000       131071       276521        4950000
   1000000      1048575      2099753      499500000
  10000000     16777215     23917332    49995000000
Una simulación puede estar mal, así que claims_tests.cpp compara estas cuentas contra las copias reales
que hace un
std::vector, contadas con un tipo instrumentado. Más adelante vemos cómo.
Lean la tabla por filas. Con n = 1000, crecer de a 1000 gana: una sola reserva, y cero traslados. Con n = 10 000 ya pierde, casi por 3 veces. Con n = 10 000 000 hace casi 3000 veces más trabajo que duplicar.
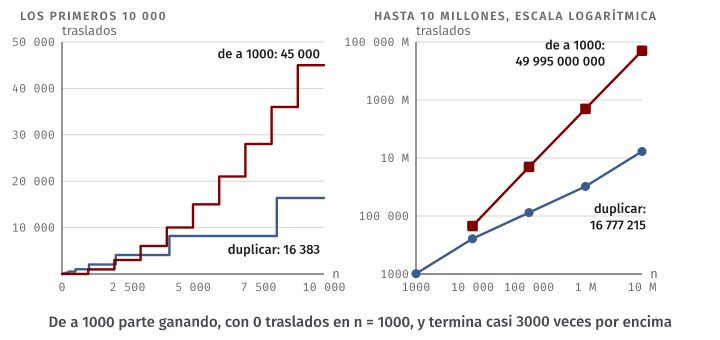
Eso responde una pregunta frecuente: ¿por qué crecer de a 1000 sigue siendo cuadrático, aunque 1000 sea grande? Porque “cuadrático” habla de lo que pasa cuando n crece, y k está fijo. Cada crecimiento traslada todo lo que hay, y cada vez hay más. Mientras n es pequeño comparado con k, la constante esconde el problema. Cuando n es mucho mayor que k, el costo por inserción es de unos n / (2k) traslados, y ese número sigue creciendo.
El factor no tiene que ser 2
La columna “por 3/2” multiplica la capacidad por 1,5. También es lineal, porque la cuenta es otra vez una
suma
geométrica: cada crecimiento es 1,5 veces el anterior, y la suma completa queda entre 2n y 3n, según dónde caiga n. En
claims_tests se
comprueba que, hasta capacidades de 100 millones, el total no pasa de 3n + 20: esos 20 vienen de redondear
hacia
abajo al multiplicar.
Lo que importa no es el 2: es multiplicar. Un factor menor gasta menos memoria y traslada más. Un factor mayor hace lo contrario. Duplicar es la opción más fácil de analizar, y es la que usaremos.
El precio de duplicar es la memoria. Justo después de crecer, casi la mitad del bloque está libre. Y durante el crecimiento conviven los dos bloques: con un tamaño de s, se ocupan s casillas del viejo más 2s del nuevo, o sea 3s.
Costo amortizado
Ya sabemos el total. Falta darle nombre a lo que significa por operación.
Definición. Sea T(n) el mayor costo total posible de una serie de n operaciones que empieza con la estructura vacía. El costo amortizado (amortized cost) por operación es T(n) / n.
Tres cosas de la definición importan:
- Toma el peor caso de la serie: la serie más cara posible, no una típica.
- Promedia dentro de la serie: reparte el costo total entre sus n operaciones.
- Parte de un estado conocido: vacío. Sin eso, la primera operación podría cargar con trabajo que nadie pagó.
Esta forma de calcularlo, sumar todo y dividir, se llama método agregado. Hay otros, y dan la misma respuesta. En este curso basta con este.
Aplicado a push_back
Usemos un modelo de costo simple: una unidad por cada elemento escrito, sea el valor insertado o un traslado. Consideramos que pedir y liberar un bloque, por sí solo, cuesta una constante.
En una serie de n push_back desde vacío, cada inserción escribe el valor una vez, y son n unidades. Los
traslados
suman menos de 2n, como acabamos de ver. Por lo tanto:
T(n) < n + 2n = 3n T(n) / n < 3El costo amortizado de push_back es O(1). Con 16 inserciones: 16 escrituras + 15 traslados = 31
unidades, y
31 / 16 ≈ 1,94, que es menos de 3.
En C++. En el
Vectordel laboratorio,new T[c]además construye las c casillas. Si T tiene constructor propio, ese trabajo cuenta, y las capacidades también forman una suma geométrica: 1 + 2 + … + 2^(j+1) = 2^(j+2) − 1 < 4n. El total sigue siendo O(n), con una constante mayor. Paraintno hay ese costo, porquenew int[c]no inicializa nada.
Una operación puede ser cara, y el total no
Una sola llamada a push_back, ¿puede costar Θ(n)? Sí. El elemento 17 trasladó 16, y el elemento 524 289
traslada
524 288. ¿Cómo se concilia eso con decir que cuesta O(1) amortizado?
Porque son afirmaciones sobre cosas distintas:
| Afirmación | Sobre qué habla | Valor |
|---|---|---|
| Peor caso de una llamada | La llamada más cara | Θ(n) |
| Costo amortizado | El total de la serie, dividido entre n | O(1) |
Las llamadas caras son raras, y cada vez más. Antes de que un crecimiento traslade s elementos, tuvieron que hacerse unas s / 2 inserciones baratas desde el crecimiento anterior. Nadie paga por adelantado en el programa: es solo la contabilidad al sumar todo.
Error común. Leer “O(1) amortizado” como “cada llamada es rápida”. No lo es. Si un programa debe responder siempre en menos de cierto tiempo (el cuadro de un videojuego, un sistema de control), esa llamada cara le puede hacer perder el plazo, aunque el total sea excelente. Si conocen el tamaño de antemano,
reservehace la reserva una sola vez, en el momento que ustedes elijan.
Amortizado no es caso promedio
Se parecen en el nombre y son cosas muy distintas.
- El caso promedio promedia sobre las entradas posibles, y por eso necesita suponer cómo se distribuyen. La búsqueda lineal revisa unos n / 2 elementos en promedio si se supone que el buscado puede estar en cualquier posición con la misma probabilidad. Si esa suposición falla, la cuenta no vale, y una entrada mala cuesta n.
- El costo amortizado promedia sobre las operaciones de una serie, y no hay probabilidades en ningún lado. Vale para toda serie posible, incluida la peor. No depende de qué valores se inserten, ni de la suerte.
Dicho de otra forma: “3 unidades amortizadas” es una garantía. Si hacen n push_back desde vacío, el total
nunca pasa de 3n,
sin excepción. El caso promedio no garantiza nada sobre una ejecución en particular.
Error común. Olvidar la condición “una serie desde vacío”. Copiar un vector no es una operación de esa serie: cuesta Θ(n). Además, en este
g++la copia queda con la capacidad justa (lo verán abajo), así que elpush_backque le sigue también traslada todo. Un ciclo que copia y luego inserta es cuadrático, aunquepush_backsea O(1) amortizado.
Medir: lo que predice la cuenta
La teoría dice que, al duplicar n, duplicar cuesta el doble y crecer de a 1000 tiende a costar cuatro veces
más.
growth_time lo mide sobre std::vector<int>. Para que el mismo vector crezca de a 1000, se le pide
reserve desde
fuera, justo antes de que se llene:
void fill_step(int n, std::size_t step) {
    std::vector<int> v;
    for (int i = 0; i < n; i++) {
        if (v.size() == v.capacity()) {
            v.reserve(v.capacity() + step);
        }
        v.push_back(i);
    }
    keep(v[n - 1]);
}
Se usa el medidor de la semana 3, bench.h: cada tiempo es la mediana de 5 repeticiones, compilando con
-O2 y sin
sanitizers. Estos tiempos son de una corrida en el entorno del curso, con otros programas corriendo en la
misma máquina.
En su laptop serán otros. Lo que se compara es por cuánto se multiplican al duplicar n.
$ build/growth_time
        n  duplicar(ms) de a 1000(ms)
   100000         0.369         0.951
   200000         0.735         3.126
   400000         1.561        10.970
   800000         3.076        40.678
1600000 5.906 155.511| Paso de n | Factor al duplicar | Factor de a 1000 |
|---|---|---|
| 100 000 → 200 000 | 1,99 | 3,29 |
| 200 000 → 400 000 | 2,12 | 3,51 |
| 400 000 → 800 000 | 1,97 | 3,71 |
| 800 000 → 1 600 000 | 1,92 | 3,82 |
Tres corridas seguidas dieron factores muy parecidos. Duplicar sube cerca de 2 en cada fila. De a 1000 se va acercando a 4, y no llega de golpe por una razón: el tiempo incluye también las n escrituras, que son lineales, y pesan menos a medida que n crece. Con n = 1 600 000, la diferencia ya es de unas 26 veces, y sigue aumentando.
Idea clave. Una medición convence cuando confirma una forma que la cuenta ya predijo. Sin la cuenta, 155 ms parece poco. Con la cuenta, saben que con diez veces más datos serán unos 100 veces más, mientras que duplicar solo costará unas 10.
Aquí se esconde una trampa de la vida real. Pedir reserve en cada inserción, “para ayudar”, puede destruir
el crecimiento geométrico:
$ build/vector_facts
1000 push_back: size 1000, capacity 1024
999 pop_back: size 1, capacity 1024
clear: size 0, capacity 1024
reserve(10): capacity 1024
shrink_to_fit: capacity 0
copia de size 1 y capacity 100: capacity 1
reserve(size + 1) antes de 1000 push_back: copias 499500
push_back(names[0]) con el vector lleno: 3 nombres, el último de 40 letras
Miren la línea de reserve(size + 1): 1000 inserciones hicieron 0 + 1 + … + 999 = 499 500 copias. Con
este g++, reserve
pide lo justo, y el vector no duplica por su cuenta. Es exactamente crecer de a 1. Comparen con las 1023
copias de
duplicar. El resto de las líneas las usaremos en las secciones siguientes.
Error común. Llamar
v.reserve(v.size() + 1)antes de cadapush_back.reservees para cuando conocen el tamaño final: se llama una vez, antes de empezar.
Encoger sin oscilar
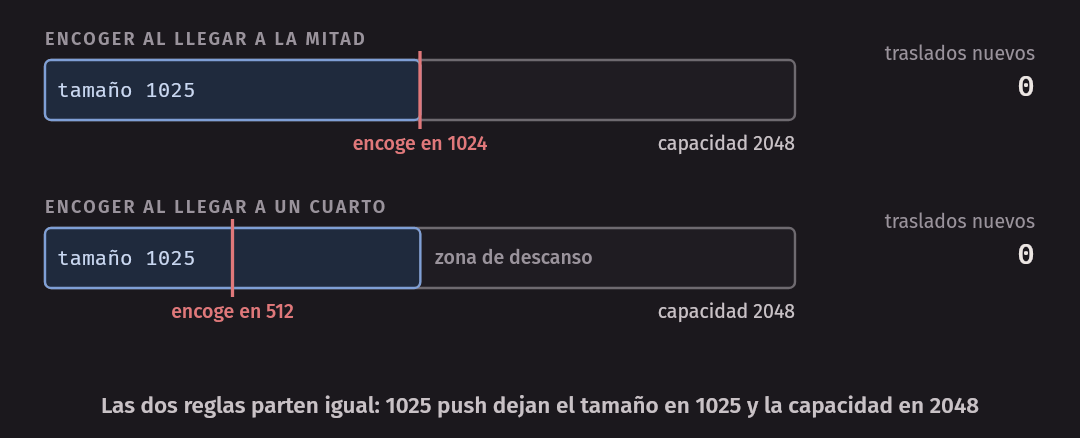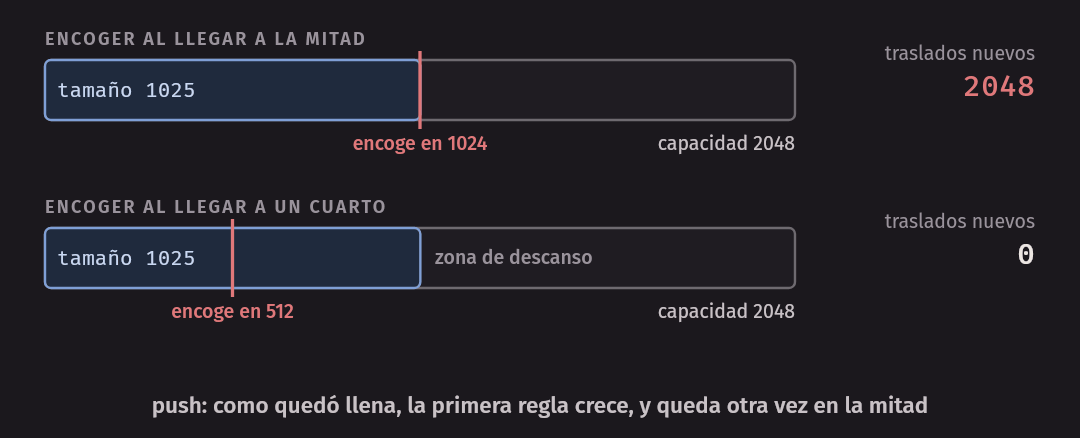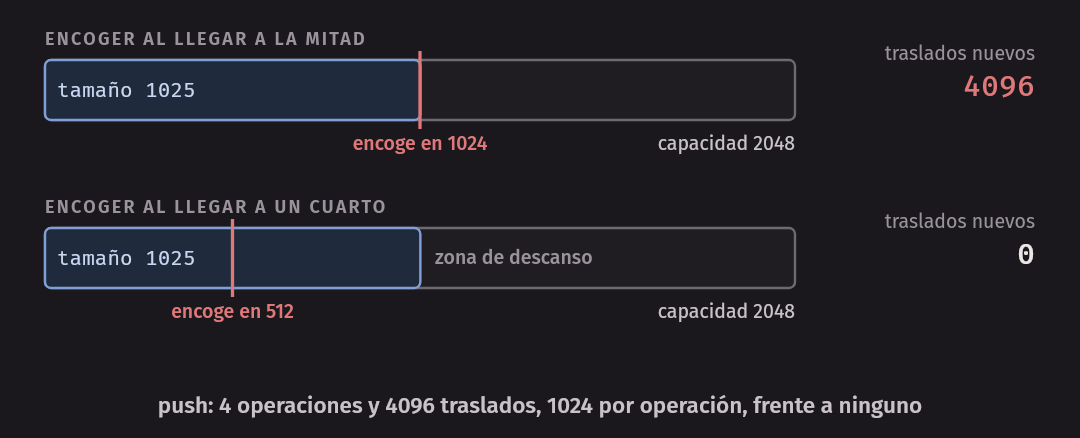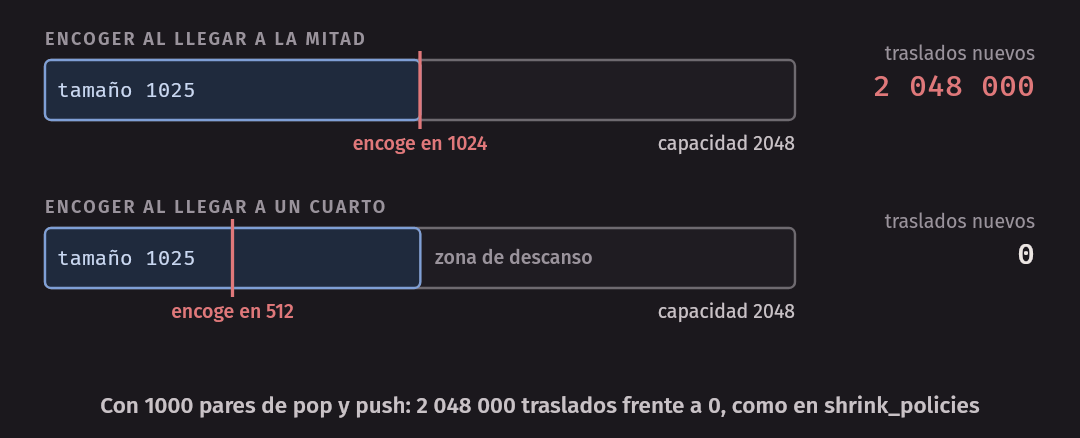
Si un arreglo tuvo un millón de elementos y ahora tiene diez, quizás convenga devolver memoria. La regla parece obvia: si el tamaño cae a la mitad de la capacidad, reducir la capacidad a la mitad. Es simétrica con crecer. Y es una mala regla.
Imaginen un arreglo de capacidad 1024, lleno, con tamaño 1024. Vean qué pasa si se alterna push y pop
justo en el borde:
| Operación | Tamaño | Capacidad | Traslados |
|---|---|---|---|
push |
1025 | 2048 | 1024 (crece) |
pop |
1024 | 1024 | 1024 (encoge: el tamaño llegó a la mitad) |
push |
1025 | 2048 | 1024 (crece) |
pop |
1024 | 1024 | 1024 (encoge) |
Cada operación traslada mil elementos. No es un caso raro de contabilidad: una serie de n operaciones cuesta Θ(n²), y el costo amortizado ya no es O(1). El problema es que, justo después de crecer o de encoger, el arreglo queda en el borde de la regla contraria.
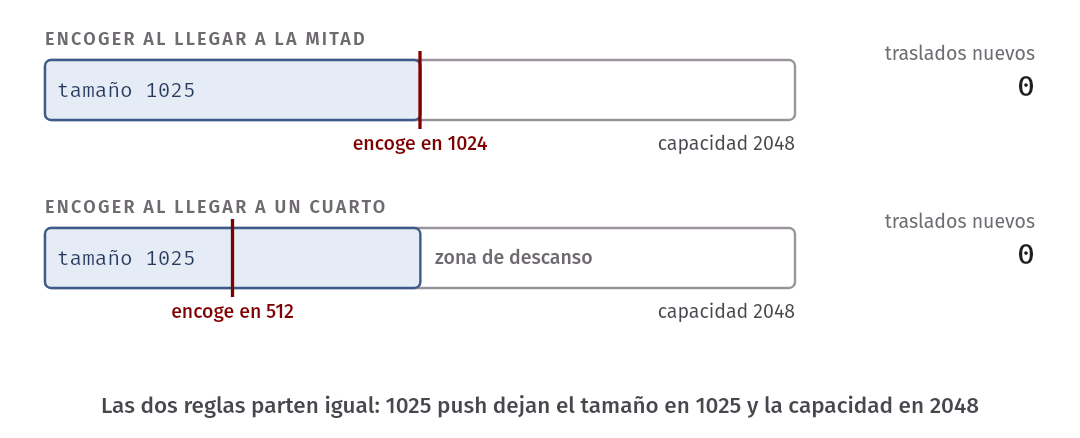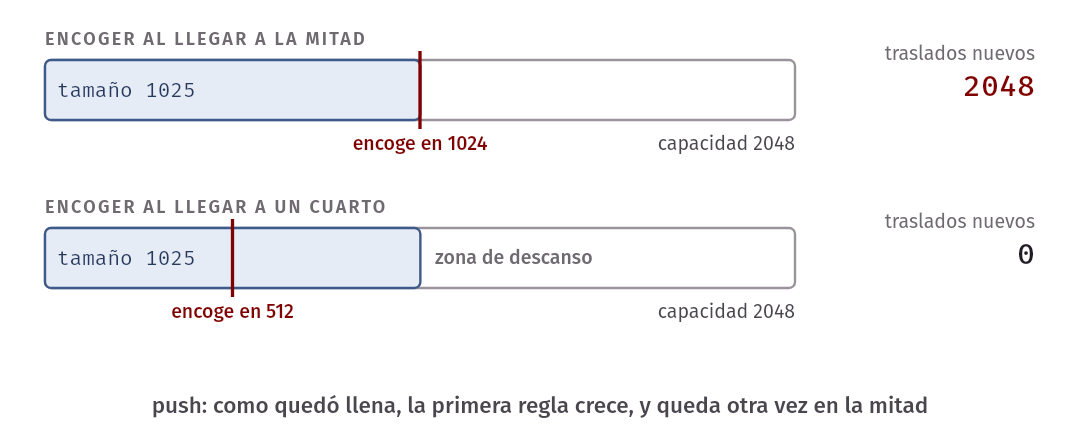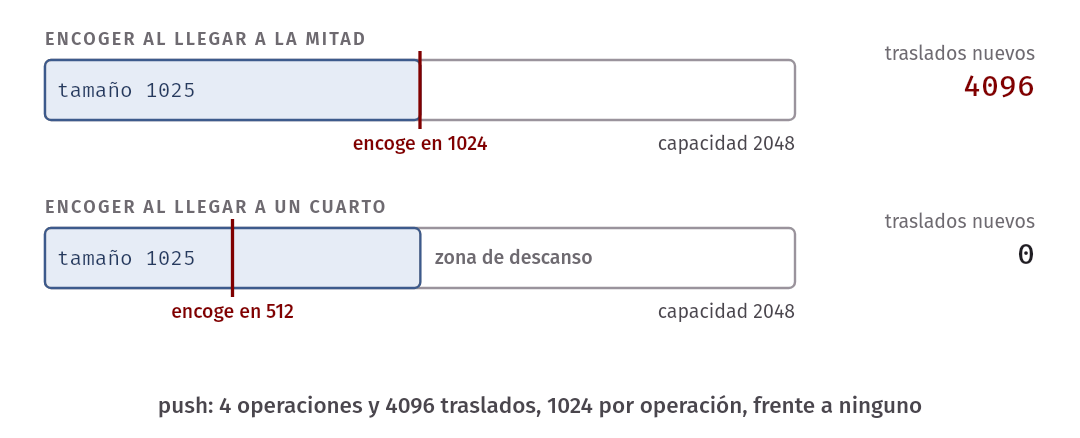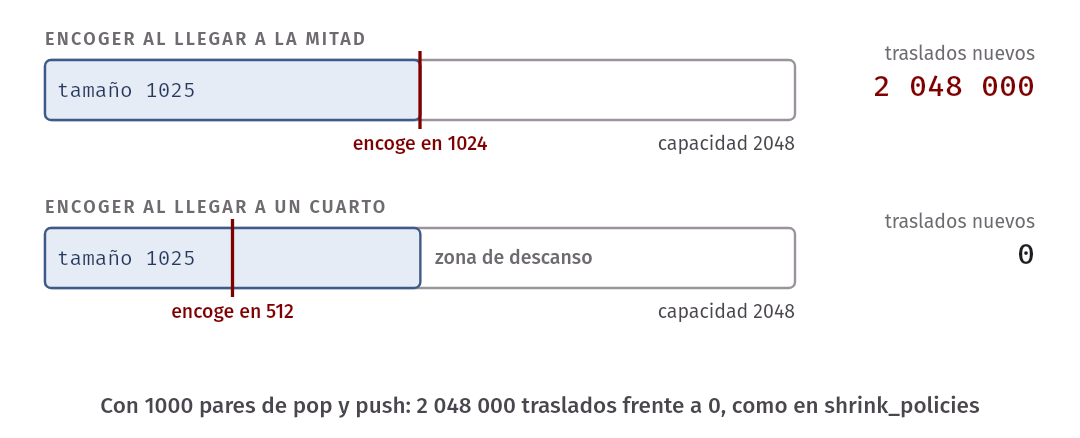
La solución es dejar una zona de descanso: encoger al llegar a un cuarto. Crecer sigue siendo duplicar
al llenarse, y encoger reduce a la
mitad cuando el tamaño cae a un cuarto de la capacidad. shrink_policies simula las dos reglas, con un
mínimo de capacidad 4 por debajo del cual no
encoge. Primero hace 1025 push, y luego 1000 pares de pop y push:
$ build/shrink_policies
Encoger al llegar a la mitad
tras 1025 push: size 1025, capacity 2048, traslados 2047
tras 2000 operaciones más: capacity 2048, traslados nuevos 2048000
Encoger al llegar a un cuarto
tras 1025 push: size 1025, capacity 2048, traslados 2047
tras 2000 operaciones más: capacity 2048, traslados nuevos 0
2000 operaciones, 2 048 000 traslados frente a ninguno: exactamente los 1024 por operación que predijo la tabla.
Por qué un cuarto funciona
Usamos otra vez el método agregado, pero sumamos por tramos. Un tramo es el conjunto de operaciones entre un cambio de capacidad y el siguiente, contando la operación que causa ese siguiente cambio. Vamos a mostrar que, en cada tramo, los traslados no pasan del doble de sus operaciones. Si eso vale en cada tramo, vale al sumar todos.
Justo después de un cambio a capacidad c, el arreglo está casi a la mitad:
- si creció, el tamaño era c/2 y se le sumó el elemento nuevo: queda en c/2 + 1;
- si encogió, el tamaño era un cuarto de la capacidad vieja 2c: queda en c/2.
Desde ahí, el siguiente cambio de capacidad puede ser de dos tipos:
| El siguiente cambio | Traslados que hace | Operaciones que hicieron falta, como mínimo | Traslados por operación |
|---|---|---|---|
| Crecer, con el tamaño en c | c | c/2 (de c/2 + 1 hasta c son c/2 − 1, más el push que lo causa) |
2 o menos |
| Encoger, con el tamaño en c/4 | c/4 | c/4 (de c/2 hasta c/4) | 1 o menos |
Los tramos con capacidad 1 y 2 también cumplen el límite: el crecimiento traslada 1 o 2 elementos, y lo
causa al menos un push. Sumando todos los tramos:
traslados totales ≤ 2 · (número de operaciones)Este resultado vale para cualquier serie de push y pop desde vacío, así que cada operación cuesta O(1)
amortizado. claims_tests.cpp lo comprueba con
200 series al azar, con semilla fija, y con varias subidas y bajadas completas: traslados ≤ 2 · operaciones en todo momento.
Idea clave. Después de cada cambio de capacidad, el arreglo queda lejos de los dos bordes. Para volver a pagar un cambio caro, hay que hacer antes muchas operaciones baratas.
En la biblioteca.
std::vectorno encoge solo. En la salida devector_facts, 999pop_backdejaronsize 1, capacity 1024, ycleartambién dejó la capacidad en 1024.reserve(10)tampoco redujo nada:reservesolo puede agrandar. Para pedir que encoja existeshrink_to_fit, que aquí dejó la capacidad en 0, pero el estándar dice que es solo una solicitud: la implementación podría ignorarla. Es decir,std::vectorprefiere no devolver memoria y evitar traslados. ElVectordel laboratorio hace lo mismo.
Mover o copiar al crecer
Hasta aquí dijimos “traslado” a propósito. ¿Es copiar, o mover? Desde la semana 2 saben que para un
std::string largo, mover es tomar un puntero y copiar es
pedir memoria y duplicar el texto. Al crecer, mover parece la respuesta obvia. std::vector, sin embargo, a
veces copia. Para entender por qué, hay que
hablar de algo que no hemos visto: qué pasa si un traslado falla.
Lo mínimo sobre excepciones
En C, una función avisa de un error por su valor de retorno, y quien la llama debe revisarlo. malloc
devuelve NULL. En C++ hay otro mecanismo: una excepción.
Con throw, una función abandona su trabajo. El programa va deshaciendo llamadas, y destruye los objetos
locales de cada una, hasta encontrar un catch que
la reciba. Si nadie la recibe, el programa termina.
    try {
        copied.push_back(FailsOnCopy(5));
    } catch (const std::runtime_error& error) {
        std::cout << "excepción: " << error.what() << "\n";
    }
Lo importante para hoy son tres hechos:
newno devuelve un puntero nulo cuando no hay memoria: lanza una excepción,std::bad_alloc. Por eso, copiar unstd::stringlargo puede lanzar excepciones.noexcepten una función es una promesa: “de aquí no sale ninguna excepción”. Si una llega a salir, el programa se termina constd::terminate.- Como los destructores corren al deshacer las llamadas, RAII sigue funcionando: lo que está en manos de un objeto se libera solo. Lo que está en un puntero suelto no: es una fuga.
Por eso hay que tener cuidado con un bloque recién pedido que todavía no tiene owner. Este es el molde. Si algo falla al llenar el bloque, se libera y se deja seguir la excepción:
std::string* copy_block(const std::string* source, std::size_t count) {
    std::string* fresh = new std::string[count];
    try {
        for (std::size_t i = 0; i < count; i++) {
            fresh[i] = checked_copy(source[i]);
        }
    } catch (...) {
        delete[] fresh;
        throw;
    }
    return fresh;
}
catch (...) recibe cualquier excepción, y throw; sola la vuelve a lanzar, para que la reciba quien
corresponda.
$ build/copy_block
copió ana y beto
excepción: cadena vacía; el bloque nuevo ya se liberó
El problema de mover
Supongan un arreglo de 4 elementos que crece, y que trasladar el tercero lanza una excepción.
- Si estaba copiando: el bloque viejo sigue intacto. Se libera el nuevo, y el arreglo queda exactamente como antes. Nadie perdió nada.
- Si estaba moviendo: los dos primeros ya salieron del bloque viejo. Están en el nuevo, y el viejo se quedó con objetos vacíos. Para deshacer habría que moverlos de vuelta, y eso también podría fallar. No hay forma segura de volver atrás.
std::vector promete que si push_back falla, el vector queda como estaba. Esa promesa se llama garantía
fuerte. Para poder cumplirla, usa esta regla al crecer:
| El tipo T | Qué hace al crecer | ¿Garantía fuerte? |
|---|---|---|
Se mueve con noexcept |
Mueve: nada puede fallar | Sí |
Su movimiento no es noexcept, y se puede copiar |
Copia | Sí |
Su movimiento no es noexcept, y no se puede copiar |
Mueve, porque no hay otra opción | No |
Esa regla está empaquetada en std::move_if_noexcept(x), de <utility>. No hace nada en tiempo de
ejecución. Igual que std::move, es solo un cast: da un valor del que se puede
mover si la construcción por movimiento de T es noexcept o si T no se puede copiar, y en otro caso da una
referencia const, de la que solo se puede copiar.
Lo vemos con el tipo instrumentado de tracked.h, que cuenta sus copias y sus movimientos. Las dos
variantes solo se diferencian en el noexcept del movimiento. Cada una
inserta 16 temporales en un std::vector:
$ build/move_or_copy
mover con noexcept: capacity 16, copias 0, movimientos 31
mover sin noexcept: capacity 16, copias 15, movimientos 16
std::string: true
Student: true
StudentWithDestructor: false
Mismatched, al construir: true, al asignar: false
Las dos primeras líneas son la clase entera. Los 16 movimientos los causan los argumentos, en los dos casos.
Los 15 traslados al crecer, los que calculamos con 1 + 2 + 4 + 8 = 15,
son movimientos en la primera línea y copias en la segunda. Quitar la palabra noexcept cambió lo que
hace el programa, sin cambiar ninguna otra línea. Con
un tipo que pide memoria al copiar, eso se nota mucho.
Las siguientes líneas dicen si la construcción por movimiento de cada tipo es noexcept, según
std::is_nothrow_move_constructible_v. El caso de StudentWithDestructor es el más
traicionero:
struct Student {
    std::string name;
};

struct StudentWithDestructor {
    std::string name;
    ~StudentWithDestructor() {}
};
Student no declara nada, así que el compilador escribe su movimiento, y es noexcept porque el de
std::string lo es. StudentWithDestructor tiene un destructor declarado, y eso
apaga el movimiento automático (es la regla de cinco de la semana 2): al “moverlo” se copia, y copiar un
std::string puede lanzar. Un destructor vacío, que parece inofensivo,
hace que un std::vector<StudentWithDestructor> copie cada nombre cada vez que crece.
Error común. Escribir el movimiento de una clase y olvidar
noexcept. El programa compila, funciona y pasa las pruebas, perostd::vectorcopia todo al crecer. Si su movimiento solo cambia punteros y números, no puede fallar: márquenlonoexcept.
Qué queda si falla
strong_guarantee lo prueba de verdad. Llena dos vectores hasta su capacidad 4 y provoca una falla al
crecer. El primero guarda un tipo que se puede copiar, con un movimiento sin noexcept, y
falla al copiar. El segundo guarda un tipo que solo se puede mover, sin noexcept, y falla al mover:
$ build/strong_guarantee
excepción: falló una copia
size 4, capacity 4, valores: 1 2 3 4
excepción: falló un movimiento
size 4, capacity 4, valores: -1 -1 3 4
El primero quedó intacto. El segundo perdió dos valores: los -1 son lo que dejó cada movimiento en el
objeto de origen. El estándar dice que en este último caso, tipo solo movible con
un movimiento que puede fallar, el efecto no está especificado. Esta salida es lo que hace este g++, y no
hay que contar con ella. Pero muestra el problema que todo lo anterior intenta evitar.
Las referencias se invalidan al crecer
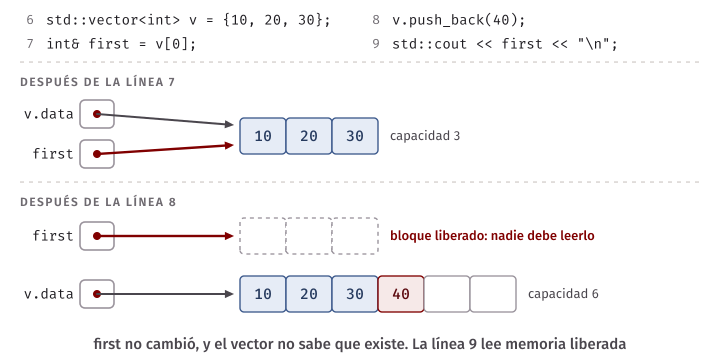
Crecer libera el bloque anterior. Cualquier cosa que apuntara a ese bloque queda apuntando a memoria liberada: una referencia, un puntero o un iterador. Se dice que quedó invalidado.
Un iterador es, por ahora, un objeto que marca una posición dentro de un contenedor, y se usa como un
puntero. Lo construimos la próxima semana. Lo que necesitan hoy es saber que el for de rango
usa iteradores por dentro. Este es el error común de la semana:
    std::vector<int> v = {10, 20, 30};
    int& first = v[0];
    v.push_back(40);
    std::cout << first << "\n";
Parece inofensivo. first es una referencia a v[0], y al v[0] no le hemos hecho nada. Pero un vector
inicializado con 3 elementos tiene aquí capacidad 3, así que push_back crece, y
first se queda apuntando al bloque viejo. ASan lo muestra con todo detalle:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/stale_reference.cpp -o build/stale_reference
$ build/stale_reference
=================================================================
==4921==ERROR: AddressSanitizer: heap-use-after-free on address 0x502000000010 at pc 0xaaaab76a9c04 bp 0xffffcf714ff0 sp 0xffffcf715008
READ of size 4 at 0x502000000010 thread T0
    #0 0xaaaab76a9c00 in main errors/stale_reference.cpp:9
...
freed by thread T0 here:
...
    #8 0xaaaae83c9a7c in main errors/stale_reference.cpp:8
...
previously allocated by thread T0 here:
...
    #7 0xaaaae83c9978 in main errors/stale_reference.cpp:6
...
SUMMARY: AddressSanitizer: heap-use-after-free errors/stale_reference.cpp:9 in main
El informe cuenta la historia completa, con tres líneas de su programa. La línea 6 creó el bloque, la línea
8 (push_back) lo liberó, y la línea 9 leyó de él a través de first. Sin ASan, este programa
muy probablemente imprima un número sin quejarse, y a veces será el correcto. Es comportamiento indefinido:
que funcione hoy no prueba nada.
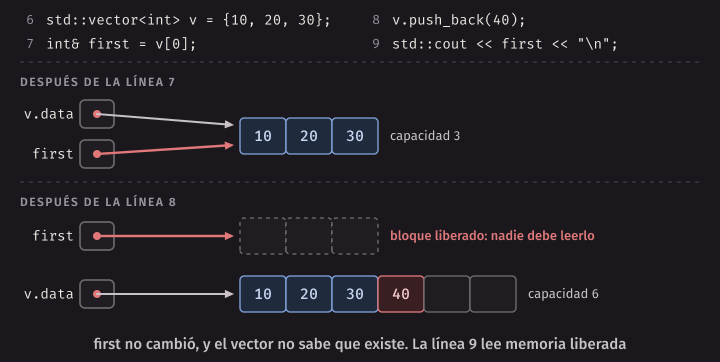
Error común. Guardar una referencia a
v[0]y luego hacerpush_back. También pasa de forma menos visible: una función que recibeconst std::string& namey agrega algo al vector de donde vienename; o un puntero a un elemento guardado en otra estructura.
El mismo error aparece al insertar mientras se recorre con un for de rango:
    std::vector<int> v = {1, 2, 3};
    for (int item : v) {
        if (item == 2) {
            v.push_back(item * 10);
        }
    }
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/push_in_range_for.cpp -o build/push_in_range_for
$ build/push_in_range_for
=================================================================
==4931==ERROR: AddressSanitizer: heap-use-after-free on address 0x502000000018 at pc 0xaaaac2c09fe4 bp 0xffffc612fa60 sp 0xffffc612fa78
READ of size 4 at 0x502000000018 thread T0
#0 0xaaaac2c09fe0 in main errors/push_in_range_for.cpp:7El for de rango guardó los iteradores del inicio y del final del bloque viejo antes de empezar. Después
del push_back, sigue avanzando por memoria liberada.
Cuándo se invalida y qué hacer
La regla de std::vector es precisa. Al insertar con push_back:
- Si la capacidad cambia, se invalidan todas las referencias, punteros e iteradores a sus elementos.
- Si la capacidad no cambia, siguen válidos los que apuntan a elementos. Solo se invalida el iterador
end().
stable_refs cuenta cuántas veces cambió de lugar el bloque, guardando la dirección como un número, porque
un puntero al bloque viejo ya no se debe usar para nada:
$ build/stable_refs
1000 push_back: capacity 1024, el bloque cambió 11 veces
1000 push_back: capacity 1000, el bloque cambió 0 veces
grades[first] = 10
Once cambios: de capacidad 0 a 1, luego 2, 4, …, 1024. Con reserve(1000) antes de empezar, ninguno. La
última línea es la otra salida: guardar un índice en vez de una referencia. Un índice dice
“la posición 0”, y se vuelve a calcular cada vez a partir del bloque actual.
| Situación | Qué hacer |
|---|---|
| Necesitan recordar una posición mientras el vector puede crecer | Guardar el índice, no una referencia |
| Conocen el tamaño final | reserve antes de empezar; mientras no pasen de esa capacidad, nada se invalida |
| Recorren e insertan a la vez | for con índice, volviendo a preguntar v.size() |
Insertar un elemento propio
Hay una variante que les toca directamente a ustedes, como autores de un arreglo dinámico:
v.push_back(v[0]) con el arreglo lleno. El parámetro es const T& value, y value apunta dentro del
bloque que crecer
va a liberar. std::vector lo resuelve: la última línea de vector_facts lo hace con cadenas de 40
letras, bajo ASan, sin ninguna queja. El estándar exige que funcione.
Pero un arreglo escrito con el orden natural no lo resuelve. errors/self_push.cpp tiene una clase pequeña
de cadenas cuyo push_back crece primero y lee value después:
    void push_back(const std::string& value) {
        if (size_ == capacity_) {
            std::size_t bigger = capacity_ == 0 ? 1 : 2 * capacity_;
            std::string* fresh = new std::string[bigger];
            for (std::size_t i = 0; i < size_; i++) {
                fresh[i] = std::move(data_[i]);
            }
            delete[] data_;
            data_ = fresh;
            capacity_ = bigger;
        }
        data_[size_] = value;
        size_++;
    }
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/self_push.cpp -o build/self_push
$ build/self_push
=================================================================
==4938==ERROR: AddressSanitizer: heap-use-after-free on address 0x504000000020 at pc 0xaaaad388d740 bp 0xfffff63f1550 sp 0xfffff63f1568
READ of size 8 at 0x504000000020 thread T0Cuando escriban su Vector, piensen en qué orden hacer las cosas para que value se lea antes de que deje
de existir. Hay una prueba para esto.
Un Vector propio: new T[capacity] y sus límites
En el laboratorio van a escribir Vector<T>. Representación: T* data_, size_ y capacity_, y el bloque
se pide con new T[capacity], igual que la pila de la semana 2. Los invariantes son:
size_ ≤ capacity_
data_ es nulo si y solo si capacity_ = 0
data_ apunta a un bloque de capacity_ objetos T vivos, y los primeros size_ son los elementos
Esta decisión tiene un costo real, y conviene decirlo tal cual: no es lo que hace std::vector. new T[c] hace dos cosas a la vez, pedir memoria y construir c objetos. De ahí salen tres límites.
Primero: T debe tener constructor sin argumentos. Si no lo tiene, ni siquiera compila:
class NoDefault {
public:
    explicit NoDefault(int value) : value_(value) {}
$ g++ -Wall -Wextra -std=c++20 errors/no_default.cpp -o build/no_default
errors/no_default.cpp: In function 'int main()':
errors/no_default.cpp:12:39: error: no matching function for call to 'NoDefault::NoDefault()'
12 | NoDefault* block = new NoDefault[4];
| ^Por la misma razón, T debe poder asignarse, ya que los elementos se escriben con = sobre objetos que ya
existen.
Segundo: hay capacity objetos vivos, no size. Una casilla “libre” contiene un objeto construido sin
argumentos.
Tercero: pop_back no destruye nada. El elemento sigue vivo en su casilla hasta que algo lo sobrescriba
o llegue delete[]. Si guardaba una cadena larga, esa memoria sigue ocupada.
std::vector separa los dos pasos: pide memoria sin construir nada, y construye cada objeto recién cuando
hace falta. El programa lifetimes hace visible la diferencia:
$ build/lifetimes
new Tracked[100]: vivos 100, construidos sin argumentos 100, destruidos 0
delete[]: vivos 0, construidos sin argumentos 100, destruidos 100
reserve(100) de std::vector: vivos 0, construidos sin argumentos 0, destruidos 0
dos push_back: vivos 2, construidos sin argumentos 0, destruidos 2
un pop_back: vivos 1, construidos sin argumentos 0, destruidos 3
fin del vector: vivos 0, construidos sin argumentos 0, destruidos 4
std::vector<NoDefault> compila, y guarda 7
Lean la línea de reserve(100): cero objetos vivos, con espacio para cien. Los 2 destruidos de la línea
siguiente son los temporales que se pasaron a push_back. El tercero es el pop_back, que sí destruye. Y
NoDefault funciona sin problema.
Vector<T> del laboratorio |
std::vector<T> en este g++ |
|
|---|---|---|
| Pedir memoria | new T[c], y construye c objetos |
Memoria sin construir nada |
reserve(100) en un vector vacío |
100 objetos vivos | 0 objetos vivos |
| T sin constructor sin argumentos | No compila | Compila |
pop_back |
El objeto sigue vivo | Destruye el objeto |
| Trasladar al crecer | Asigna sobre objetos ya construidos | Construye en la memoria nueva |
push_back(v[0]) |
Depende de ustedes | Funciona |
| Factor de crecimiento | 2, porque el laboratorio lo pide | 2 aquí; el estándar no lo fija |
| Capacidad de una copia | Igual al tamaño | Igual al tamaño aquí; el estándar no lo fija |
¿Por qué no hacerlo como std::vector? Porque requiere memoria sin construir, construir un objeto en una
dirección dada y destruirlo a mano, y un error ahí es fácil de cometer y difícil de ver. Nada de eso cambia
lo que este capítulo quiere enseñar: tamaño, capacidad, cuánto
cuesta crecer, cuándo se mueve y cuándo se copia. Para int, double, std::string y casi todo lo que
usaremos, new T[c] alcanza. Es un límite que hay que conocer, no un error oculto.
En C++. Hay un detalle más que solo se nota si se lee con cuidado.
std::move_if_noexceptmira si la construcción por movimiento esnoexcept, porque está pensado para quien construye en memoria nueva, comostd::vector. NuestroVectorasigna sobre objetos ya construidos. Son dos funciones distintas, y un tipo podría prometer una y no la otra: en la salida demove_or_copy,Mismatchedestrueal construir yfalseal asignar. Con ese tipo, una falla podría dejar elVectora medio trasladar. En un tipo normal, las dos prometen lo mismo. NuestroVectorasume eso, y lo dice en un comentario.
Cómo se prueba
Las pruebas no se limitan a mirar los valores: cuentan. tracked.h define un tipo con contadores, que son
miembros static porque new T[n] llama al constructor sin argumentos, y no hay forma de pasarle a cada
objeto un contador propio.
template <bool NoexceptMove>
class BasicTracked {
public:
    inline static Counts counts;
Con ese tipo, una prueba puede exigir “16 inserciones, 15 copias” sin depender de la velocidad de la
máquina. Y como TrackedRiskyMove no mueve con noexcept, cada traslado de std::vector es una copia, y
se puede comparar la cuenta teórica contra el comportamiento real. Eso es lo que hace claims_tests.cpp:
void simulated_copies_match_std_vector() {Las pruebas nunca exigen un tiempo. Un tiempo depende de la máquina; una cuenta, no.
El tipo abstracto cola
Un cambio de tema, pero con las mismas herramientas. Una cola (queue) es un tipo abstracto de datos: lo que entra primero sale primero (FIFO, first in, first out), como una fila en el banco. Ofrece:
| Operación | Qué hace |
|---|---|
enqueue(x) |
Agrega x al final |
dequeue() |
Quita el elemento del frente |
front() |
Devuelve el elemento del frente |
empty() |
Dice si está vacía |
Compárenla con la pila de la semana 2, que saca lo último que entró. El tipo abstracto no dice cómo se implementa. Eso lo decidimos ahora.
En la biblioteca.
std::queue, de<queue>, ofrecepush,pop,front,back,emptyysize. No es una estructura propia, sino una interfaz sobre otro contenedor: por defecto,std::deque, que construiremos en versión propia la próxima semana.
En un arreglo normal, sacar del frente cuesta Θ(n)
La primera idea es usar un arreglo dinámico: enqueue es push_back, y el frente está en la posición 0. El
problema es dequeue. Para que el frente siga en la posición 0, todos los demás tienen que correrse un
lugar. Eso cuesta n − 1 movimientos, con n elementos:
$ build/front_removal
vaciar 1000 elementos por el frente: 499500 movimientos
vaciar 2000 elementos por el frente: 1999000 movimientos
vaciar 4000 elementos por el frente: 7998000 movimientos
std::queue: front 10, back 30; tras pop, front 20, size 2
Vaciar n elementos cuesta (n − 1) + (n − 2) + … + 1 = n(n − 1)/2 movimientos. Con n = 1000 son 499 500. Al duplicar n, se multiplica casi por 4: es cuadrático, y es la misma suma de las secciones anteriores.
Una segunda idea: no correr nada, y llevar un índice frente que avance en cada dequeue. Sacar ya es
O(1). Pero las casillas de antes del frente quedan inútiles para siempre: una cola de pocos elementos, por
la que pasan muchos, terminaría creciendo sin límite y con casi todo su bloque vacío.
Buffer circular
Un buffer circular (circular buffer) aprovecha esas casillas: cuando el final llega al borde del arreglo, da la vuelta y sigue desde la posición 0. El bloque es el mismo de siempre. Lo circular está en cómo se calculan los índices.
La representación tiene un índice del frente, un tamaño y una capacidad:
 ┌────┬────┬────┬────┬────┬────┬────┬────┐
 │ e4 │ e5 │    │    │ e0 │ e1 │ e2 │ e3 │     capacidad = 8
 └────┴────┴────┴────┴────┴────┴────┴────┘     frente = 4
   0    1    2    3    4    5    6    7        tamaño = 6
                       ▲
                       e0 es el elemento 0 de la cola: el frente
El elemento i de la cola está en la posición (frente + i) mod capacidad.
Todo lo demás sale de esa fórmula:
front()es el elemento 0: la posiciónfrente.enqueueescribe en la posición (frente + tamaño) mod capacidad, que es donde iría el elemento númerotamaño, y luego suma 1 al tamaño.dequeuehace frente ← (frente + 1) mod capacidad, y resta 1 al tamaño.
Ningún elemento se mueve. Las tres operaciones son Θ(1), mientras no haga falta crecer.
Un ejemplo. En un buffer de capacidad 8, con frente en 6 y tamaño 4, ¿en qué posiciones están los elementos?
$ build/ring_trace
op  capacidad frente  tamaño posición usada
E   4         0       1      0
E   4         0       2      1
E   4         0       3      2
D   4         1       2      0
D   4         2       1      1
E   4         2       2      3
E   4         2       3      0
E   4         2       4      1
--  8         0       4      (desenrolla)
E   8         0       5      4
encolados: 7
capacidad 8, frente 6, tamaño 4: e0->6 e1->7 e2->0 e3->1
capacidad 8, frente 5, tamaño 8: e0->5 e1->6 e2->7 e3->0 e4->1 e5->2 e6->3 e7->4
desenrollar: 5->0 6->1 7->2 0->3 1->4 2->5 3->6 4->7
capacidad 16, frente 0, tamaño 8: e0->0 e1->1 e2->2 e3->3 e4->4 e5->5 e6->6 e7->7
La primera línea después de encolados responde la pregunta: están en 6, 7, 0 y 1. Los dos primeros están
al final del bloque, y los otros dos dieron la vuelta. A mano: (6 + 0) mod 8 = 6, (6 + 1) mod 8 = 7, (6 + 2)
mod 8 = 0, (6 + 3) mod 8 = 1.
Una traza, paso a paso
ring_trace no guarda ningún elemento: solo calcula índices. La tabla de arriba sigue una cola de capacidad
4 con esta serie, donde E es encolar y D desencolar: E E E D D E E E E. Sigan la tabla con un dibujo de 4
casillas:
| Operación | Dónde actúa | Bloque después | frente | tamaño |
|---|---|---|---|---|
| E a | posición (0 + 0) mod 4 = 0 | a . . . |
0 | 1 |
| E b | posición (0 + 1) mod 4 = 1 | a b . . |
0 | 2 |
| E c | posición (0 + 2) mod 4 = 2 | a b c . |
0 | 3 |
| D (sale a) | posición 0; frente ← 1 | . b c . |
1 | 2 |
| D (sale b) | posición 1; frente ← 2 | . . c . |
2 | 1 |
| E d | posición (2 + 1) mod 4 = 3 | . . c d |
2 | 2 |
| E e | posición (2 + 2) mod 4 = 0 | e . c d |
2 | 3 |
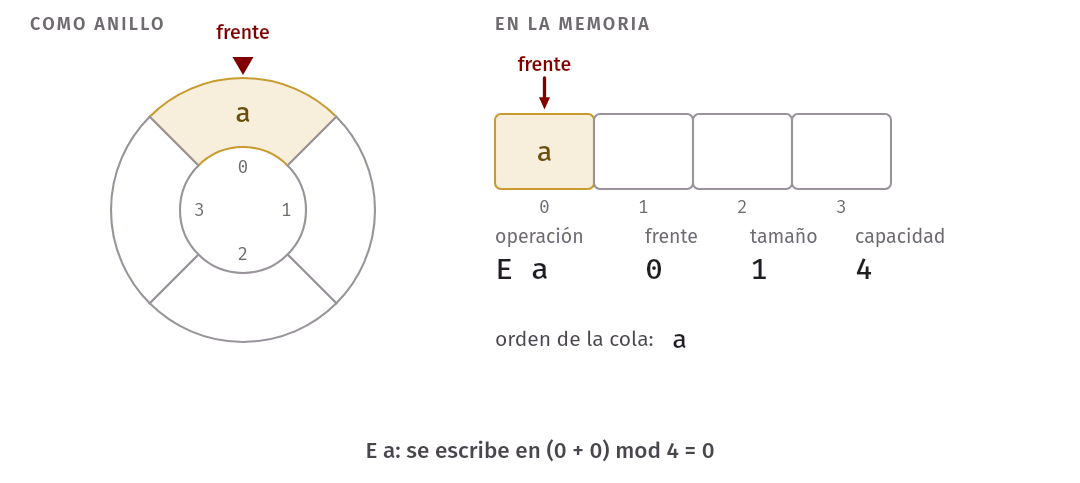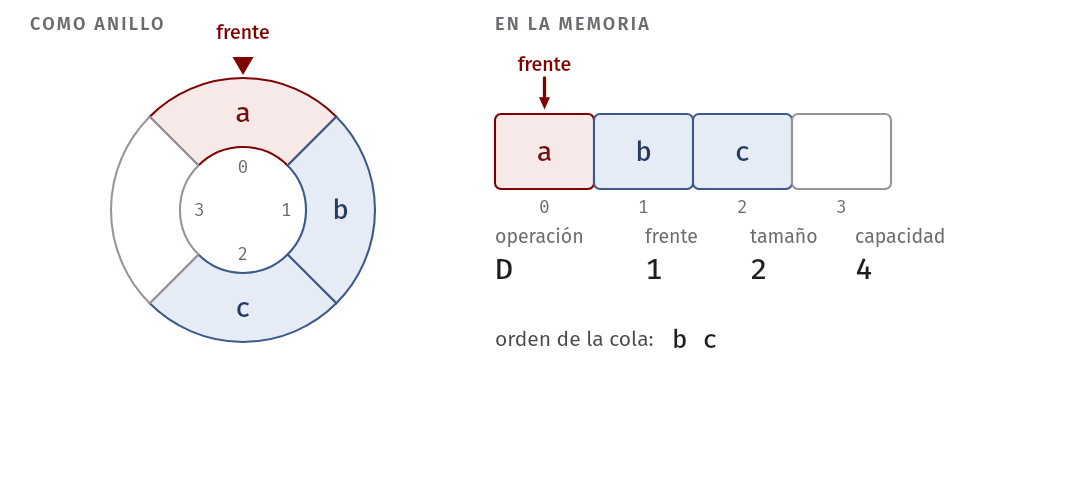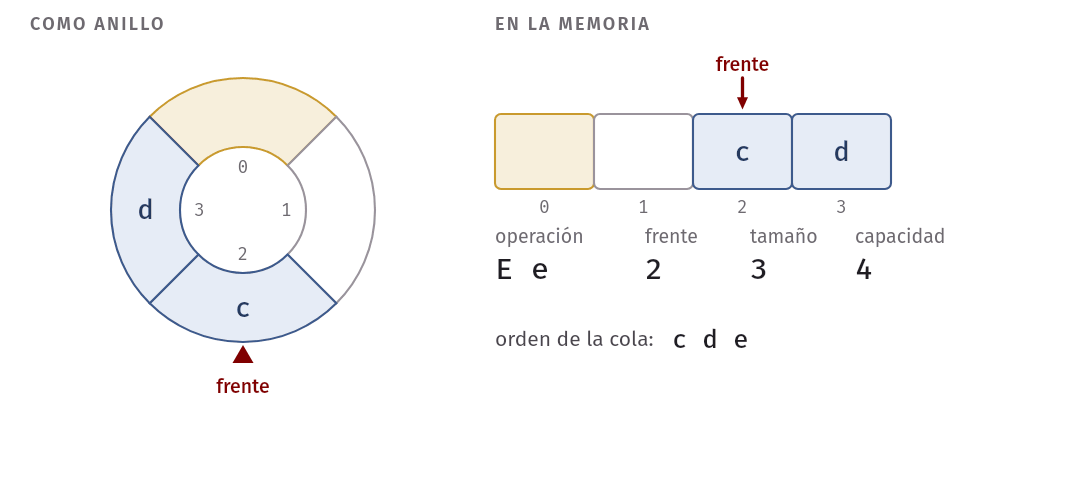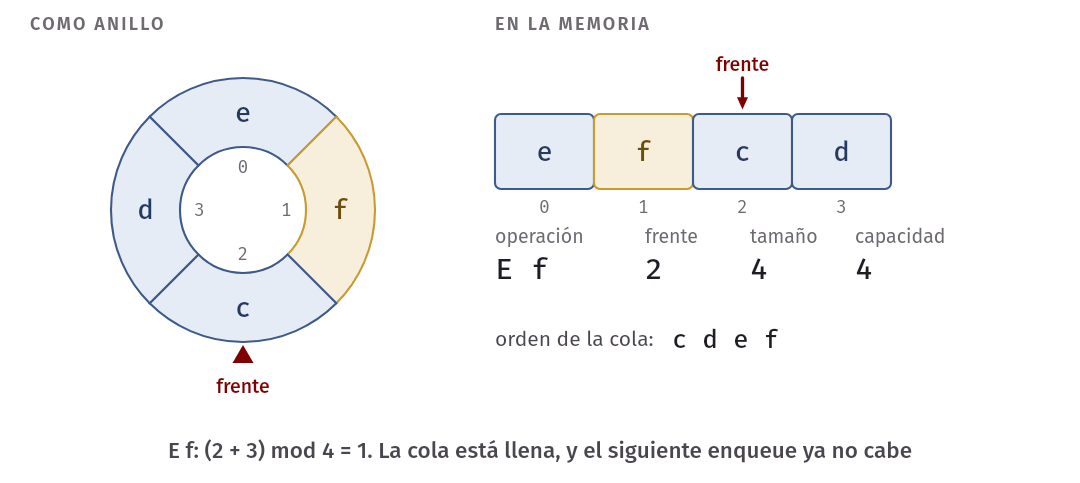
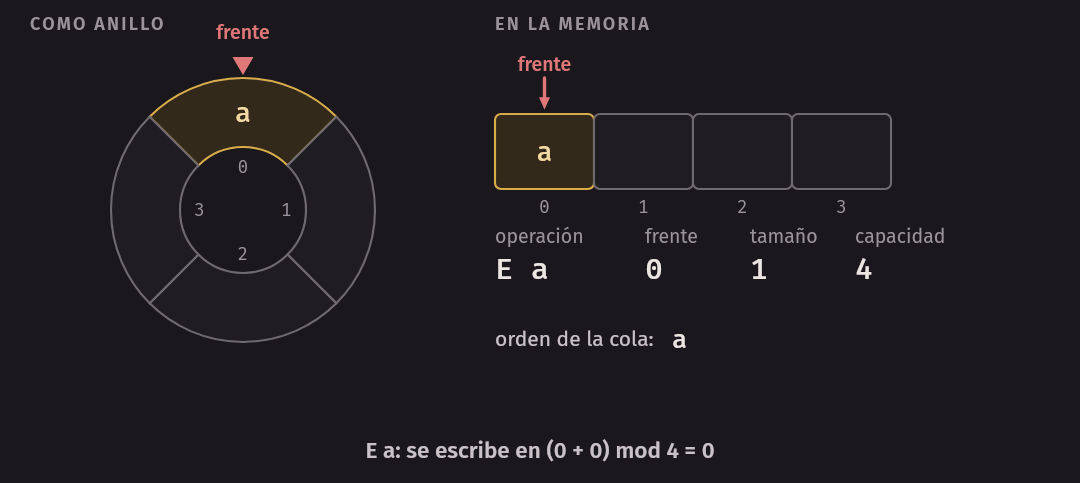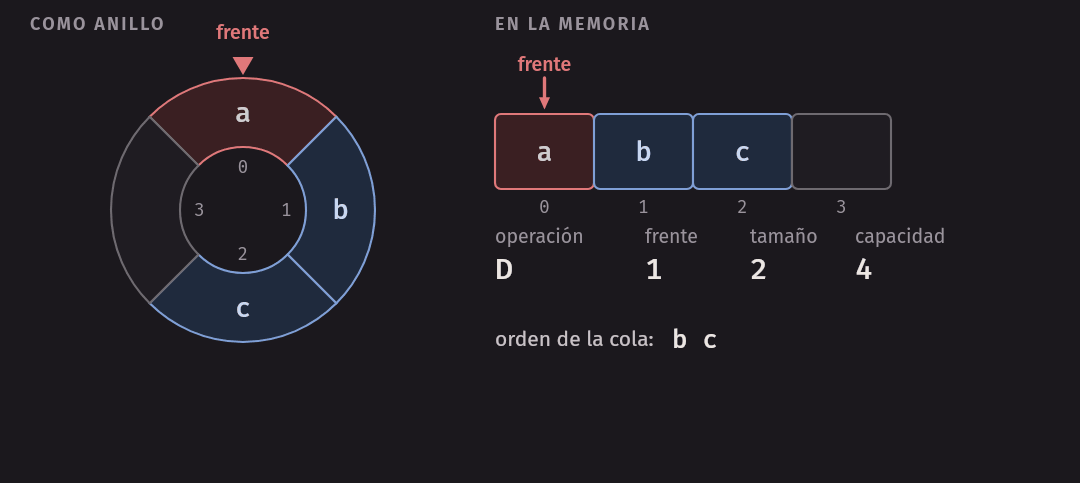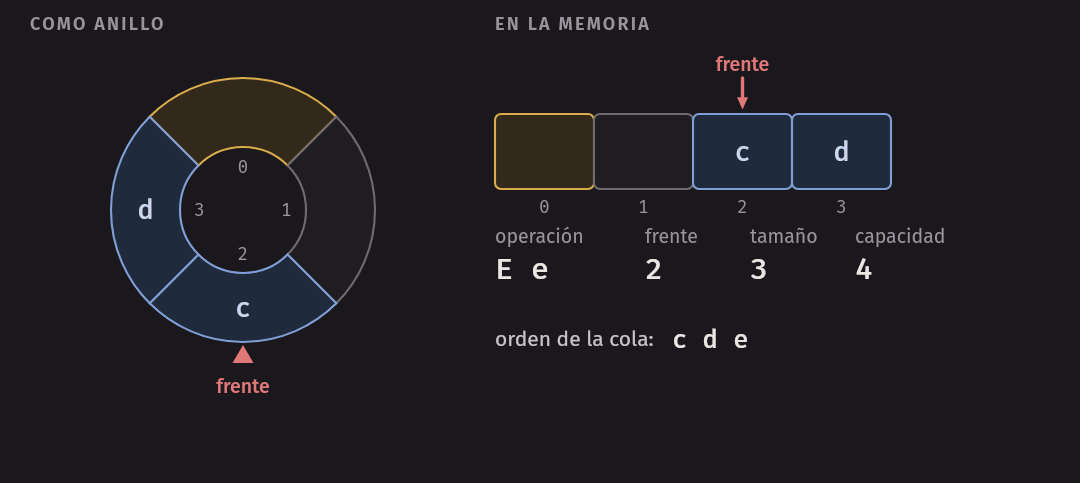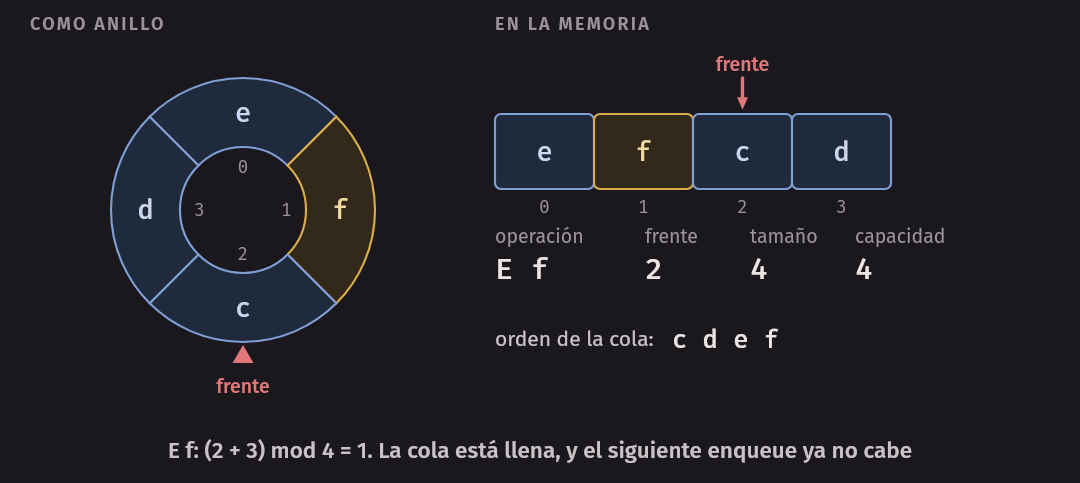
| E f | posición (2 + 3) mod 4 = 1 | e f c d |
2 | 4 |
Fíjense en la séptima fila: e dio la vuelta, y queda antes que c en la memoria, aunque en la cola va
después. El orden de la cola lo dicta la fórmula, no la posición en el bloque.
¿Por qué guardar el tamaño?
Una alternativa común es guardar dos índices, frente y final. Tiene un problema: en una cola vacía los dos coinciden, y en una cola llena también, porque el final dio toda la vuelta. Sin más información, no se distinguen. Con frente y tamaño no hay ambigüedad: vacía es tamaño 0, y llena es tamaño = capacidad.
Al crecer hay que desenrollar
Un buffer circular lleno crece igual que un arreglo dinámico: duplicar, trasladar, liberar. Salvo por un
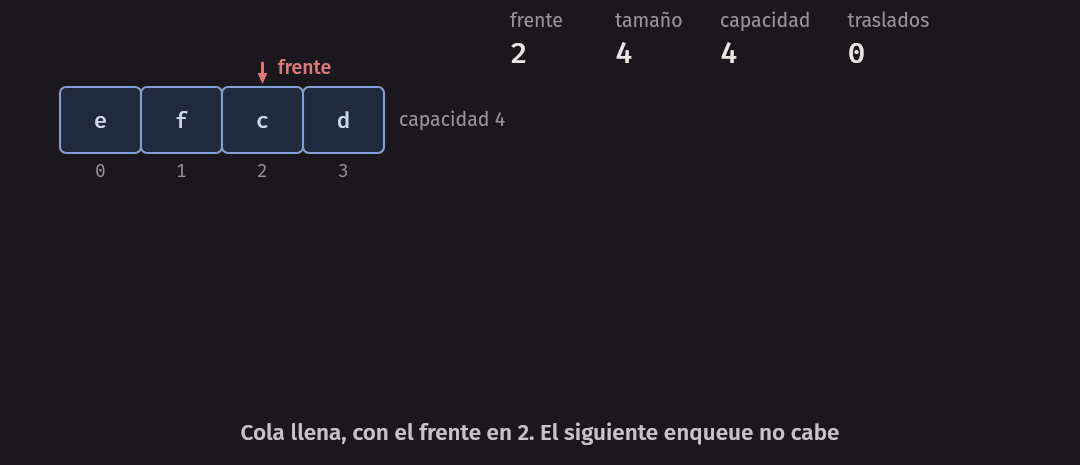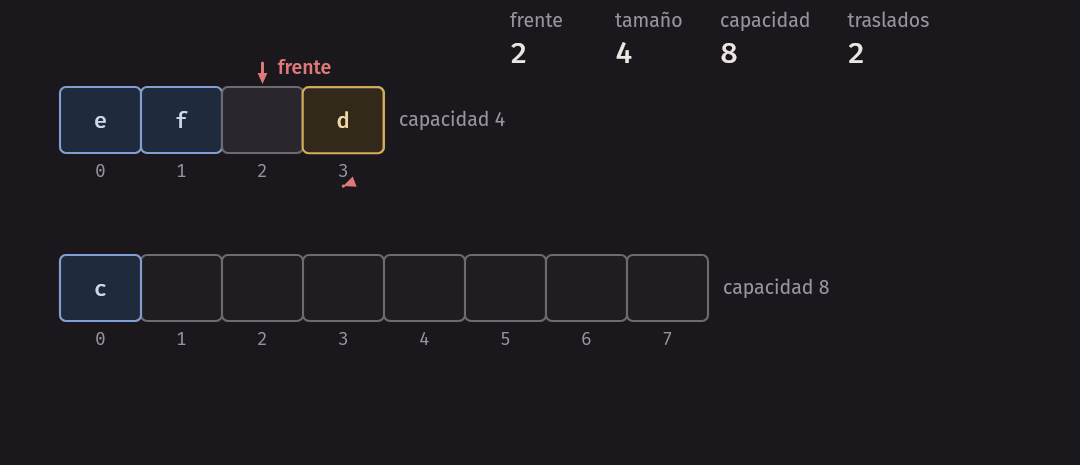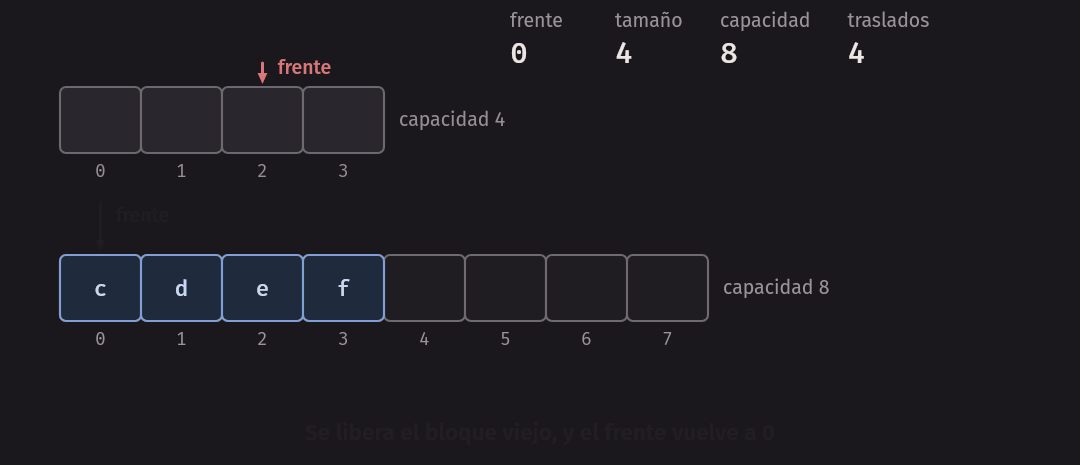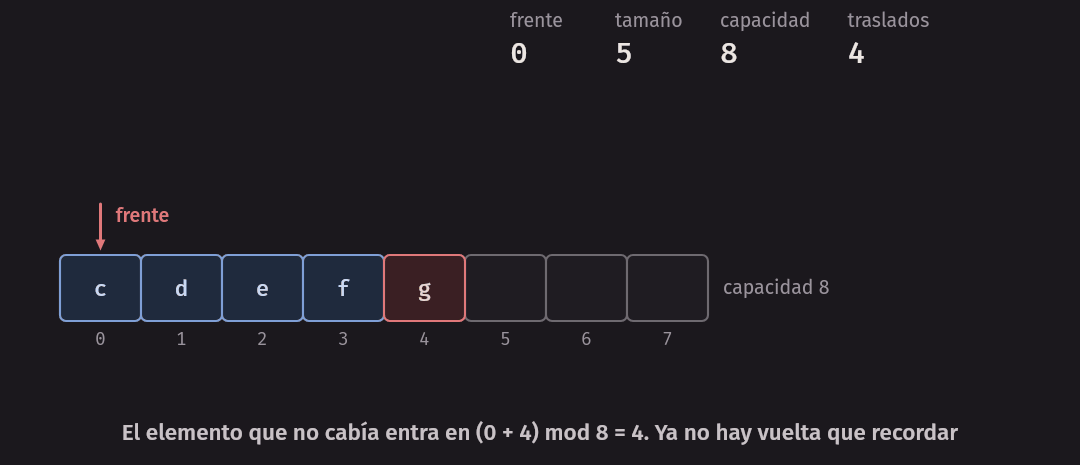
detalle. Veamos el estado de la traza con la cola llena, e f c d, con frente en 2. El siguiente enqueue
ya no cabe.
Error común. Crecer copiando cada casilla a la misma posición del bloque nuevo. Quedaría así, en capacidad 8:
e f c d . . . .con frente en 2. El elemento 2 de la cola, según la fórmula, estaría ahora en (2 + 2) mod 8 = 4, pero esa casilla está vacía:ese quedó en la posición 0. La fórmula depende de la capacidad, así que al cambiar la capacidad, cambian las posiciones.
La solución es desenrollar (unroll): recorrer la cola en su orden, y escribirla desde la posición 0 del bloque nuevo. El elemento i de la cola pasa de la posición vieja (frente + i) mod capacidad_vieja a la posición nueva i. Y el frente vuelve a 0.
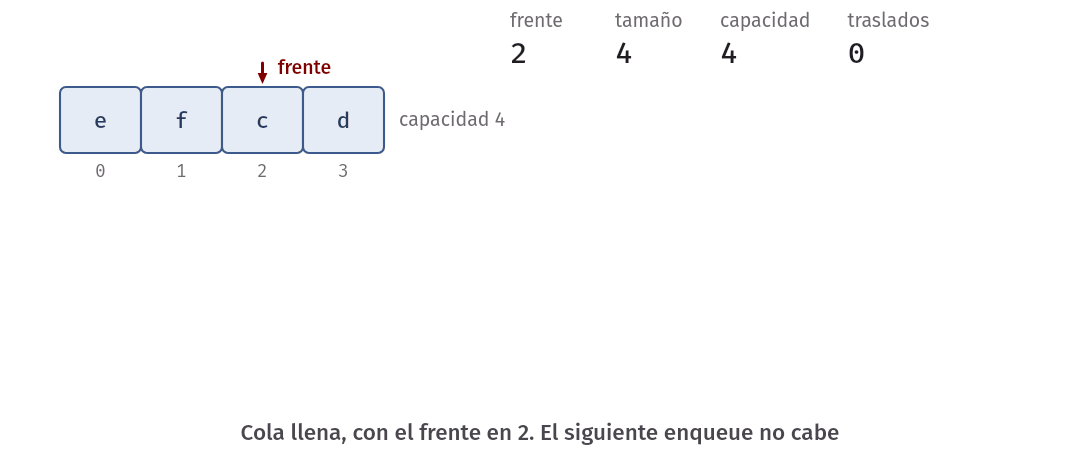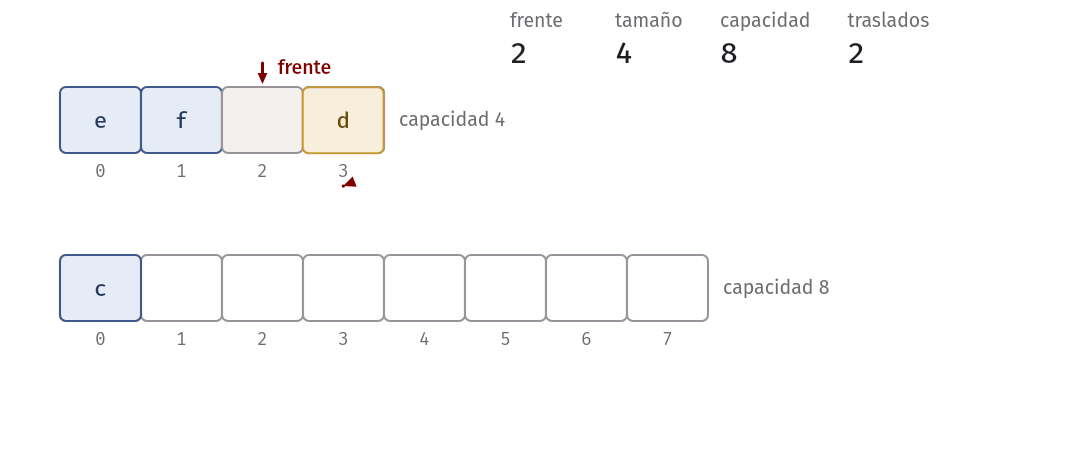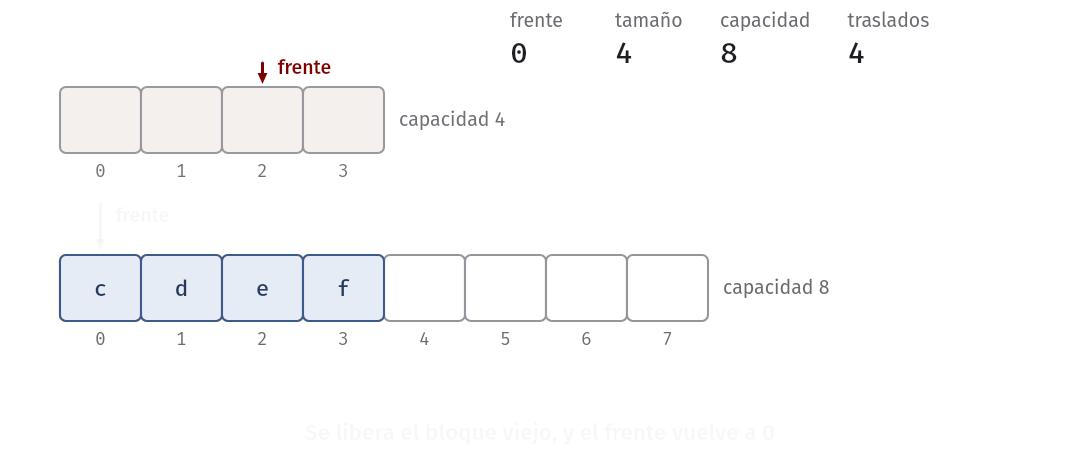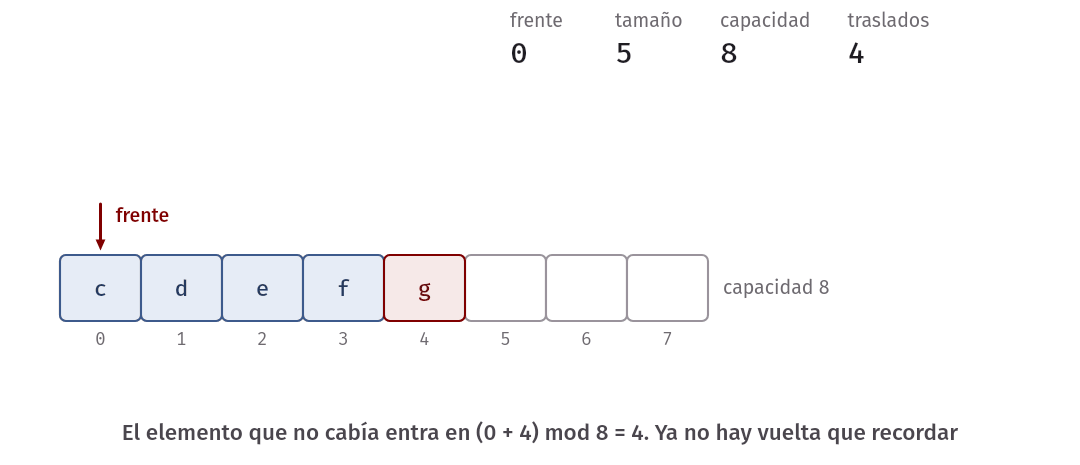
Por eso la traza de ring_trace muestra (desenrolla), con frente 0, y el siguiente elemento en la
posición 4. La línea desenrollar de la salida hace lo mismo con una cola de capacidad 8 y frente 5, y
da 5->0 6->1 7->2 0->3 1->4 2->5 3->6 4->7. El último renglón confirma que, con frente 0, las
posiciones vuelven a ser consecutivas.
¿Y el costo? Desenrollar traslada cada elemento una vez, igual que crecer. La cuenta es exactamente la misma
de antes: con duplicación, menos de 2n traslados en n enqueue desde vacío, y dequeue no traslada nada.
Por eso enqueue es O(1) amortizado y dequeue es Θ(1). Si se quiere encoger, se aplica la regla
del cuarto, y también se desenrolla.
| Implementación de la cola | enqueue |
dequeue |
Problema |
|---|---|---|---|
| Arreglo, con el frente siempre en 0 | O(1) amortizado | Θ(n) | Vaciar es cuadrático |
| Arreglo, con un índice que solo avanza | O(1) amortizado | Θ(1) | Las casillas de atrás se pierden |
| Buffer circular | O(1) amortizado | Θ(1) | Ninguno de los dos |
Esta semana el buffer circular queda en papel: los ejercicios del final lo piden con trazas y dibujos, y la próxima semana lo implementan en el laboratorio, ampliado a un deque, que inserta y saca por los dos extremos.
El código de esta semana
Todo está en code/week-04:
| Archivo | Qué muestra |
|---|---|
capacity_growth.cpp |
Cuándo cambia la capacidad de std::vector |
growth_math.h, growth_count.cpp |
Cuenta de traslados con cada regla, sin guardar elementos |
growth_time.cpp, bench.h |
Medición: duplicar frente a crecer de a 1000 |
shrink_policies.cpp |
Encoger a la mitad frente a encoger a un cuarto |
tracked.h, move_or_copy.cpp |
Copiar o mover al crecer, según noexcept |
copy_block.cpp, strong_guarantee.cpp |
Excepciones: el molde, y qué queda si falla el crecimiento |
lifetimes.cpp |
new T[n] frente a std::vector: cuántos objetos hay vivos |
stable_refs.cpp, vector_facts.cpp |
Invalidación y otras afirmaciones sobre std::vector |
front_removal.cpp, ring_trace.cpp |
Sacar del frente, y la aritmética del buffer circular |
claims_tests.cpp |
Comprueba con assert las cuentas de este capítulo |
errors/ |
Programas con errores a propósito |
lab/ |
El laboratorio: empiecen por lab/README.md |
make test corre los ejemplos, las pruebas, y vuelve a ejecutar los comandos de este capítulo para
comprobar que su salida es la que aparece aquí, salvo la de los tiempos, que depende de la máquina.
El laboratorio
Esta semana hay una sola sesión de laboratorio, de 2 horas, porque la otra es la Práctica 1. La guía,
con tiempos sugeridos, está en code/week-04/lab/README.md. Se trata de
tres cosas:
- Escribir
Vector<T>:push_back,pop_back,operator[],size,capacity,reservey las cinco funciones de la regla de cinco. Recibenvector.hcon los invariantes y las firmas. - Pasar las pruebas dadas con ASan, incluidas las que cuentan copias con un tipo instrumentado.
- Medir con el medidor de la semana 3
push_backduplicando frente a crecer de a 1000, y explicar el resultado con el cálculo de la teoría.
No hay que tocar el Vector para crecer de a 1000: el programa de medición lo logra desde fuera, con
reserve, igual que fill_step. Si reserve queda en la capacidad exacta que se le pide, esa parte
funciona sola.
make lab
make test-lab
Resumen
- Un arreglo dinámico tiene un tamaño y una capacidad. Cuando se llena: pide un bloque mayor, traslada todo y libera el anterior.
- Crecer de a k traslada k · m(m + 1)/2 elementos, con m = ⌊(n − 1)/k⌋. Eso es Θ(n²/k): cuadrático, por grande que sea k.
- Duplicar traslada 1 + 2 + 4 + … + 2^j, entre n − 1 y 2n − 3 elementos para n ≥ 2. Eso es menos de 2n: lineal.
- El costo amortizado es el total de la peor serie de n operaciones desde vacío, dividido entre n.
push_backcuesta menos de 3 unidades amortizadas, aunque una llamada pueda costar Θ(n). - Amortizado no es caso promedio: no hay probabilidades, y vale para toda serie.
- Para encoger sin oscilar, se reduce a la mitad al llegar a un cuarto, no a la mitad. Así los traslados no pasan de 2 por operación.
std::vectorusastd::move_if_noexceptal crecer: mueve si el movimiento esnoexcept, y si no copia, para dar la garantía fuerte. Unnoexceptolvidado se paga en copias.- Crecer invalida referencias, punteros e iteradores. No guarden una referencia a
v[0]y luego haganpush_back. Usen índices, oreserve. new T[c]exige un constructor sin argumentos, y mantienecobjetos vivos.std::vectorno tiene esos límites.- Una cola saca lo primero que entró. En un arreglo normal, sacar del frente cuesta Θ(n).
- En un buffer circular, el elemento i está en (frente + i) mod capacidad. Al crecer se desenrolla.
Ejercicios
-
Partiendo de capacidad 1 y duplicando, ¿cuántos traslados se hacen en total para insertar 16 elementos? ¿Y para insertar 17? ¿Y 33? Compruébenlo con la fórmula 2^(j+1) − 1.
-
Un compañero dice: “Duplicar hace menos de n copias para n inserciones”. Muestren con un valor concreto de n que es falso, y escriban la cota correcta.
-
Expliquen con sus palabras la diferencia entre costo amortizado y caso promedio. Después digan cuál de los dos describe cada frase: (a) “buscar en esta tabla revisa dos casillas, si las claves están bien repartidas”; (b) “un millón de
push_backno pasan de tres millones de escrituras”. -
Una sola llamada a
push_back, ¿puede costar Θ(n)? Den el número exacto de traslados de la inserción 1025 en un arreglo que parte vacío y duplica. Expliquen cómo eso no contradice el “O(1) amortizado”. -
Usen la fórmula k · m(m + 1)/2 para calcular los traslados con k = 1000 y n = 200 000. Hagan lo mismo con k = 10 000. ¿Por cuánto se dividió el costo? ¿Dejó de ser cuadrático? Duplicando n en cada caso, ¿por cuánto se multiplica aproximadamente?
-
Digan cuántas escrituras (valores insertados más traslados) hacen 1000
push_backdesde vacío al duplicar, y calculen el costo por operación. ¿Respeta la cota de 3? -
Tomen la regla de encoger al llegar a la mitad. Partiendo de capacidad 16 y tamaño 16, escriban una tabla con cuatro operaciones que trasladen 16 elementos cada una. Luego repitan las mismas operaciones con la regla del cuarto.
-
En un
Vectorconnew T[c], ¿cuántos objetos vivos hay después dev.reserve(50)y trespush_back? ¿Y en unstd::vector? Justifiquen, y comprueben el caso destd::vectorcontracked.h. -
Escriban una clase con un movimiento propio y sin
noexcept, e insértenla en unstd::vector. Cuenten las copias, agreguennoexcepty vuelvan a contar. Luego agréguenle aStudentun destructor vacío y comprueben constd::is_nothrow_move_constructible_vqué cambia. Expliquen por qué. -
Este código tiene un error. Encuéntrenlo sin ejecutarlo, y escriban dos formas de arreglarlo.
std::vector<std::string> names = {"ana"}; const std::string& first = names[0]; names.push_back("beto"); std::cout << first << "\n"; -
En papel. Una cola sobre un buffer circular tiene capacidad 8, con frente en 6 y tamaño 4. (a) ¿En qué posiciones están los elementos? (b) Hagan una traza de: encolar, encolar, desencolar, desencolar, desencolar, encolar. Por cada operación, escriban la posición usada, el frente y el tamaño. (c) Desde el estado final, encolen hasta que haga falta crecer, y dibujen el bloque de capacidad 16 después de desenrollar.
-
Para pensar. Una versión de la cola guarda frente y final, en vez de frente y tamaño. Muestren dos estados, uno vacío y uno lleno, con los mismos dos índices. Propongan dos formas de distinguirlos, y digan cuánto cuesta cada una. Después piensen en qué fallaría si la capacidad fuera 0 al calcular
(frente + i) mod capacidad, y cómo lo evitarían.