Apuntes · Capítulo 5Secuencias y ordenamiento
Listas enlazadas y deques
Listas enlazadas y deques
La semana pasada construimos un arreglo dinámico. Sus elementos están uno al lado del otro, y de eso salen sus dos virtudes: llegar al elemento i cuesta O(1), y crecer cuesta O(1) amortizado. De lo mismo salen sus dos defectos. Insertar al inicio obliga a mover todo, y cuando el bloque crece cambia de lugar, así que todo puntero o iterador que apuntaba adentro queda inválido. También vimos, solo en teoría, el buffer circular: un arreglo que da la vuelta para sacar del frente sin mover nada.
Hoy cambiamos la decisión de fondo: cada elemento vive en su propio bloque, y los bloques se unen con punteros. Eso es una lista enlazada (linked list). Insertar y sacar en un punto conocido cuesta O(1) y ningún elemento se mueve jamás. A cambio, llegar al elemento i cuesta Θ(i), y cada elemento paga una reserva de memoria y sus punteros.
También veremos tres cosas que van más allá de las listas. Un nodo centinela, que elimina casos especiales
del código. Los iteradores, que explican qué hace realmente un for por rango. Y una pregunta que nos
acompañará todo el curso: un buffer circular y una lista doble implementan el mismo deque con el mismo O(1), y
al medirlos una de ellas puede ser decenas de veces más lenta. ¿Qué está viendo el reloj que O no ve?
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Nodos en la memoria y Lista simplemente enlazada.
- En clase: Lista doble con nodo centinela, Iteradores, Cuándo se invalida un iterador, El tipo abstracto deque, Dos representaciones con el mismo O(1) y Lo que O no ve.
- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de la semana. Opcional: Open Data Structures, secs. 2.4 (ArrayDeque), 3.1 (SLList) y 3.2 (DLList); CLRS, capítulo Elementary Data Structures.
Código. Los programas de este capítulo están en
code/week-05. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Nodos en la memoria
Un nodo (node) es un bloque de memoria dinámica que guarda un elemento y uno o más punteros a otros nodos. Una lista enlazada es una secuencia de nodos en la que cada uno dice cuál es el siguiente.
Definición. Una lista simplemente enlazada de n elementos es una secuencia de n nodos x₀, …, xₙ₋₁ tal que el
puntero next de xᵢ apunta a xᵢ₊₁, y el de xₙ₋₁ es nulo. Un puntero head da acceso a x₀. Si n = 0, head es
nulo.
La definición no dice dónde está cada nodo, y esa es la idea. En un arreglo, el orden de los elementos y el orden en la memoria son lo mismo. En una lista son cosas independientes: el orden lo dan los punteros, y los nodos pueden estar en cualquier parte. Así se dibuja una lista de tres elementos, y es lo primero que hay que hacer antes de programar cualquier operación:
head ──> [ 10 | ●─]──> [ 20 | ●─]──> [ 30 | nulo ]Y esto es lo que hay en una memoria de verdad. Este programa imprime la distancia en bytes de cada elemento al primero, en un arreglo y en listas construidas de tres maneras distintas. Las distancias dependen de la biblioteca y de la máquina; lo que vale la pena mirar es su forma.
$ build/node_addresses
arreglo: 0 4 8 12 16 20
lista: 0 32 64 96 128 160
con otras reservas: 0 80 208 368 576 816
lista barajada: 0 -32 32 128 64 96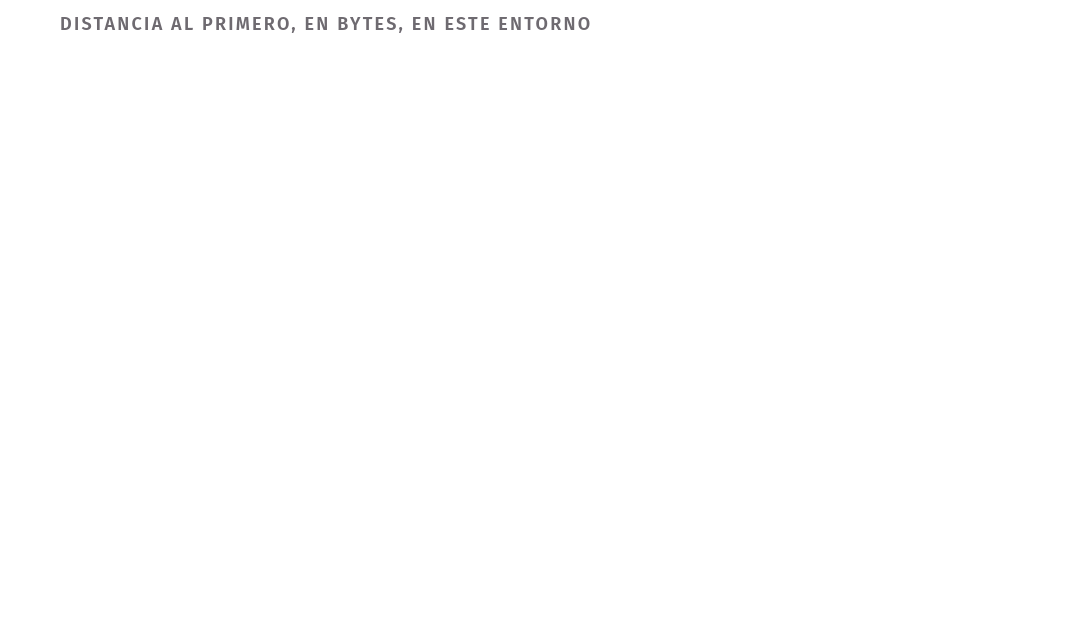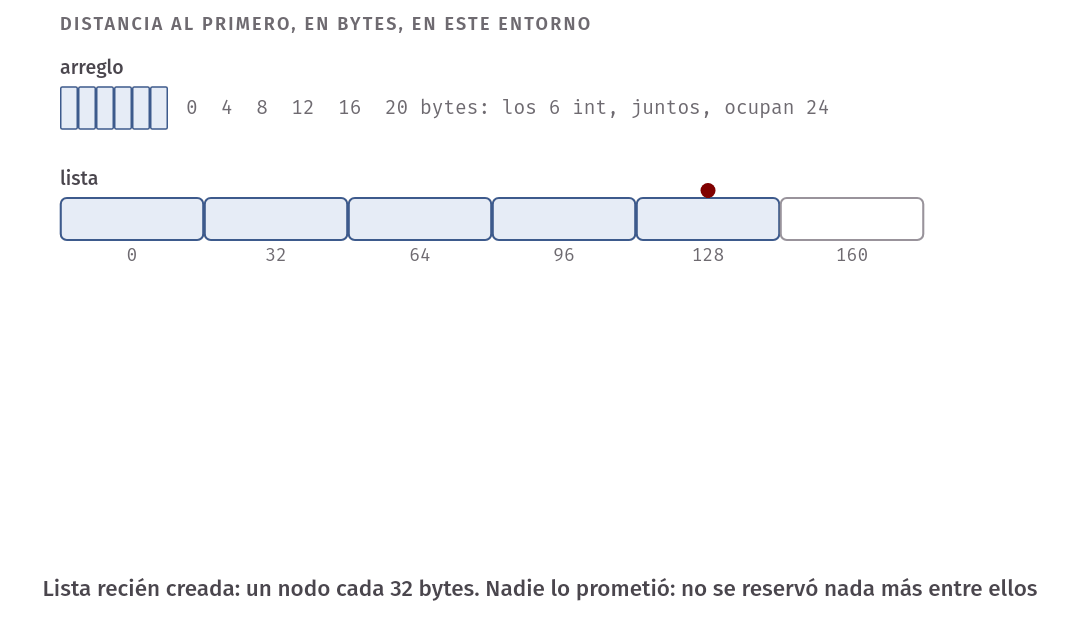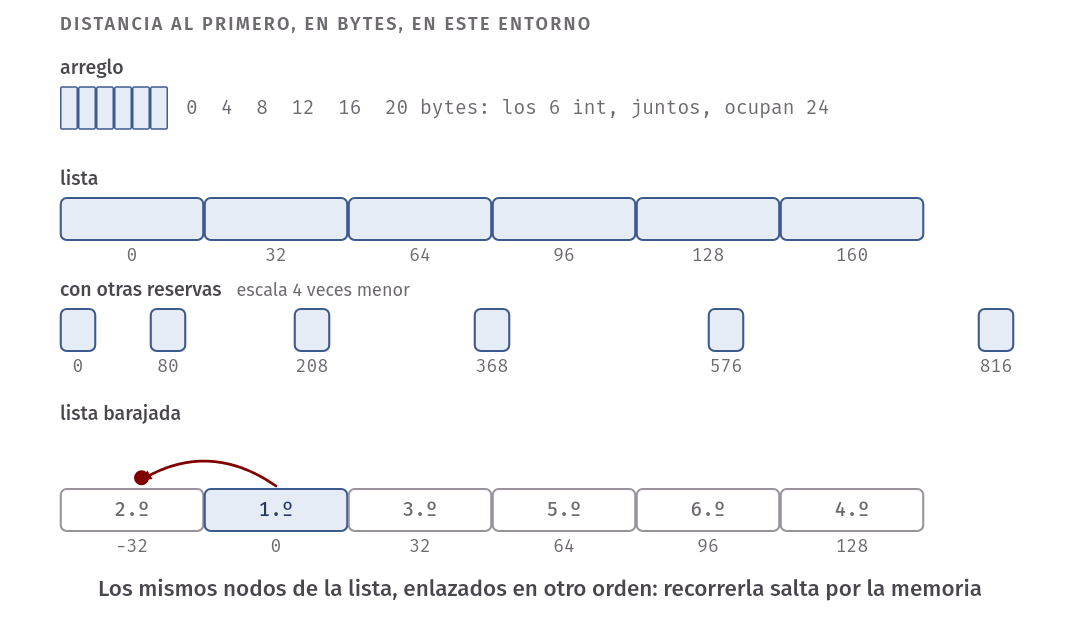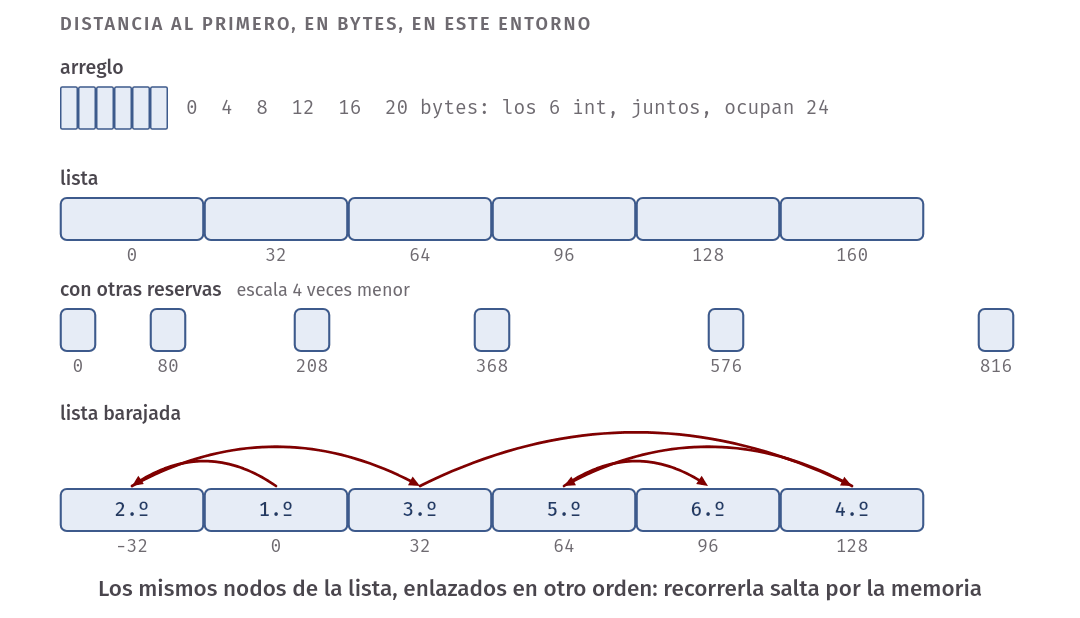
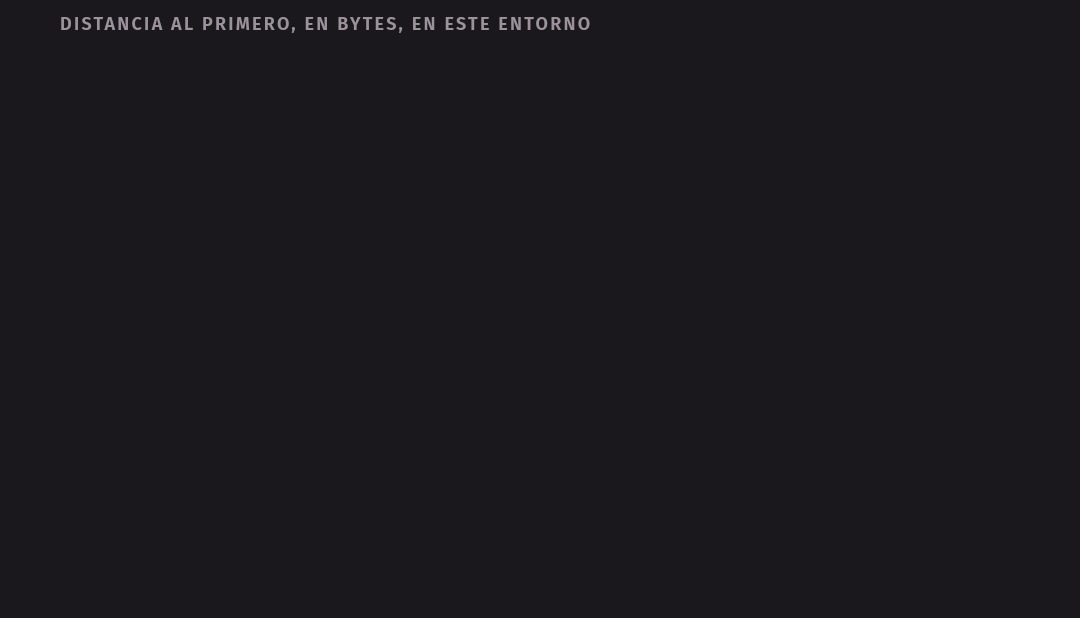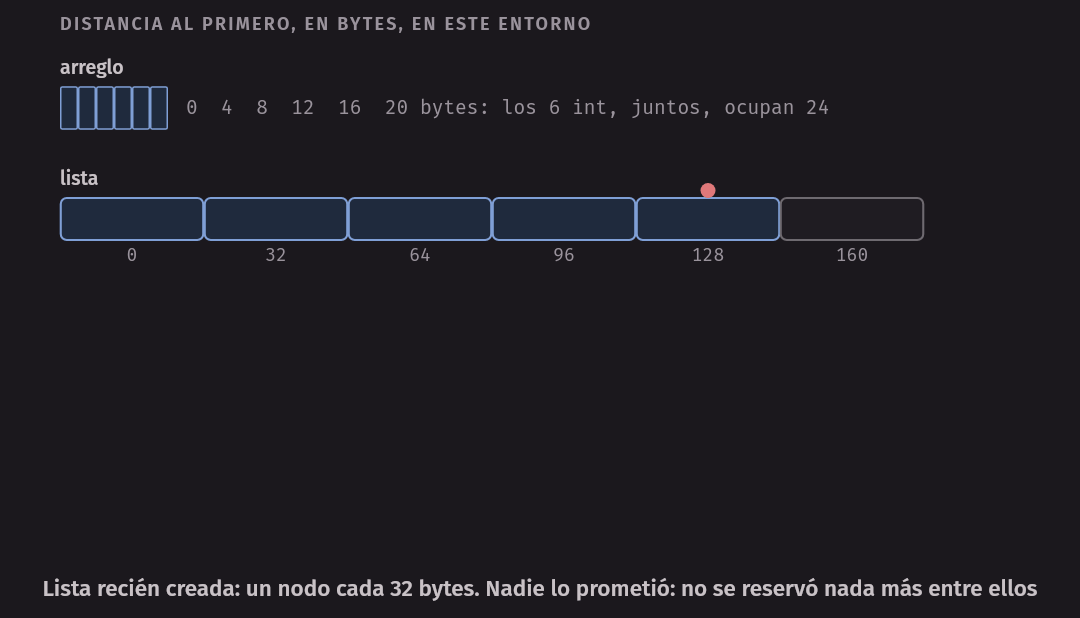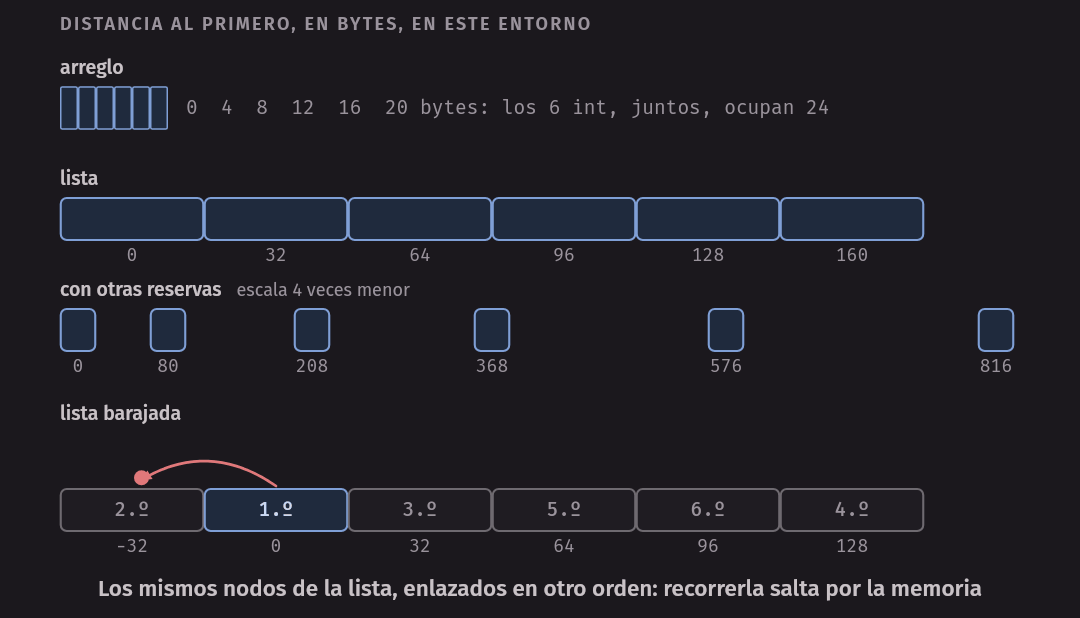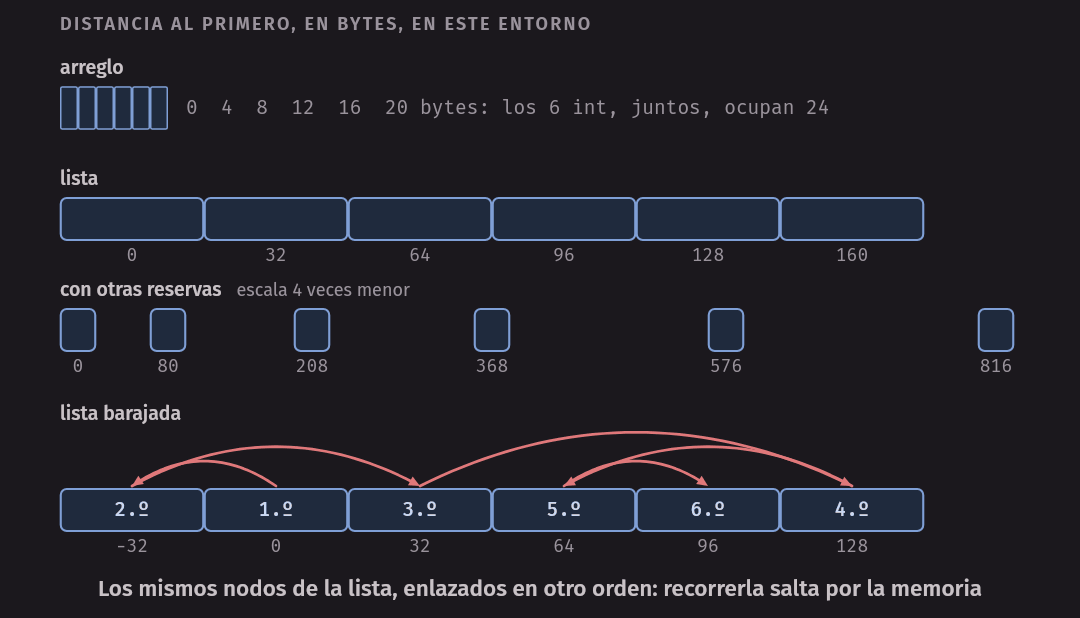
Tres observaciones:
- En el arreglo, cada
intestá a 4 bytes del anterior. El estándar garantiza que van contiguos, asizeof(int)bytes, y ese tamaño es 4 en este entorno. - En la lista recién creada, cada nodo está a 32 bytes del anterior. Nadie lo prometió. Ocurre porque
el programa no reservó nada más entre nodo y nodo, y porque en esta biblioteca un nodo de 24 bytes ocupa un
bloque de 32. Un
intocupa ahora ocho veces más. - La tercera lista se construyó intercalando otras reservas, como pasa en un programa que hace varias cosas a la vez. Sus nodos ya no están seguidos. Y la cuarta tiene los mismos nodos de la segunda, enlazados en otro orden: el orden de la lista ya no tiene relación con el orden en la memoria.
Volveremos a estas cuatro formas al medir: explican casi todo lo que veremos al final del capítulo.
Lista simplemente enlazada
Cada nodo tiene el elemento y un puntero al siguiente. La clase guarda head_ y, para poder insertar al final,
tail_. Es un template, igual que la pila de la semana 2.
template <typename T>
class SinglyList {
...
private:
    struct Node {
        T value;
        Node* next;
    };

    Node* head_ = nullptr;
    Node* tail_ = nullptr;
    std::size_t size_ = 0;
};
Sus invariantes, como en la semana 2, se escriben en un comentario y se comprueban en check_invariants:
head_es nulo si y solo sitail_es nulo si y solo sisize_ == 0.- Siguiendo
nextdesdehead_se visitansize_nodos, y el último estail_. tail_->nextes nulo.
Insertar y sacar al inicio
Para insertar al inicio basta crear el nodo apuntando al que era primero, y actualizar head_:
void push_front(const T& value) {
    head_ = new Node{value, head_};
    if (tail_ == nullptr) {
        tail_ = head_;
    }
    size_++;
}
Sigamos push_front(10) sobre una lista que tiene [20 30]. El lado derecho se evalúa primero, así que el
nodo nuevo recibe el head_ antiguo:
antes     head_ ──────────────> [ 20 | ●─]──> [ 30 | nulo ]

new       head_ ──────────────> [ 20 | ●─]──> [ 30 | nulo ]
                                  ^
                  [ 10 | ●─]──────┘

después   head_ ──> [ 10 | ●─]──> [ 20 | ●─]──> [ 30 | nulo ]
No importa cuántos elementos tenga la lista: se ejecuta la misma cantidad de instrucciones, y ningún elemento
se mueve. Si contamos la reserva de memoria como una operación, push_front cuesta O(1). Esa suposición merece
una aclaración: el estándar de C++ no le pone un costo a new, y new no es gratis. Lo medimos más adelante.
Sacar del inicio es el proceso inverso:
void pop_front() {
    assert(!empty());
    Node* old_head = head_;
    head_ = old_head->next;
    delete old_head;
    if (head_ == nullptr) {
        tail_ = nullptr;
    }
    size_--;
}
El orden importa. Primero se guarda el nodo y se avanza head_, y recién después se borra. Si se borrara primero,
leer old_head->next sería un acceso a memoria liberada.
Miren también los dos if. La lista vacía obliga a tratar tail_ aparte, tanto al insertar como al sacar.
Son casos especiales reales, y olvidarlos es un bug clásico. La prueba test_singly_list insiste en ese punto: vacía
la lista e inserta de nuevo.
Insertar al final y llegar al elemento i
Con tail_, insertar al final también es O(1):
void push_back(const T& value) {
    Node* node = new Node{value, nullptr};
    if (tail_ == nullptr) {
        head_ = node;
    } else {
        tail_->next = node;
    }
    tail_ = node;
    size_++;
}
Con esto ya tenemos una cola: push_back para entrar y pop_front para salir, las dos en O(1) y sin
capacidad que administrar. Lo que no se puede hacer bien es sacar del final. Para sacar el último hay que
dejar a tail_ en el penúltimo, y un nodo no sabe quién está antes de él. Hay que recorrer desde head_, así
que pop_back costaría Θ(n). Por eso esta clase no lo ofrece, y por eso existe la lista doble.
Para llegar al elemento i no hay aritmética de punteros posible, porque los nodos no están seguidos. Solo queda saltar:
T& at(std::size_t i) {
    assert(i < size_);
    Node* node = head_;
    for (std::size_t step = 0; step < i; step++) {
        node = node->next;
    }
    return node->value;
}
Son exactamente i saltos: Θ(i). Eso tiene una consecuencia sobre cómo se usa. Este ciclo de slist_demo.cpp
imprime la lista, y como cada at(i) empieza de nuevo desde head_, hace 0 + 1 + … + (n − 1) saltos, que es
Θ(n²):
for (std::size_t i = 0; i < list.size(); i++) {
    std::cout << (i == 0 ? "" : " ") << list.at(i);
}
Con una lista de tres ciudades no importa, y por eso aparece aquí. Para recorrer de verdad necesitamos otra herramienta: el iterador, unas secciones más adelante.
$ build/slist_demo
[puno cusco lima] tamaño 3
[cusco lima] tamaño 2
[cusco lima tacna] tamaño 3
at(2) = tacna
Lista contra arreglo
| Operación | Lista simple con tail_ |
Arreglo dinámico |
|---|---|---|
| Llegar al elemento i | Θ(i) | O(1) |
| Insertar al inicio | O(1) | Θ(n) |
| Sacar del inicio | O(1) | Θ(n) |
| Insertar al final | O(1) | O(1) amortizado |
| Sacar del final | Θ(n) | O(1) |
| Insertar en el medio, ya estando en ese punto | O(1), si se conoce el nodo anterior | Θ(n) en el peor caso |
Idea clave. La lista cambia acceso por posición a cambio de inserción sin mover nada. Ninguna de las dos estructuras es mejor en general: cada una abarata lo que la otra encarece.
El owner de los nodos
La lista es owner de sus nodos: los creó con new y nadie más los conoce. Por eso su destructor, RAII como en
la semana 2, tiene que liberarlos todos. El de SinglyList es corto porque reutiliza pop_front:
~SinglyList() {
    while (head_ != nullptr) {
        pop_front();
    }
}
Esta clase prohíbe copiar y mover (= delete) para concentrarnos en los punteros. Una copia superficial haría
que dos listas fueran owners de los mismos nodos, y la regla de cinco que resuelve eso la escribirán en el
laboratorio.
Error común. Borrar un nodo y luego leer su
nextpara avanzar. Este destructor parece razonable, y hasta puede pasar inadvertido sin sanitizers, porque la memoria recién liberada a menudo sigue teniendo los mismos bytes:
~BadList() {
    for (Node* node = head_; node != nullptr; node = node->next) {
        delete node;
    }
}
El node = node->next del for se ejecuta después del delete del cuerpo. ASan lo señala con precisión:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/use_after_delete.cpp -o build/use_after_delete
$ build/use_after_delete
READ of size 8 at 0x502000000038 thread T0
    #0 0xaaaaac491570 in BadList::~BadList() errors/use_after_delete.cpp:14
...
0x502000000038 is located 8 bytes inside of 16-byte region [0x502000000030,0x502000000040)
freed by thread T0 here:
...
    #1 0xaaaaac4914fc in BadList::~BadList() errors/use_after_delete.cpp:15
Se lee así: una lectura de 8 bytes (un puntero) en la línea 14, dentro de un bloque de 16 bytes (un nodo) que se
liberó en la línea 15. “8 bytes inside” es justamente el campo next. La corrección es leer next antes de
borrar, y es lo que hace el destructor de la lista doble que viene ahora.
Lista doble con nodo centinela
Una lista doblemente enlazada (doubly linked list) agrega a cada nodo un puntero prev al anterior. Con él, un
nodo puede salir de la lista sin que nadie recorra nada: ya sabe quiénes son sus dos vecinos. Eso resuelve
pop_back.
El costo son 8 bytes más por nodo y dos punteros más que mantener. Y, si se escribe de la manera directa, una
colección de casos especiales. Sacar un nodo x de una lista doble con head y tail nulos en los extremos pide
distinguir cuatro situaciones:
| Situación de x | Qué hay que hacer |
|---|---|
| En el medio | x->prev->next = x->next y x->next->prev = x->prev |
| Es el primero | Además, actualizar head. No existe x->prev |
| Es el último | Además, actualizar tail. No existe x->next |
| Es el único | Actualizar los dos |
Todos estos casos existen porque un extremo de la lista apunta a “nada”. La idea para eliminarlos es sencilla: que no haya nada.
El centinela
Definición. Un nodo centinela (sentinel node) es un nodo que siempre está en la lista y no guarda un
elemento. En la lista doble circular con centinela, los nodos forman un ciclo: el next del centinela es el primer
elemento, y su prev es el último. El next del último elemento y el prev del primero son el centinela.
La lista vacía es un centinela que se apunta a sí mismo, con C.next = C y C.prev = C. Con dos elementos, A y B,
cada par de flechas une dos nodos: next hacia la derecha y prev hacia la izquierda. El par de abajo
cierra el ciclo: B.next = C y C.prev = B.
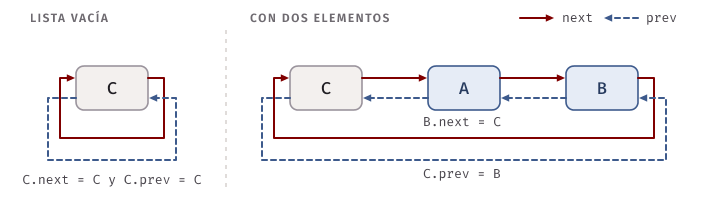
Dicho en una tabla, que es la forma más clara de leerlo:
| Nodo | prev |
next |
|---|---|---|
| C | B | A |
| A | C | B |
| B | A | C |
Ahora todo nodo tiene siempre un anterior y un siguiente, sin excepciones. Esa es una afirmación sobre la estructura, y se puede comprobar: es el invariante de la clase.
// Invariantes:
// - sentinel_ nunca es nulo. Su value no es un elemento de la lista.
// - Los nodos forman un ciclo: para todo nodo x, x->next->prev == x y x->prev->next == x.
// - Siguiendo next desde sentinel_ se visitan size_ nodos antes de volver a sentinel_.
//
// T debe tener constructor por defecto, porque el centinela también guarda un T.
template <typename T>
class DList {
    struct Node {
        T value{};
        Node* prev = nullptr;
        Node* next = nullptr;
    };
Insertar y borrar, sin casos especiales
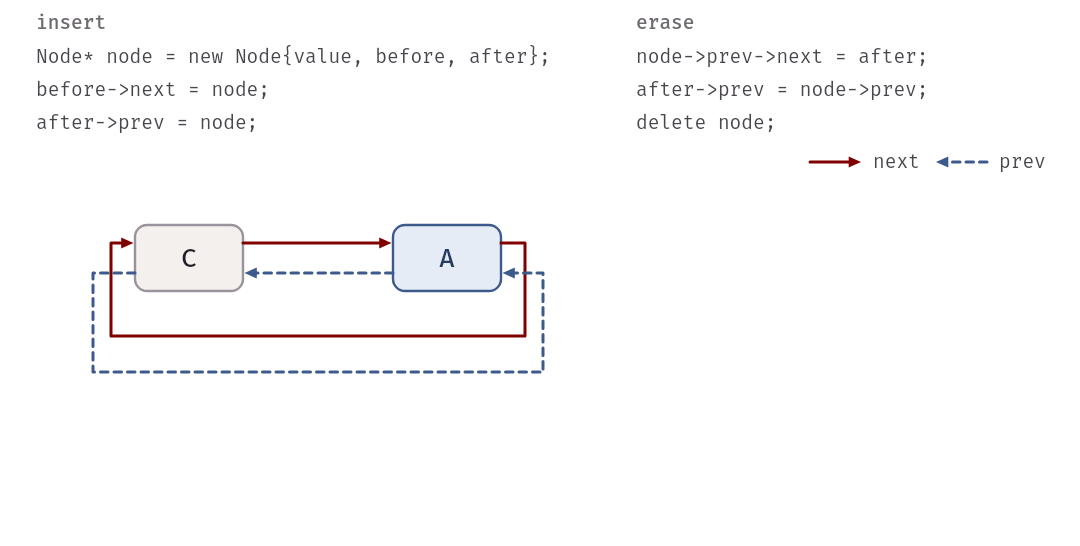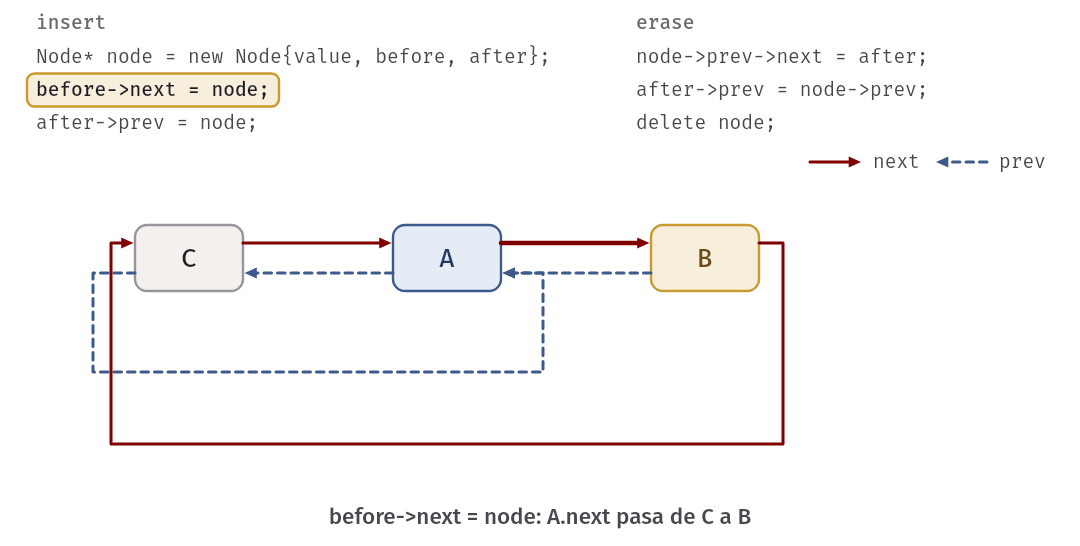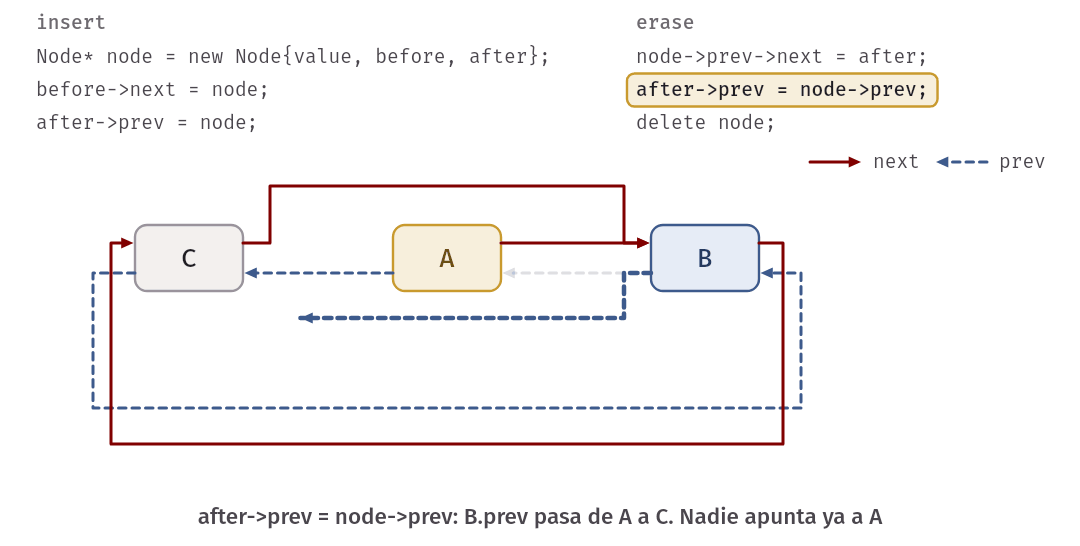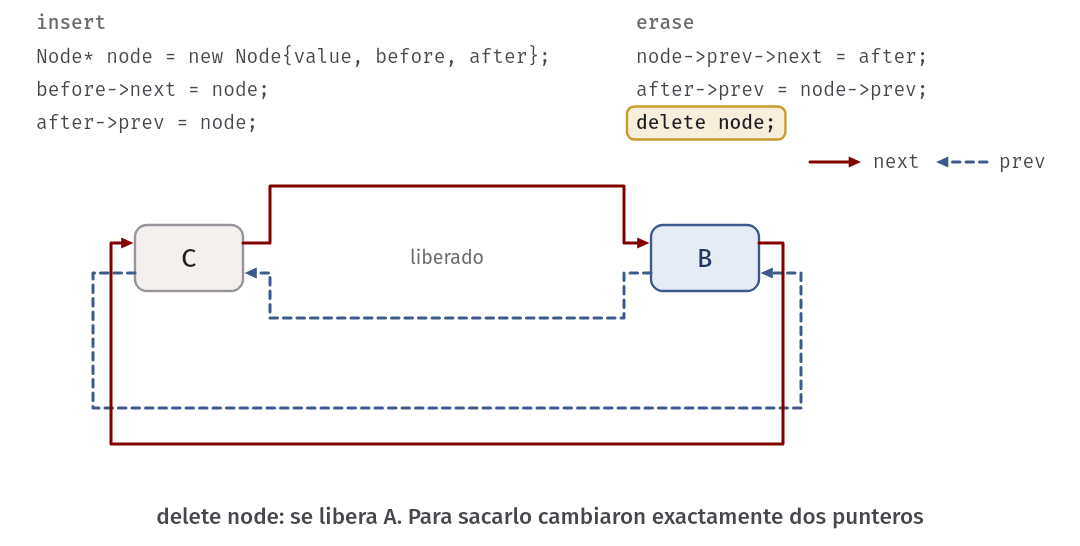
Solo hacen falta dos operaciones. Insertar antes de un nodo:
iterator insert(iterator pos, const T& value) {
    Node* after = pos.node_;
    Node* before = after->prev;
    Node* node = new Node{value, before, after};
    before->next = node;
    after->prev = node;
    size_++;
    return iterator(node);
}
Sigamos insert de B en una lista que solo tiene A, antes del centinela. Es decir, un push_back. Con
before = A y after = C, los punteros cambian así:
| Paso | Lo que se ejecuta | A.next |
C.prev |
B.prev |
B.next |
|---|---|---|---|---|---|
| Inicio | C | A | |||
| 1 | new Node{value, before, after} |
C | A | A | C |
| 2 | before->next = node |
B | A | A | C |
| 3 | after->prev = node |
B | B | A | C |
Ahora el mismo código con la lista vacía, donde before y after son los dos el centinela. La línea before->next = node hace C.next = B, y after->prev = node hace C.prev = B. Queda un ciclo C ↔ B correcto, sin un solo if.
Insertar al inicio, al final, en el medio y en una lista vacía es la misma función.
Borrar un nodo tampoco necesita casos:
iterator erase(iterator pos) {
    assert(pos != end());
    Node* node = pos.node_;
    Node* after = node->next;
    node->prev->next = after;
    after->prev = node->prev;
    delete node;
    size_--;
    return iterator(after);
}
Saquemos A de la lista de dos elementos del dibujo. Cambian exactamente dos punteros: C.next pasa de A a B,
y B.prev pasa de A a C. El nodo A se libera, y su propio prev y next dejan de importar.
| Nodo | prev |
next |
|---|---|---|
| C | B | B |
| B | C | C |
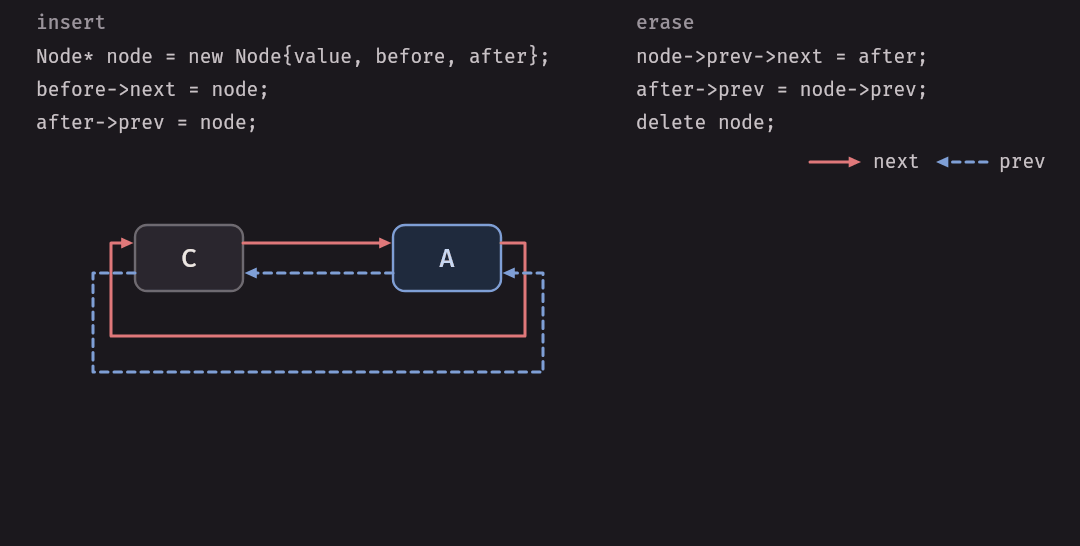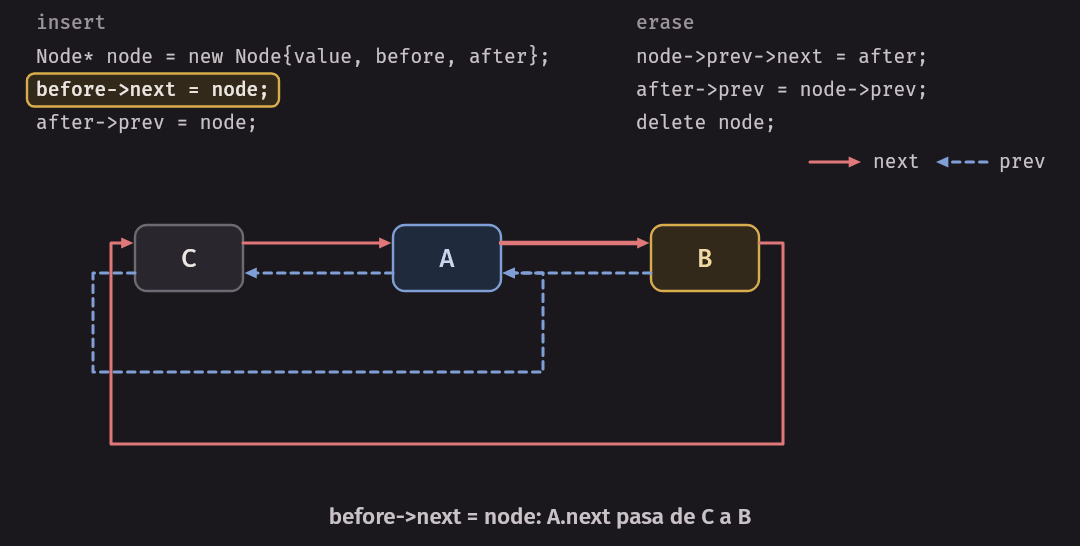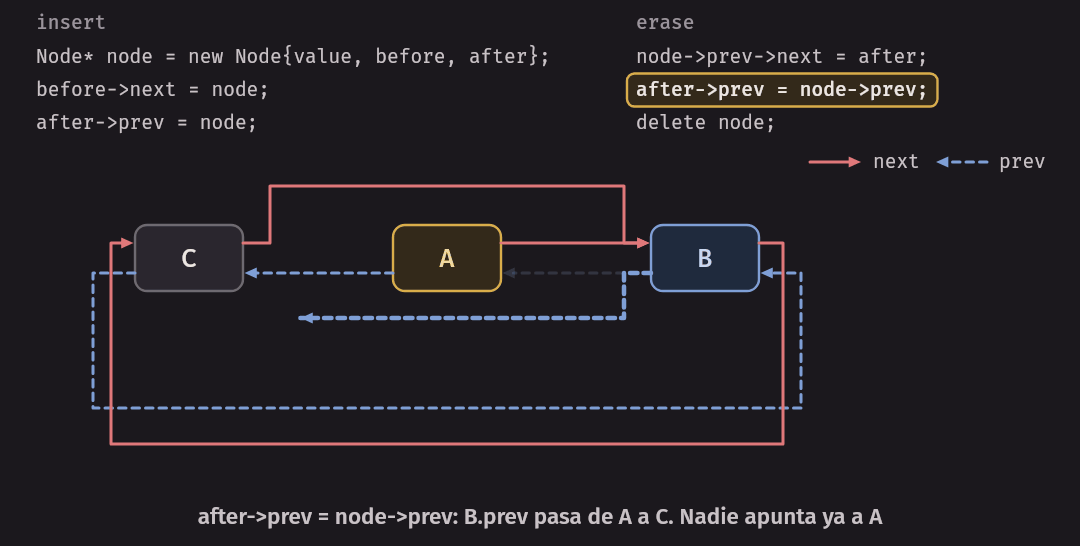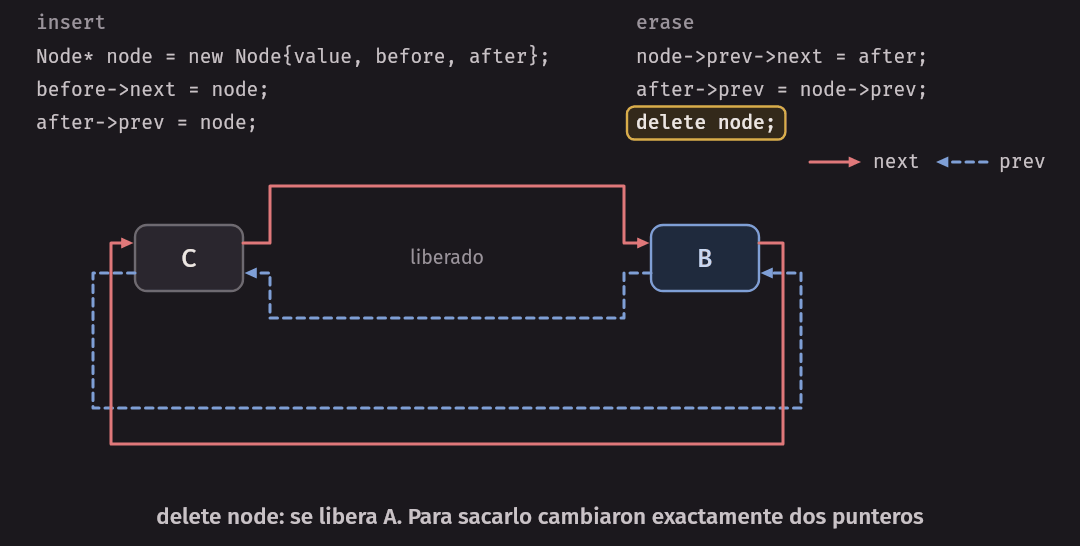
Con esas dos funciones, los cuatro extremos salen en una línea cada uno. Compárenlas con los if de
SinglyList:
void push_front(const T& value) { insert(begin(), value); }
void push_back(const T& value) { insert(end(), value); }
void pop_front() { erase(begin()); }
void pop_back() { erase(iterator(sentinel_->prev)); }
Idea clave. El centinela no agrega funcionalidad, elimina casos. Ya no hay punteros nulos que preguntar, ni un
heady untailque actualizar, ni una lista vacía que tratar aparte. Cadaifque desaparece es un bug que ya no se puede escribir.
La lista funciona igual en los dos sentidos, y el iterador tiene operator--, así que se puede imprimir de atrás
hacia adelante. Esa es una prueba barata de que prev está bien.
$ build/dlist_demo
adelante: 10 20 40
atrás:    40 20 10
adelante: 10 20 30 40
atrás:    40 30 20 10
después de borrar: 40
adelante: 10 20 40
atrás:    40 20 10
tamaño 0, vacía: sí
Quién es owner de qué
La lista es owner de todos sus nodos, incluido el centinela. El constructor lo crea, y el destructor recorre el ciclo liberando hasta volver al centinela, que se libera al final. Fíjense en la línea que evita el error de hace un momento:
~DList() {
    Node* node = sentinel_->next;
    while (node != sentinel_) {
        Node* next = node->next;  // se lee antes de borrar
        delete node;
        node = next;
    }
    delete sentinel_;
}
El centinela da una regla simple para la lista vacía, pero también tiene costos que conviene decir:
- Una lista vacía reserva memoria. El constructor hace un
new, aunque nunca se inserte nada. Tnecesita constructor por defecto. NuestroNodetiene unT value{}, y el centinela también es unNode, así queDList<T>no compila con un tipo que no se pueda construir sin argumentos.
En la biblioteca.
std::listno tiene la segunda restricción. En elg++del curso, sus enlaces están en un tipo aparte (_List_node_base), y solo los nodos normales agregan el valor, así questd::list<T>funciona con unTsin constructor por defecto. Para separarlos usa herencia, que no veremos en este curso.
Mover una lista con centinela
Si escriben la regla de cinco para una lista con centinela en el heap, se encontrarán con un problema que std::vector
no tiene. Después de un movimiento, el origen tiene que seguir siendo válido: como mínimo, se debe poder destruir y
asignar. Pero nuestras operaciones suponen que sentinel_ nunca es nulo. Si el constructor de movimiento se lleva el
centinela, el origen rompe su invariante.
Hay varias salidas. La que usaremos en el laboratorio es la más simple de razonar: el nuevo objeto crea su propio
centinela y luego intercambia con el origen, que queda vacío y con un centinela válido. El precio es que ese
constructor reserva memoria, puede lanzar std::bad_alloc y por lo tanto no puede ser noexcept.
En C++. Recuerden
std::move_if_noexceptde la semana 4: al crecer, unstd::vectormueve sus elementos solo si el movimiento no puede lanzar, y si no, los copia. Así que unstd::vector<LinkedDeque<int>>copia todos los nodos de cada lista cada vez que crece. Se puede comprobar comparando la dirección de un elemento antes y después. Constd::is_nothrow_move_constructible_v, en elg++del curso,std::list<int>da verdadero (guarda su centinela dentro del objeto) ystd::deque<int>da falso.
Comprobar el invariante
Este programa se equivoca en una sola línea: al insertar, olvida actualizar el prev del nodo siguiente.
void push_front(int value) {
    Node* first = sentinel_->next;
    Node* node = new Node{value, sentinel_, first};
    sentinel_->next = node;
    // falta: first->prev = node;
}
Recorrer hacia adelante sigue dando el resultado correcto, así que una prueba que solo imprima no lo descubre.
ASan tampoco, porque no hay ningún acceso inválido. check_invariants sí:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/forgot_prev.cpp -o build/forgot_prev
$ build/forgot_prev
1 2
forgot_prev: errors/forgot_prev.cpp:48: void BrokenList::check_invariants() const: Assertion `node->prev->next == node' failed.
Es un bug que recién se manifestaría más tarde, en otra operación y lejos de la línea culpable: un pop_back o un
erase que usan prev dejarían la lista rota. Por eso los invariantes de una estructura enlazada se comprueban en
las pruebas después de cada grupo de operaciones.
Iteradores
Con la lista doble, ¿cómo le damos al usuario una forma de recorrerla? No podemos darle operator[] y un ciclo con
índice, porque ya vimos que eso cuesta Θ(n²). Tampoco podemos darle Node*: Node es un detalle privado, y exponerlo
permitiría romper el ciclo desde afuera.
Definición. Un iterador (iterator) es un objeto que señala una posición dentro de un contenedor y sabe avanzar a la siguiente. La posición que sigue a la última se llama fin, y no contiene un elemento: no se puede leer.
Es la generalización de lo que ya hacían en C con un puntero que recorre un arreglo:
| En C, con un puntero | Con un iterador | Qué hace |
|---|---|---|
int *p = array |
auto it = list.begin() |
Señala el primero |
array + n |
list.end() |
Señala el fin, uno después del último |
*p |
*it |
Da el elemento |
p++ |
++it |
Avanza |
p != array + n |
it != list.end() |
Pregunta si llegó al fin |
La tabla oculta una diferencia. En el arreglo, avanzar es sumar. En la lista es seguir un puntero. El código que recorre es el mismo, y lo que hace cada operador depende del contenedor.
En nuestra lista, el iterador es un wrapper de un Node*, y el centinela es exactamente la posición de fin:
end() lo señala, y como el next del último elemento es el centinela, avanzar desde el último llega al fin solo.
template <typename V>
class Iter {
public:
    V& operator*() const { return node_->value; }
    Iter& operator++() {
        node_ = node_->next;
        return *this;
    }
    Iter& operator--() {
        node_ = node_->prev;
        return *this;
    }
    bool operator==(const Iter& other) const { return node_ == other.node_; }
    bool operator!=(const Iter& other) const { return node_ != other.node_; }

private:
    friend class DList;
    explicit Iter(Node* node) : node_(node) {}
    Node* node_;
};

using iterator = Iter<T>;
using const_iterator = Iter<const T>;
Algunos detalles:
operator++es el preincremento, y devuelve el propio iterador por referencia. Elforpor rango solo usa esta forma. El posincrementoit++se declara con unintde mentira y no lo escribimos.VesToconst T. Es un template dentro de un template, y evita escribir dos clases casi iguales. Coniterator,*itda unT&y se puede escribir el elemento. Conconst_iterator, da unconst T&.- El constructor es privado, y
friend class DListle permite usarlo solo a la lista. Quien use la clase no puede fabricar un iterador a partir de unNode*.
La lista necesita begin y end en dos versiones, para que también se pueda recorrer una lista const:
iterator begin() { return iterator(sentinel_->next); }
iterator end() { return iterator(sentinel_); }
const_iterator begin() const { return const_iterator(sentinel_->next); }
const_iterator end() const { return const_iterator(sentinel_); }
En C++. Desde C++20, si una clase define
operator==, el compilador acepta tambiéna != by lo reescribe como!(a == b). Nosotros definimos los dos para que quede a la vista lo que elforusa. En C++17 el mismo código sinoperator!=da un error de compilación.
Qué hace realmente un for por rango
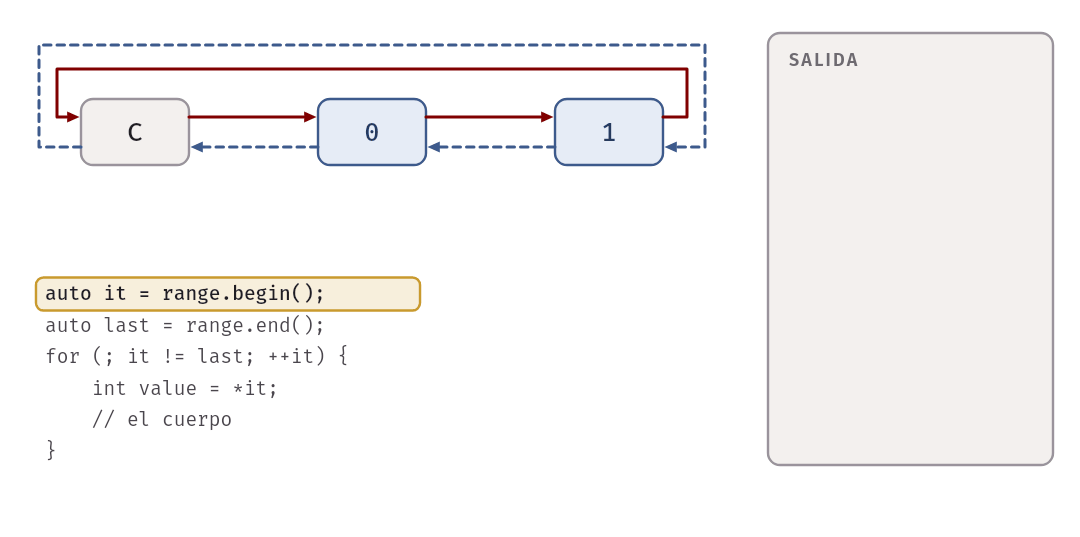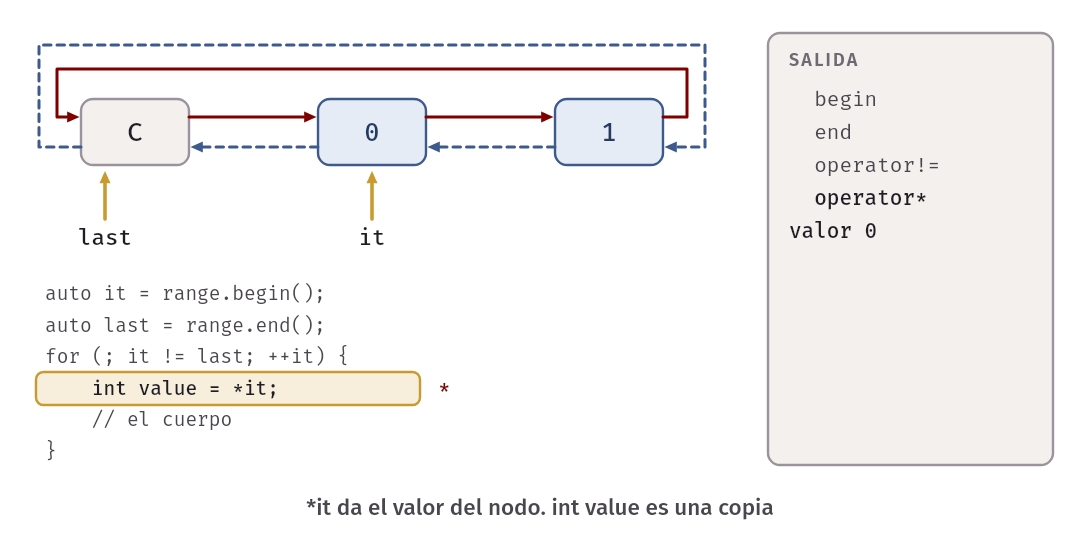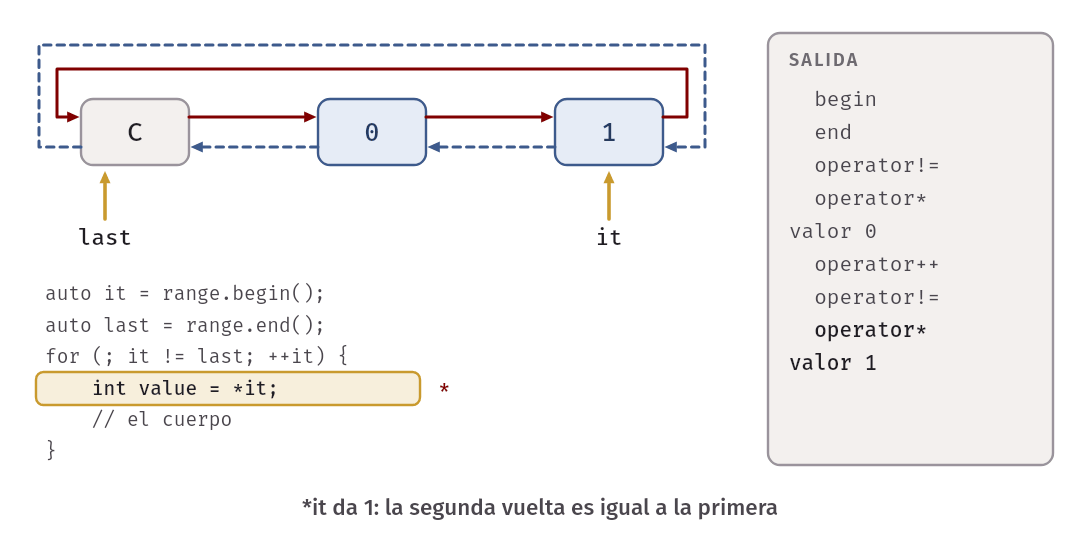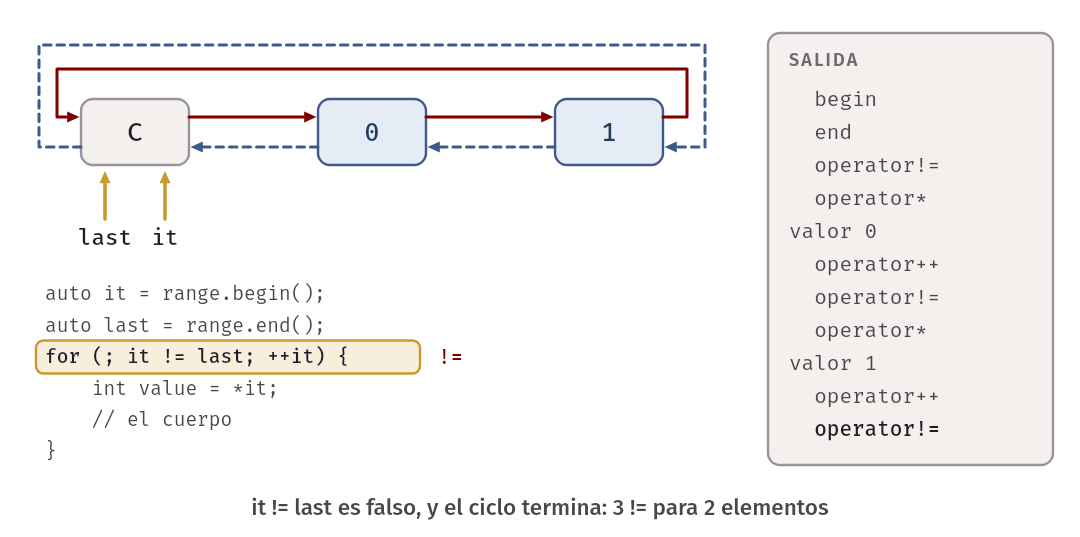
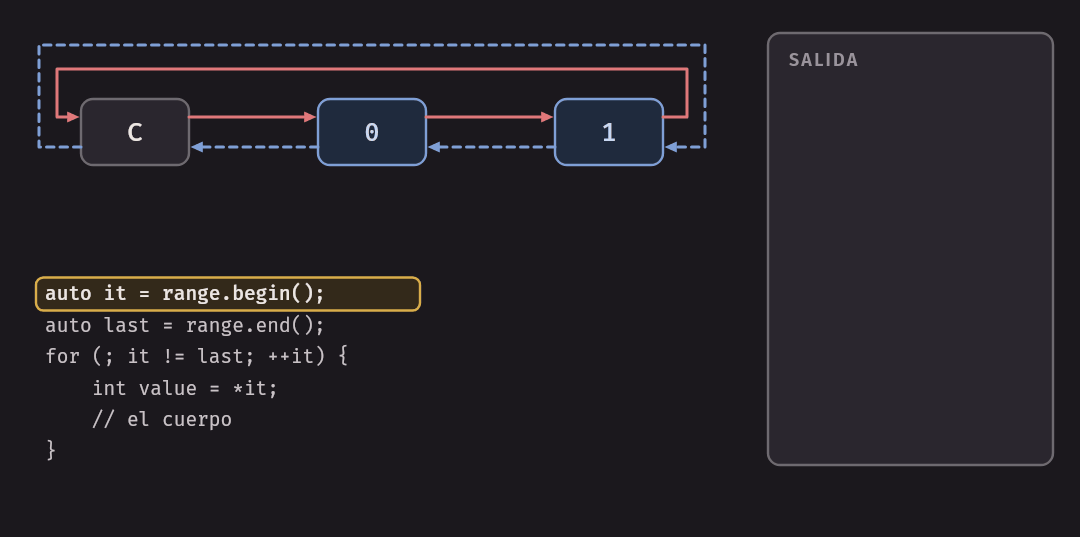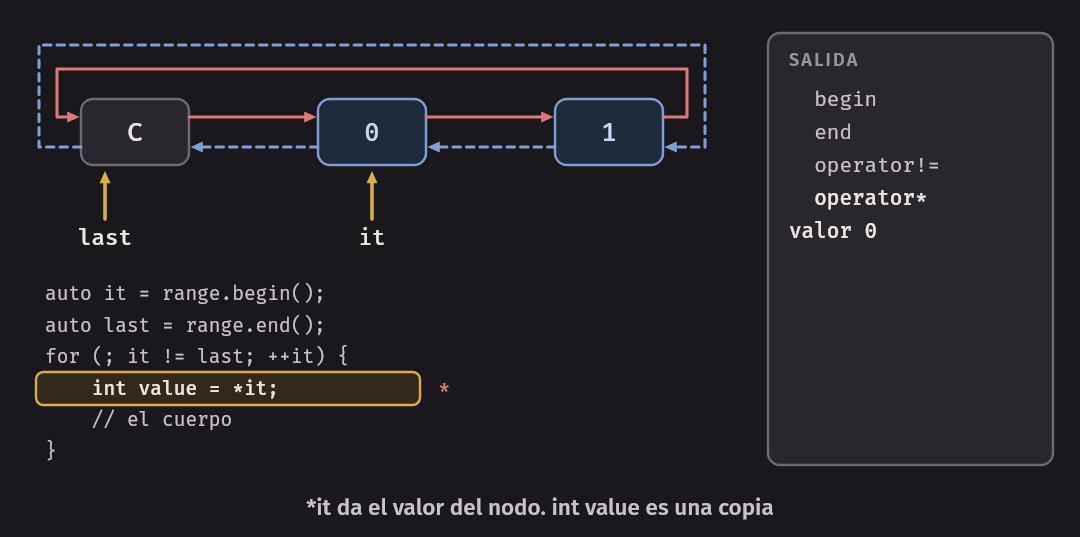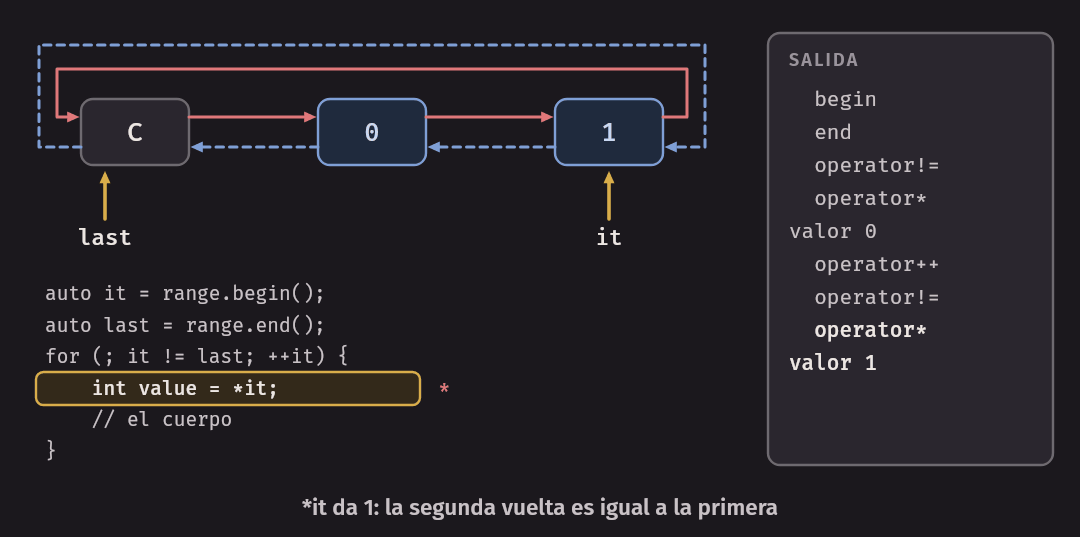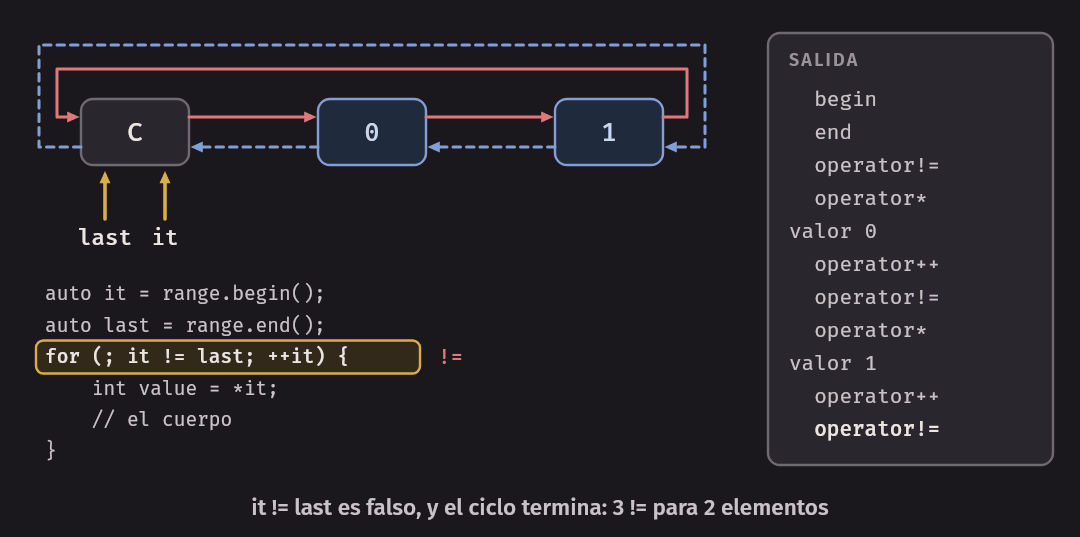
Un for por rango no es magia, es una abreviatura. Para for (int value : list) { ... }, el compilador escribe
aproximadamente esto (la forma exacta está en el estándar, con nombres internos):
auto&& range = list;
auto it = range.begin();
auto last = range.end();
for (; it != last; ++it) {
    int value = *it;
    // el cuerpo
}
De ahí salen tres reglas que conviene saber de memoria:
- Sirve para cualquier clase con
beginyend, y un iterador con*,++y!=. No hay que heredar de nada. end()se llama una sola vez, antes del primer ciclo. Si el cuerpo cambia dónde está el fin, elforno se entera.int value = *ites una copia. Para modificar el elemento se escribeint& value, y para evitar la copia de un tipo caro,const T& value.
Podemos verlo en vez de creerlo. trace_range.cpp define un rango cuyo iterador imprime cada llamada que recibe, y lo
recorre primero con un for por rango y después con el ciclo equivalente escrito a mano:
$ build/trace_range
for por rango:
  begin
  end
  operator!=
  operator*
valor 0
  operator++
  operator!=
  operator*
valor 1
  operator++
  operator!=
ciclo equivalente:
  begin
  end
  operator!=
  operator*
valor 0
  operator++
  operator!=
  operator*
valor 1
  operator++
  operator!=
Las dos partes de la salida son idénticas. Para dos elementos hay tres !=: la última pregunta es la que termina el
ciclo.
En la biblioteca. Nuestro iterador alcanza para el
forpor rango y parastd::accumulate, pero no parastd::find: en elg++del curso,std::findda un error de compilación porque le pide al iterador que declare su categoría (iterator_category). Los iteradores de la biblioteca declaran esos tipos además de los operadores. Aquí no nos hacen falta.
Borrar mientras se recorre
erase devuelve un iterador al elemento siguiente, y hay una buena razón. Después de borrar, el iterador que se le
pasó señala un nodo liberado, y avanzarlo es exactamente el error de antes, leer next de un nodo borrado. La forma
correcta de borrar mientras se recorre usa el valor que devuelve:
auto it = list.begin();
while (it != list.end()) {
    if (*it % 2 == 0) {
        it = list.erase(it);
    } else {
        ++it;
    }
}
$ build/erase_evens
1 3 5 7 Un for por rango no se puede usar para eso, porque el ++ oculto siempre se ejecuta, y siempre sobre el iterador
que ya no sirve.
Error común. Borrar el elemento actual dentro de un
forpor rango:
auto it = list.begin();
for (int value : list) {
    if (value == 1) {
        list.erase(it);  // el ++ oculto del for lee el next del nodo borrado
    }
}
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/erase_in_range_for.cpp -o build/erase_in_range_for
$ build/erase_in_range_for
READ of size 8 at 0x503000000080 thread T0
#0 0xaaaaab114bc8 in DList<int>::Iter<int>::operator++() errors/../dlist.h:32
#1 0xaaaaab113da4 in main errors/erase_in_range_for.cpp:10
...
freed by thread T0 here:
...
#1 0xaaaaab115114 in DList<int>::erase(DList<int>::Iter<int>) errors/../dlist.h:97
#2 0xaaaaab113d9c in main errors/erase_in_range_for.cpp:12El informe es una buena lección de lectura: la línea 10 de main es la del for. No hay ningún ++ escrito ahí, y
sin embargo ASan dice que ahí se llamó a operator++. Es el ciclo oculto.
Cuándo se invalida un iterador
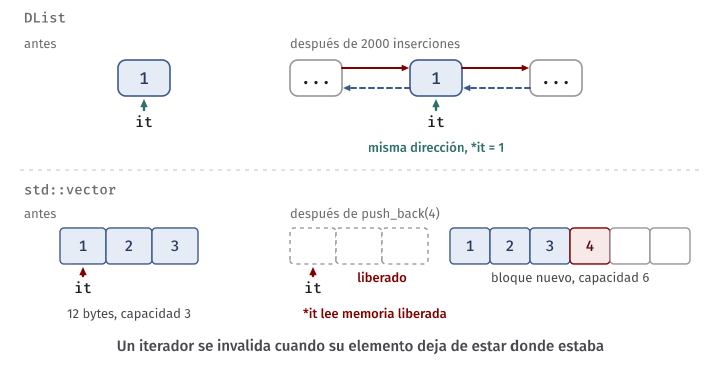
Un iterador está invalidado cuando ya no se puede usar: desreferenciarlo o avanzarlo es comportamiento indefinido.
Si señalaba un elemento, un puntero o una referencia a ese elemento pueden invalidarse por la misma razón. En arreglos
dinámicos y listas, una buena guía sale de lo que hay debajo: un iterador a un elemento se invalida cuando ese elemento
deja de estar donde estaba. No es una regla general, porque cada contenedor define la suya: end() en un std::vector
se invalida sin que nada se mueva, y en std::deque también hay casos así, como veremos.
En una lista, los nodos no se mueven nunca. Insertar crea un nodo y toca los punteros de sus vecinos, pero ningún elemento cambia de lugar. Borrar solo destruye el nodo borrado. En un arreglo dinámico, en cambio, crecer traslada todos los elementos a otro bloque.
| Operación | DList y std::list |
std::vector |
|---|---|---|
| Insertar | Ninguno se invalida | Si crece: todos. Si no crece: los de ese punto en adelante, y end() |
| Borrar | Solo los del elemento borrado | Los de ese punto en adelante, y end() |
Lo comprobamos sin cometer el error. invalidation.cpp guarda las direcciones como números y las compara, sin usar en
ningún momento un puntero inválido:
$ build/invalidation
lista: el elemento sigue en la misma dirección: sí
lista: *it = 1, *in_list = 1
vector sin reserve: el bloque cambió de lugar 10 veces
vector con reserve: siguió en la misma dirección: sí
Un elemento de la lista sobrevive a 2000 inserciones, en su misma dirección. El std::vector que empezó con capacidad
1 y creció hasta 1001 elementos cambió de lugar 10 veces, y con reserve no cambió. Las 10 veces dependen de la política
de crecimiento de la biblioteca, en este caso duplicar.
Y esto es lo que pasa si se usa el iterador después de que el vector creció. Es el error común de la semana 4, ahora con un iterador:
std::vector<int> values = {1, 2, 3};
auto it = values.begin();
values.push_back(4);  // la capacidad era 3: el bloque cambia de lugar
std::cout << *it << "\n";
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/stale_vector_iterator.cpp -o build/stale_vector_iterator
$ build/stale_vector_iterator
READ of size 4 at 0x502000000010 thread T0
#0 0xaaaae57a9a58 in main errors/stale_vector_iterator.cpp:9
...
0x502000000010 is located 0 bytes inside of 12-byte region [0x502000000010,0x50200000001c)El bloque de 12 bytes son los tres int originales.
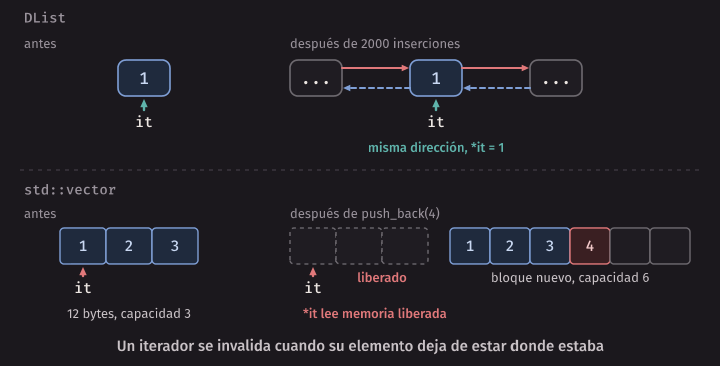
Idea clave. La estabilidad es la propiedad más subestimada de la lista enlazada. Si otra parte del programa guarda punteros a los elementos, una lista se los conserva. Es una razón mucho mejor para elegir una lista que “insertar es O(1)”.
En la biblioteca.
std::dequees un caso intermedio, y es de los pocos que conviene mirar en la referencia: insertar en un extremo invalida todos los iteradores, pero no los punteros ni las referencias a los elementos.
El tipo abstracto deque
Un deque (double-ended queue, cola de dos extremos, se pronuncia “dek”) es un tipo abstracto de datos, una secuencia que se puede modificar por los dos extremos. Como en la semana 2, el tipo abstracto dice qué hacen las operaciones, y no cómo.
| Operación | Efecto | Precondición |
|---|---|---|
push_front(x) |
x pasa a ser el primero | |
push_back(x) |
x pasa a ser el último | |
pop_front() |
Saca el primero | No está vacío |
pop_back() |
Saca el último | No está vacío |
front() y back() |
Devuelven el primero y el último | No está vacío |
size() y empty() |
Tamaño, y si está vacío |
Sus dos casos particulares ya los conocen. Una pila es un deque que solo usa un extremo: push_back y pop_back,
el último en entrar es el primero en salir. Una cola usa un extremo para entrar y el otro para salir: push_back y
pop_front, el primero en entrar es el primero en salir. Quien tiene un deque tiene las dos.
Una interfaz sin clase base
Vamos a tener dos implementaciones del deque, y queremos correr las mismas pruebas en las dos. En otros lenguajes, y más adelante en otros cursos, eso se suele hacer declarando una clase base. Aquí no hace falta, porque tenemos templates: una función template compila con cualquier tipo que tenga las operaciones que ella usa.
template <typename D>
void test_both_ends() {
    D deque;
    assert(deque.empty());
    deque.push_back(2);
    deque.push_back(3);
    deque.push_front(1);
    assert(deque.size() == 3);
    assert(deque.front() == 1);
    assert(deque.back() == 3);
Esa prueba no sabe nada de nodos ni de buffers. La misma función, instanciada con tres tipos que no tienen ninguna relación entre sí, comprueba los tres:
test_both_ends<DList<int>>();
test_both_ends<std::list<int>>();
test_both_ends<std::deque<int>>();
$ build/same_interface
DList: ok
std::list: ok
std::deque: okLa interfaz común no está escrita en una declaración de C++: es el conjunto de operaciones que usan las pruebas, y se
escribe en la documentación. Si a un tipo le falta una operación, el template no compila, y el error lo da el compilador.
Las pruebas del laboratorio, en lab/tests/deque_suite.h, funcionan así.
Idea clave. Las pruebas son del tipo abstracto, no de la representación. Si una prueba solo pasa con una de las dos representaciones, está probando un detalle interno, y ese es un dato sobre la prueba.
Dos representaciones con el mismo O(1)
El deque sobre un buffer circular
La semana pasada vieron la cola sobre un buffer circular: un arreglo de capacidad c, un índice front y un tamaño, donde
el elemento i está en la casilla (front + i) mod c. Para tener un deque solo falta una operación más: insertar por delante,
retrocediendo front una casilla y dando la vuelta si estaba en 0.
algoritmo push_front(deque, x)
    si deque.tamaño = deque.capacidad entonces
        crecer(deque)
    fin si
    deque.frente ← (deque.frente - 1 + deque.capacidad) mod deque.capacidad
    deque.datos[deque.frente] ← x
    deque.tamaño ← deque.tamaño + 1
fin algoritmo
El + capacidad no es un adorno. Sin él, con frente en 0, la resta da −1, y escribirla así en C++ no da la casilla
correcta en general: con std::size_t da la vuelta a 2⁶⁴ − 1, y el resultado solo sale bien, por casualidad, si la capacidad
es potencia de 2. Con un int, -1 % 4 da −1, no 3.
Sigamos un ejemplo que parte de capacidad 4. Las casillas libres se marcan con un punto.
| Operación | Casillas | front |
Tamaño | Capacidad |
|---|---|---|---|---|
push_back(a) |
a . . . |
0 | 1 | 4 |
push_back(b) |
a b . . |
0 | 2 | 4 |
push_back(c) |
a b c . |
0 | 3 | 4 |
pop_front() |
. b c . |
1 | 2 | 4 |
push_back(d) |
. b c d |
1 | 3 | 4 |
push_back(e) |
e b c d |
1 | 4 | 4 |
push_front(z), primero crece |
b c d e . . . . |
0 | 4 | 8 |
push_front(z), después inserta |
b c d e . . . z |
7 | 5 | 8 |
Tres momentos para mirar con cuidado:
push_back(e)da la vuelta. (1 + 3) mod 4 = 0, así queeva a la casilla 0 y el arreglo queda lleno, aunqueesea el último elemento y esté en la primera casilla.- Crecer desenrolla. No basta copiar las casillas tal como están en el mismo orden: la casilla 0 del buffer viejo tiene
e, que es el último. Se copia en orden lógico, del elemento 0 altamaño - 1, y el frente vuelve a 0. push_front(z)retrocede al final. (0 − 1 + 8) mod 8 = 7. Ahora el elemento 0 esz, en la casilla 7, y el elemento 1 esb, en la casilla (7 + 1) mod 8 = 0.
Con T general, dos decisiones quedan a la vista. En primer lugar, este diseño reserva con new T[capacidad], así que T
necesita constructor por defecto, y las casillas sin elemento también contienen un T. Eso significa que un pop no destruye
nada: si no se hace algo más, el valor se queda en la casilla. Con un std::string largo o un std::shared_ptr, el recurso
sigue retenido por un elemento que ya no existe. Por eso la casilla que queda libre se reemplaza por un T{}. La alternativa
sin esa restricción sobre T es reservar memoria sin construir, y construir y destruir cada elemento a mano. std::vector y
std::deque lo hacen así, pero aquí no.
En segundo lugar, push_back(const T&) tiene una trampa, que las pruebas del laboratorio revisan:
Error común. Si el argumento es una referencia a un elemento del mismo deque, como en
deque.push_back(deque.front()), y el buffer tiene que crecer,growlibera el bloque donde vive el argumento. Luego se lee una referencia colgante. Hay que sacar la copia antes de crecer.
El deque sobre una lista doble
Esta ya está hecha: DList tiene todas las operaciones del deque. Cada una es O(1) si contamos new y delete como una
operación, y siempre, no solo amortizado: nunca hay que trasladar nada.
Las dos representaciones, lado a lado
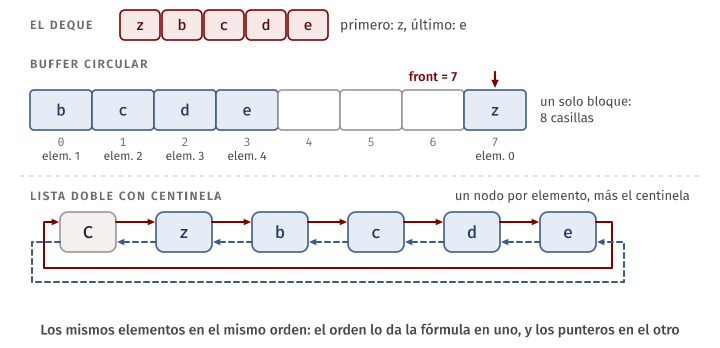
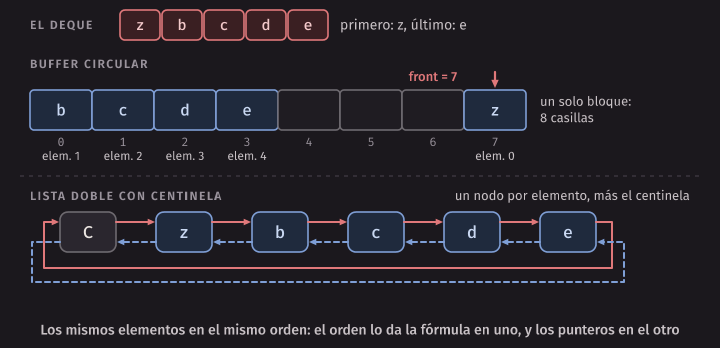
| Operación | Buffer circular | Lista doble con centinela |
|---|---|---|
push_front, push_back |
O(1) amortizado, Θ(n) la que crece | O(1) |
pop_front, pop_back |
O(1) | O(1) |
front, back |
O(1) | O(1) |
| Elemento i | O(1) | Θ(min(i, n − i)), desde el extremo más cercano |
| Recorrer todo | Θ(n) | Θ(n) |
| Insertar en el medio, con un iterador | Θ(n) | O(1) |
| Elementos que no se mueven | No: crecer los traslada | Sí, hasta que se borren |
Bytes por int en nuestro entorno |
Entre 4 y 8 mientras crece duplicando; más si se vacía, porque no encoge | 32, más un centinela |
Si solo nos quedamos con la notación O, las operaciones del deque se ven iguales, y no habría cómo elegir. Vamos a medir.
Lo que O no ve
La notación O dice cómo crece el costo con n, y deliberadamente ignora las constantes. Eso es lo que la hace útil, y también es su límite: dos programas Θ(n) pueden diferir por un factor de cien, y O no tiene forma de decirlo. Veamos dos cosas que quedan fuera: las reservas de memoria y la cache.
Cómo se midió
Todas las mediciones de esta sección se hicieron en el entorno del curso, en un contenedor Linux sobre una laptop con
procesador Apple (aarch64), con otros procesos corriendo a la vez. Se compilaron con g++ -O2, sin sanitizers, con el
medidor de la semana 3 (bench.h): cada tiempo es la mediana de varias repeticiones. Corrimos cada programa tres veces
y comparamos.
Los tiempos absolutos son de esta máquina y en la suya serán otros. Lo que se puede defender son las razones entre columnas que se repiten en las tres corridas, y solo sacaremos conclusiones de esas.
Reservas de memoria
Primero un conteo, que no depende del reloj. alloc_count.cpp reemplaza el operator new global por uno que cuenta sus
llamadas, e inserta un millón de enteros.
$ build/alloc_count
reservas para 1000000 push_back
std::vector: 21
std::deque:  7825
std::list:   1000000
DList:       1000001
std::vector reserva 21 veces porque duplica su capacidad. DList reserva una vez por elemento, más el centinela. Hay un
factor de casi 50 000 en la cantidad de llamadas a new, y la tabla de costos de O no refleja ninguno de esos factores. En el
medio queda std::deque, que en la implementación de g++ guarda los elementos en bloques de tamaño fijo. Estos conteos son
de la biblioteca del curso. El estándar no los fija.
¿Se nota en el tiempo? ends_bench.cpp hace n push_back seguidos de n pop_back, y da nanosegundos por operación.
$ build/ends_bench
       n std::vector    DList  razón
   10000       0.44     6.65   15.3
  100000       0.43     6.95   16.2
 1000000       0.41     7.55   18.2
Las tres corridas dieron razones entre 15.2 y 15.4 para n = 10 000, entre 16.0 y 16.2 para n = 100 000, y entre 16.8 y 18.2
para n = 1 000 000. La columna de la lista casi no cambia con n, como corresponde a O(1). Lo mismo la del std::vector. La
diferencia es un factor constante, cercano a 16.
Esta medición dice cuánto más cuesta, pero no separa las causas. La reserva y la liberación de cada nodo son la diferencia más visible, pero también hay más memoria que escribir. Lo honesto es decir que el conteo de reservas es consistente con el resultado, no que lo explica por completo.
Una hipótesis sobre la cache
Antes de medir el recorrido necesitamos una idea de cómo funciona la memoria. Leer de la RAM es lento comparado con lo que hace la CPU en ese mismo tiempo. Por eso la CPU tiene una cache, una memoria mucho más pequeña y rápida donde guarda lo último que leyó, normalmente en varios niveles: un nivel 1 muy pequeño y muy rápido, y un nivel 2, más grande y algo más lento.
La cache no trabaja de a un byte. Al leer un byte que no está, trae una línea completa, un bloque de bytes vecinos de tamaño fijo. Por eso importa la localidad (locality) de un programa, que tiene dos formas:
- Localidad espacial: si leen una dirección, probablemente leerán las vecinas enseguida. La línea ya las trajo.
- Localidad temporal: si leen algo, probablemente volverán a leerlo pronto. Sigue en la cache.
Además, muchos procesadores detectan que un programa avanza con un paso regular, y traen las líneas siguientes antes de que se pidan. Eso se llama prebúsqueda (prefetching).
Con esto, un arreglo recorrido en orden es el mejor caso posible. Una lista cuyos nodos están seguidos se le parece, aunque ocupe más. Y una lista cuyos nodos están en orden aleatorio es el peor caso: cada salto puede caer en cualquier parte. Esta es una predicción, y podemos ponerla a prueba: si la cache es la causa, el efecto debería depender de cuánta memoria ocupa la estructura. Con pocos elementos, todo cabe en la cache y el orden no debería importar.
El experimento
Para aislar la localidad necesitamos dos recorridos con exactamente el mismo código y la misma cantidad de nodos, cuya
única diferencia sea dónde están en la memoria. Barajar directamente lo que devuelve new no está en nuestras manos, porque lo
decide la biblioteca. Pero hay algo equivalente: no movemos los nodos y los enlazamos en otro orden.
void shuffle_nodes(unsigned seed) {
    std::vector<Node*> nodes;
    nodes.reserve(size_);
    for (Node* node = sentinel_->next; node != sentinel_; node = node->next) {
        nodes.push_back(node);
    }
    std::mt19937 rng(seed);
    std::shuffle(nodes.begin(), nodes.end(), rng);
    Node* last = sentinel_;
    for (Node* node : nodes) {
        last->next = node;
        node->prev = last;
        last = node;
    }
    last->next = sentinel_;
    sentinel_->prev = last;
}
Después de esto, la lista tiene los mismos nodos, en las mismas direcciones, pero recorrerla salta sin orden. Es el orden que tendría una lista si sus nodos se hubieran reservado en orden aleatorio. Los elementos quedan en otro orden, lo que no cambia su suma.
traversal_bench.cpp mide, en nanosegundos por elemento, cuatro recorridos que suman n enteros:
- arreglo: un
std::vector<int>, en orden. - arr.baraj: el mismo arreglo, visitado según una permutación al azar de los índices. No hay nodos ni saltos de puntero.
- lista: una
DList<int>recién construida. - lis.baraj: la misma lista, después de
shuffle_nodes.
Los recorridos cortos se repiten para que cada medición toque al menos dos millones de elementos. La columna lis/arr es
lista entre arreglo, y lb/lista es lista barajada entre lista. Las columnas cont y cont.b son el porcentaje de saltos de
la lista que avanzan exactamente 32 bytes, antes y después de barajar. Es una forma de comprobar con un conteo que los nodos
están donde creemos. La última columna dice si la suma dio lo mismo en todas las representaciones.
$ build/traversal_bench
       n  arreglo arr.baraj    lista lis.baraj  lis/arr  lb/lista     cont   cont.b
    1024     0.37      0.37     1.11      1.11      3.0       1.0   100.0%     0.2% ok
    4096     0.36      0.36     1.20      1.16      3.4       1.0    99.7%     0.1% ok
   16384     0.35      0.40     1.58      8.80      4.5       5.6    99.9%     0.0% ok
   65536     0.36      0.71     1.73     12.78      4.7       7.4   100.0%     0.0% ok
  262144     0.36      0.96     1.69     17.97      4.7      10.6   100.0%     0.0% ok
 1048576     0.36      1.05     1.67     96.32      4.6      57.7   100.0%     0.0% ok
 4194304     0.36      1.04     1.69    158.50      4.7      93.8   100.0%     0.0% ok
Para no confiar en una corrida, estas son las razones de las tres. La memoria de la lista se calcula como 32 bytes por nodo.
| n | Memoria de la lista | lis/arr en las 3 corridas |
lb/lista en las 3 corridas |
|---|---|---|---|
| 1 024 | 32 KB | 3.0, 3.0, 3.0 | 1.0, 1.0, 1.0 |
| 4 096 | 128 KB | 3.4, 3.3, 3.3 | 1.0, 1.0, 1.0 |
| 16 384 | 512 KB | 4.5, 4.5, 4.4 | 5.6, 5.5, 5.7 |
| 65 536 | 2 MB | 4.7, 4.5, 4.6 | 7.4, 7.7, 7.8 |
| 262 144 | 8 MB | 4.7, 4.6, 4.6 | 10.6, 10.4, 9.6 |
| 1 048 576 | 32 MB | 4.6, 4.6, 4.7 | 57.7, 56.6, 54.4 |
| 4 194 304 | 128 MB | 4.7, 4.7, 4.7 | 93.8, 89.0, 91.4 |
Qué podemos afirmar, y qué no
Esto es lo que se repite en las tres corridas y por lo tanto se puede afirmar para esta máquina:
- Todos los recorridos son Θ(n) y ninguno es igual a otro. Con 4 millones de elementos, la lista barajada tarda más de 400 veces lo que el arreglo por elemento (158.50 / 0.36 en la corrida de arriba).
- Barajar no cambia nada con pocos elementos. Con n = 1 024 y n = 4 096,
lb/listaes 1.0 en las tres corridas, aunquecont.bmuestra que los nodos ya están desordenados. Saltar sin orden no es lento por sí mismo. - Barajar cuesta más a medida que la lista ocupa más memoria, con saltos claros: entre 128 KB y 512 KB, y otra vez entre 8 MB
y 32 MB. Nada cambió en el código entre filas, y
lb/listacompara el mismo código sobre los mismos nodos.
Eso es exactamente lo que predijo la hipótesis de la cache: sin efecto mientras todo cabe, y un efecto creciente cuando deja de caber. La máquina también coincide. El macOS de la laptop reporta para sus núcleos de rendimiento una cache de nivel 1 de 128 KB y una de nivel 2 de 16 MB, y los saltos ocurren al pasar esos tamaños.
Y esto es lo que no podemos afirmar con estos datos:
- No medimos fallos de cache. Medimos tiempo. Para contar fallos hacen falta los contadores del procesador, y este entorno no trae
perf, la herramienta habitual para leerlos. La cache es la explicación más probable porque predijo el resultado, no porque la hayamos observado. - La cache quizás no es la única causa. La traducción de direcciones virtuales también tiene su propia cache (el TLB), y un recorrido sin orden también la exige más. Con estas mediciones no se puede separar una de otra.
- Los números de la cache son orientativos. En el contenedor,
getconf LEVEL1_DCACHE_LINESIZEdice 64 bytes, mientras que el macOS de la misma laptop reporta líneas de 128. Además no sabemos en qué núcleo corrió cada medición, y estos procesadores tienen núcleos de distintos tamaños de cache. Por eso no citamos la coincidencia de tamaños como una demostración. - En otra máquina, los saltos estarán en otro lugar. Lo que debería repetirse es la forma: 1.0 con pocos elementos y mucho más que 1 con muchos.
Las otras dos columnas
La lista en orden también es más lenta que el arreglo, y la razón es de 3.0 con n = 1 024, cuando todo debería caber en la cache. Esa parte no parece venir de la cache. Tampoco se debe a que el compilador esté usando instrucciones vectoriales para el arreglo, como podría sospecharse. Se puede preguntar al compilador, y la línea 69 es la del ciclo del arreglo:
$ g++ -Wall -Wextra -std=c++20 -O2 -fopt-info-vec-missed traversal_bench.cpp -o /dev/null 2>&1 | grep 'cpp:69:'
traversal_bench.cpp:69:26: missed: couldn't vectorize loop
traversal_bench.cpp:69:26: missed: Loop costings not worthwhile.
Lo más probable es que el costo venga de la forma del ciclo. En la lista, la CPU no sabe dónde está el siguiente nodo hasta que termina
de leer el puntero, y por eso cada paso depende del anterior. La columna arr.baraj apoya esta lectura: con n = 1 024 también hace dos
lecturas por elemento, y va igual que el arreglo normal, 0.37 ns. Pero no lo medimos por separado, así que queda como una explicación
probable.
Al crecer n, lis/arr sube de 3.0 a alrededor de 4.6 y se queda ahí. La lista en orden ocupa ocho veces más memoria por elemento, y aun
así no se hunde como la barajada: su cont es prácticamente 100%, un paso regular, justo lo que la prebúsqueda y las líneas de cache
aprovechan.
arr.baraj es la columna más interesante para no sacar la conclusión equivocada. Sube de 0.37 a alrededor de 1.05 ns sin un solo puntero
entre elementos: lo que cuesta es el desorden en el acceso, no los punteros como tales. También sube mucho menos que la lista
barajada, lo que tiene al menos dos explicaciones posibles, que no separamos: el arreglo ocupa la octava parte (16 MB contra 128 MB
con el n mayor), y sabe el índice siguiente sin leer el elemento actual, de modo que la CPU puede adelantar lecturas.
Idea clave. Dos recorridos Θ(n) pueden diferir por un factor de cientos, con el mismo código, según dónde estén los datos. Por eso una lista recién construida puede dar una falsa impresión: en un programa que lleva horas reservando y liberando, nada garantiza que los nodos sigan en orden. O dice cómo crece el costo. La localidad ayuda a explicar cuánto vale cada paso.
Entonces, ¿para qué sirve una lista?
No hay que concluir que las listas son inútiles. Sirven cuando importa lo que el arreglo no puede dar:
- Referencias estables. Otros guardan punteros a los elementos, y estos no deben moverse.
- Insertar o borrar en un punto que ya tienen, sin trasladar los demás. Por ejemplo, sacar un elemento de una cola de la que se tiene su iterador.
- Costo por operación sin picos. Una inserción en un arreglo dinámico puede costar Θ(n), aunque su costo amortizado sea O(1). Si
newno molesta, en la lista nunca pasa eso.
Si lo único que necesitan es una secuencia que se recorre y crece en un extremo, empiecen por un arreglo, y midan.
En la biblioteca.
std::vectores arreglo dinámico.std::listes lista doble.std::dequetiene la interfaz de nuestro deque y tambiénoperator[]en O(1), pero su representación son bloques de tamaño fijo, no un buffer circular único. Es lo que muestra el conteo de 7825 reservas.
El código de la semana
En code/week-05:
| Archivo | Qué contiene |
|---|---|
slist.h, slist_demo.cpp |
Lista simple con head_ y tail_ |
dlist.h, dlist_demo.cpp |
Lista doble con centinela e iterador |
node_addresses.cpp |
Dónde quedan los elementos en la memoria |
trace_range.cpp |
Las llamadas que hace un for por rango |
erase_evens.cpp |
Borrar mientras se recorre |
invalidation.cpp |
Qué sobrevive a una inserción |
same_interface.cpp |
Una prueba, varias representaciones, sin clase base |
alloc_count.cpp, alloc_counter.h |
Contar llamadas a operator new |
traversal_bench.cpp, ends_bench.cpp, bench.h |
Mediciones, con -O2 y sin sanitizers |
test_structures.cpp, tracked.h |
Pruebas de las listas: casos dirigidos y al azar, contra std::list |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo. Eso incluye volver a correr los comandos de este capítulo: si un ejemplo dejara de dar lo que
dice el texto, la prueba falla. Las mediciones no se comparan, porque dependen de la máquina. Lo que sí revisan las pruebas son los conteos,
como las reservas de memoria y qué porcentaje de nodos está seguido, porque esos sí deben repetirse.
El laboratorio
Escribirán ArrayDeque<T> en la sesión 1 y LinkedDeque<T> en la sesión 2, en lab/array_deque.h y lab/linked_deque.h. Cada método sin
hacer detiene el programa con un mensaje que dice cuál falta.
make test-array     # solo ArrayDeque
make test-linked    # solo LinkedDeque
make test-lab       # los dos
make bench          # la tabla para su conclusión, con -O2 y sin sanitizers
Algunas cosas que conviene saber antes de empezar:
- Las pruebas son las mismas para las dos. Salvo cuatro de cada lado, sobre detalles de cada representación, como la capacidad o las reservas.
Incluyen copias contadas con un tipo instrumentado, y operaciones al azar con semilla fija contra
std::deque. - Corren con ASan y UBSan. Una fuga hace fallar la prueba, aunque el resultado sea correcto.
- El origen de un movimiento queda vacío y se puede seguir usando. Es un contrato que elegimos nosotros y que las pruebas revisan. Recuerden que
para los tipos de la biblioteca el estado del origen solo es válido pero no especificado. En un buffer con capacidad 0, cuidado con
% 0. shuffle_nodesse escribe igual que enDList. Las mediciones la usan; es lo que permite repetir el experimento de este capítulo con sus deques.
Al final, lab/conclusion.md les pide responder con sus propios números: las dos son O(1) en los extremos y Θ(n) al recorrer, ¿por qué los tiempos no
son iguales? Digan qué midieron y qué supusieron, igual que en este capítulo.
Resumen
- Una lista enlazada une nodos con punteros. El orden de la lista es independiente del orden en la memoria.
- En una lista simple, insertar y sacar al inicio cuesta O(1), y llegar al elemento i cuesta Θ(i). Sacar del final cuesta Θ(n), aun con
tail_. - Una lista doble puede sacar cualquier nodo conocido en O(1). Con un nodo centinela en un ciclo, todo nodo tiene anterior y siguiente, y los casos especiales desaparecen. Al sacar un nodo cambian exactamente dos punteros.
- La lista es owner de todos sus nodos, incluido el centinela. Hay que leer
nextantes de borrar. - Un iterador señala una posición y sabe avanzar. Un
forpor rango es una abreviatura debegin,end,!=,*y++, yendse llama una sola vez. - En una lista, solo se invalidan los iteradores del elemento borrado. En un
std::vector, crecer los invalida todos. - Un deque inserta y saca por los dos extremos. Pilas y colas son casos particulares. Se puede probar con templates, sin clase base.
- El buffer circular y la lista doble tienen el mismo O(1) en los extremos y el mismo Θ(n) al recorrer. En esta máquina, los extremos de la lista costaron unas 16 veces más que los del arreglo, con un conteo de reservas que apunta a una causa.
- Barajar los nodos de la lista no cambió nada con pocos elementos, y multiplicó el tiempo por decenas con muchos, con el mismo código. Es lo que predice la localidad, aunque el tiempo no sea una medición directa de fallos de cache.
Ejercicios
- Dibujen una lista doble con centinela y tres elementos A, B y C. Escriban la tabla de
prevynext. ¿Qué punteros cambian al sacar B? ¿Y al sacar C? - Escriban el orden en que hay que asignar los punteros para insertar un nodo después de otro en una lista simple. Muestren con un dibujo qué se pierde si se hace en el orden inverso.
- ¿Qué cuesta cada operación? Justifiquen en una línea:
pop_backenSinglyList,v.insert(v.begin(), x)enstd::vector,eraseenDListcon un iterador, buscar un valor enDList, elemento 500 en unaDListde 1000 elementos si se parte del extremo más cercano. - Sobre
DList, escribanreverse(), que invierte la lista en Θ(n) sin reservar memoria y sin mover ningún valor. Ayuda: en cada nodo, incluido el centinela, se intercambian dos punteros. Compruébenla concheck_invariants. - Agreguen a
DList::Iterel posincremento,Iter operator++(int). ¿Por qué devuelve una copia y no una referencia? Conviertan un ciclo para que lo use. - ¿Cuáles de estos programas tienen un error? Para cada uno digan por qué, y comprueben con ASan.
a)
for (int x : v) { v.push_back(x); }con unstd::vectorno vacío. b) Lo mismo con unaDListno vacía, que no termina nunca: córtenla conCtrl+C. c)auto it = v.begin(); v.reserve(v.capacity() * 2 + 1); *it = 0;con unstd::vectorno vacío. d)auto it = l.begin(); l.push_front(1); *it = 0;con unaDListno vacía. - Sigan a mano un buffer circular de capacidad 4:
push_front(a),push_front(b),push_back(c),pop_back(),push_back(d),push_back(e),push_back(f). Hagan la tabla de casillas,front, tamaño y capacidad. - Con
alloc_counter.h, cuenten cuántas reservas hace unstd::vector<int>en esta máquina si antes llaman areserve(n). Expliquen por qué el conteo es exacto y no un tiempo que varía. - Cambien
traversal_bench.cpppara que el elemento sea unstructde 64 bytes y no unint, en el arreglo y en la lista. Antes de correrlo, predigan qué pasa conlis/arry por qué. Corran tres veces, y digan si la predicción se cumplió. - ¿La columna
lb/listasigue en 1.0 hasta el mismo n en su propia laptop? Corranbuild/traversal_benchtres veces, busquen en la documentación de su procesador los tamaños de su cache, y digan si coinciden con los saltos. Escriban también qué no podrían afirmar solo con esos datos. - Una lista de nodos se puede reservar toda de una vez en un bloque (un arreglo de nodos con punteros como enlaces). Escriban un
DListque reserve así y comparen sus reservas y sulis.barajcon la original. ¿Qué propiedad de las listas se conserva y cuál se pierde cuando el bloque tiene que crecer? - El
ArrayDequedel laboratorio nunca encoge. Agreguen la regla de la semana 4: reducir a la mitad al llegar a un cuarto de la capacidad. Escriban una prueba que cuente reservas y demuestre que alternarpush_backypop_backen el borde ya no reserva todo el tiempo. ¿Sigue siendo O(1) amortizado?