Apuntes · Capítulo 6Secuencias y ordenamiento
Ordenamiento y búsqueda binaria
Ordenamiento y búsqueda binaria
La semana pasada terminamos con una pregunta sobre el reloj: dos estructuras con el mismo O(1) podían diferir por un factor enorme. Hoy cambiamos de problema, y vamos a seguir mirando dos números a la vez: cuánto cuenta el análisis y cuánto mide el reloj.
El problema es el que resuelve cualquier buscador cuando ustedes empiezan a escribir. Tienen 28 039 palabras con
su frecuencia. El usuario escribe ca, y el programa debe proponer las cinco palabras más frecuentes que empiezan
así, antes de que termine de presionar la tecla. Se puede revisar todo el archivo en cada consulta. También se puede
pagar una vez por ordenar el archivo, y después encontrar a los candidatos de cada consulta leyendo unas 30 palabras.
Esa es la idea de la semana: ordenar es una inversión. Ordenar cuesta Θ(n log n), y deja los datos de modo que cada búsqueda cueste Θ(log n). Para llegar ahí veremos dos algoritmos de ordenamiento que se usan de verdad, mergesort y quicksort, con sus virtudes y sus trampas. Veremos también por qué ningún ordenamiento por comparación puede ser más rápido que Θ(n log n), qué ofrece la biblioteca estándar, y cómo escribir una búsqueda binaria que funcione a la primera. Eso se logra con una invariante, no con suerte.
También hay una trampa que no está en los libros en inglés. Nuestras palabras están en UTF-8, y std::string
compara bytes. En ese orden, árbol va después de zorro, y cámara no empieza con ca. Lo vamos a medir y a decir
tal cual.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Qué significa ordenar y Mergesort.
- En clase: Quicksort, Pivote al azar, Muchos elementos repetidos, Estabilidad, La cota Ω(n log n), Qué usan las bibliotecas y Búsqueda binaria con invariante.
- Después de clase: repasen con el Resumen y los Ejercicios, y lean Bytes, UTF-8 y orden y El código de la semana. Opcional: Open Data Structures, secs. 11.1.1 (Merge-Sort), 11.1.2 (Quicksort) y 11.1.4 (A Lower-Bound for Comparison-Based Sorting); CLRS, capítulo Quicksort.
Código. Los programas de este capítulo están en
code/week-06. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso. Los datos están endata/, y su origen y sus límites se explican endata/README.md.
Qué significa ordenar
Definición. Dado un arreglo a[0], …, a[n − 1] y una relación “va antes que”, ordenar (sorting) es reacomodar sus elementos de modo que para ningún i ocurra que a[i + 1] va antes que a[i].
Fíjense en dos detalles. El resultado es una permutación del original: no se pierde ni se inventa nada. Y la condición se escribe “a[i + 1] no va antes que a[i]” para admitir elementos equivalentes, como dos personas con la misma nota.
Los algoritmos de esta semana son por comparación: lo único que hacen con los datos es preguntar “¿a va antes que b?”. Eso los hace generales, porque sirven para enteros, cadenas o registros con solo cambiar la pregunta. También les pone un límite, que veremos más adelante.
El ordenamiento que a cualquiera se le ocurre primero es el de inserción: tomar cada elemento y ponerlo en su lugar entre los anteriores, que ya están ordenados, como quien acomoda cartas en la mano. Con una entrada al revés, cada elemento se compara con todos los anteriores, y son 0 + 1 + … + (n − 1) comparaciones, o sea Θ(n²). Duplicar los datos cuadruplica el costo. Para pasar de ahí hace falta otra idea: dividir el problema.
Mergesort
La idea
Mergesort (ordenamiento por mezcla) se apoya en una observación simple: mezclar dos arreglos que ya están ordenados es fácil y barato. Basta mirar el primero de cada uno y sacar el menor, como quien junta dos pilas de exámenes ordenadas.
algoritmo merge_sort(a, lo, hi)
    si hi - lo < 2 entonces
        devolver
    fin si
    mid ← lo + (hi - lo) div 2
    merge_sort(a, lo, mid)
    merge_sort(a, mid, hi)
    mezclar(a, lo, mid, hi)
fin algoritmo
Los rangos son semiabiertos, como en toda la biblioteca de C++: lo entra y hi no. Un rango con 0 o 1 elementos ya
está ordenado, y ese es el caso base.
La mezcla
La mezcla es el corazón del algoritmo. Mantiene esta invariante: buffer[lo, out) tiene, en orden, los elementos
más pequeños de los dos lados, e items[left, mid) e items[right, hi) son lo que falta.
inline void merge_runs(std::vector<int>& items, std::vector<int>& buffer, std::size_t lo,
                       std::size_t mid, std::size_t hi, long long& comparisons) {
    std::size_t left = lo;
    std::size_t right = mid;
    std::size_t out = lo;
    while (left < mid && right < hi) {
        comparisons++;
        if (items[right] < items[left]) {
            buffer[out++] = items[right++];
        } else {
            buffer[out++] = items[left++];
        }
    }
    while (left < mid) {
        buffer[out++] = items[left++];
    }
    while (right < hi) {
        buffer[out++] = items[right++];
    }
    for (std::size_t i = lo; i < hi; i++) {
        items[i] = buffer[i];
    }
}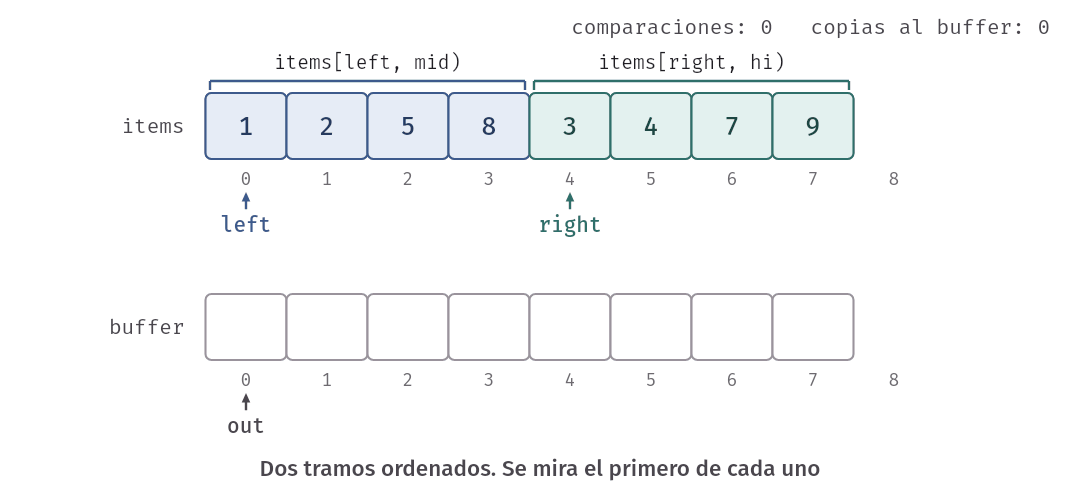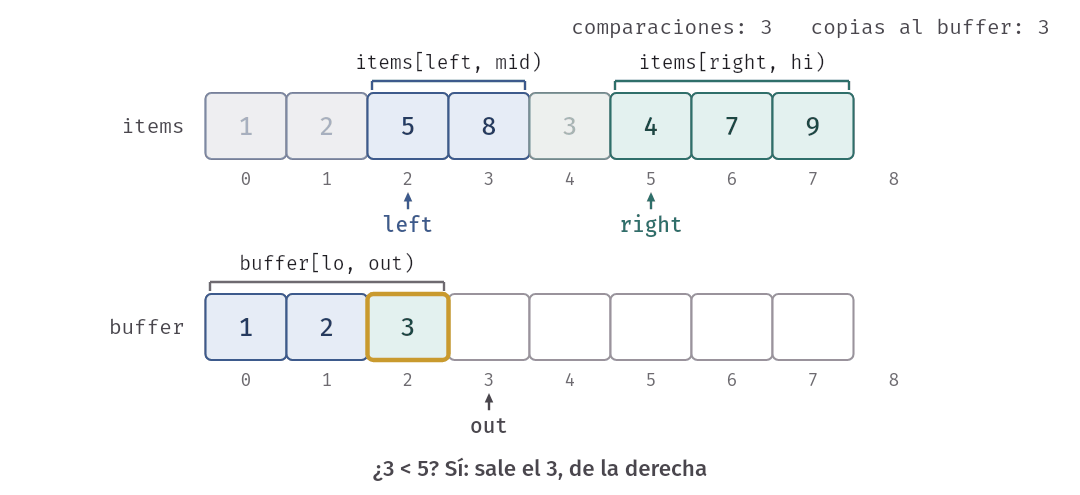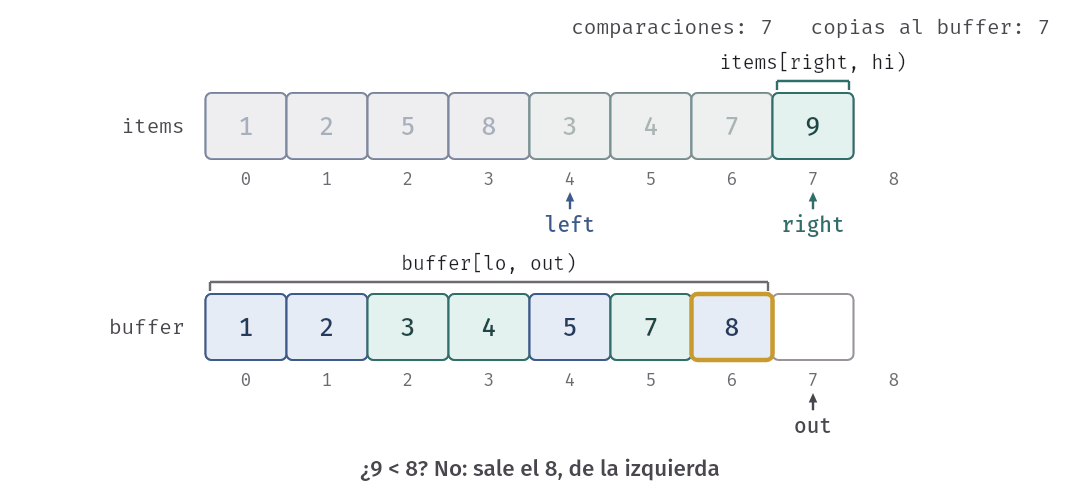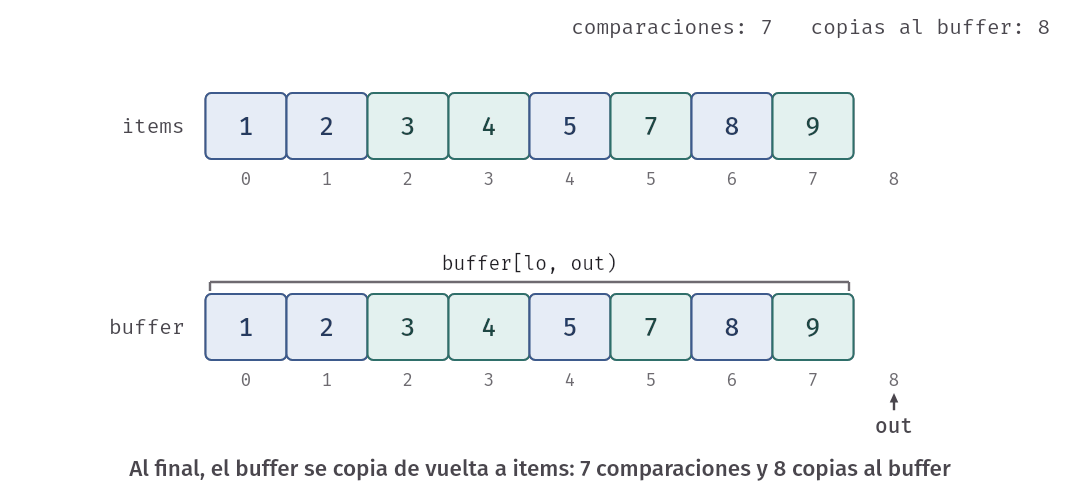
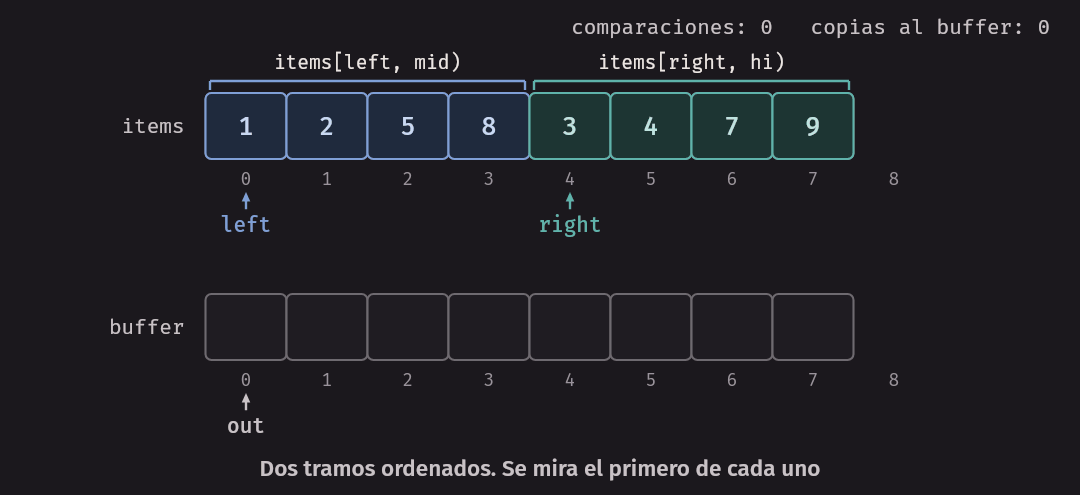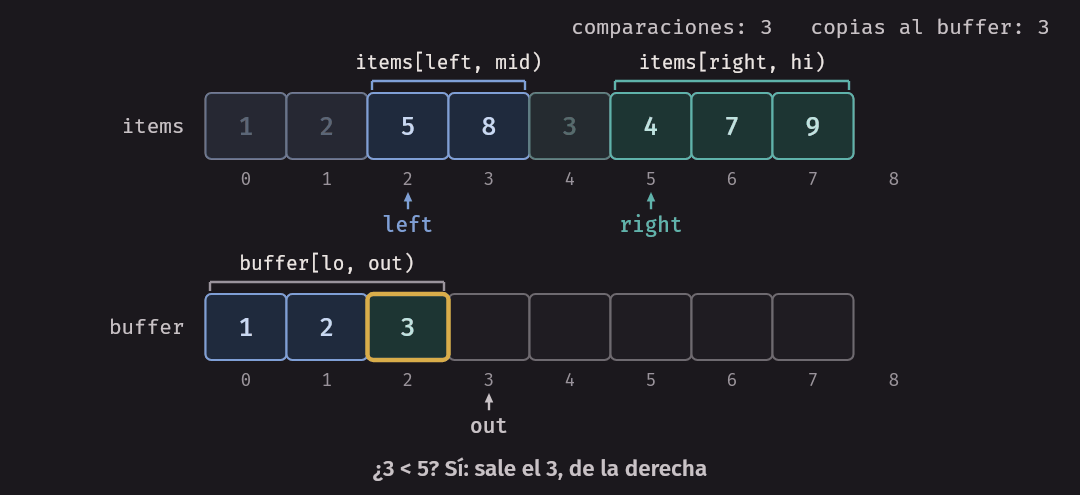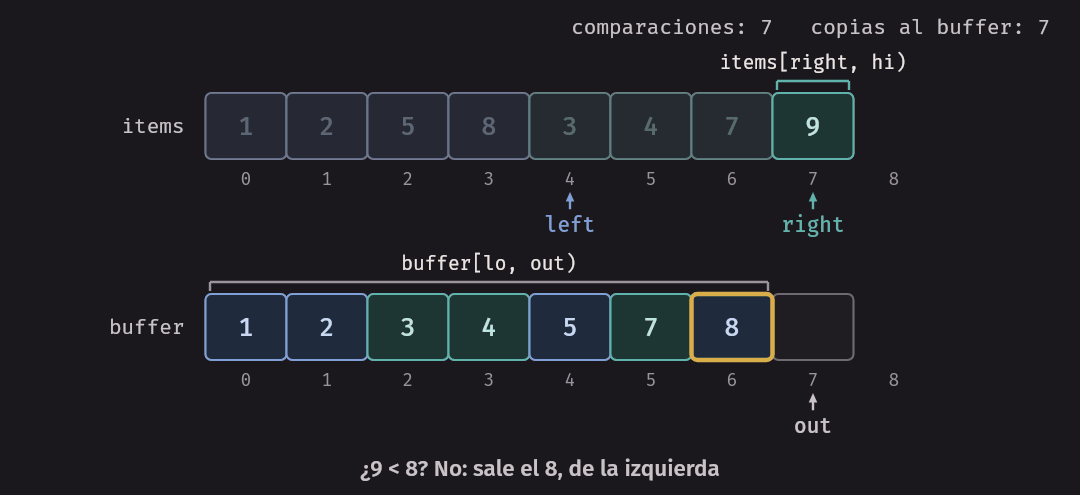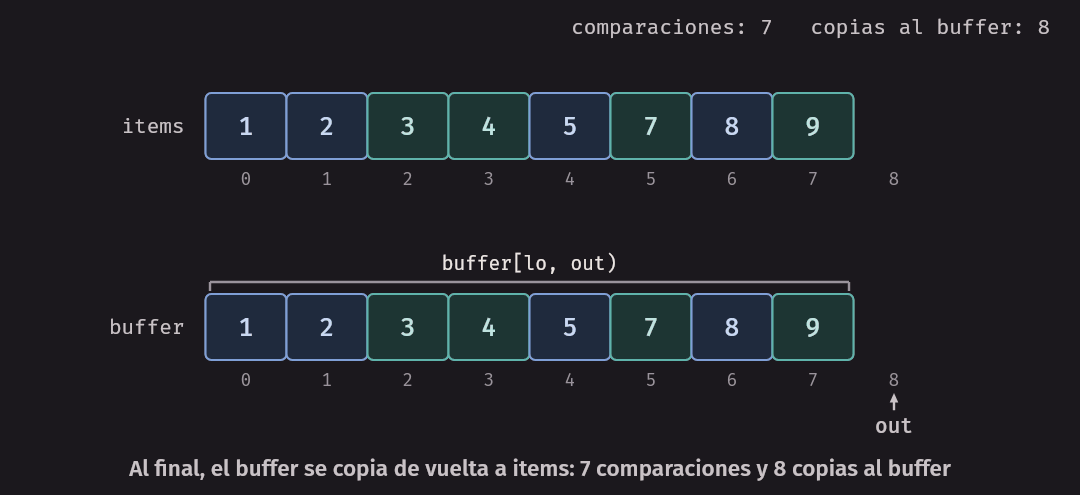
Cada vuelta del primer ciclo hace una comparación y saca un elemento. Cuando un lado se acaba, el otro se copia sin comparar. Por eso, mezclar m elementos cuesta a lo sumo m − 1 comparaciones y exactamente m copias hacia el buffer.
Miren la condición del if. Se toma el de la derecha solo si es estrictamente menor. En un empate gana el de la
izquierda. Parece un detalle; en la sección de estabilidad veremos que no lo es.
El árbol de llamadas
Este programa ordena ocho números y muestra lo que hace cada nivel de la recursión. Las divisiones van de arriba abajo, y las mezclas de abajo arriba:
$ build/trace_merge
dividir
  nivel 0: [5 2 8 1 9 3 7 4]
  nivel 1: [5 2 8 1] [9 3 7 4]
  nivel 2: [5 2] [8 1] [9 3] [7 4]
  nivel 3: [5] [2] [8] [1] [9] [3] [7] [4]
mezclar
  nivel 2: [2 5] [1 8] [3 9] [4 7]
           4 comparaciones, 8 elementos copiados
  nivel 1: [1 2 5 8] [3 4 7 9]
           6 comparaciones, 8 elementos copiados
  nivel 0: [1 2 3 4 5 7 8 9]
           7 comparaciones, 8 elementos copiados
Este es el árbol de llamadas para n = 8. Cada línea de dividir es un nivel del árbol. De esta salida sale todo el
análisis, sin necesidad de una recurrencia ni de inducción:
- Cuántos niveles hay. Cada nivel parte los rangos por la mitad. Con n = 8, los tamaños son 8, 4, 2 y 1. Se puede dividir por 2 unas log₂ n veces hasta llegar a 1, así que hay alrededor de log₂ n niveles con mezclas.
- Cuánto cuesta cada nivel. Los rangos de un nivel no se tocan entre sí y juntos tienen los n elementos. Por lo tanto, cada nivel copia n elementos y hace menos de n comparaciones. La salida lo muestra: 8 copias por nivel.
- El total. log₂ n niveles con Θ(n) de trabajo cada uno da Θ(n log n), en cualquier caso. El algoritmo divide siempre igual, sin importar qué haya en el arreglo.
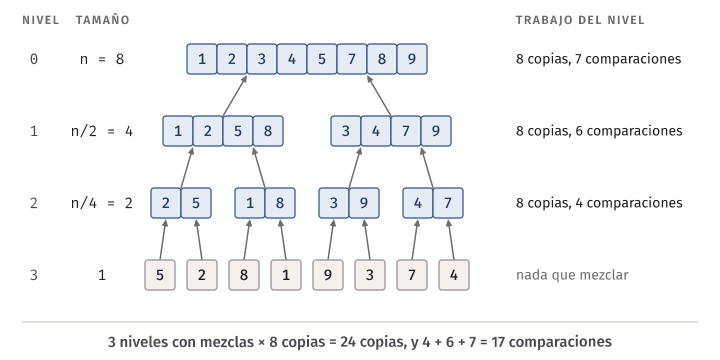
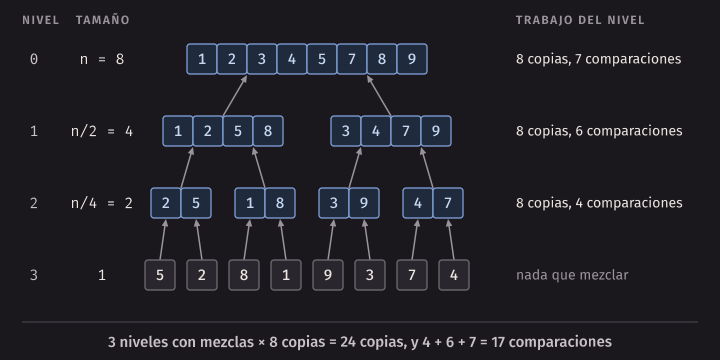
Idea clave. Para analizar un algoritmo recursivo que divide, dibujen el árbol de llamadas y sumen por niveles, no por llamadas. Las llamadas de un nivel son muchas y chicas, pero juntas tocan cada elemento una vez.
Lo que cuesta: memoria extra
La mezcla necesita un lugar donde escribir: si escribiera sobre items, pisaría elementos que todavía no leyó. Por
eso mergesort usa un buffer de n elementos, más los alrededor de log₂ n marcos de la recursión. No es un
algoritmo “en el lugar” (in place). Con 1000 millones de enteros, son 4 GB más.
Esa es su única desventaja seria. A cambio, garantiza Θ(n log n) en el peor caso, y es estable.
inline void merge_sort_ints(std::vector<int>& items, long long& comparisons) {
    std::vector<int> buffer(items.size());
    merge_sort_range(items, buffer, 0, items.size(), comparisons);
}
El buffer se reserva una sola vez afuera, y todos los niveles lo comparten. Si cada mezcla reservara el suyo, el algoritmo tendría el mismo O, y haría unas n reservas de memoria en vez de una.
Quicksort
La idea
Quicksort hace lo mismo al revés. En mergesort, dividir es trivial y el trabajo está en juntar. En quicksort, el trabajo está en dividir, y juntar es trivial.
Definición. Partir (partition) un rango respecto de un pivote p es reacomodarlo para que primero queden los elementos menores que p, luego p, y luego los mayores o iguales. Cuando termina, p ya está en su lugar definitivo.
Una vez partido, ningún elemento de la izquierda tiene que pasar a la derecha. Basta ordenar cada lado por separado.
algoritmo quick_sort(a, lo, hi)
    si hi - lo < 2 entonces
        devolver
    fin si
    p ← partir(a, lo, hi)
    quick_sort(a, lo, p)
    quick_sort(a, p + 1, hi)
fin algoritmo
Y no necesita buffer: la partición intercambia elementos dentro del mismo arreglo.
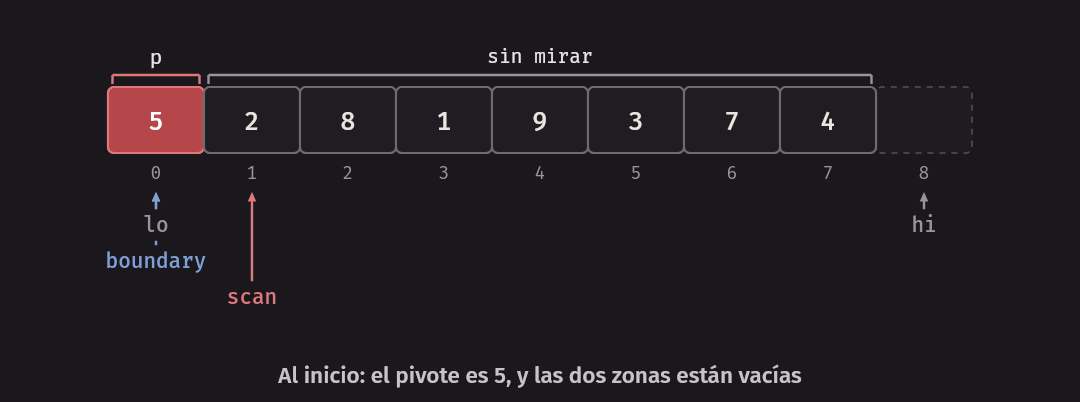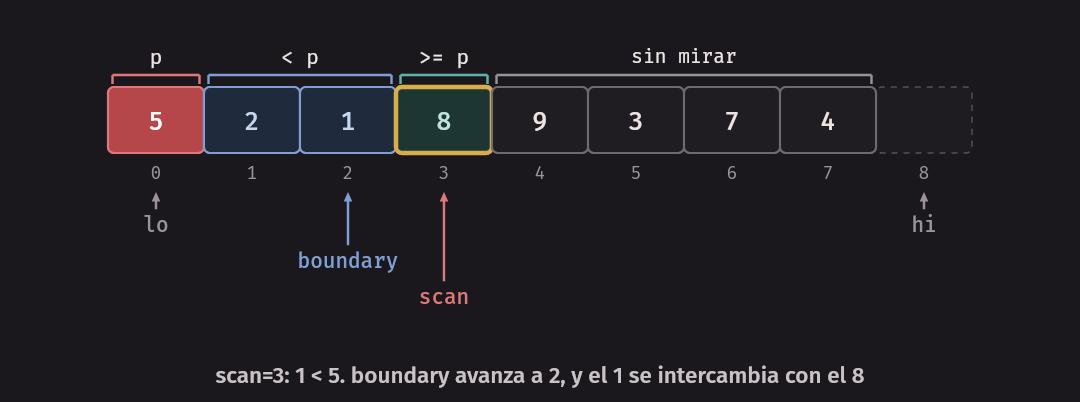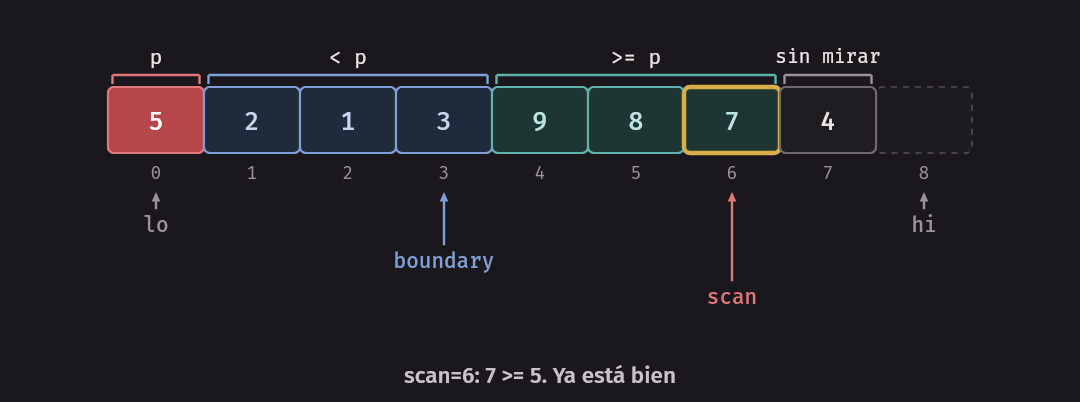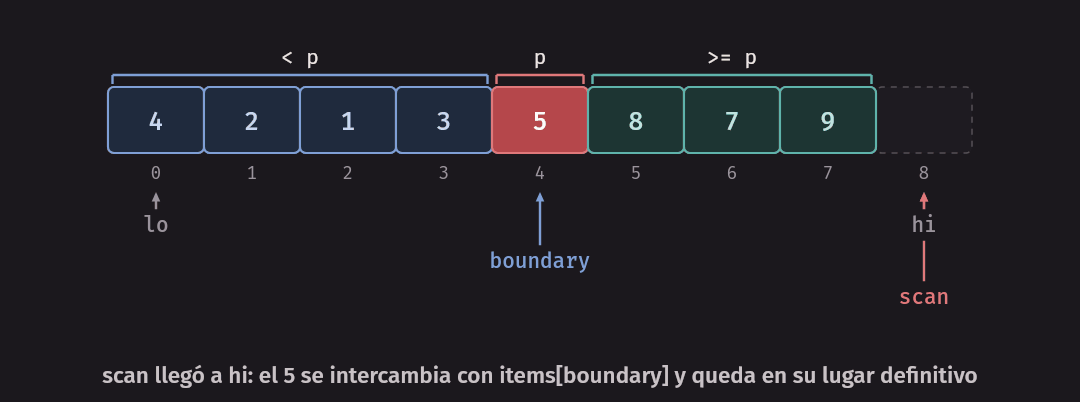
La invariante de la partición
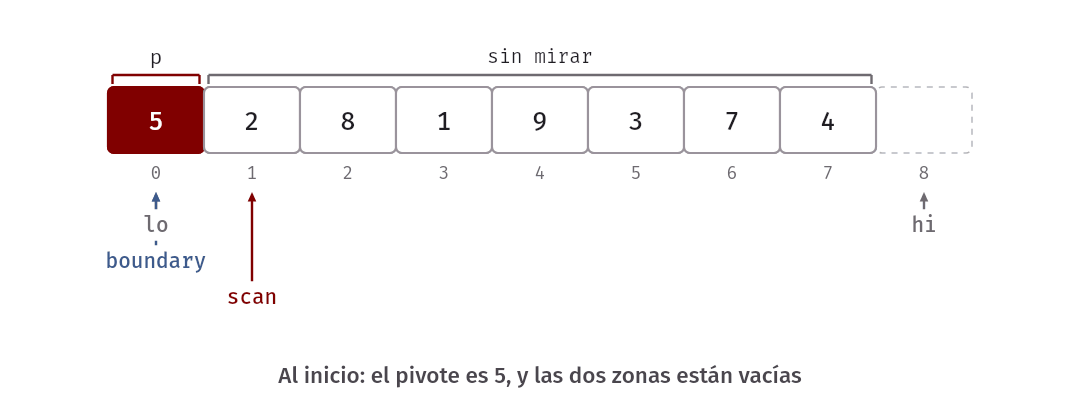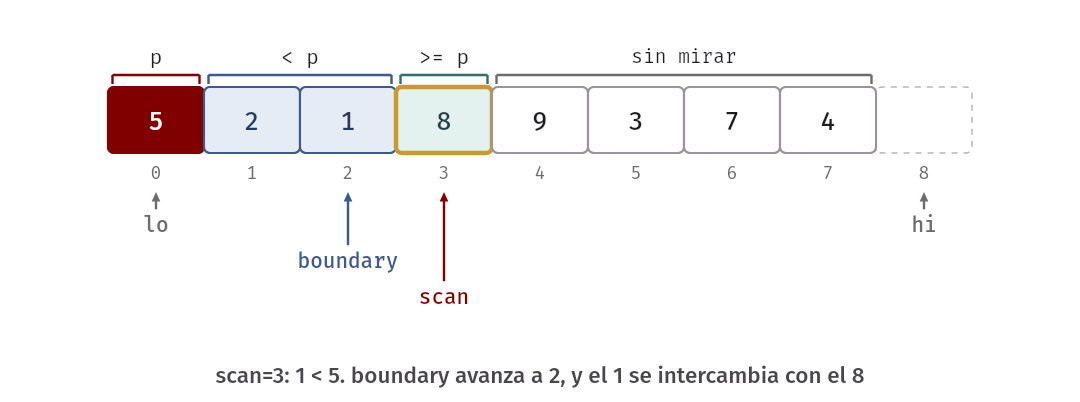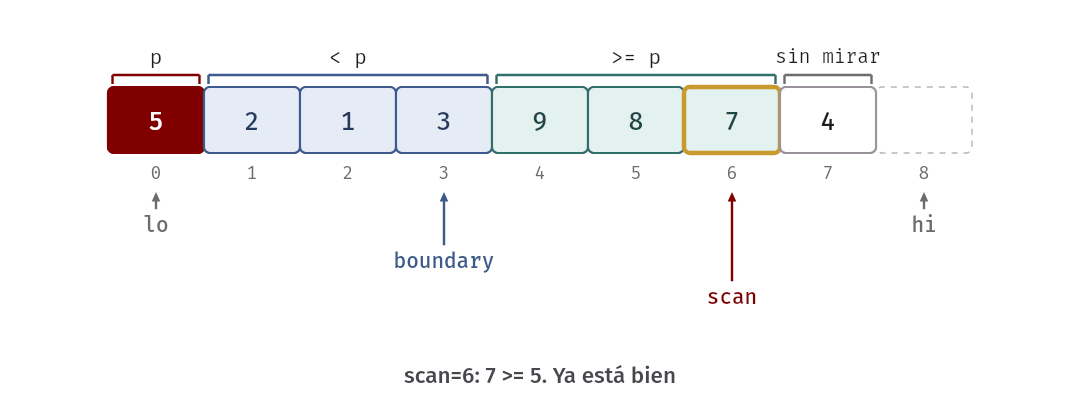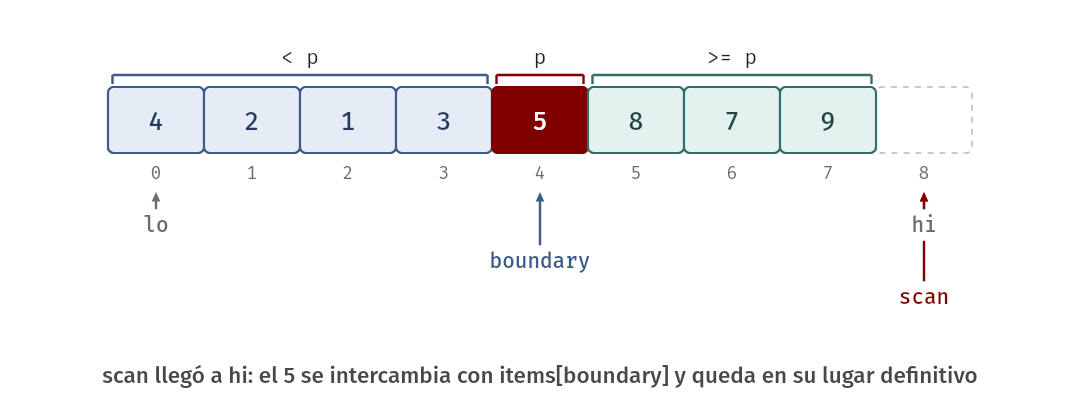
Empezamos con el pivote más simple: el primer elemento. La partición recorre el arreglo con scan y va dejando atrás
dos zonas, separadas por boundary:
inline std::size_t partition_first(std::vector<int>& items, std::size_t lo, std::size_t hi,
                                   long long& comparisons) {
    int pivot = items[lo];
    std::size_t boundary = lo;
    // Invariante: items(lo, boundary] < pivot, e items(boundary, scan) >= pivot.
    for (std::size_t scan = lo + 1; scan < hi; scan++) {
        comparisons++;
        if (items[scan] < pivot) {
            boundary++;
            std::swap(items[boundary], items[scan]);
        }
    }
    std::swap(items[lo], items[boundary]);
    return boundary;
}
Revisemos la invariante como se revisa cualquiera: al inicio, en cada paso y al final.
- Al inicio.
boundary == loyscan == lo + 1. Las dos zonas están vacías, así que se cumple. - En cada paso. Si
items[scan] >= pivot, el elemento ya está bien: avanzarscanagranda la zona>=. Si es menor,boundaryavanza hasta el primer elemento de la zona>=, y el intercambio lo manda al final de esa zona y trae al menor a la zona<. - Al final.
scan == hi, ya no queda nada sin mirar. El últimoswappone al pivote entre las dos zonas, porque enboundaryhay un elemento menor que él (o el propio pivote, si la zona<está vacía).
Sigámoslo con el arreglo de antes:
$ build/trace_partition | head -9
pivote = primer elemento = 5
  scan=1 boundary=1  5 2 8 1 9 3 7 4
  scan=2 boundary=1  5 2 8 1 9 3 7 4
  scan=3 boundary=2  5 2 1 8 9 3 7 4
  scan=4 boundary=2  5 2 1 8 9 3 7 4
  scan=5 boundary=3  5 2 1 3 9 8 7 4
  scan=6 boundary=3  5 2 1 3 9 8 7 4
  scan=7 boundary=4  5 2 1 3 4 8 7 9
  pivote a su lugar 4 2 1 3 5 8 7 9  (posición 4)
El 5 quedó en la posición 4, que es donde estará al final. Y 4 2 1 3 y 8 7 9 no están ordenados, pero ya no se
mezclarán entre sí.
El mejor caso y el peor caso
El costo de una partición de un rango de tamaño m es m − 1 comparaciones. Lo que cambia es la forma del árbol.
Si el pivote cae en el medio, se parte en dos mitades. El árbol es igual al de mergesort: log₂ n niveles con unas n comparaciones cada uno, Θ(n log n).
Si el pivote es siempre un extremo, el menor o el mayor del rango, un lado queda vacío y el otro tiene m − 1. El árbol degenera en un camino con n niveles, y las comparaciones suman (n − 1) + (n − 2) + … + 1 = n(n − 1)/2, que es Θ(n²).
¿Qué entrada hace eso con el primer elemento? Una que ya está ordenada: el primero siempre es el menor. Es irónico, porque la entrada más fácil de todas es la peor. Con la inversa, el pivote es alternadamente el mayor y el menor, y cada partición también saca un solo elemento. Lo mismo con todos los elementos iguales: ninguno es estrictamente menor que el pivote. Y no son casos raros: los datos ya ordenados, o casi, son muy comunes.
El conteo no deja dudas, y coincide con la fórmula exactamente:
$ build/count_sorts | sed -n '9,13p'
quicksort con el primero como pivote, entrada ordenada
     n  comparac.     n(n-1)/2
  1000     499500       499500
  2000    1999000      1999000
  4000    7998000      7998000
Al duplicar n, las comparaciones se multiplican por 4. Ese es el sello de Θ(n²).
Y hay un segundo problema, además del tiempo: la recursión también tiene n niveles. Cada nivel es un marco en la
pila, y la pila es limitada. Este programa ordena una entrada ya ordenada con el pivote fijo. Con 20 000 elementos
y la pila
por defecto de 8 MB termina bien. Si achicamos la pila a 1 MB con ulimit -s, para no esperar mucho, se ve qué pasa
cuando la recursión no cabe:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/deep_recursion.cpp -o build/deep_recursion
$ build/deep_recursion 20000
ordenó 20000 elementos
$ ulimit -s 1024; build/deep_recursion 20000 2>&1 | sed -n '3p;$p' | cut -c1-74
==26406==ERROR: AddressSanitizer: stack-overflow on address 0xffffe0083ff0
==26406==ABORTING
Con la pila normal de 8 MB pasa lo mismo, solo que hace falta una entrada más grande: en esta máquina, ordenar 100 000 elementos terminó en el mismo error después de más de medio minuto. Las direcciones cambian en cada corrida.
Error común. Creer que el peor caso de quicksort “solo” es lento. Con un pivote ingenuo puede además tumbar el programa, y una entrada ordenada basta para causarlo. Un servidor que ordena lo que le manda un usuario queda expuesto.
El caso promedio
Si el arreglo está en un orden al azar, quicksort cuesta Θ(n log n) en promedio. Hay una manera de verlo que no necesita inducción: contar pares.
Llamemos z₁ < z₂ < … < zₙ a los elementos en orden, supongamos que son distintos, y tomemos un par zᵢ, zⱼ con i < j. Dos elementos se comparan solo si uno de ellos es el pivote, y un par se compara a lo sumo una vez, porque el pivote no vuelve a participar.
Miren el grupo zᵢ, zᵢ₊₁, …, zⱼ, que tiene j − i + 1 elementos. Mientras no se elija un pivote de ese grupo, todos siguen juntos en el mismo rango. Si el primero que se elige es zᵢ o zⱼ, el par se compara. Si es uno del medio, zᵢ y zⱼ se separan para siempre. Cada elemento del grupo tiene la misma probabilidad de salir primero, así que:
P(zi y zj se comparan) = 2 / (j - i + 1)Los vecinos se comparan siempre, y los lejanos casi nunca. Sumando sobre todos los pares, el valor esperado es un poco menos de 2n(1 + 1/2 + 1/3 + … + 1/n), y esa suma armónica es alrededor de ln n. El total es aproximadamente 2n ln n ≈ 1.39 n log₂ n. Se puede comprobar contando:
$ build/count_sorts | sed -n '16,20p'
quicksort con pivote al azar, entrada al azar: promedio de 20 semillas
       n   comparac.    2 n ln n  razón
    1000       10832       13816   0.784
   10000      155270      184207   0.843
  100000     2021950     2302585   0.878
La razón se acerca a 1 lentamente, porque 2n ln n omite términos negativos proporcionales a n, que pesan menos a medida que n crece.
Pivote al azar
El argumento anterior supuso que el arreglo viene al azar. No podemos pedirle eso al usuario. Pero podemos poner el azar nosotros: elegir el pivote al azar da lo mismo que tener un arreglo al azar, y ya no hay ninguna entrada fija que sea mala siempre.
inline void quick_random_range(std::vector<int>& items, std::size_t lo, std::size_t hi,
                               std::mt19937& rng, long long& comparisons) {
    if (hi - lo < 2) {
        return;
    }
    std::uniform_int_distribution<std::size_t> pick(lo, hi - 1);
    std::swap(items[lo], items[pick(rng)]);
    std::size_t p = partition_first(items, lo, hi, comparisons);
    quick_random_range(items, lo, p, rng, comparisons);
    quick_random_range(items, p + 1, hi, rng, comparisons);
}
Es un cambio de dos líneas. Lo que pasa a ser aleatorio es el algoritmo, no los datos. Toda entrada de elementos distintos tiene el mismo costo esperado, Θ(n log n). Sigue existiendo una mala racha que cuesta Θ(n²), pero depende de la suerte de esa corrida, y no de lo que el usuario mandó. Con n grande, esa racha es tan improbable que no vale la pena preocuparse por ella.
En C++.
std::mt19937es un generador de números pseudoaleatorios, ystd::uniform_int_distribution<T>(a, b)da valores en el rango cerrado [a, b]. Por eso vahi - 1. Se usa una semilla fija para que las pruebas se repitan. Un servidor expuesto a usuarios hostiles usaría una semilla que no se pueda adivinar. El estándar fija la secuencia demt19937, pero no cómo la distribución convierte esos números, así que otra biblioteca podría elegir otros pivotes.
Ahora veamos todo junto. Esta tabla cuenta las comparaciones con n = 4096, con cinco entradas. Son conteos, no tiempos, así que no dependen de la máquina:
$ build/count_sorts | sed -n '1,7p'
comparaciones con n = 4096
entrada        merge q.primero    q.azar    q.tres std::sort    stable
al azar        43983     56479     55320     88183     59551     48346
ordenada       24576   8386560     61392     94040     55831     28668
inversa        24576   8386560     56008     87440     41482     21654
10 valores     42540    850773    855607     26340     41311     47160
iguales 24576 8386560 8386560 8192 37643 28668(std::sort y std::stable_sort cuentan aquí lo que hacen en esta biblioteca.) Lean la tabla por columnas:
mergesiempre se queda entre 24 000 y 44 000, por debajo de n log₂ n = 49 152.q.primerova bien con datos al azar, y con los ordenados se dispara hasta 8 386 560, que es n(n − 1)/2.q.azararregla la filaordenada. Pero miren la última fila: con todos iguales sigue en 8 386 560. El azar no sirve de nada ahí. Eso nos lleva al siguiente problema.
Muchos elementos repetidos
Nuestra partición manda a la derecha todo lo que es mayor o igual al pivote. Si todos los elementos son iguales, cada partición saca solo al pivote y deja n − 1 a la derecha, sin importar cuál se elija. Con solo 10 valores distintos, la tabla también muestra más de 850 000 comparaciones. El azar protege contra el orden de los datos, pero no contra los empates.
Y en la práctica los empates son lo normal: ordenar a 40 000 estudiantes por ciclo, o las 28 039 palabras de nuestro archivo por frecuencia. Más de la mitad de esas palabras, 14 110, aparece una sola vez.
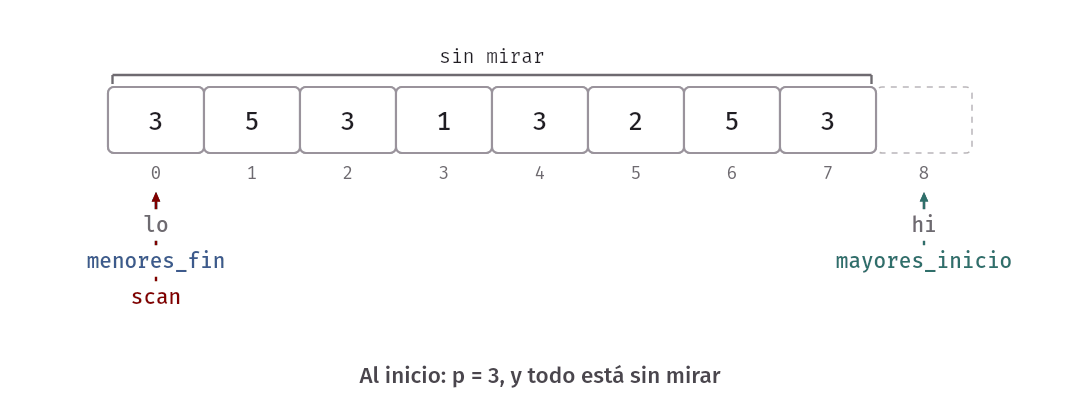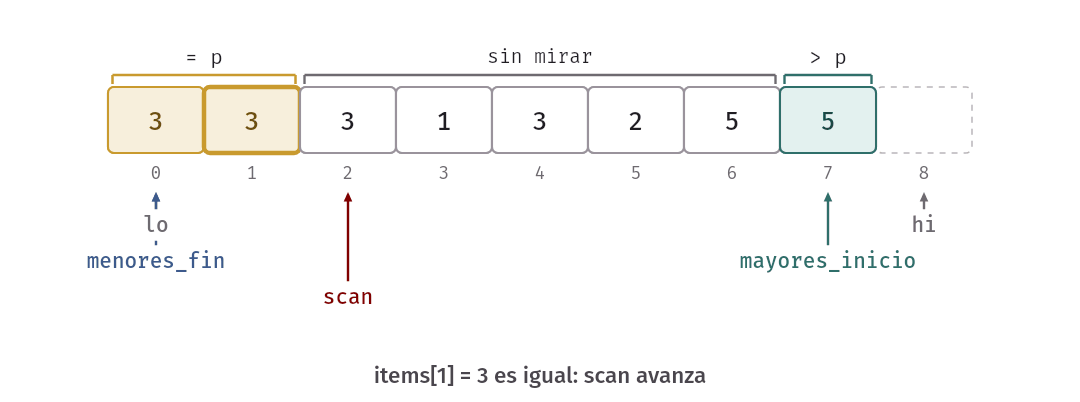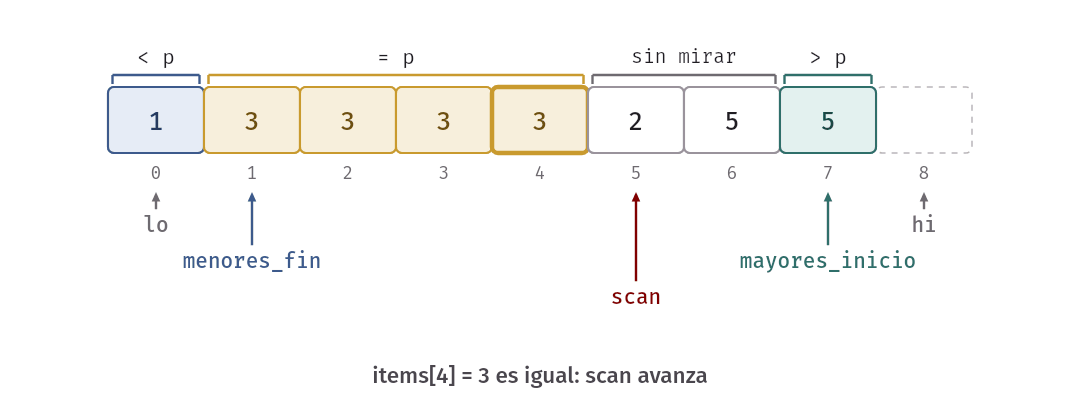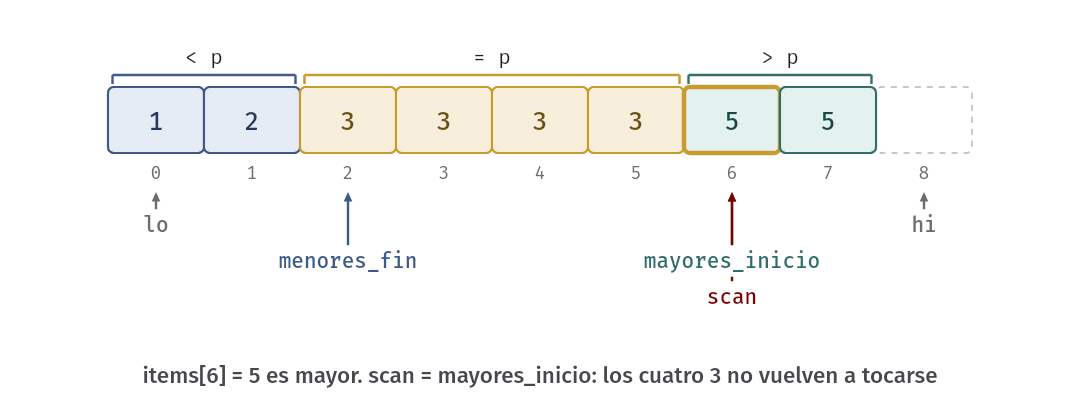
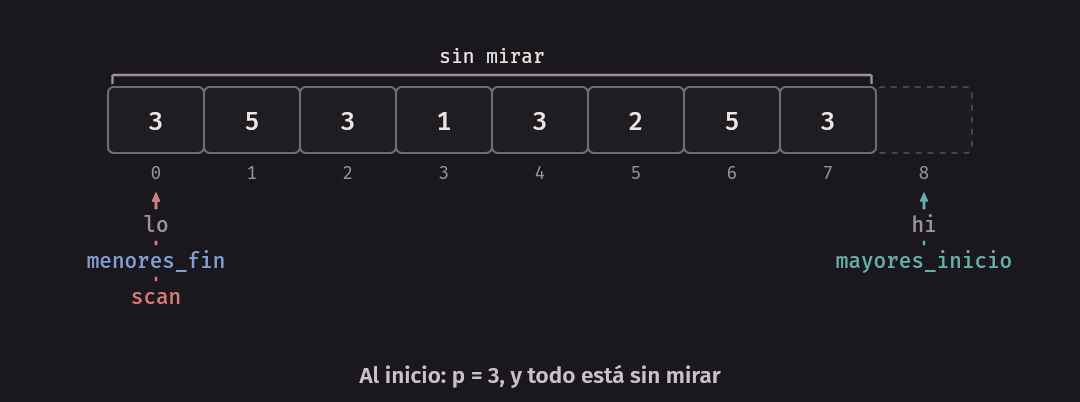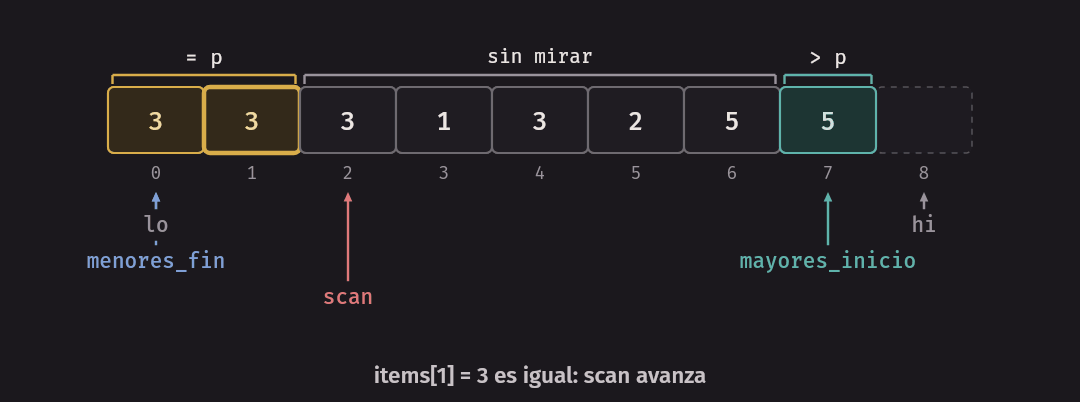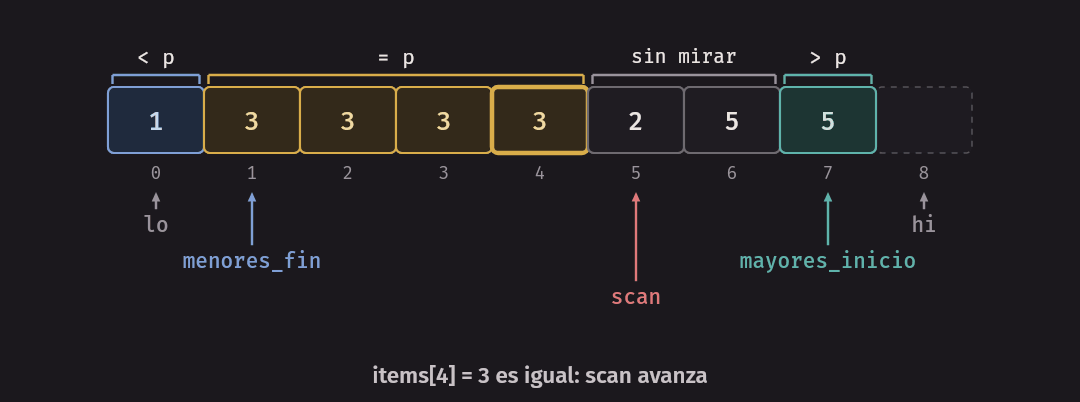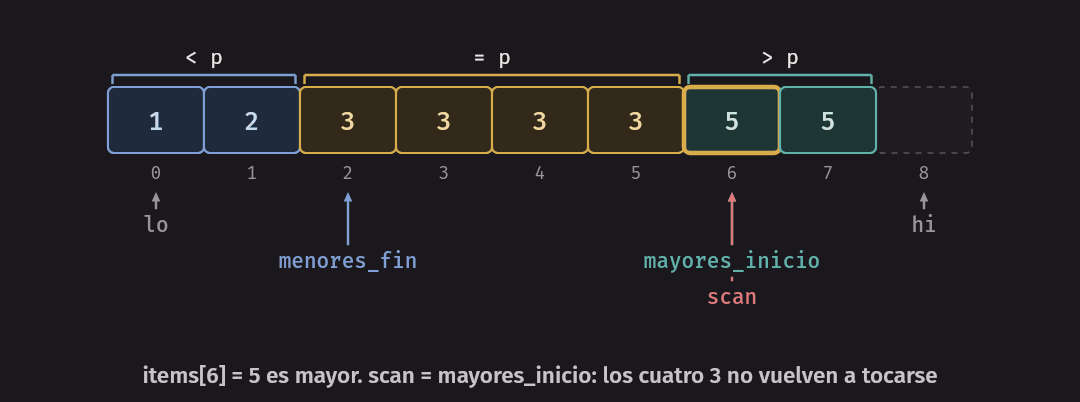
La solución es una partición en tres: los menores, los iguales y los mayores. Los iguales ya están en su lugar definitivo, y no vuelven a tocarse. Se recurre solo sobre menores y mayores. Se mantienen tres fronteras:
algoritmo partir_en_tres(a, lo, hi, p)
    menores_fin ← lo
    scan ← lo
    mayores_inicio ← hi
    mientras scan < mayores_inicio hacer
        si a[scan] < p entonces
            intercambiar a[menores_fin] con a[scan]
            menores_fin ← menores_fin + 1
            scan ← scan + 1
        sino si p < a[scan] entonces
            mayores_inicio ← mayores_inicio - 1
            intercambiar a[scan] con a[mayores_inicio]
        sino
            scan ← scan + 1
        fin si
    fin mientras
    devolver menores_fin, mayores_inicio
fin algoritmo
Un detalle: cuando el elemento es mayor, scan no avanza, porque lo que llegó desde el final no se ha mirado.
Cuando es
menor sí avanza, porque lo que llega desde menores_fin es un igual ya revisado.
$ build/trace_partition | sed -n '10,18p'
pivote = 3
  menores_fin=0 scan=1 mayores_inicio=8  3 5 3 1 3 2 5 3
  menores_fin=0 scan=1 mayores_inicio=7  3 3 3 1 3 2 5 5
  menores_fin=0 scan=2 mayores_inicio=7  3 3 3 1 3 2 5 5
  menores_fin=0 scan=3 mayores_inicio=7  3 3 3 1 3 2 5 5
  menores_fin=1 scan=4 mayores_inicio=7  1 3 3 3 3 2 5 5
  menores_fin=1 scan=5 mayores_inicio=7  1 3 3 3 3 2 5 5
  menores_fin=2 scan=6 mayores_inicio=7  1 2 3 3 3 3 5 5
  menores_fin=2 scan=6 mayores_inicio=6  1 2 3 3 3 3 5 5
Al final, 1 2 son los menores, los cuatro 3 no vuelven a tocarse, y 5 5 son los mayores. La columna q.tres
de la tabla muestra el
efecto: con todos iguales baja a 8192 comparaciones, que son 2n, una sola pasada. Con 10 valores, a 26 340. Y hay
un precio: cada elemento que no es menor cuesta dos comparaciones, así que con datos distintos q.tres hace
bastante más
que q.azar (88 183 contra 55 320).
Con k valores distintos, un rango se reduce a nada en unas log k pasadas, y el costo esperado es O(n log k), que llega a Θ(n log k) si los valores son más o menos igual de frecuentes. Eso no contradice la cota de la siguiente sección, que habla de elementos que pueden ser todos distintos.
Idea clave. Quicksort tiene tres enemigos distintos. El pivote fijo cae ante entradas ordenadas, el pivote al azar lo arregla, y la partición en tres arregla los empates. Ninguno de los dos remedios sirve para el otro problema.
La profundidad de la pila
Con pivote al azar, la recursión tiene una profundidad esperada de Θ(log n), pero ninguna garantía. Hay un truco sencillo que sí la da: recurrir sobre el lado menor y seguir en un ciclo con el mayor. El lado sobre el que se recurre tiene a lo sumo la mitad de los elementos, así que caben a lo sumo log₂ n marcos, pase lo que pase. Es opcional en el laboratorio.
Lo que dice el reloj
Hasta aquí, conteos. Veamos si el reloj está de acuerdo. Medimos con -O2, sin sanitizers, mediana de 5 repeticiones,
sobre int, y con la máquina compartida con otros procesos. Los tiempos dependen de la máquina; lo comparable
son las razones, y las de abajo se repitieron en 3 corridas:
$ build/time_sorts
milisegundos con n = 16000
entrada       merge q.primero   q.azar   q.tres std::sort   stable
al azar        0.89     0.81     0.87     1.09     0.68     0.72
ordenada       0.24    70.71     0.34     0.57     0.12     0.07
10 valores     0.50     9.02     9.38     0.12     0.18     0.30
iguales        0.24    58.64    76.78     0.03     0.07     0.07

entrada al azar, milisegundos al duplicar n
       n    merge   q.azar   q.tres std::sort   stable
  250000     20.1     17.9     22.7      14.8     16.8
  500000     42.8     36.9     47.6      31.0     35.5
1000000 89.1 77.6 99.4 66.5 75.4- La entrada mala. Con la entrada ordenada,
q.primerotardó unas 200 veces más queq.azarcon solo 16 000 elementos. En las 3 corridas, la razón estuvo entre 200 y 270. - Los empates. Con todos iguales,
q.trestardó más de 1000 veces menos queq.azar. - La forma. Con datos al azar, al duplicar n cada columna se multiplica por un poco más de 2, lo que esperamos de Θ(n log n): (2n log 2n) / (n log n) ≈ 2.1 con estos n. No lo tomen como prueba, sino como que no lo contradice.
- Las constantes. Con datos al azar,
mergehace menos comparaciones queq.azar(43 983 contra 55 320 con n = 4096), y aun así, con n grande, tarda más. Mergesort copia todo a un buffer y de vuelta, y eso el conteo de comparaciones no lo ve. Puede que también pese la cache, pero no lo medimos.q.treshace un 60% más comparaciones queq.azar, y con n grande tarda alrededor de un 27% más: otro recordatorio de que una comparación no vale un tiempo fijo.
Estabilidad
Definición. Un ordenamiento es estable (stable sort) si dos elementos equivalentes quedan en el resultado en el mismo orden relativo que tenían al principio.
No tiene sentido hablar de estabilidad si los elementos equivalentes son indistinguibles, como dos enteros iguales. Importa cuando se ordena por una clave y el elemento lleva algo más: un registro de estudiante que se ordena solo por nota, un término que se ordena solo por frecuencia.
Cuándo importa. En una tabla ordenada por nombre, el usuario hace clic en “nota”. Espera que los que tienen la misma nota sigan por nombre. Un ordenamiento estable lo da gratis: ordenar por la clave secundaria, y después de manera estable por la principal, deja los empates de la segunda ordenados por la primera.
Mergesort es estable por la decisión que señalamos en la mezcla: en un empate, gana el de la izquierda, y el de la
izquierda era
el que estaba antes. Por eso la condición es items[right] < items[left]. Si se escribiera
!(items[left] < items[right]), ordenaría igual de bien, y dejaría de ser estable.
Quicksort, con estas particiones, no lo es. Un swap manda un elemento lejos, saltando por encima de otros
iguales. Aquí
hay cuatro exámenes, con su nota y una letra para distinguirlos:
$ build/stability ../../data/terminos.tsv | head -2
antes:    2a 3b 3c 1d
partido:  1d 2a 3c 3b
Antes 3b iba delante de 3c; después de una sola partición, 3c va delante. Ya no hay manera de saber cuál iba
primero.
Una prueba con datos reales
Nuestro archivo terminos.tsv está ordenado por frecuencia descendente, y los empates por texto. Eso nos da un
experimento
limpio: tomamos los términos ordenados por texto, los volvemos a ordenar por frecuencia, y vemos cuántas líneas
coinciden
con el archivo.
$ build/stability ../../data/terminos.tsv | tail -3
líneas: 28039
std::stable_sort, iguales al archivo: 28039
std::sort,        iguales al archivo: 344
std::stable_sort reconstruye el archivo línea por línea. std::sort también deja las frecuencias en orden, y
nadie puede
decir que su resultado esté mal, porque nunca prometió otra cosa. Solo que los empates quedaron en cualquier orden.
Error común. Creer que algo es estable porque salió bien en una prueba chica. En libstdc++, un rango de 16 elementos o menos se ordena solo por inserción, que preserva el orden de los empates. Este programa ordena con
std::sortregistros con tres claves posibles, y cuenta cuántos pares vecinos empatados quedaron invertidos:
$ build/stability ../../data/terminos.tsv | sed -n '3,4p'
std::sort con 16 elementos, empates invertidos: 0
std::sort con 17 elementos, empates invertidos: 8
Para probar estabilidad, usen entradas grandes y muchos empates.
La cota Ω(n log n)
Mergesort cuesta Θ(n log n) en el peor caso. ¿Se podrá hacer mejor con otra idea más ingeniosa? Si solo se usan comparaciones, no.
El árbol de decisiones. Un ordenamiento por comparación, sobre n elementos, se puede describir como un árbol. Cada nodo es una pregunta “¿a < b?”, y según la respuesta se sigue por una rama. Cada hoja es una conclusión: “el orden correcto es este”. Por ejemplo, con tres elementos a, b y c:
                         ¿a < b?
                 sí /              \ no
              ¿b < c?              ¿a < c?
            sí /    \ no         sí /    \ no
          a b c    ¿a < c?     b a c    ¿b < c?
                 sí /   \ no          sí /   \ no
               a c b   c a b        b c a   c b a
Hay dos observaciones, y la cota sale de ellas:
- Hacen falta al menos n! hojas. n elementos distintos se pueden ordenar de n! maneras, y cada una de ellas pide una respuesta distinta. Si dos órdenes llegaran a la misma hoja, el algoritmo se equivocaría con uno.
- Un árbol binario de altura h tiene a lo sumo 2ʰ hojas. Cada pregunta como mucho duplica los caminos posibles.
Por lo tanto 2ʰ ≥ n!, o sea h ≥ log₂(n!). La altura es el número de comparaciones en el peor caso. Con n = 3, log₂ 6 ≈ 2.58, así que hacen falta 3 preguntas en el peor caso, que es justo lo que muestra el árbol.
Falta ver cuánto es log₂(n!). No hace falta ninguna fórmula: la mitad de los factores de n! son al menos n/2, así que n! ≥ (n/2)^(n/2), y entonces:
log2(n!) >= (n/2) log2(n/2)Eso es Ω(n log n). No damos aquí una demostración completa, porque no consideramos todos los detalles de lo que puede hacer un algoritmo. Pero la idea es esa: hay que distinguir entre n! posibilidades, y cada comparación da un solo bit de información.
Con n = 4096 son log₂(4096!) ≈ 43 250 comparaciones en el peor caso. Con datos al azar, nuestro mergesort hizo 43 983: está a menos de un 2% del límite teórico. Por comparaciones, no queda casi nada que ganar.
Lo que la cota dice y lo que no dice
- Se aplica a cualquier algoritmo que obtenga información sobre el orden solo comparando pares de elementos: mergesort, quicksort, inserción, y también heapsort, que veremos en la semana 13.
- Habla del peor caso. No dice que toda entrada cueste tanto. El mergesort de la tabla hizo 24 576 comparaciones con la entrada ordenada, bien por debajo de 43 250, y eso es porque una entrada determinada solo recorre un camino del árbol.
- No se aplica a un algoritmo que use los datos de otra manera. Si los valores son enteros de 0 a 99, basta contar cuántos hay de cada uno en un arreglo de 100 casillas. Eso cuesta Θ(n + 100), sin comparar elementos entre sí. No viola la cota: lee el valor y lo usa como índice, que es algo que un comparador no puede hacer. A cambio, necesita saber de antemano el rango de valores. El ejercicio 8 les pide escribirlo.
Qué usan las bibliotecas
Lo que garantiza el estándar
| Función | Qué garantiza C++20 | Requiere |
|---|---|---|
std::sort |
O(N log N) comparaciones. No garantiza estabilidad | Iteradores de acceso aleatorio |
std::stable_sort |
Estable. N log N comparaciones si hay memoria extra; si no, a lo sumo N log² N | Iteradores de acceso aleatorio |
std::lower_bound |
A lo sumo log₂ N + O(1) comparaciones | Rango partido respecto del valor buscado |
Estas son las garantías del estándar. El estándar no dice qué algoritmo usar. Por eso tampoco dice, por
ejemplo, que std::sort
sea quicksort. std::sort y std::stable_sort tampoco funcionan sobre una lista enlazada: necesitan saltar a cualquier posición, y por eso
std::list tiene su propia función miembro sort, estable, que reenlaza nodos sin mover los elementos.
En la biblioteca. Esto es específico de libstdc++ 14, la biblioteca de g++ que usamos, y se puede leer en
bits/stl_algo.h.std::sortes introsort: un quicksort con pivote elegido entre tres (la mediana de tres candidatos) que cuenta la profundidad y, si pasa de 2 ⌊log₂ n⌋, cambia a heapsort para ese rango. Eso asegura O(n log n) aun en el peor caso. Deja los rangos de hasta 16 elementos sin ordenar, y al final pasa un ordenamiento por inserción.std::stable_sortes mergesort con un buffer temporal, que usa un método en el lugar, más lento, si no consigue memoria. Otra biblioteca podría hacerlo distinto, cumpliendo lo mismo.
Volvamos a la tabla de tiempos. Con datos al azar, std::sort le ganó a nuestros tres quicksorts. No hay magia: tiene
las mismas ideas, con cuidado en los detalles. Y en la práctica la regla es simple: usen std::sort, y
std::stable_sort si importan los
empates o si ya vienen en un orden útil. Se escribe un ordenamiento propio para entender cómo funcionan, y en
casos muy especiales.
Comparadores
Un comparador (comparator) es lo que responde “¿a va antes que b?”. Se puede pasar de varias maneras, y todas
compilan a lo mismo desde el punto de vista de std::sort, que es un template: recibe “algo que se puede llamar
con dos
elementos y devuelve bool”. Ya conocen la idea, de qsort y sus punteros a función en C. Aquí no hay void *, y
el compilador conoce el tipo.
bool by_text(const Term& a, const Term& b) {
    return a.text < b.text;
} std::sort(terms.begin(), terms.end(), by_text);
std::sort(terms.begin(), terms.end(), [](const Term& a, const Term& b) {
if (a.weight != b.weight) {
return a.weight > b.weight;
}
return a.text < b.text;
});
std::sort(values.begin(), values.end(), std::greater<int>());El segundo es una lambda con parámetros, como las de la semana 3, pero con [], porque no usa nada de
alrededor. Ordena
de mayor a menor frecuencia y, en los empates, por texto: es la manera de escribir varias claves en un solo
comparador.
El tercero es un objeto de la biblioteca que aplica >.
$ build/comparators
por texto: arequipa(90) cusco(90) lima(40) puno(40) tacna(95)
por frecuencia, y texto en los empates: tacna(95) arequipa(90) cusco(90) lima(40) puno(40)
de mayor a menor: 3 2 1
lower_bound de lima: lima en la posición 2
Una lambda también puede capturar una variable por referencia y contar. Así se obtuvieron las columnas
std::sort y stable de la
tabla de comparaciones, y así las pruebas del laboratorio miden sus ordenamientos sin tocar su código:
    std::sort(items.begin(), items.end(), [&comparisons](int a, int b) {
        comparisons++;
        return a < b;
    });
El comparador tiene que ser un orden estricto
std::sort exige un orden débil estricto (strict weak ordering). En palabras simples, debe comportarse como el
<:
- Nada va antes que sí mismo:
comp(a, a)es falso. - Si
ava antes quebybantes quec,ava antes quec. - Si
aybson equivalentes (ninguno va antes que el otro), ybyctambién,ayctambién lo son.
<= viola la primera regla. Parece inofensivo, y no lo es: el estándar no promete nada, porque es comportamiento
indefinido. Con 100 elementos iguales, en esta corrida:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/bad_comparator.cpp -o build/bad_comparator
$ build/bad_comparator
==34312==ERROR: AddressSanitizer: heap-buffer-overflow on address 0x5140000001d0 at pc 0xaaaaac5bb254 bp 0xffffd2c74730 sp 0xffffd2c74748
READ of size 4 at 0x5140000001d0 thread T0
...
    #6 0xaaaaac5b9538 in main errors/bad_comparator.cpp:8
...
0x5140000001d0 is located 0 bytes after 400-byte region [0x514000000040,0x5140000001d0)
std::sort leyó fuera del arreglo. La causa, en libstdc++, es razonable: su partición avanza “mientras el elemento vaya
antes que el pivote”, sin revisar si se acabó el rango, contando con que el comparador dirá que no al llegar a un elemento
igual. Con <= nunca dice que no.
Error común. Escribir
return a.weight >= b.weight;para ordenar de mayor a menor. Funciona con pocos elementos, y revienta con muchos iguales. Se escribe>.
Búsqueda binaria con invariante
Ahora cobramos la inversión. En un arreglo ordenado, una comparación con el elemento del medio descarta la mitad.
La búsqueda binaria es famosa por lo fácil que es equivocarse. La receta para no hacerlo es dejar de pensar en “encontrar x” y empezar a pensar en la pregunta que siempre tiene respuesta:
Definición. Dado un arreglo ordenado, la búsqueda del límite inferior (lower bound) de x devuelve la posición del primer elemento mayor o igual a x, o n si no hay ninguno.
Esa posición siempre existe, esté x o no. Es también el lugar donde habría que insertar x para mantener el orden. Y la invariante se escribe sola:
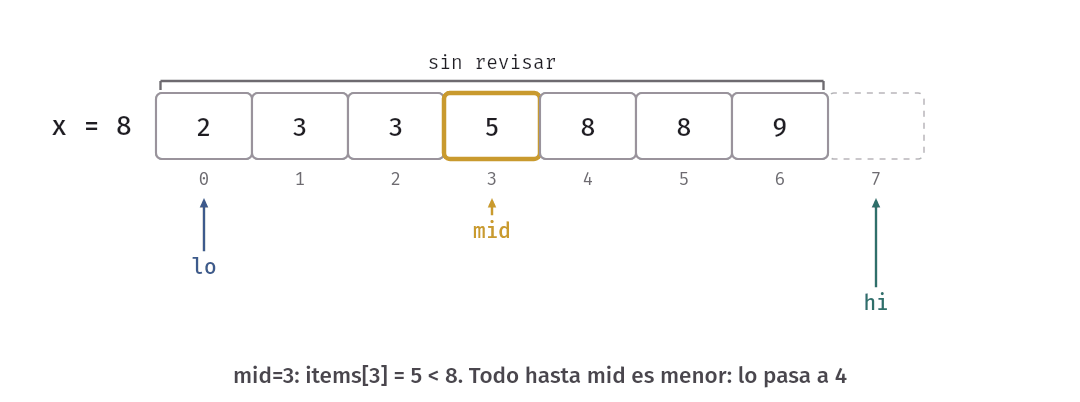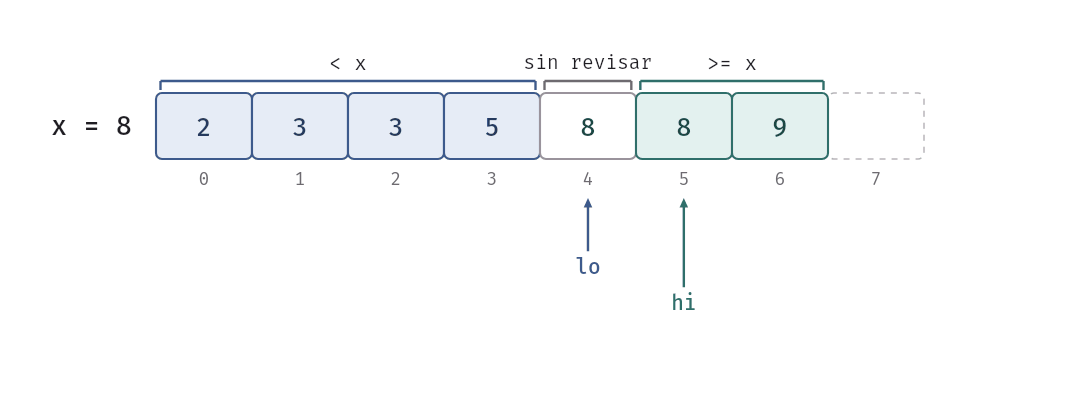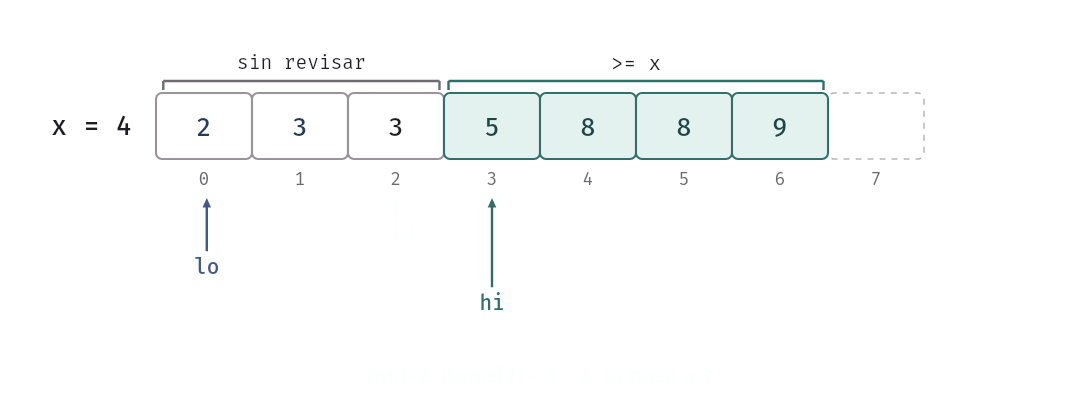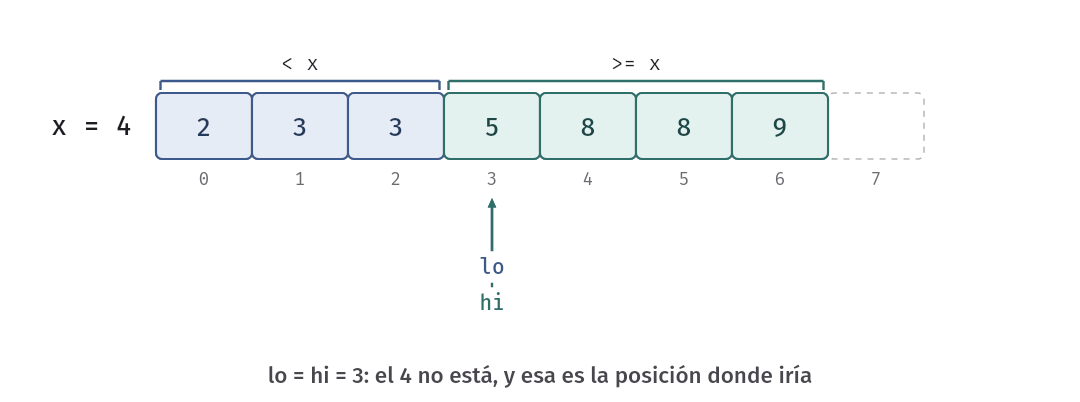
Invariante. Todo lo que está en [0, lo) es menor que x. Todo lo que está en [hi, n) es mayor o igual a x.
inline std::size_t lower_bound_index(const std::vector<int>& items, int x, long long& probes) {
    std::size_t lo = 0;
    std::size_t hi = items.size();
    // Invariante: todo en [0, lo) es < x, y todo en [hi, n) es >= x.
    while (lo < hi) {
        std::size_t mid = lo + (hi - lo) / 2;
        probes++;
        if (items[mid] < x) {
            lo = mid + 1;
        } else {
            hi = mid;
        }
    }
    return lo;
}
Cada línea sale de la invariante, y se comprueba en los mismos tres momentos de siempre:
- Al inicio.
lo = 0yhi = n: las dos zonas están vacías. - En cada paso. Si
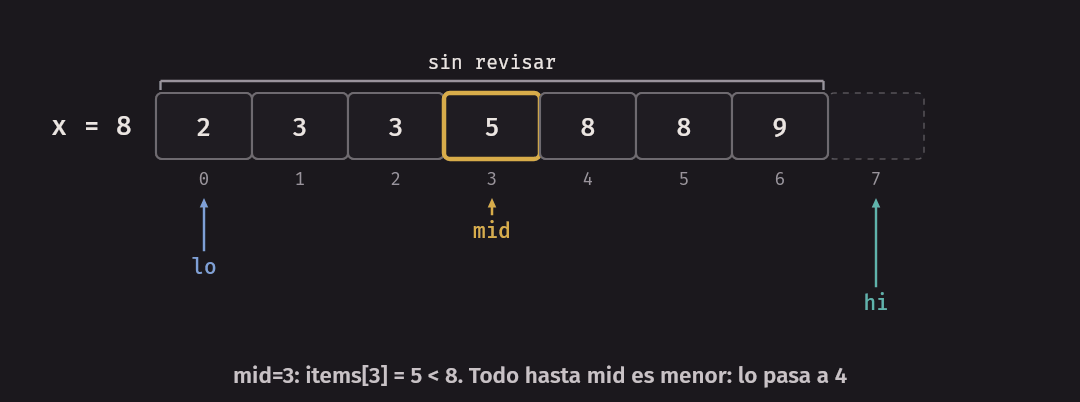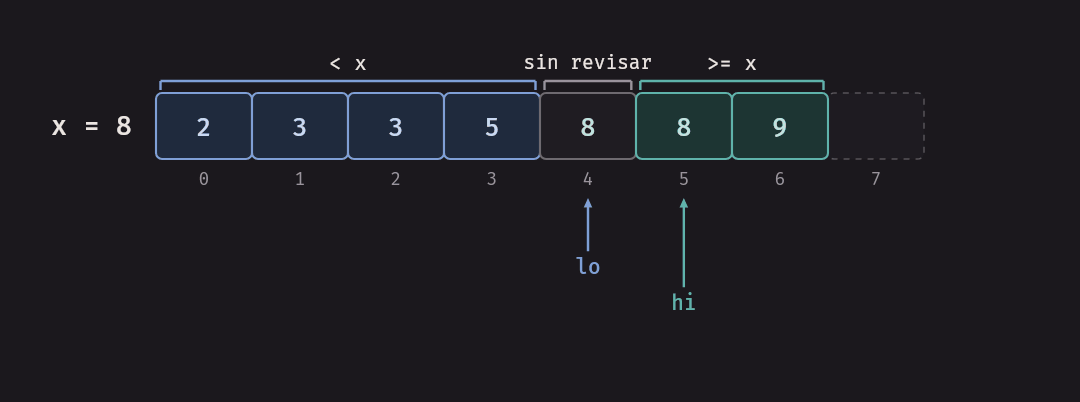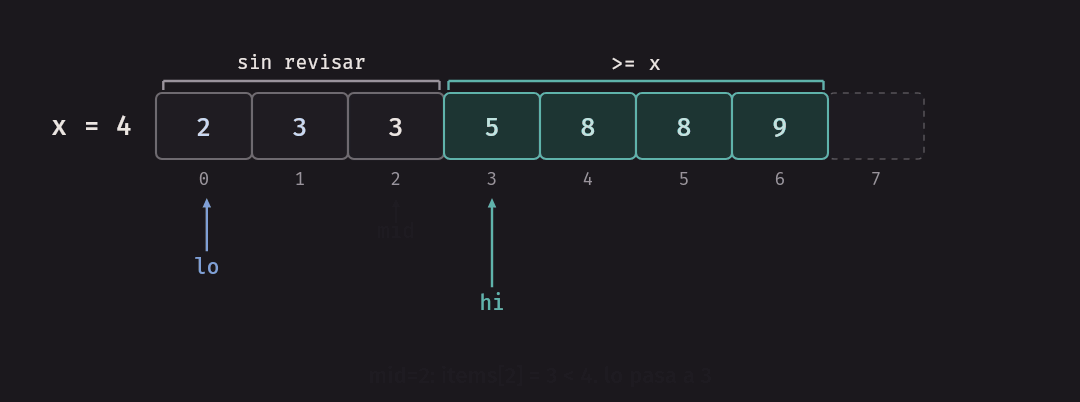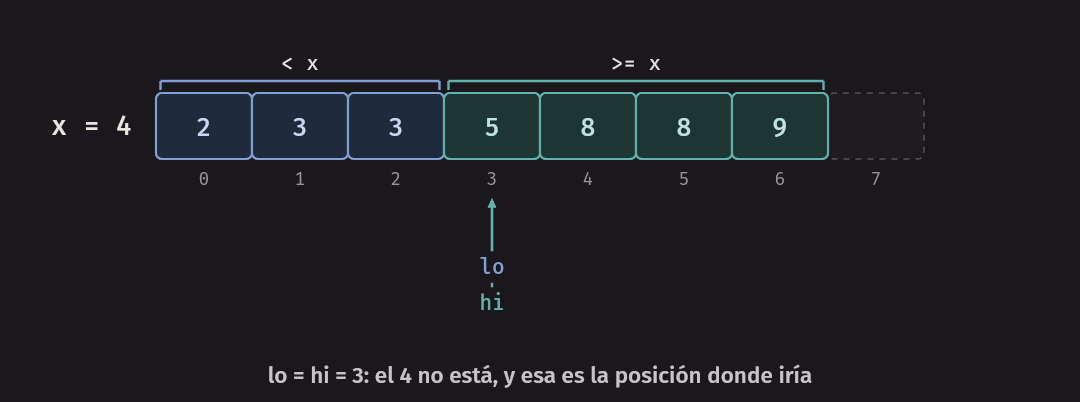
items[mid] < x, entonces, como el arreglo está ordenado, todo hastamides menor que x: se puede ponerlo = mid + 1. Si no,items[mid]y todo lo que le sigue es mayor o igual, así que se puede ponerhi = mid. Noten la asimetría: en el primer casomidqueda en la zona izquierda, y por esolopasa amid + 1. En el segundo queda en la zona derecha, que empieza justo enhi. - Al final. El ciclo termina cuando
lo == hi. La zona sin revisar está vacía, y las dos zonas se tocan.loes justamente el primero que es mayor o igual a x. No hay que hacer ningún caso aparte, ni para el arreglo vacío, ni para x mayor que todos.
¿Por qué termina? Mientras lo < hi, se cumple lo <= mid < hi. Por eso lo = mid + 1 aumenta lo, y
hi = mid disminuye hi.
En cada vuelta, el rango hi - lo se reduce por lo menos a la mitad, redondeando hacia abajo. Tras a lo sumo ⌊log₂
n⌋ + 1 vueltas llega a 0.
$ build/trace_search
x = 8
  lo=0 hi=7 mid=3 items[mid]=5 < x
  lo=4 hi=7 mid=5 items[mid]=8 >= x
  lo=4 hi=5 mid=4 items[mid]=8 >= x
  termina con lo=hi=4
x = 4
  lo=0 hi=7 mid=3 items[mid]=5 >= x
  lo=0 hi=3 mid=1 items[mid]=3 < x
  lo=2 hi=3 mid=2 items[mid]=3 < x
  termina con lo=hi=3
x = 10
  lo=0 hi=7 mid=3 items[mid]=5 < x
  lo=4 hi=7 mid=5 items[mid]=8 < x
  lo=6 hi=7 mid=6 items[mid]=9 < x
  termina con lo=hi=7
El arreglo es 2 3 3 5 8 8 9. Con x = 8 hay dos candidatos, y devuelve el primero: en el segundo paso encontró
un 8 y no se detuvo, porque
podría haber otro antes. Con x = 4, que no está, devuelve 3, donde iría. Con x = 10 devuelve 7, que es n, y es la
respuesta correcta. Para saber si x está, hay que revisar además si lo < n y si items[lo] == x.
Dos errores clásicos
El overflow en el punto medio. (lo + hi) / 2 es correcto en matemáticas. En un int, la suma puede
pasarse de 2 147 483 647. Este programa
busca en un rango de dos mil millones, sin arreglo real, sobre una función:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/midpoint_overflow.cpp -o build/midpoint_overflow
$ timeout 2 build/midpoint_overflow
errors/midpoint_overflow.cpp:18:23: runtime error: signed integer overflow: 1000000001 + 2000000000 cannot be represented in type 'int'
UBSan lo avisa. Sin eso, el comportamiento es indefinido; en esta corrida el programa tampoco termina, y timeout
lo cortó a los 2 segundos.
lo + (hi - lo) / 2 calcula lo mismo sin pasar nunca de hi.
Seamos honestos con el alcance: con std::size_t, de 64 bits en esta máquina, lo + hi no va a hacer overflow sobre
un arreglo real. El problema aparece al usar int para los índices, o std::uint32_t para ahorrar memoria. La
versión con la resta es igual de corta, y funciona en todos los
casos, así que no hay razón para escribir la otra. C++20 también trae std::midpoint, en <numeric>.
El ciclo que no termina. Sucede cuando el rango no se reduce. El caso típico es poner lo = mid:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/stuck_search.cpp -o build/stuck_search
$ timeout 2 build/stuck_search; echo "código de salida: $?"
lo=0 hi=4 mid=2
lo=2 hi=4 mid=3
lo=3 hi=4 mid=3
lo=3 hi=4 mid=3
código de salida: 124
Con hi - lo == 1, mid vale lo, y lo = mid no cambia nada. El programa queda en ese estado para siempre,
hasta que timeout lo corta, con el código 124.
Error común. Mezclar convenciones. La nuestra es
[lo, hi), conhi = midylo = mid + 1, y condiciónlo < hi. Otra válida es[lo, hi], conhi = mid - 1,lo = mid + 1y condiciónlo <= hi; pero constd::size_t,mid - 1da la vuelta cuandomid == 0. Escojan una, escriban su invariante, y al cambiar cualquier línea revisen los tres momentos. Y siempre prueben con arreglos vacíos, de uno y de dos elementos.
std::lower_bound y sus parientes
La biblioteca ya la tiene. Devuelve un iterador, y se le puede pasar un comparador:
    auto found = std::lower_bound(terms.begin(), terms.end(), wanted,
                                  [](const Term& term, const std::string& x) { return term.text < x; });
Noten el orden de los parámetros: primero el elemento y después el valor buscado, porque la pregunta es “¿este
elemento va
antes que x?”. Por eso los tipos pueden ser distintos. std::upper_bound da el primero mayor que x, y
std::equal_range da
los dos, de modo que upper - lower es cuántas veces aparece x.
Veamos cuánto rinde, con el diccionario de 1 045 757 palabras. log₂ 1 045 757 ≈ 19.996:
$ build/word_search ../../data/palabras.txt casa rodillas árbol desta
1045757 palabras; ordenado por bytes: sí
casa       20 comparaciones, está
rodillas   20 comparaciones, no está; la siguiente es rodillazo
árbol     20 comparaciones, está
desta      20 comparaciones, no está; la siguiente es destaca
Una búsqueda lineal revisaría cientos de miles de palabras. Dos de estos resultados son límites de los datos, no
del algoritmo: rodillas es una palabra
normal que falta en este diccionario, y desta es una grafía antigua que aparece en los libros de donde salen los
términos del laboratorio.
Idea clave. La búsqueda binaria no necesita de verdad un arreglo ordenado por x. El estándar pide algo más débil: que el rango esté partido respecto de la pregunta, primero todos los que responden “sí” y después todos los que responden “no”. Cualquier pregunta con esa forma se puede responder con Θ(log n) preguntas. Es lo que van a usar en el laboratorio: la segunda búsqueda no pregunta por un valor, sino por algo que se puede decidir mirando solo el comienzo de cada término.
std::partition_pointes la versión de la biblioteca de esa idea general.
Bytes, UTF-8 y orden
Falta una trampa, y es específica de nuestros datos. std::string guarda bytes, y UTF-8 usa más de un byte para
las letras con tilde y la ñ:
$ build/byte_order_unsigned ../../data/terminos.tsv | head -4
a = 61, size() = 1
á = c3 a1, size() = 2
ñ = c3 b1, size() = 2
z = 7a, size() = 1
Eso tiene tres consecuencias:
size()cuenta bytes, no letras:ámide 2. Si recorren una palabra con un ciclo sobrechar, parten laáen dos pedazos.- Una comparación de
std::stringcompara bytes, sin signo. Como0xC3es mayor que cualquier letra sin tilde, toda palabra que sigue con tilde o con ñ queda después de las que siguen con una letra simple. - En particular,
árbolyñandúvan después dezorro.
No es orden alfabético
$ build/byte_order_unsigned ../../data/terminos.tsv | sed -n '5,7p'
char con signo: no
con std::string: cama cazar caña cámara zorro árbol ñandú
char por char : cama cazar caña cámara zorro árbol ñandú
Un diccionario pondría cámara junto a cama, y caña antes de cazar. Aquí no. Lo mismo pasa con
palabras.txt: aunque se diga “en orden alfabético”, lo que tiene es
orden de bytes, como confirma la línea ordenado por bytes: sí de la salida anterior, y por eso se puede buscar en
él con std::string.
Para nuestro propósito, el orden de bytes tiene una virtud enorme: todos los términos que empiezan con los mismos bytes quedan contiguos. No es lo que un lector esperaría, pero es un orden total, se calcula rápido, y funciona para buscar. Ordenar como un diccionario español requiere reglas de cotejo (collation), que no vamos a ver.
Rangos de prefijos
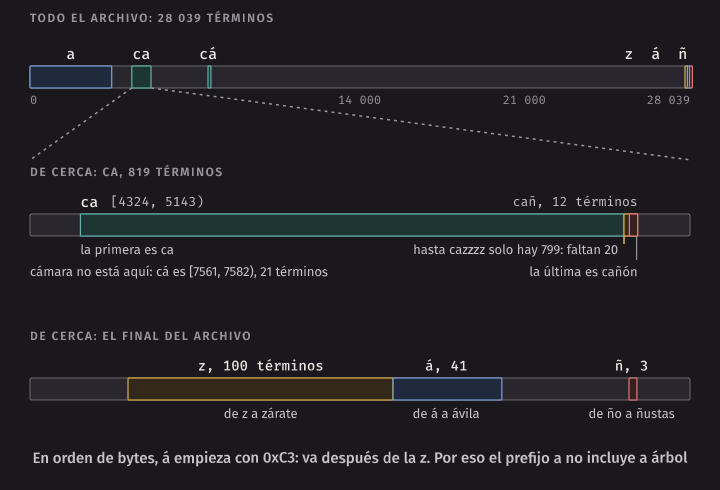
Decir “empieza con” también significa bytes. Este programa revisa todo el archivo ordenado, sin búsqueda binaria, y dice dónde están los términos que empiezan con cada prefijo:
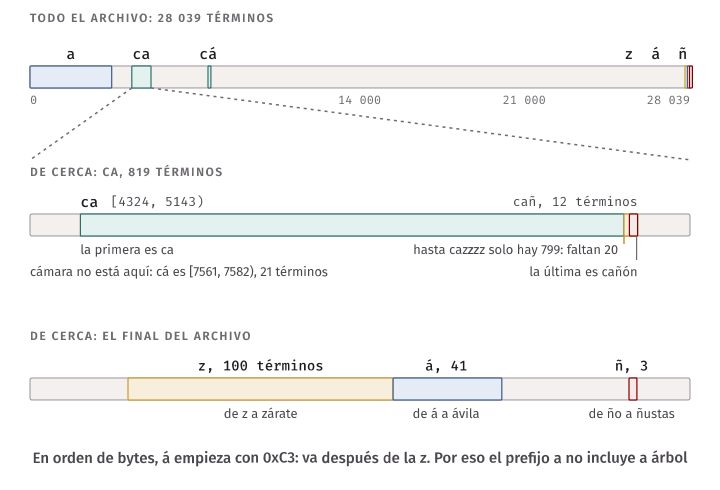
$ build/byte_order_unsigned ../../data/terminos.tsv | sed -n '8,14p'
a     3471 términos en [0, 3471): de a a aún
á      41 términos en [27927, 27968): de á a ávila
ca     819 términos en [4324, 5143): de ca a cañón
cá     21 términos en [7561, 7582): de cádiz a cáñamo
cañ    12 términos en [5131, 5143): de caña a cañón
z      100 términos en [27827, 27927): de z a zárate
ñ       3 términos en [28016, 28019): de ño a ñustas
(Las columnas se corren un lugar en las filas con tilde. printf cuenta bytes al rellenar, otra vez.)
Lean con cuidado:
ano incluye aárbol. Son 3471 términos, yáes otro rango con 41, casi al final del archivo. Lo mismo concaycá:cámaraestá en otro lado.- Cada rango es contiguo, y por eso una búsqueda binaria lo puede encontrar. Fíjense que
cañtermina en 5143, igual queca. caincluye acañón, y lo deja al final, después decazosy de todo lo que sigue conz. Yatermina enaún, después de todas las palabras conaz.
Esa última línea es la trampa de implementar el rango “hasta el último que empieza con lo mismo seguido de zzz”:
$ build/byte_order_unsigned ../../data/terminos.tsv | tail -1
entre ca y cazzzz: 799 términos
Faltan 20 de los 819: las palabras que siguen con ñ o con una vocal con tilde, como cañón y caía, se pierden
sin que nada falle. Tampoco funciona bien “sumarle 1 al último byte”,
que hace overflow en casos extremos y que obliga a pensar en bytes con signo. La pregunta correcta se hace sobre el
comienzo de cada término, no sobre un valor inventado: compare(0, n, prefijo)
compara los primeros n bytes de un std::string con otro.
¿Y un prefijo cortado a la mitad de una letra, como el primer byte de á? Como hablamos de bytes, tiene una
respuesta precisa: es el rango de todos los términos que empiezan
con ese byte, que incluye a á, é, í, ñ, ó y ú. No es lo que un usuario pediría, y tampoco es un error.
Las pruebas del laboratorio fijan esa conducta, para que no sea un accidente.
Idea clave. Este autocompletado busca por bytes. Es correcto en ese sentido, y lo prueban contra un oráculo. Pero escribir
cano ofrececámara, y escribirano ofreceárbol. Para eso hay que ordenar por una versión de la palabra sin tildes. Ese es el ejercicio 11. Lo importante es saber qué hace su programa, y decirlo.
El signo de char
Hay una última sorpresa. En C++, char puede tener signo o no: es una decisión de cada plataforma. En Linux con
g++, en x86-64 tiene signo, y en ARM de 64 bits, como el contenedor de esta máquina, no.
Compilamos el mismo programa de las dos maneras, para que el ejemplo no dependa de su máquina:
$ build/byte_order_signed ../../data/terminos.tsv | sed -n '5,7p'
char con signo: sí
con std::string: cama cazar caña cámara zorro árbol ñandú
char por char : árbol ñandú cámara caña cama cazar zorro
La segunda línea es la misma en las dos compilaciones, porque comparar std::string no depende del signo de
char. La tercera no, porque usa este comparador:
bool less_by_char(const std::string& a, const std::string& b) {
    std::size_t common = std::min(a.size(), b.size());
    for (std::size_t i = 0; i < common; i++) {
        if (a[i] != b[i]) {
            return a[i] < b[i];
        }
    }
    return a.size() < b.size();
}
Si char tiene signo, 0xC3 vale −61, así que á queda antes que a. El comparador sigue siendo un orden
válido, pero es otro. Ordenar con él y buscar con < produce búsquedas equivocadas, y encima
el programa funciona en un contenedor sobre una laptop ARM y falla en un Codespace con x86-64.
En C++. El estándar dice que
char_traits<char>::ltse comporta como<sobreunsigned char. Por esooperator<ycomparedestd::stringdan el mismo orden de bytes en todas las máquinas, y ni ellas nistarts_withdependen del signo dechar. Usen esas operaciones y no comparencharporchar. Por lo mismo,make test-labcorre las pruebas de la sesión 2 también compiladas con-fsigned-char.
El código de la semana
En code/week-06:
| Archivo | Qué contiene |
|---|---|
int_sorts.h |
Mergesort, los tres quicksorts y la búsqueda binaria de la clase, para enteros, con contadores |
inputs.h |
Las entradas de las mediciones, con semilla fija |
trace_merge.cpp, trace_partition.cpp, trace_search.cpp |
Los paso a paso de este capítulo |
count_sorts.cpp |
Las tablas de comparaciones |
time_sorts.cpp, bench.h |
Las mediciones, con -O2 y sin sanitizers |
stability.cpp |
La estabilidad con el archivo de términos |
comparators.cpp |
Comparadores y std::lower_bound |
word_search.cpp |
Búsqueda en el diccionario, contando comparaciones |
byte_order.cpp |
El orden de bytes, el signo de char y los rangos de prefijos |
test_examples.cpp |
Pruebas de int_sorts.h: casos dirigidos y al azar, contra la biblioteca |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo, y eso incluye volver a correr los comandos de este capítulo: si un
ejemplo dejara de dar lo que dice el texto, la prueba falla.
Las mediciones de tiempo no se comparan, porque dependen de la máquina. Sí se revisan los conteos, que deben
repetirse.
Los programas que usan datos reciben la ruta como argumento. Los Makefile tienen DATA ?= ../../data, y lo
pueden cambiar si sus datos están en otro lugar.
El laboratorio: autocompletado
En la sesión 1 escribirán merge_sort, quick_sort y slow_input en lab/sorts.h. En la sesión 2,
sort_by_text, prefix_range, top_k y top_k_scan en lab/autocomplete.h. Ya vienen hechos el
quicksort con pivote fijo (lab/fixed_pivot.h), la carga del archivo (lab/terms_io.h), un programa para probar
de mano (build/lab/autocomplete) y los dos programas de medición. Cada función sin hacer detiene el programa con
un mensaje
que dice cuál falta.
make test-sorts          # solo la sesión 1
make test-autocomplete   # solo la sesión 2
make test-lab            # todo
make bench-sorts         # la tabla de la sesión 1, con -O2 y sin sanitizers
make bench-query         # la tabla de la sesión 2
build/lab/autocomplete ../../data/terminos.tsv ca 5
Algunas cosas que conviene saber antes de empezar:
- Las pruebas no miden tiempos: cuentan. Cuentan comparaciones con un comparador que incrementa un contador,
copias con un tipo instrumentado, y lecturas del arreglo de términos con un wrapper. Por eso
prefix_rangey las otras son templates: reciben “algo consize()yoperator[]”. Usen índices. merge_sortdebe ser estable y no copiar.Tno siempre tiene constructor por defecto: el buffer se arma conreserveypush_back, y se usastd::move, que es lo que importa cuando se ordenan cadenas.quick_sortusa pivote al azar y partición en tres. Una prueba cuenta que con todos iguales haga una sola pasada.- La prueba de oro de
prefix_rangees un oráculo. Compara contra una revisión completa constarts_with, con prefijos cortados por bytes. - Los empates de
top_kvan por texto. Piensen en qué propiedad de qué ordenamiento les da eso sin escribir nada más. top_k_scanno puede cortar antes. Es la línea de base con la que se compara. Si corta al juntar k resultados, además de dar otra respuesta, no mediría lo que queremos saber.
Al final, lab/report.md les pide responder con sus propios números: qué entrada hace lento al pivote fijo, y con
qué prefijos gana de verdad la búsqueda binaria. No den por hecho que gana con todos. Midan.
Resumen
- Mergesort divide por la mitad, ordena cada lado y mezcla. Tiene log₂ n niveles con n de trabajo cada uno: Θ(n log n) siempre. Necesita un buffer de n elementos, y es estable si en los empates toma el de la izquierda.
- Quicksort parte alrededor de un pivote, que queda en su lugar definitivo, y ordena cada lado. No necesita buffer. Promedio Θ(n log n), con unas 1.39 n log₂ n comparaciones, y peor caso Θ(n²).
- Con el primer elemento como pivote, una entrada ya ordenada cuesta exactamente n(n − 1)/2 comparaciones, y la recursión llega a n niveles, que pueden agotar la pila.
- El pivote al azar hace que el costo esperado no dependa del orden de la entrada, pero no resuelve los empates. La partición en tres sí: con todos iguales hace una pasada. Cuesta más comparaciones con datos distintos.
- Un ordenamiento es estable si los elementos equivalentes conservan su orden. Importa al ordenar por una clave, y permite ordenar por varias claves en pasos sucesivos.
- Cualquier ordenamiento por comparación hace Ω(n log n) comparaciones en el peor caso, porque debe distinguir n! órdenes y cada respuesta da un bit. Quien usa los datos de otra manera, como contar enteros chicos, no está sujeto a esa cota.
std::sortgarantiza O(N log N), pero no estabilidad;std::stable_sortes estable. En libstdc++ son introsort y mergesort con buffer, pero eso no lo pide el estándar. El comparador debe ser un orden estricto:<=es comportamiento indefinido.- La búsqueda binaria se escribe desde una invariante:
[0, lo)es menor que x, y[hi, n)es mayor o igual. El ciclo termina cuandolo == hi, y ahí está el primero que es mayor o igual a x. Cuesta a lo sumo ⌊log₂ n⌋ + 1 revisiones. Usenlo + (hi - lo) / 2, y asegúrense de que el rango siempre se reduzca. std::stringcompara bytes sin signo. Las palabras con tilde quedan en otro lugar, ycano incluye acámara. Compararcharporcharda otro orden en una máquina dondechartiene signo.
Ejercicios
- Dibujen el árbol de llamadas de mergesort para n = 11 con la regla
mid = lo + (hi - lo) / 2. ¿Cuántos niveles hay? ¿Cuántos elementos se copian en cada uno? Comprueben adaptandotrace_merge.cpp. - Hagan a mano la partición de
4 7 1 9 2 8 3con el primer elemento como pivote. Escriban la tabla descan,boundaryy el arreglo. ¿Dónde queda el pivote? Comprueben adaptandotrace_partition.cpp. - Den tres entradas distintas de 6 elementos que hagan que un quicksort con el primer elemento como pivote haga 15 comparaciones. ¿Pueden dar una que haga el mínimo? ¿Cuánto es ese mínimo?
- ¿Es estable el ordenamiento por inserción de este capítulo? ¿Y uno por selección, que busca el mínimo y lo intercambia con el primero, y sigue con el resto? Den un ejemplo, o una justificación, para cada uno.
- Escriban la búsqueda del primer elemento mayor que x. Escriban primero la invariante, y den los tres
argumentos. ¿Qué línea cambia con respecto a
lower_bound_index? Pruébenla contrastd::upper_boundcon semilla fija. - Con su búsqueda y con
lower_bound_index, escriban una función que cuente en O(log n) cuántas veces aparece x en un arreglo ordenado. ¿Cuántas revisiones hace como máximo? - Cada uno de estos cambios a
lower_bound_indexlo daña. Digan qué pasa, sin correrlo, y comprueben después contimeout: a)while (lo <= hi); b)hi = mid - 1; c)lo = mid; d)if (items[mid] <= x). - Escriban
counting_sort(std::vector<int>&, int max_value)para enteros entre 0 ymax_value, sin comparar elementos entre sí. Cuenten sus operaciones contramerge_sort_intscon n = 1 000 000 ymax_value= 100. ¿Por qué no viola la cota Ω(n log n)? ¿Qué pasa conmax_value= 10⁹? merge_sort_intscopia dos veces cada elemento en cada nivel. Reescriban la mezcla alternando los papeles deitemsybufferen cada nivel, de modo que cada elemento se copie una vez por nivel. Midan contime_sorts.cpp, en 3 corridas, si la diferencia conq.azarse reduce. ¿Qué pueden afirmar?- Una entrada de “órgano” sube y luego baja:
0 1 2 … 2 1 0. Agreguen esa fila acount_sorts.cppy expliquen qué le pasa a cada columna. ¿Hay alguna entrada que sea mala paraq.azarcon esta semilla y con cualquier otra? - Hagan un autocompletado que ofrezca
cámaraal escribirca. Agreguen aTermuna clavefoldedsin tildes (usen una función que cambieápora, y lo demás, pero que deje lañ). Ordenen y busquen porfolded, y muestrentext. ¿Qué ocurre con los términos que quedan iguales después de quitar las tildes, y cómo usarían la estabilidad? top_kordena todo el rango aunque solo quiera 5. Escriban una versión que recorra el rango y mantenga un arreglo ordenado con los mejores k hasta el momento. ¿Cuánto cuesta en función de m (tamaño del rango) y de k? Mídanla con el prefijo vacío y cona. Compárenla constd::partial_sort. (En la semana de heaps verán una estructura hecha para esto.)