Apuntes · Capítulo 7Diccionarios
Tablas hash
Tablas hash
La semana pasada, con un arreglo ordenado y búsqueda binaria, encontrar una palabra entre un millón tomaba unas 20 comparaciones. Es un resultado excelente, y tiene un precio: para mantener el orden, insertar una palabra nueva obliga a mover en promedio la mitad del arreglo. Si los datos cambian todo el tiempo, Θ(n) por inserción no sirve.
Hoy buscamos otra cosa. Queremos guardar, buscar y borrar por clave en un número de pasos que no dependa de cuántas claves hay. Suena imposible, porque la búsqueda binaria parece el límite. No lo es, porque la búsqueda binaria solo sabe comparar dos claves, y nosotros vamos a hacer algo que ella no hace: usar la clave para calcular dónde está.
Esa es una tabla hash (hash table). Es, muy probablemente, la estructura de datos más usada en el software real. También tiene letra pequeña, que veremos completa: su costo es un costo esperado, depende de una buena función, y alguien que conozca la función puede obligarla a comportarse como una lista. Sus claves, además, no salen en orden.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): El diccionario, Del arreglo indexado por clave a la función hash, Colisiones: son inevitables y Qué pide una buena función hash.
- En clase: Encadenamiento, El factor de carga, Crecer, El peor caso sigue siendo Θ(n),
std::unordered_mapystd::hash, Error común: modificar una clave que ya está en la tabla y ¿Tabla hash o arreglo ordenado?.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de la semana. Opcional: Open Data Structures, secs. 5.1 (ChainedHashTable) y 5.3 (Hash Codes); CLRS, capítulo Hash Tables, 4.ª edición.
Código. Los programas de este capítulo están en
code/week-07. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
El diccionario
Empecemos por lo que queremos hacer, sin decir cómo. Un diccionario (dictionary, también llamado map) es un tipo abstracto de datos que guarda pares (clave, valor), con claves que no se repiten.
Definición. Un diccionario ofrece estas operaciones:
| Operación | Qué hace |
|---|---|
set(k, v) |
Si la clave k no está, agrega el par (k, v). Si ya está, reemplaza su valor por v |
get(k) |
Devuelve el valor de k, o avisa que no está |
contains(k) |
Dice si k está |
remove(k) |
Saca el par de k. Avisa si estaba |
size() |
Cuántos pares hay |
Como en la semana 2, el tipo abstracto dice qué se puede hacer, no cómo. Hay muchas representaciones posibles, y este curso dedica varias semanas a compararlas.
Ya usaron uno. En Introducción a la Programación, el intérprete tenía una tabla de variables, Env. Cuando el
programa decía x = 3, el intérprete guardaba el valor 3 con la clave "x". Cuando después leía x + 1,
buscaba "x". Esa tabla se la dimos hecha, y la usaron solo por su encabezado: un buen ejemplo de para qué
sirve un tipo abstracto. En el laboratorio de hoy la construyen ustedes.
Hay diccionarios en todas partes: la libreta de contactos del celular (nombre → número), el DNS (nombre → IP), los campos de un objeto en Python o JavaScript (nombre → valor), un contador de palabras (palabra → cuántas veces), una cache (pregunta → respuesta ya calculada).
Lo que ya sabemos hacer
Con lo visto hasta ahora, tenemos tres representaciones. Con n claves, sus costos son:
| Representación | get |
set de una clave nueva |
remove |
|---|---|---|---|
| Arreglo sin orden | Θ(n) | Θ(n), hay que ver que no esté | Θ(n) |
| Lista enlazada | Θ(n) | Θ(n), hay que ver que no esté | Θ(n) |
| Arreglo ordenado | Θ(log n) | Θ(n), hay que abrir un hueco | Θ(n) |
Observen la columna de set. Aunque insertar al final de un arreglo cueste O(1), un diccionario no puede
repetir claves: antes de insertar hay que buscar. Por eso nada baja de Θ(n). Hoy vamos a llegar a O(1) esperado
en las tres columnas.
Del arreglo indexado por clave a la función hash
Hay un caso en el que un diccionario es trivial. Supongamos que las variables del intérprete se llaman con una sola letra minúscula. Entonces basta un arreglo de 26 casillas, y la clave se convierte directamente en el índice:
algoritmo guardar(valores, letra, v)
    valores[codigo(letra) - codigo('a')] ← v
fin algoritmo
Guardar y buscar son Θ(1), sin ninguna comparación de claves. Esto se llama tabla de acceso directo (direct-address table): la clave es la posición. Funciona porque hay pocas claves posibles.
Ahora tomemos los nombres de verdad. Una clave de 10 bytes tiene 256¹⁰ valores posibles, unos 1.2 × 10²⁴. No existe una memoria para ese arreglo. Y sería un desperdicio absurdo, porque un programa usa unas decenas de variables, y un diccionario del español, cerca de un millón de palabras.
La salida es separar dos cantidades que hasta ahora estaban juntas: el universo de claves posibles, enorme, y las claves que de verdad hay, n. Reservamos un arreglo proporcional a n, y usamos una función que traduzca cada clave a una posición de ese arreglo.
Definición. Una función hash (hash function) h recibe una clave y devuelve un número. Una tabla hash
es un arreglo de m casillas (slots) en el que la clave k se guarda en la casilla h(k) mod m.
Son dos pasos, y conviene distinguirlos:
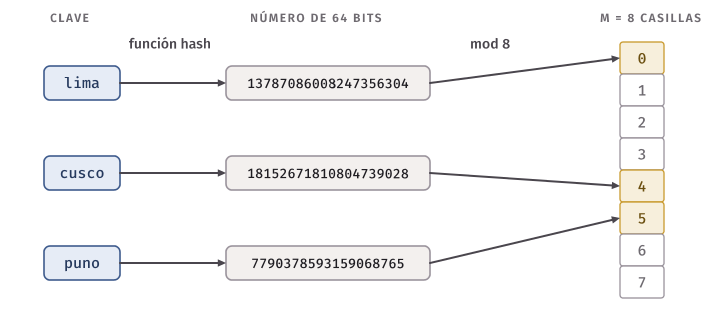
La función hash no conoce el tamaño de la tabla: convierte cualquier clave en un número grande, siempre el mismo para la misma clave. El módulo adapta ese número a la tabla de turno. Esa separación nos va a importar cuando la tabla crezca.
Idea clave. Una búsqueda binaria descarta claves comparándolas. Una tabla hash calcula dónde debería estar la clave, y va directo. Por eso no está sujeta a las Θ(log n) comparaciones de la búsqueda binaria: ni siquiera juega al mismo juego.
Colisiones: son inevitables
Definición. Hay una colisión (collision) cuando dos claves distintas caen en la misma casilla.
¿Podemos elegir una función que las evite? No. Si hay más claves posibles que casillas, y siempre las hay, por el principio del palomar algunas claves distintas caen en la misma casilla. Tampoco ayuda que la función hash dé 64 bits: hay más cadenas posibles que números de 64 bits, así que hasta el número completo se repite alguna vez.
Eso se refiere a las claves posibles. ¿Y las que de verdad están? Si guardamos muchas menos claves que casillas, quizá tengamos suerte. Este programa inserta palabras en orden aleatorio, usando FNV-1a, una función que veremos en un momento, y cuenta cuántas alcanza a meter hasta la primera colisión. Repite el experimento 51 veces con cada m y da la mediana.
$ build/first_collision ../../data/palabras.txt
m           mediana  raiz(m)  repeticiones
1000        33       32       51
100000      381      316      51
1000000     1082     1000     51
10000000    3910     3162     51
Con un millón de casillas, la primera colisión llegó después de unas mil palabras: con la tabla ocupada al 0.1
%. No es mala suerte. Es la paradoja del cumpleaños: en un grupo de 23 personas, lo más probable ya es que dos
cumplan el mismo día, porque lo que crece rápido no es el número de personas sino el de parejas. Con k
claves hay k(k − 1)/2 parejas, y cada una tiene una probabilidad de 1/m de chocar. Cuando k(k − 1)/2 se acerca a
m, es decir, cuando k es del orden de √m, ya es de esperar una colisión. La columna raiz(m) muestra que ese es
el orden que se midió.
Conclusión de diseño: no vale la pena tratar de evitar las colisiones. Hay que vivir con ellas y lograr que cuesten poco. El resto del capítulo responde a dos preguntas: cómo tener pocas (una buena función) y qué hacer con las que quedan (encadenamiento).
Qué pide una buena función hash
Una función hash para una tabla debe cumplir tres cosas.
- Determinista. La misma clave siempre da el mismo número, al menos mientras viva la tabla. Si no, guardamos en una casilla y buscamos en otra.
- Rápida. Se calcula en cada operación. Con una clave de L bytes, cuesta Θ(L): cuando decimos que
getes O(1), estamos contando el largo de la clave como constante. Con claves muy largas, el hash puede ser la parte más cara. - Que reparta bien. Las claves reales deben caer repartidas de manera pareja entre las casillas, como si cada una eligiera su casilla al azar.
La primera se puede escribir con más precisión, y es la regla que no se puede romper:
Idea clave. Si dos claves son iguales, su hash debe ser igual. Lo contrario no se pide: dos claves distintas pueden tener el mismo hash, y eso es una colisión, algo normal. Una función que no cumpla la primera regla da una tabla incorrecta, que pierde datos. Una que reparta mal da una tabla correcta y lenta.
En efecto, la función h(k) = 0 es determinista, rapidísima y correcta: la tabla funciona, con todo en una
sola casilla. Solo que es una lista. La tercera condición es lo que separa una tabla hash de una lista.
Sumar los caracteres, y por qué falla
La primera idea que se le ocurre a casi todo el mundo es sumar los bytes de la clave:
inline std::uint64_t sum_hash(const std::string& key) {
    std::uint64_t hash = 0;
    for (char c : key) {
        hash += static_cast<unsigned char>(c);
    }
    return hash;
}
Es determinista y rápida. Veamos cómo reparte:
$ build/hash_demo
palabra  suma  suma%8  fnv1a             fnv1a%8
amor     431   7       8c778a83af1454b2  2
roma     431   7       a35c141ff0caad88  0
mora     431   7       0d1beba2c400c74c  4
ramo     431   7       6daffc1fd1e8c544  4
ad       197   5       089c3e07b5458e38  0
bc       197   5       08a63507b54dd372  2
lima     419   3       bf5591ad69578b90  0
cusco    541   5       fbeb3ed5bf436bd4  4
Tiene dos defectos, y los dos son de fondo:
- No ve el orden. La suma no cambia al reordenar las letras, así que todo anagrama colisiona:
amor,roma,morayramodan 431, y las cuatro están en el diccionario del curso. Tampoco hace falta ser anagrama:adybctambién coinciden, porque lo que una letra sube, la otra lo baja. - Da números pequeños. Una palabra tiene pocos bytes y cada byte vale a lo sumo 255. Sus sumas caben en unos pocos miles de valores. El hash completo es de 64 bits, pero la suma solo usa una parte mínima de ese espacio.
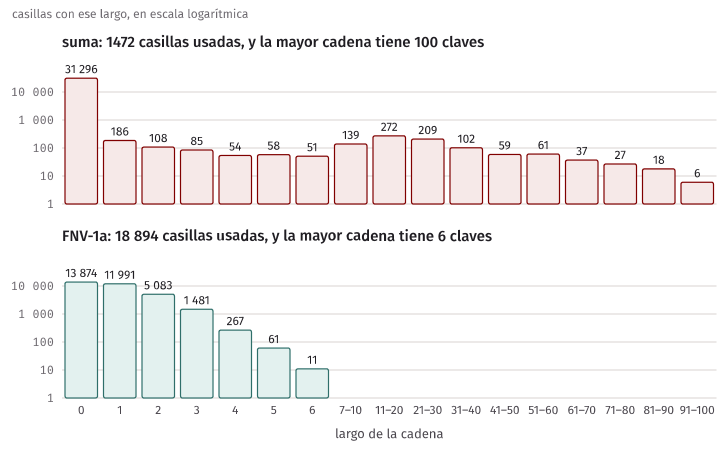
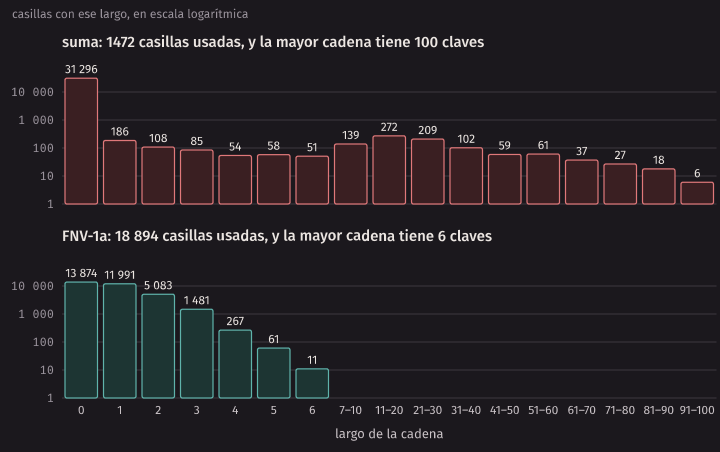
El segundo defecto es el grave. Este programa cuenta las casillas usadas con 28 039 términos reales, sin
construir ninguna tabla. Prueben a leer la columna usadas de las filas suma:
$ build/hash_compare ../../data/terminos.tsv
28039 palabras; la suma da 1472 valores distintos, de 97 a 2212
hash           m   alfa    usadas  la_mayor comp_acierto
suma        1024  27.38      1021       100        21.7
fnv1a       1024  27.38      1024        49        14.7
suma       32768   0.86      1472       100        20.7
fnv1a      32768   0.86     18894         6         1.4
suma     1048576   0.03      1472       100        20.7
fnv1a    1048576   0.03     27642         3         1.0
comp_acierto es cuántas comparaciones de claves cuesta en promedio buscar una clave que está. La columna
alfa la explicamos en unas secciones. Fíjense en esto: con un millón de casillas, 37 veces más que claves,
la suma sigue usando solo 1472 y sigue con una cadena de 100 claves. Agrandar la tabla no ayuda en nada,
porque todas las sumas ya caben en las primeras 2212 casillas.
Fíjense también en la primera fila de cada función. Con 1024 casillas, fnv1a también cuesta 14.7
comparaciones: una buena función no salva a una tabla demasiado chica. Lo que separa a las dos es lo que pasa al
dar más casillas.
FNV-1a
FNV-1a es una función hash clásica, de dominio público y muy corta. Su nombre viene de sus autores: Fowler, Noll y Vo. La versión de 64 bits usa dos constantes que fijan sus autores, publicadas en su página oficial:
inline std::uint64_t fnv1a(const std::string& key) {
    std::uint64_t hash = 14695981039346656037ULL;
    for (char c : key) {
        hash ^= static_cast<unsigned char>(c);
        hash *= 1099511628211ULL;
    }
    return hash;
}
Para cada byte, primero se mezcla con el hash mediante un XOR, y después se multiplica por un primo elegido.
En C++. Multiplicar un
std::uint64_tpor un número grande da overflow casi siempre, y aquí es justo lo que queremos: el overflow de un entero sin signo está bien definido, y da la vuelta módulo 2⁶⁴. Con un entero con signo es comportamiento indefinido, también en C++20. Por eso un hash se calcula siempre sin signo.
Sigamos dos anagramas, byte por byte. El hexadecimal se lee mejor que el decimal para esto:
$ build/fnv_trace
clave "ab"
  inicio        cbf29ce484222325
  xor  61       cbf29ce484222344
  por el primo  af63dc4c8601ec8c
  xor  62       af63dc4c8601ecee
  por el primo  089c4407b545986a
clave "ba"
  inicio        cbf29ce484222325
  xor  62       cbf29ce484222347
  por el primo  af63df4c8601f1a5
  xor  61       af63df4c8601f1c4
  por el primo  08a63307b54dd00c
Miren qué hace cada paso. El XOR cambia solo los bits bajos: ...2325 pasa a ...2344. La multiplicación, en
cambio, reparte ese cambio hacia los bits altos: una diferencia de un par de bits antes de multiplicar termina
siendo una diferencia en muchos dígitos después. Y como cada byte se mezcla con todo lo anterior, el orden
importa: ab y ba terminan distintos. Esas son las dos cosas que le faltaban a la suma: ve el orden, y usa
los 64 bits.
Para comprobar que escribimos la función correcta, no basta con que el resultado “se vea al azar”. Su página
publica vectores de prueba: "" da cbf29ce484222325, que es la propia constante inicial, "a" da
af63dc4c8601ec8c, y "foobar" da 85944171f73967e8. test_structures.cpp comprueba estos y dos más con
bytes altos. Observen en la traza que el primer por el primo de "ab" es justamente el valor de "a".
Error común. Olvidar el
static_cast<unsigned char>. En C++,charpuede tener signo o no, según la plataforma: en Linux sobre x86-64 tiene, en Linux sobre arm64, como este entorno, no tiene, y en macOS sobre arm64 sí tiene. Las letras con tilde son bytes mayores que 127 en UTF-8. Con signo, valen negativo, y una función escrita sin la conversión da resultados distintos según la máquina. Con-funsigned-chary-fsigned-charpodemos forzar cada caso, en cualquier máquina:
$ g++ -std=c++20 -funsigned-char errors/signed_char_hash.cpp -o build/sc1 && build/sc1
bad_sum("lima") = 419
bad_sum("ñandú") = 1060
$ g++ -std=c++20 -fsigned-char errors/signed_char_hash.cpp -o build/sc2 && build/sc2
bad_sum("lima") = 419
bad_sum("ñandú") = 36
Recuerden también que std::string guarda bytes, no letras. ñandú tiene 5 letras y 7 bytes en UTF-8. Para
hashear eso no es un problema: la función trata la clave como una secuencia de bytes, y dos cadenas iguales
tienen los mismos bytes. Un cuidado, eso sí: dos textos que se ven iguales en la pantalla pueden tener bytes
distintos, porque Unicode permite escribir ú de más de una manera, y para la tabla serían claves distintas.
Este curso no entra en ese tema.
Una advertencia: FNV-1a sirve para una tabla, no para seguridad. No es una función hash criptográfica. Es fácil encontrar claves con el hash que uno quiera, como haremos dentro de poco. Para contraseñas o firmas se usan otras funciones, que no son tema de este curso.
Encadenamiento
Ya tenemos función. Falta decidir qué pasa cuando dos claves caen en la misma casilla. La respuesta de esta semana es la más simple posible.
Definición. En el encadenamiento (chaining), cada casilla guarda una lista enlazada, llamada su cadena, con todas las claves que caen ahí.
La semana 9 verá otra familia, donde la colisión se resuelve buscando otra casilla dentro del propio arreglo. Hoy, listas.
La representación
Tenemos un arreglo de m punteros a nodo. Cada nodo guarda la clave, el valor y el siguiente. Usamos listas
simples, de la semana 5: no hace falta ir hacia atrás. Para concentrarnos en lo nuevo, este capítulo trabaja con
ChainTable, en chain_table.h, que tiene un número fijo de casillas, no borra y no crece. Todo eso lo
agregarán en el laboratorio.
template <typename V>
class ChainTable {
...
private:
    struct Node {
        std::string key;
        V value;
        Node* next;
    };

    Node** slots_;
    std::size_t capacity_;
    std::size_t size_ = 0;
    HashFunction hash_;
};
Observen Node** slots_: un puntero a un arreglo de punteros, reservado así:
: slots_(new Node*[capacity]()), capacity_(capacity), hash_(hash) {Los () del final importan. Sin ellos, los punteros de un new Node*[n] quedan con basura; con ellos, quedan
todos nulos, que aquí significa “cadena vacía”. Y HashFunction es un puntero a función, como los que usaron en
C:
using HashFunction = std::uint64_t (*)(const std::string&);Eso nos deja probar la misma tabla con sum_hash y con fnv1a. Sus invariantes:
- Cada nodo de la cadena i cumple
hash_(key) % capacity_ == i. - Una clave aparece en un solo nodo.
size_es el total de nodos.
El primero es la razón de ser de la estructura: es lo que permite buscar mirando una sola cadena. Como en
las semanas anteriores, check_invariants lo comprueba, recorriendo todo.
Buscar y guardar
Las dos operaciones empiezan igual: calcular la casilla, y recorrer esa cadena comparando claves.
std::size_t slot_of(const std::string& key) const {
    return hash_(key) % capacity_;
}

Node* find_node(const std::string& key) const {
    for (Node* node = slots_[slot_of(key)]; node != nullptr; node = node->next) {
        if (node->key == key) {
            return node;
        }
    }
    return nullptr;
}
Fíjense en la comparación node->key == key. Es indispensable: el hash solo dice dónde mirar. Dos claves
distintas pueden estar en la misma cadena, así que encontrar la casilla no es encontrar la clave. Por eso el
nodo tiene que guardar la clave completa.
const V* get(const std::string& key) const {
    Node* node = find_node(key);
    return node == nullptr ? nullptr : &node->value;
}
get devuelve un puntero: nulo si la clave no está. Es la misma convención que find devolviendo end(), sin
iteradores. Y como el puntero es const V*, quien lo reciba puede leer el valor pero no cambiarlo.
void set(const std::string& key, const V& value) {
    Node* node = find_node(key);
    if (node != nullptr) {
        node->value = value;
        return;
    }
    std::size_t slot = slot_of(key);
    slots_[slot] = new Node{key, value, slots_[slot]};
    size_++;
}
set tiene dos caminos: si la clave ya está, solo cambia el valor, y size_ no se mueve. Si no está, inserta
un nodo. Se inserta al inicio de la cadena: es la misma línea de push_front de la semana 5. El orden
dentro de la cadena no importa, porque una búsqueda la mira toda si hace falta, e insertar al inicio no exige
recorrer nada. Aquí eso no ahorra mucho, porque find_node ya la recorrió. Al crecer, en cambio, sí importará:
cada nodo se enlazará sin comparar claves.
Un ejemplo paso a paso
Usemos la mala función a propósito, para que haya colisiones que mirar, con 8 casillas:
$ build/chain_trace
Con la suma y 8 casillas
set(lima): suma 419, casilla 3
set(amor): suma 431, casilla 7
set(roma): suma 431, casilla 7
set(ad): suma 197, casilla 5
set(bc): suma 197, casilla 5
set(mora): suma 431, casilla 7
  0:
  1:
  2:
  3: lima
  4:
  5: bc ad
  6:
  7: mora roma amor
comparaciones para mora: 1, para amor: 3, para ramo: 3
Con FNV-1a y 4 casillas
  0: piura ica cusco lima
  1: puno
  2: tacna
  3:
Con FNV-1a y 8 casillas
  0: lima
  1:
  2:
  3:
  4: piura ica cusco
  5: puno
  6: tacna
  7:
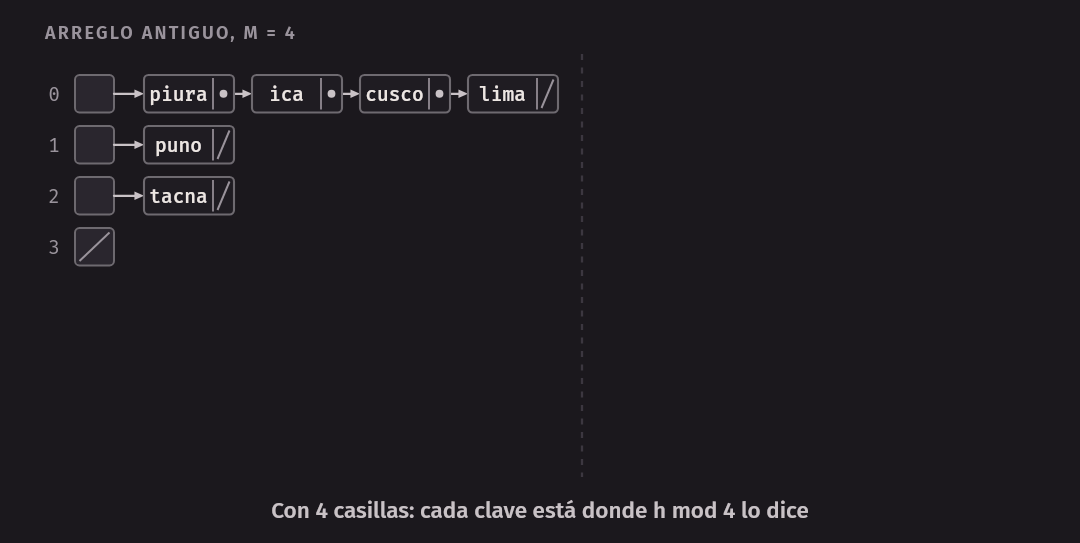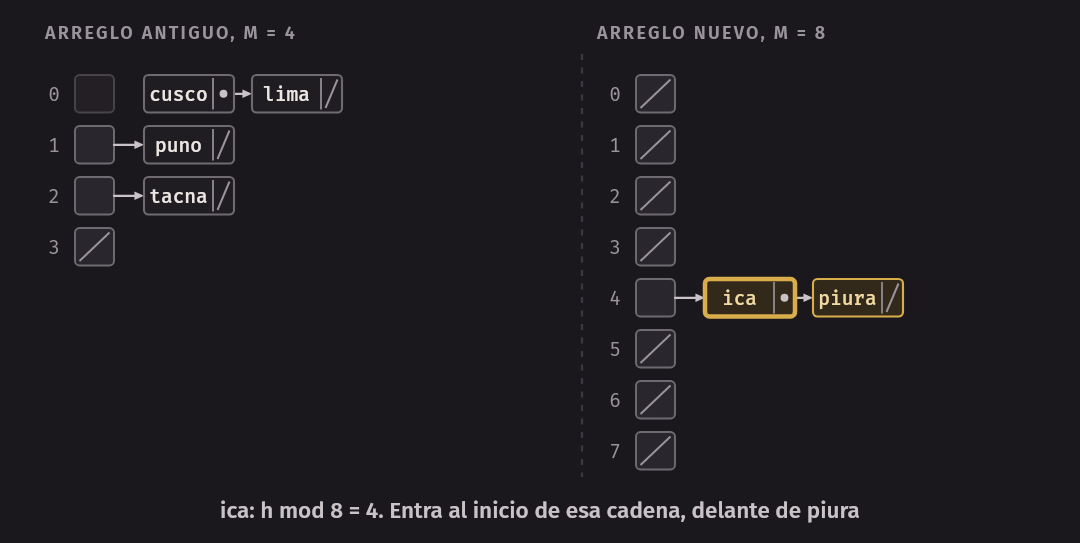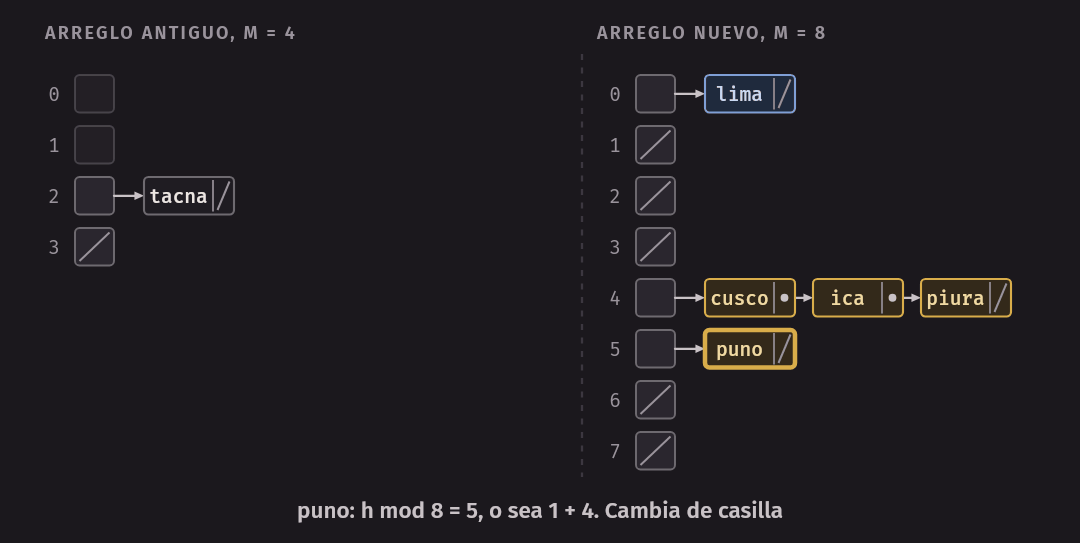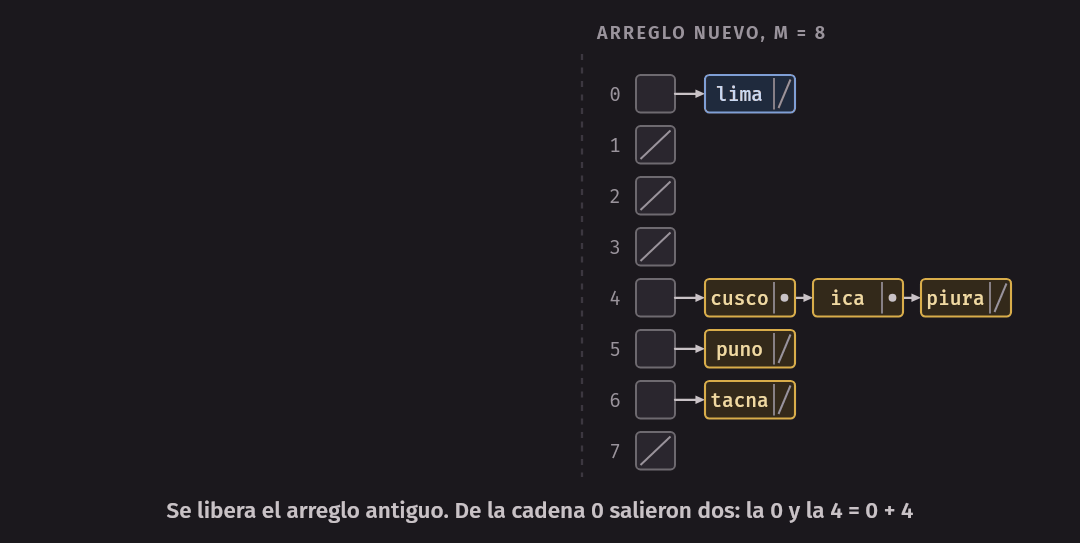
Dibujada, esa corrida va así, con las seis inserciones y las búsquedas de abajo:
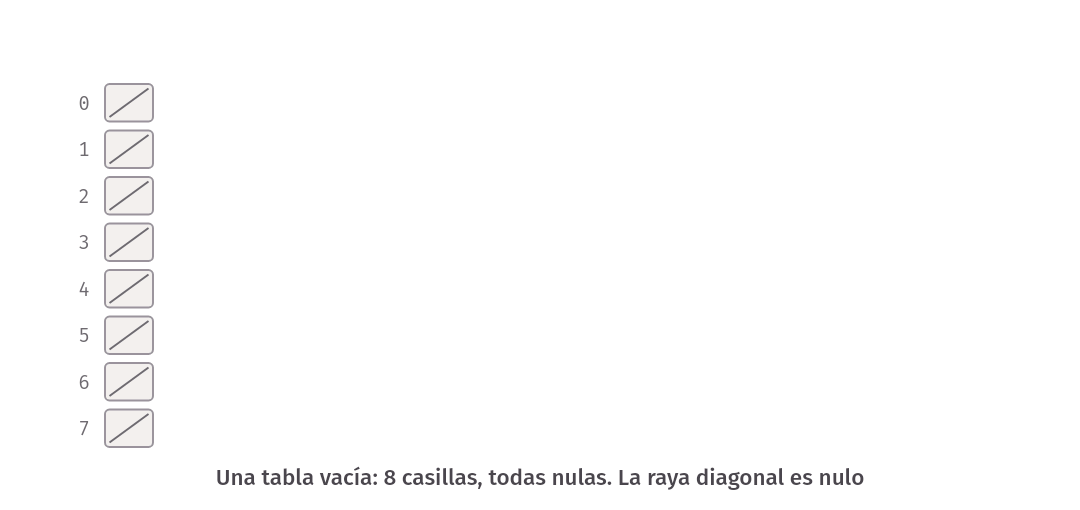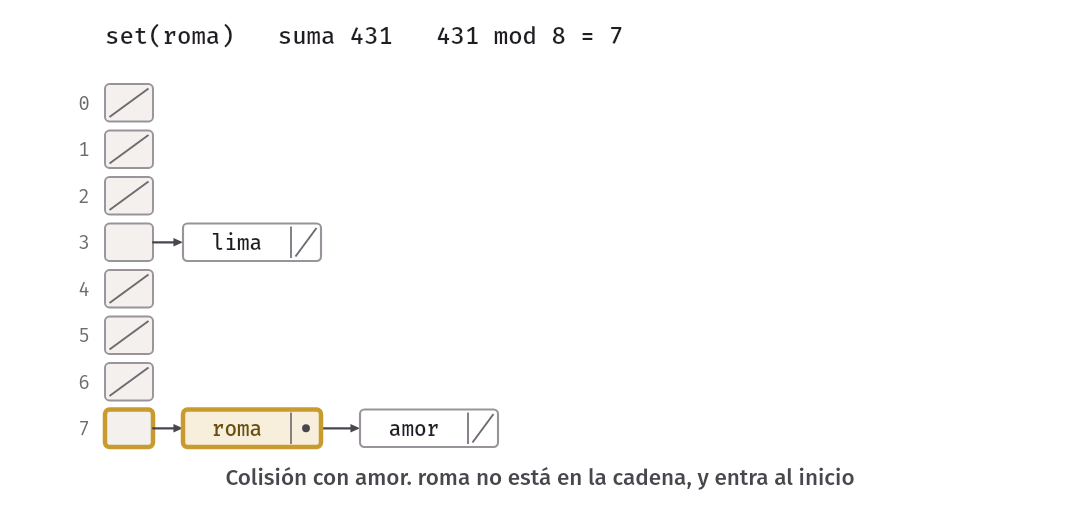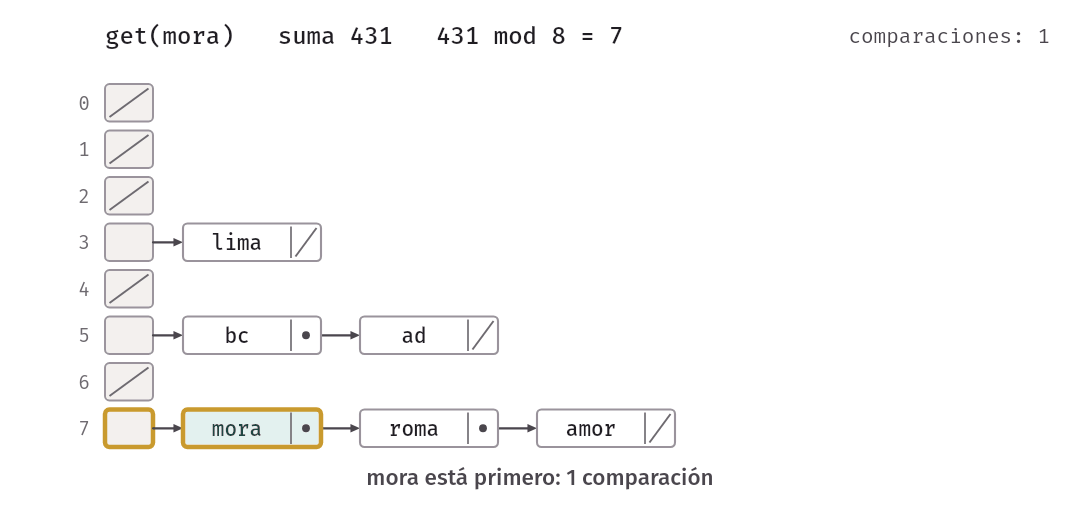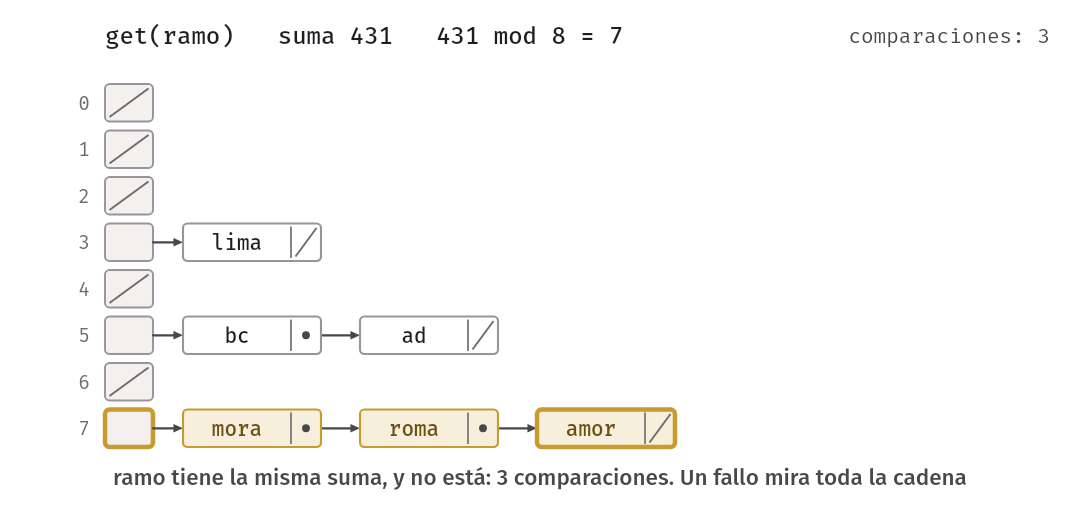
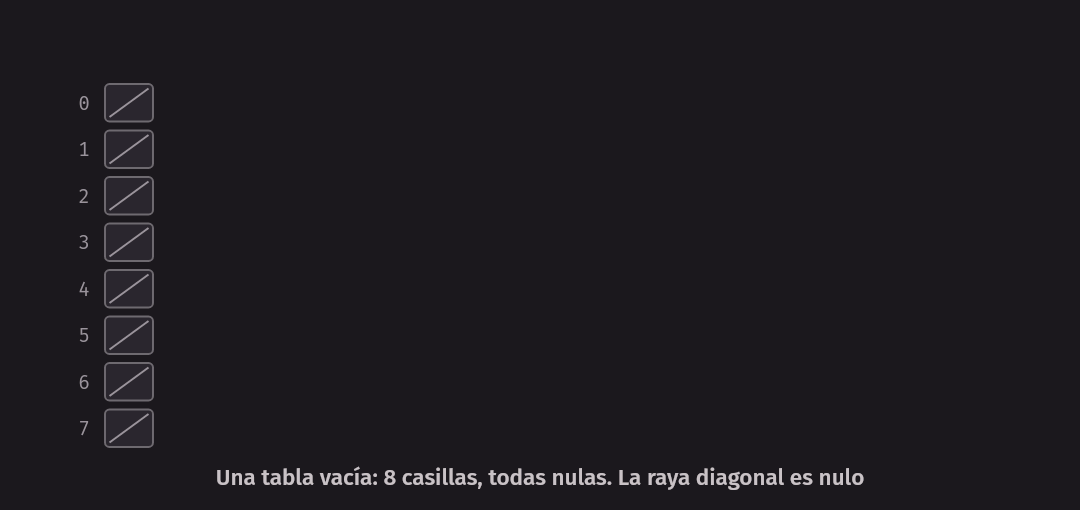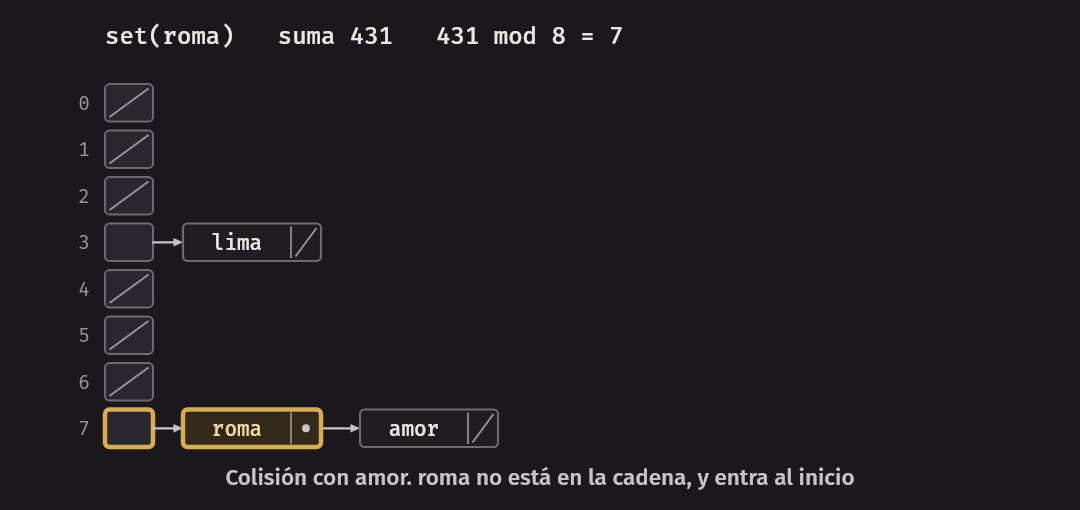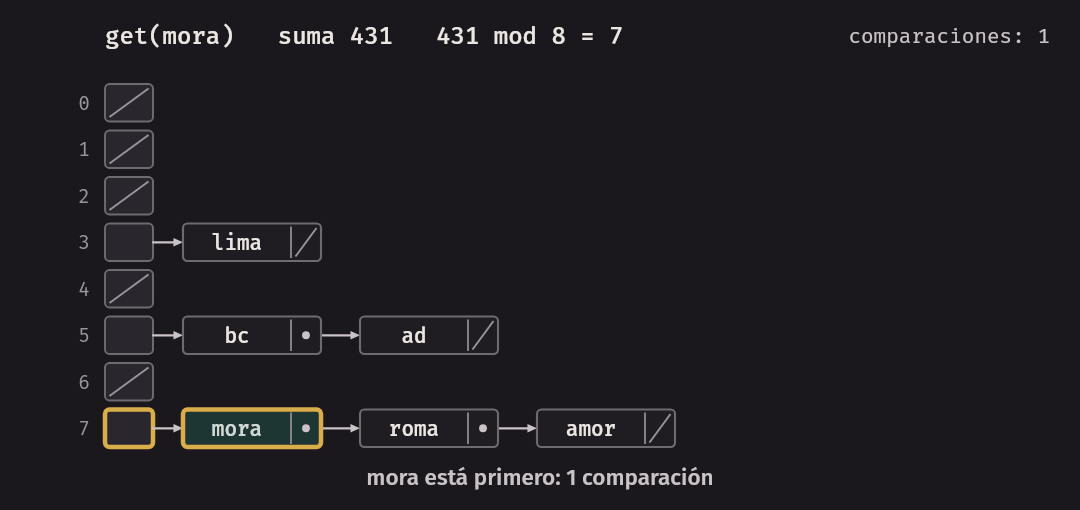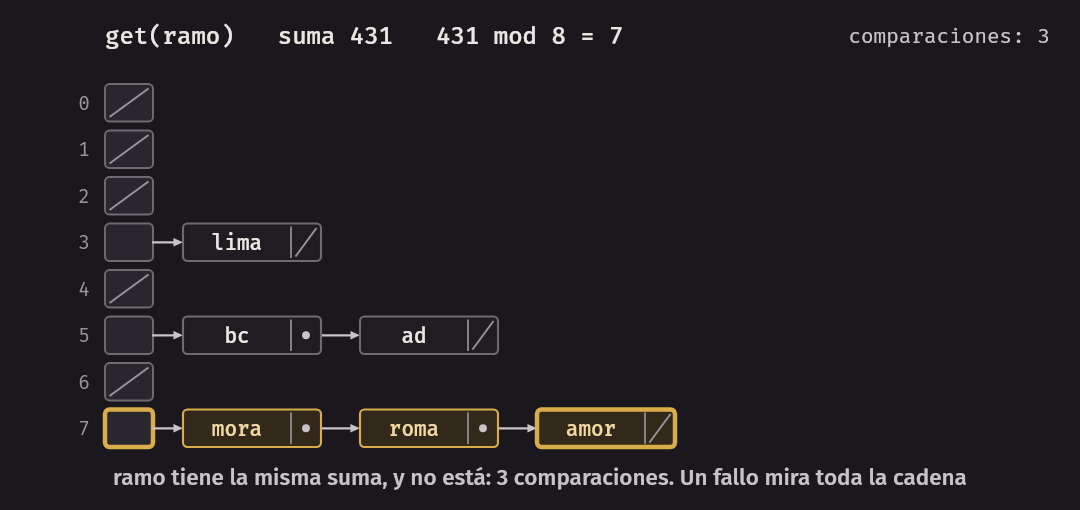
Tres búsquedas sobre esa tabla, siguiendo la última línea de esa parte de la salida:
moraestá primero en la casilla 7: 1 comparación.amorestá al final de la misma cadena: 3 comparaciones. Es una búsqueda con acierto.ramono está. Su suma es 431, así que hay que recorrer toda la casilla 7 para saberlo: 3 comparaciones. Es una búsqueda con fallo, que siempre mira la cadena completa.
Una casilla vacía, en cambio, responde “no está” con cero comparaciones de claves.
Borrar
Borrar una clave es sacar un nodo de una lista simple. Se calcula la casilla, se busca el nodo en la cadena y se lo saca:
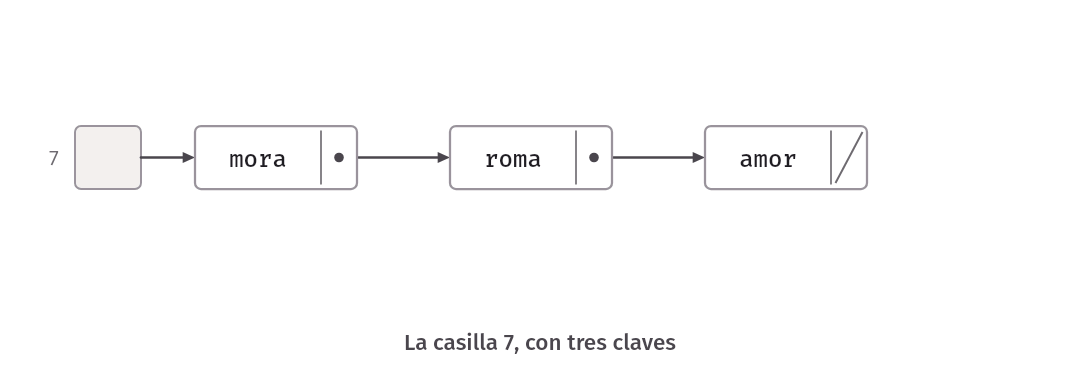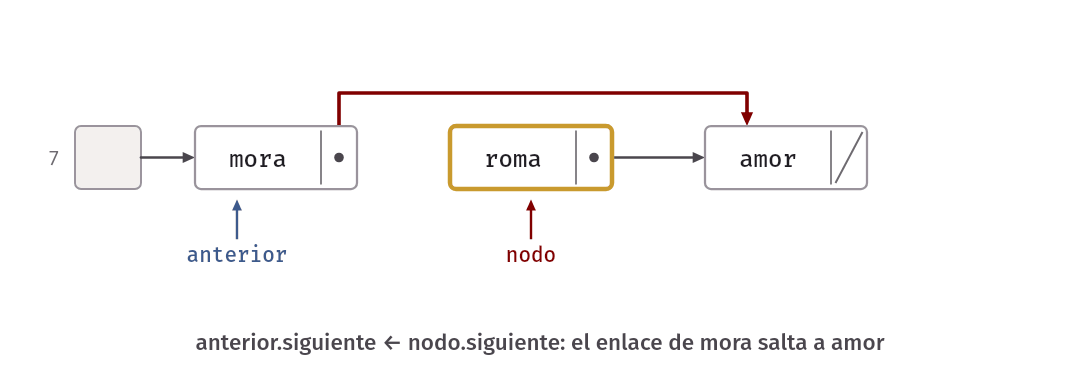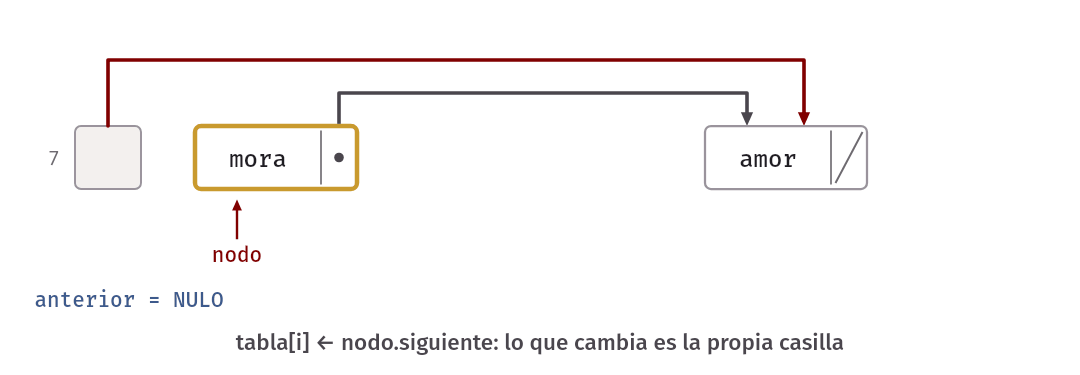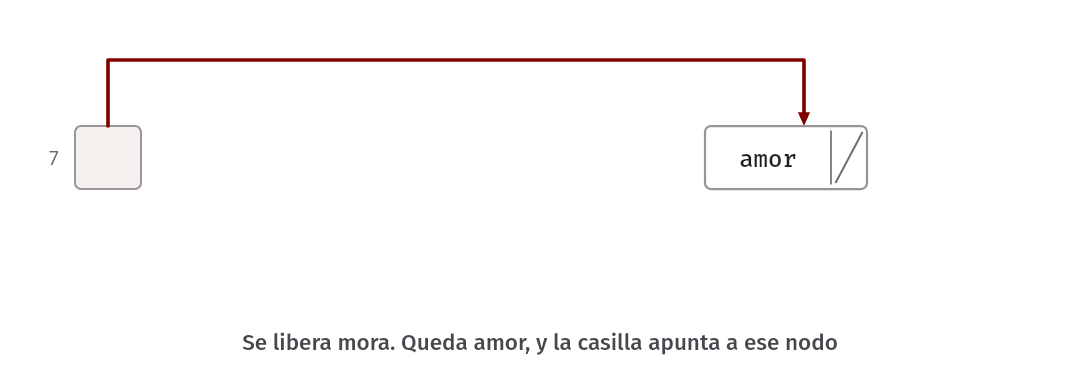
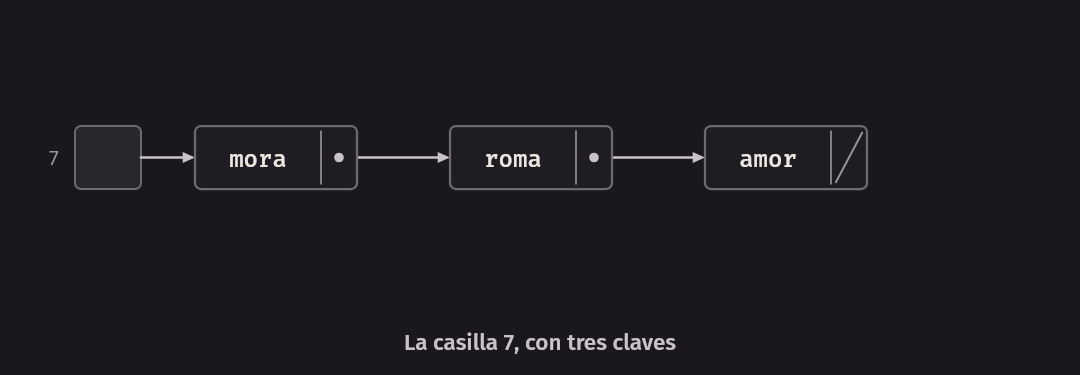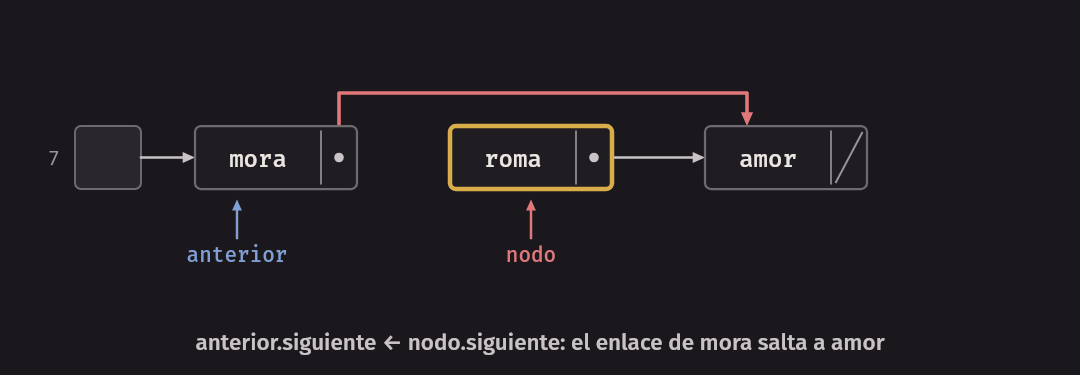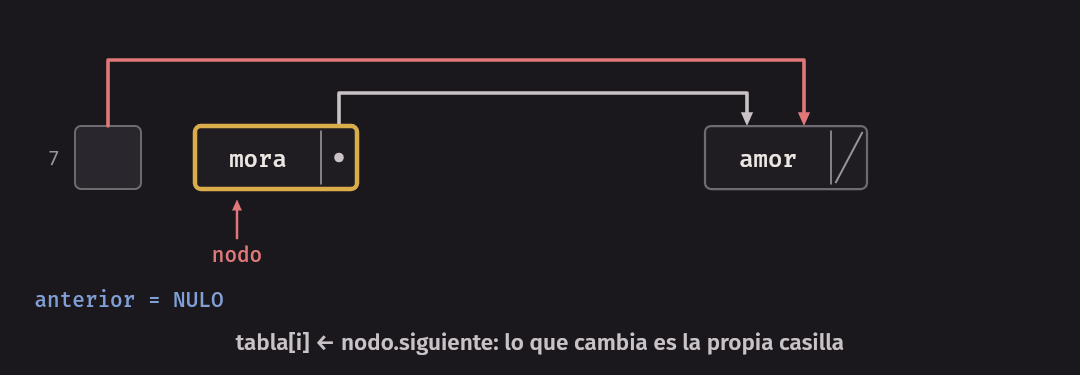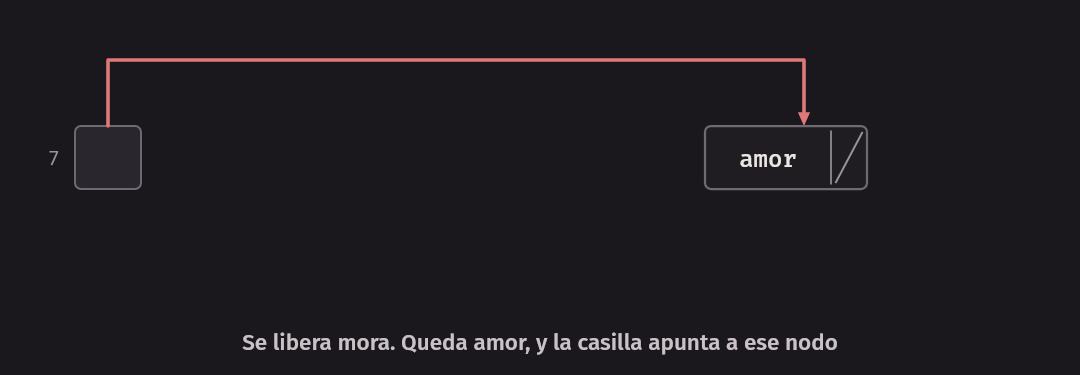
Hay dos situaciones. Si el nodo no es el primero, hay que cambiar el next del anterior. Si es el primero, no
hay anterior: lo que cambia es la propia casilla. En pseudocódigo:
algoritmo borrar(tabla, clave)
    i ← h(clave) mod m
    anterior ← NULO
    nodo ← tabla[i]
    mientras nodo ≠ NULO hacer
        si nodo.clave = clave entonces
            si anterior = NULO entonces
                tabla[i] ← nodo.siguiente
            sino
                anterior.siguiente ← nodo.siguiente
            fin si
            liberar nodo
            n ← n - 1
            devolver verdadero
        fin si
        anterior ← nodo
        nodo ← nodo.siguiente
    fin mientras
    devolver falso
fin algoritmo
Como una casilla es un puntero, igual que un campo next, en C++ esos dos casos se pueden unificar con un
puntero a puntero, que ya usaron en C. Queda a su elección en el laboratorio.
Error común. Olvidar el caso del primer nodo, y tener una casilla apuntando a memoria liberada. Si la prueba de ustedes solo borra claves que quedaron al final de su cadena, no lo verá nunca. Por eso las pruebas del laboratorio borran en todas las posiciones, en una tabla con cadenas largas.
Probar una tabla
Una tabla hash se puede equivocar en silencio: una clave en la cadena equivocada no produce ningún error de memoria. Por eso, se prueba de dos maneras. Primero, con casos dirigidos a lo que puede salir mal: una colisión de verdad, una sobrescritura, el orden de una cadena.
void test_collisions_keep_both() {
    ChainTable<int> table(16, sum_hash);
    table.set("amor", 1);
    table.set("roma", 2);
    assert(*table.get("amor") == 1);
    assert(*table.get("roma") == 2);
Aquí la mala función es útil: sum_hash garantiza la colisión, sin tener que buscar dos palabras que choquen
con FNV-1a. Con un puntero a función, la misma clase sirve para las dos pruebas.
Segundo, con operaciones al azar, con semilla fija, comparando con una implementación en la que confiamos. Es el mismo patrón de las semanas anteriores:
std::mt19937 rng(42);
ChainTable<int> table(64, fnv1a);
std::unordered_map<std::string, int> model;
for (int step = 0; step < 50000; step++) {
    std::string key = "k" + std::to_string(rng() % 2000);
Con 2000 claves posibles y 50 000 pasos, se repiten muchas: se prueban inserciones y también sobrescrituras. Al
final se llama a check_invariants, que recorre todas las cadenas y verifica cada clave contra su casilla. En
cada paso, además, los dos deben coincidir en size, y en cada lectura, en el valor. Como la semilla es fija,
una falla se repite igual cada vez.
El factor de carga
¿Cuánto cuesta una búsqueda? Depende de cuán larga sea la cadena, y eso depende de cuántas claves hay por casilla.
Definición. El factor de carga (load factor) de una tabla con n claves y m casillas es α = n/m.
α es el largo promedio de las cadenas, contando las vacías, sin importar qué función se use. Con encadenamiento, α puede ser mayor que 1: nada impide tener más claves que casillas.
La suposición, y lo que da
Para decir algo sobre una cadena en particular hace falta una suposición sobre la función: que reparte bien. Precisamente, que cada clave cae en cualquier casilla con la misma probabilidad, sin importar dónde cayeron las otras. Se llama hashing uniforme (uniform hashing), y ninguna función real lo cumple al pie de la letra: es un modelo. Con él, sin hacer el análisis probabilístico formal, que viene en otro curso, la intuición es esta.
Búsqueda con fallo. La clave buscada cae en una casilla cualquiera. Esa cadena tiene, en promedio, α claves, y hay que mirarlas todas. Son α comparaciones. Más el paso de calcular la casilla, cuyo costo no depende de n.
Búsqueda con acierto. La clave está en alguna cadena. Sin contarla a ella, la cadena tiene otras claves, en promedio cerca de α. Al buscarla, se revisan las que estén delante de ella, y en promedio está a la mitad. Son cerca de 1 + α/2 comparaciones: 1 por ella misma, y α/2 por las que tiene delante.
Idea clave. Con una función que reparte bien, el costo esperado de una búsqueda es O(1 + α). El 1 representa calcular la casilla, y α, recorrer la cadena. Si mantenemos α acotado por una constante, sin importar n, el costo esperado es O(1).
Es un costo esperado: un promedio sobre cómo caen las claves, suponiendo que reparten bien. No es una garantía para cada operación. Tampoco es lo mismo que el costo amortizado de la semana 4, que era un promedio sobre una secuencia de operaciones, sin ninguna suposición ni azar. Vuelve a salir abajo, y conviene no mezclarlos.
Comprobémoslo
Podemos contar comparaciones reales. Este programa baraja el diccionario, mete las n primeras palabras a una tabla con m casillas, y busca esas n (aciertos) y las n siguientes (fallos), usando FNV-1a:
$ build/load_experiment ../../data/palabras.txt
     m       n   alfa   acierto  1+alfa/2     fallo      alfa
   100     300   3.00      2.43      2.50      3.07      3.00
  1024     512   0.50      1.26      1.25      0.46      0.50
  1024    1024   1.00      1.49      1.50      1.06      1.00
  1024    2048   2.00      2.03      2.00      1.99      2.00
  1024    3072   3.00      2.52      2.50      3.02      3.00
  1024    5120   5.00      3.52      3.50      5.02      5.00
  1024   10240  10.00      6.00      6.00     10.04     10.00
  1024  102400 100.00     51.00     51.00    100.00    100.00
Son conteos, no tiempos: no dependen de la máquina. Una función real, con palabras reales, sigue muy de cerca el modelo. La predicción es sobre el promedio, y entonces, si la tabla es muy chica o hay pocos datos, habrá más ruido, como en la primera fila. La fila de α = 100 es tan exacta como la de α = 1, pero es inútil: la fórmula solo dice que el costo es proporcional a α.
Ejemplo. Una tabla con 100 casillas guarda 300 claves. El factor de carga es α = 300/100 = 3. Si la clave no está, se esperan unas 3 comparaciones, y la medición dio 3.07. Si la clave está, cerca de 1 + 3/2 = 2.5, y la medición dio 2.43. En una búsqueda con acierto, las comparaciones son exactamente las claves desde el inicio de la cadena hasta la buscada, y se cuenta esta última, por eso esa fórmula tiene el 1.
Noten que fallar cuesta más que acertar cuando α es grande, y puede costar menos con α chico: con α = 0.5, una búsqueda con fallo da muchas veces con una casilla vacía.
Cuántas casillas quedan vacías
También se puede predecir cómo se distribuye la carga. Para una casilla dada, la probabilidad de que una clave
no caiga ahí es 1 − 1/m. Con n claves independientes, la probabilidad de que quede vacía es (1 − 1/m)ⁿ, cerca de
e^(−α) cuando m es grande. Con α = 0.86, eso da un 42 %. En la tabla de hash_compare, fnv1a usó 18 894 de 32
768 casillas, así que quedaron vacías 13 874, un 42.3 %.
Noten qué significa: aun repartiendo perfectamente, muchas casillas quedan vacías y otras tienen varias
claves. Repartir al azar no es repartir parejo. Por eso una cadena de 6, como la de esa misma fila, no indica
ningún problema, mientras que suma llega a 100 con los mismos datos.
Crecer
Si m queda fijo y n crece, α crece, y con él el costo. Una tabla de 1024 casillas con un millón de claves busca en cadenas de mil. Ya vimos cómo resolver un problema así en la semana 4: duplicar.
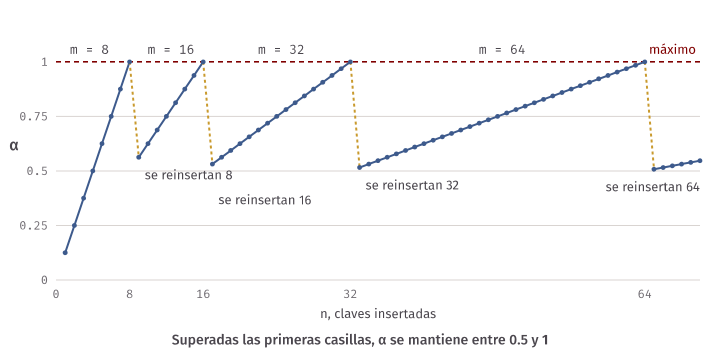
La regla: se fija un factor de carga máximo. Si la inserción de una clave nueva lo superaría, primero se duplican las casillas. En nuestra tabla el máximo será 1.0: en promedio, una clave por casilla. Con eso, α nunca pasa de 1, y si no se borra nada se mantiene entre 0.5 y 1, una vez superadas las primeras casillas.
Sigamos la regla, con 8 casillas iniciales y máximo 1.0:
| Claves al terminar | Casillas | α | ¿Qué pasó en esa inserción? |
|---|---|---|---|
| 1 | 8 | 0.125 | Nada especial |
| 8 | 8 | 1.0 | La tabla queda justo en el máximo, y no crece |
| 9 | 16 | 0.5625 | 9/8 superaría 1: primero se reinsertan 8, luego entra la nueva |
| 16 | 16 | 1.0 | Otra vez en el máximo |
| 17 | 32 | 0.53125 | Se reinsertan 16 |
| 33 | 64 | 0.515625 | Se reinsertan 32 |
¿Por qué 1.0, y no otro número? Es una decisión entre tiempo y memoria. Un máximo menor da cadenas más cortas,
con más casillas vacías. Un máximo mayor ahorra casillas y alarga las cadenas. std::unordered_map empieza
también con 1.0, y deja cambiarlo con max_load_factor. Nuestra tabla tendrá set_max_load_factor, que usarán
en la semana 9 para medir esa decisión.
Por qué hay que reinsertar todo
En la semana 4, crecer era copiar los elementos al bloque nuevo, cada uno en su mismo índice. Aquí eso no
funciona, porque el índice de una clave depende de m: es h(k) mod m. Al cambiar m, cambia dónde debería
estar cada clave:
$ build/naive_copy ../../data/terminos.tsv
lima: hash % 8 = 0, hash % 16 = 0
cusco: hash % 8 = 4, hash % 16 = 4
tacna: hash % 8 = 6, hash % 16 = 6
puno: hash % 8 = 5, hash % 16 = 13
arequipa: hash % 8 = 1, hash % 16 = 1
con 1024 casillas: 28039 de 28039 encontradas
copiando a 2048:   13892 de 28039 encontradas
reinsertando:      28039 de 28039 encontradas
Este programa construye una tabla y la “hace crecer” de dos maneras. Copiando las casillas a una tabla de
2048 en sus mismos índices, se pierde la mitad de las palabras: siguen en la memoria, pero get las busca en
otro lugar y no las encuentra. Nada falla, no hay error de memoria: la tabla simplemente responde mal.
Reinsertando, se encuentran todas.
¿Por qué justo la mitad? Con m potencia de 2, h mod m son los bits bajos de h. Al duplicar se mira un bit más.
Si ese bit es 0, el índice queda igual, como le pasa a lima. Si es 1, el índice aumenta en el m antiguo:
puno pasa de 5 a 5 + 8 = 13. Si el hash reparte bien, ese bit es 0 para la mitad de las claves.
Idea clave. Al crecer hay que reinsertar todas las claves, porque cada una está donde
h(k) mod mlo decía, y m acaba de cambiar. Copiar las casillas viola el invariante principal de la tabla, sin ningún aviso, salvo que lo revisecheck_invariants.
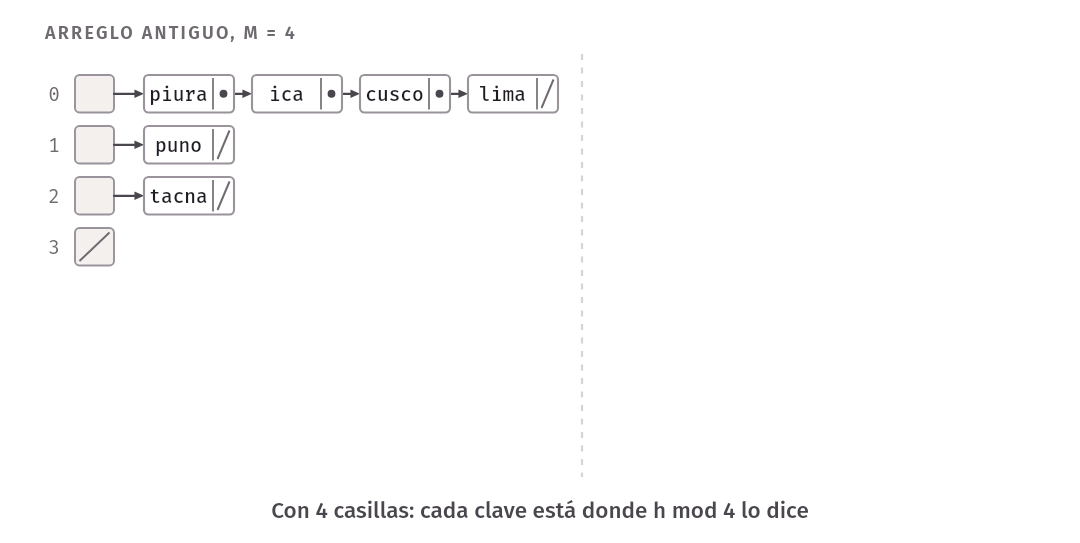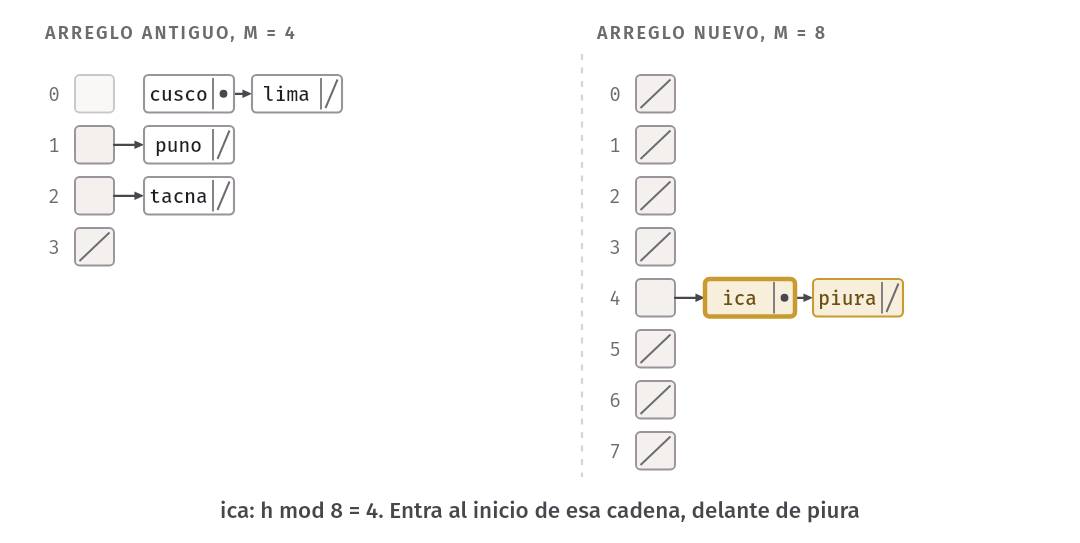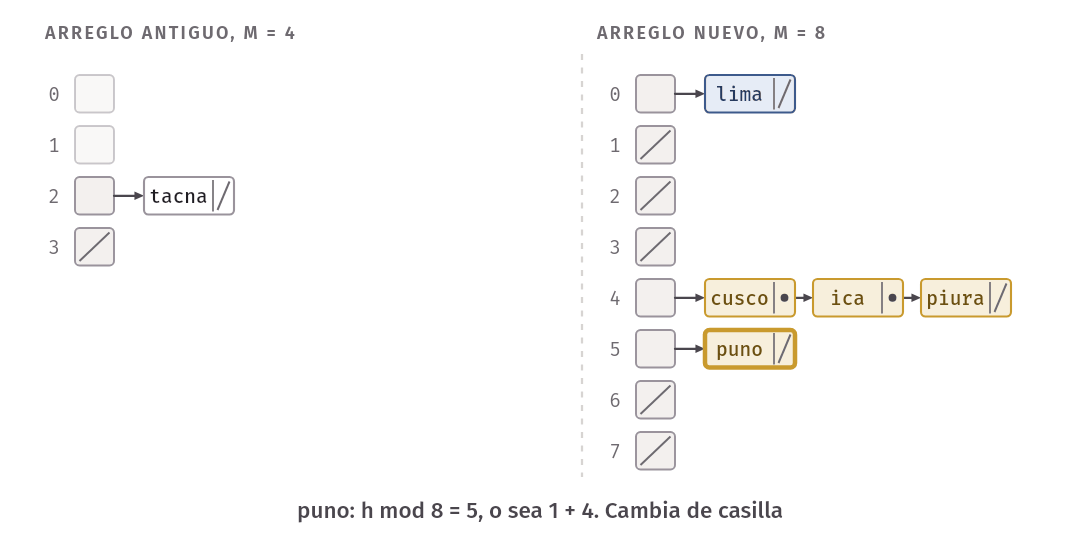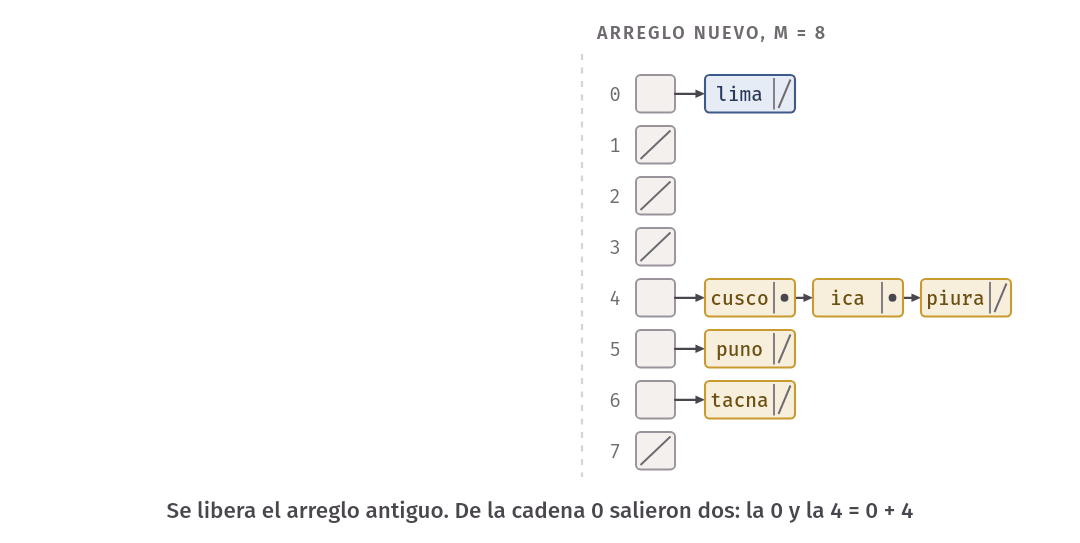
La salida de chain_trace muestra lo mismo con seis ciudades en 4 y luego en 8 casillas: con 4, lima,
cusco, ica y piura están en la casilla 0; con 8, lima se queda y las otras tres pasan a la 4 = 0 + 4. De
una cadena salen, a lo sumo, dos. El crecimiento nunca mezcla claves de cadenas distintas.
Reinsertar sin copiar
Reinsertar no significa crear de nuevo. Los nodos ya existen, con su clave y su valor: basta con volver a enlazarlos en el arreglo nuevo. No se reserva ningún nodo, ni se copia ninguna clave o valor:
algoritmo crecer(tabla)
    nueva ← arreglo de 2 × m punteros NULO
    para i desde 0 hasta m - 1 hacer
        nodo ← tabla[i]
        mientras nodo ≠ NULO hacer
            siguiente ← nodo.siguiente
            j ← h(nodo.clave) mod (2 × m)
            nodo.siguiente ← nueva[j]
            nueva[j] ← nodo
            nodo ← siguiente
        fin mientras
    fin para
    liberar tabla
    tabla ← nueva
    m ← 2 × m
fin algoritmo
Guardar siguiente antes de tocar el nodo es fundamental, por lo mismo que en la semana 5: en cuanto
nodo.siguiente cambia, ya no se puede llegar al resto de la cadena antigua.
Esto tiene una consecuencia práctica muy agradable. Como ningún nodo cambia de lugar en la memoria, un puntero
devuelto por get sigue siendo válido después de crecer, muy al revés de lo que pasaba en un std::vector.
La semana 9 verá que en otras tablas no es así.
El costo: otra vez amortizado
Una inserción que dispara el crecimiento cuesta Θ(n), porque hay que recalcular el hash de todas las claves y enlazar cada una. ¿Se paga eso? Es la misma cuenta de la semana 4. Contemos cuántas reinserciones hay en total, empezando con 8 casillas:
$ build/growth_count
         n   casillas reinsertadas por_insercion
      1000       1024         1016         1.02
     10000      16384        16376         1.64
    100000     131072       131064         1.31
   1000000    1048576      1048568         1.05
   1048576    1048576      1048568         1.00
   1048577    2097152      2097144         2.00
El crecimiento ocurre con tablas de 8, 16, 32, …, y en cada uno se reinsertan tantas claves como casillas tenía la tabla. El total, para terminar con m casillas, es 8 + 16 + … + m/2 = m − 8. Y como la tabla creció solo porque ya había más de m/2 claves, m < 2n. Así que, sin importar n, hay menos de 2 reinserciones por cada clave insertada. El último renglón muestra el peor momento: justo después de duplicar, 1.99999, que el programa redondea a 2.00. Crear el arreglo de punteros nuevo también cuesta Θ(m), lo que agrega otro término proporcional a n.
Por lo tanto, en una secuencia de n inserciones, el costo es Θ(n) esperado: O(1) amortizado y esperado por inserción. Las dos palabras hacen falta. “Amortizado” porque una inserción puede costar Θ(n) aunque el promedio de la secuencia sea constante. “Esperado” porque la cadena que hay que revisar depende de la función.
Error común. Comprobar el factor de carga después de una sobrescritura.
setde una clave que ya está no aumentan, y no debe hacer crecer la tabla. Por eso primero se busca, y solo se crece si la clave es nueva.
Nuestra tabla no encoge al borrar, igual que std::vector y std::unordered_map: el arreglo conserva sus
casillas hasta que se destruye la tabla. Es razonable en la mayoría de los usos, y lo único que pasa es que α
queda por debajo de su máximo, cosa que no estorba. Recorrer todas las claves, eso sí, cuesta Θ(m + n): hay que
pasar por cada casilla, también por las vacías.
Lo que cuesta una tabla, en resumen
| Operación | Esperado, si la función reparte bien y α es acotado | Peor caso |
|---|---|---|
get, contains |
O(1) | Θ(n) |
set de una clave que ya está |
O(1) | Θ(n) |
set de una clave nueva |
O(1) amortizado | Θ(n) |
remove |
O(1) | Θ(n) |
| Recorrer todas las claves | Θ(m + n) | Θ(m + n) |
Falta sumar un detalle en todas las filas: calcular el hash y comparar claves cuesta tiempo proporcional al largo de la clave. Y un costo que no sale en esta tabla, y que ya vimos en la semana 5: con encadenamiento, cada clave nueva paga una reserva de memoria, y cada paso por una cadena es un salto de puntero. La semana 9 mide cuánto se puede ganar sin esos nodos.
El peor caso sigue siendo Θ(n)
O(1 + α) tiene la suposición de que la función reparte bien. No es la garantía de que siempre será así. Si todas
las claves caen en la misma casilla, la tabla es una lista: buscar cuesta Θ(n), y construirla con n inserciones
cuesta Θ(n²), porque cada set revisa la cadena.
¿Puede pasar con FNV-1a? Por casualidad, con datos normales, es muy improbable. A propósito, es fácil. La
función es pública y no usa ningún secreto, así que se puede calcular de antemano. Basta con probar claves,
k0, k1, k2, …, y quedarse con aquellas cuyo hash sea múltiplo de 8192. Todas caerán en la casilla 0 de
cualquier tabla con m ≤ 8192 potencia de 2, así que además crecer no sirve de nada. Elegir las claves solo exige calcular hashes hasta juntar 4000: la última fue k32475944, unos 32 millones de intentos. También se puede hacer con std::hash y la tabla de la biblioteca:
$ build/flood
4000 claves; la ultima elegida es k32475944
normales   m=4096  la mayor cadena     5, comparaciones por busqueda      1.4
elegidas   m=4096  la mayor cadena  4000, comparaciones por busqueda   2000.5
elegidas   m=8192  la mayor cadena  4000, comparaciones por busqueda   2000.5
unordered_map con reserve(4000): bucket_count 4027
normales   la casilla de keys[0] tiene     1,      0.23 ms
elegidas   la casilla de keys[0] tiene  4000,     19.66 ms
Las tres primeras filas son conteos, y son exactos. Con 4000 claves, cada búsqueda pasó de 1.4 comparaciones a
2000.5. Las dos últimas miden el tiempo de insertar las 4000 claves en un std::unordered_map, compilado con
-O2, sin sanitizers y con la mediana de 5 repeticiones. Los tiempos dependen de la máquina. En cuatro corridas
en el entorno del curso, las claves elegidas tardaron entre 84 y 92 veces más. Con más claves la diferencia
sería mayor, porque el costo pasó de lineal a cuadrático. Noten un detalle honesto: las claves se eligieron para
ese bucket_count, 4027, que el programa ya conocía por usar reserve. Contra una tabla que crece, con tamaños
primos, el atacante tendría que elegir de otro modo, buscando el hash completo o tamaños futuros, pero sigue sin
haber un secreto que se lo impida.
Eso no es teoría. Crosby y Wallach describieron este ataque en Denial of Service via Algorithmic Complexity Attacks. Y en 2011 el aviso oCERT-2011-003 informó de lo mismo en varios lenguajes a la vez, con una exposición especial en servidores web. El mecanismo es simple: un servidor guarda los parámetros de una petición HTTP en una tabla hash, y el atacante manda una petición con miles de nombres elegidos para colisionar. Una sola petición puede ocupar una CPU durante mucho tiempo.
¿Y la defensa? Hacer que el atacante no pueda calcular la función: mezclar en el hash un número secreto, elegido al azar cuando arranca el programa. Python lo hace con las cadenas, como dice su documentación, citando este mismo aviso. Se ve con solo correrlo dos veces:
$ python3 -c "print(hash('lima'))"
-5712963166023579098
$ python3 -c "print(hash('lima'))"
30076730791972610
Otra defensa posible es limitar las cadenas o usar una estructura con peor caso garantizado, como los árboles
balanceados de las próximas semanas. Nuestra HashMap del laboratorio no se defiende, y std::hash tampoco,
como veremos: si las claves vienen de alguien que quiere hacer daño, hay que pensarlo.
Idea clave. O(1) esperado no es lo mismo que O(1). Una tabla hash es rápida porque el dato “se porta bien” con la función. Si el dato viene de un adversario, esa suposición se puede romper a propósito.
std::unordered_map y std::hash
La biblioteca estándar trae esta estructura, ya hecha y bien probada. En su trabajo diario la usarán a ella, no a una propia.
std::unordered_map<std::string, int> sizes;Las operaciones que corresponden al diccionario:
| Diccionario | std::unordered_map |
|---|---|
set(k, v) |
m[k] = v, o m.insert_or_assign(k, v) |
get(k) |
m.find(k), que devuelve un iterador, o end() si no está |
contains(k) |
m.contains(k), desde C++20 |
remove(k) |
m.erase(k), que devuelve cuántos borró: 0 o 1 |
size() |
m.size() |
Al recorrerla, cada elemento es un std::pair<const Key, Value>, con sus partes first y second.
Qué dice el estándar y qué hace esta biblioteca
Separemos las dos cosas. Lo primero vale en todo compilador. Lo segundo es lo que hace libstdc++, la biblioteca
de g++, y puede cambiar.
El estándar pide:
- Búsqueda, inserción y borrado en tiempo constante en promedio, y lineal en el tamaño en el peor caso.
max_load_factor()empieza en 1.0, y la tabla agrega casillas automáticamente para mantenerload_factor()por debajo de ese máximo.- Una interfaz para ver las casillas (
bucket_count,bucket_size,bucket), que aquí se llaman buckets. - Reorganizar las casillas invalida los iteradores, pero no los punteros y las referencias a los elementos.
- El orden de recorrido no está especificado.
std::hash<Key>: claves iguales dan hashes iguales, dentro de una misma ejecución del programa. No se pide que sea el mismo número entre dos ejecuciones, ni entre dos compiladores. Tampoco dice qué función usar. Una biblioteca podría usar un secreto al azar.
libstdc++ hace, en el entorno del curso:
std::hash<std::string>usa una función llamada_Hash_bytes, con la semilla fija0xc70f6907, segúnbits/functional_hash.h. Es decir, no hay secreto: da el mismo número en cada ejecución, y por eso pudimos elegir claves para atacarla.- Todos los nodos forman una sola lista simple, y cada casilla es un puntero a su tramo dentro de ella, según el
comentario de
bits/hashtable.h. Es una forma de encadenamiento, con el detalle de que recorrer la tabla entera es recorrer esa lista. - Los tamaños son primos, no potencias de 2, y crecen a algo más del doble:
$ build/library_demo
al inicio: bucket_count 1, max_load_factor 1
crece en n = 1 14 30 60 128 258 542 1110
bucket_count: 1 13 29 59 127 257 541 1109 2357
con n = 2000: load_factor 0.848536
orden: ica tacna puno cusco piura lima
tras rehash(100), bucket_count 103: lima piura cusco puno tacna ica
contains("ica") 1, contains("nazca") 0, size 6
cities["nazca"] 0, size 7
hash("lima") = 13284090235051427774
La regla que vemos es la misma de nuestra tabla: con 13 casillas, cabe la clave número 13, y la 14 hace crecer a
la tabla. Así, load_factor nunca pasa de 1. Estos números y este orden son de esta versión de esta biblioteca:
el estándar no promete ninguno.
Por qué las claves no salen ordenadas
Miren la línea orden. Se insertaron lima, cusco, puno, tacna, ica, piura, y salieron en otro
orden, que tampoco es el alfabético. ¿Por qué? Porque la posición de una clave la decide su hash, y un hash
bien hecho no tiene ninguna relación con el orden de las claves: esa es justamente la idea de repartir bien. La
tabla no guarda ninguna información de orden. Por eso se llama unordered.
Y además, el orden puede cambiar sin que uno toque ninguna clave. Tras rehash(100), las mismas seis claves
salen en otro orden. Cualquier inserción que haga crecer la tabla puede hacer lo mismo. Conclusión: no escriban
un programa que dependa del orden de un std::unordered_map, ni una prueba que compare su salida con un texto.
Hoy puede pasar, y mañana, con otro compilador, otra versión o una inserción más, deja de pasar. Si necesitan
orden, necesitan otra estructura: un arreglo ordenado, o el std::map de la semana 10.
Error común. Usar
operator[]para preguntar si una clave está. Si no está,m[k]la inserta, con un valor por defecto. Por eso, en la salida,cities["nazca"]dio 0 ysizesubió de 6 a 7. Para preguntar, usencontainsofind. Por lo mismo,operator[]no se puede usar en un mapaconst.
En la biblioteca. Si saben cuántas claves van a insertar,
m.reserve(n)evita los crecimientos, igual que enstd::vector. Con un tipo propio como clave, hay que dar una función hash y una comparación de igualdad, ya questd::hashno existe para él. Las dos deben estar de acuerdo: claves iguales, hash igual.
Error común: modificar una clave que ya está en la tabla
La posición de un nodo depende del hash de su clave en el momento de insertarlo. Si alguien cambia la clave
después, el nodo queda en una casilla que ya no le corresponde. Es el mismo problema que copiar sin reinsertar,
y por eso check_invariants lo detecta. errors/mutated_key.cpp lo muestra, con una tabla que comete el error
de diseño de entregar su clave sin const:
std::string* key_of(const std::string& key) {$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/mutated_key.cpp -o build/mutated_key
$ build/mutated_key
invariantes: 1
size: 1
get("lima"): no está
get("cusco"): no está
invariantes: 0El programa guarda lima, y cambia esa clave a cusco a través del puntero. Ahora el dato está en la tabla,
size lo cuenta, y nadie lo puede encontrar: ni con el nombre antiguo, porque esa clave ya no está en ningún
nodo, ni con el nuevo, porque se busca en otra casilla. No hay ningún error de memoria, ningún sanitizer se
queja, y el programa simplemente pierde datos. El estado es válido como memoria e inválido como tabla: solo el
invariante lo ve.
Por eso la biblioteca hace que la clave sea const, y este código no compila:
entry.first = "cusco";$ g++ -std=c++20 -c errors/const_key.cpp -o build/const_key.o
errors/const_key.cpp: In function 'int main()':
errors/const_key.cpp:9:23: error: no match for 'operator=' (operand types are 'const std::__cxx11::basic_string<char>' and 'const char [6]')
9 | entry.first = "cusco";Para cambiar una clave de verdad, hay que borrar el par e insertarlo con la clave nueva. Nuestra HashMap
tampoco deja este camino abierto: guarda su propia copia de la clave, y get solo entrega el valor. El peligro
sigue vivo cuando la clave contiene un puntero, o cuando su función hash lee algo que está fuera de ella: si un
std::unordered_map hashea a través de un puntero lo apuntado, y alguien lo cambia desde afuera, el const no
lo salva. Regla práctica: una clave, una vez en la tabla, no cambia.
¿Tabla hash o arreglo ordenado?
Después de todo esto, ¿para qué seguir usando un arreglo ordenado? Comparemos los dos sobre el diccionario
completo, con 200 000 consultas elegidas al azar, las mismas para los dos. Se compiló con -O2 y sin
sanitizers, y el tiempo es la mediana de 5 repeticiones. Los tiempos dependen de la máquina, y las comparaciones
no. MB son los millones de bytes pedidos con new y sin liberar, sin contar lo que agrega malloc.
$ build/lookup_bench ../../data/palabras.txt
1045757 palabras, 200000 consultas
                        ns/consulta    comparaciones         MB
arreglo ordenado                510             20.0       35.2
std::unordered_map              165              1.4       71.8
construir la tabla: 364 ms
empiezan con cas: 1537, de cas a casó
la tabla debe revisar 1045757 claves para hallar las mismas 1537
antes de la primera b: aúpo; ultima antes de la primera con a acentuada: zúñiga; primera: ábaco
Leámoslo. Hay 20 comparaciones contra 1.4, como predicen log₂ n y 1 + α/2. En cuatro corridas, la tabla fue entre 2.4 y 3.1 veces más rápida. Es bastante menos de lo que sugiere la proporción de 14 a 1 de comparaciones: una consulta en la tabla también paga el hash completo y probablemente saltos por la memoria entre punteros, y aquí no tenemos una herramienta para medir la cache. El arreglo, por su parte, ocupó cerca de la mitad de la memoria.
La tabla no lo gana todo, y ese es el punto de esta sección. Prefieran un arreglo ordenado con búsqueda binaria cuando:
- Hacen falta consultas por orden o por rango. “Todas las que empiezan con
cas” son 1537 palabras consecutivas: dos búsquedas binarias las delimitan. En la tabla, esas palabras están regadas al azar y hay que revisar todas las claves, más de un millón. Lo mismo vale para el mínimo, el máximo, el siguiente o los k primeros. - Los datos casi no cambian. Si se construye una vez, ordenar y buscar es simple, y ninguna inserción paga Θ(n). Un diccionario que se carga al arrancar es un caso así.
- Importa la memoria. En esta medición, ocupó la mitad. Tampoco hay nodos, ni reservas por clave.
- Se necesita una garantía de peor caso. Θ(log n) es una cota, sin suposiciones sobre las claves. No hay claves elegidas que la rompan.
Prefieran una tabla hash cuando lo que importa es guardar, buscar y borrar por clave exacta, los datos cambian mucho, y el orden no importa. Es el caso más común.
Una advertencia sobre “orden”. std::string compara bytes, así que el arreglo está en orden de bytes, no en
orden alfabético del español. La última línea lo muestra: antes de la primera b está aúpo, y ábaco no está
entre las palabras con a: va después de todas las que empiezan con z. En UTF-8, á empieza con el byte
0xC3, mayor que cualquier letra sin tilde. Entonces, la búsqueda del prefijo a no encuentra ábaco. El
prefijo cas funcionó porque el prefijo mismo no lleva tilde: el rango incluye casó, cuya tilde viene
después. Si necesitaran el orden del idioma, tendrían que comparar con otra función.
Idea clave. Una tabla hash solo sabe responder una pregunta: “¿qué valor tiene exactamente esta clave?”. La responde muy bien. Todo lo que dependa de que una clave sea parecida o cercana a otra se pierde, porque una buena función hash destruye precisamente esa relación.
El código de la semana
En code/week-07:
| Archivo | Qué contiene |
|---|---|
hash_functions.h, hash_demo.cpp, fnv_trace.cpp |
Suma y FNV-1a, y su traza |
chain_table.h, chain_trace.cpp |
Encadenamiento con m fijo |
first_collision.cpp |
Cuántas claves hasta la primera colisión |
hash_compare.cpp |
Casillas usadas y cadenas, con cada función |
load_experiment.cpp |
Comparaciones contra α |
naive_copy.cpp, growth_count.cpp |
Crecer: por qué reinsertar y cuánto cuesta |
flood.cpp |
Claves elegidas para que colisionen |
library_demo.cpp |
std::unordered_map por dentro |
lookup_bench.cpp, bench.h |
Arreglo ordenado contra tabla hash |
word_file.h, tracked.h |
Leer listas de palabras, y contar copias en las pruebas |
test_structures.cpp |
Vectores oficiales de FNV-1a, y ChainTable contra std::unordered_map |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
Estos programas reciben el archivo de datos como argumento. El Makefile tiene DATA ?= ../../data, que apunta
a los archivos del curso, descritos en data/README.md.
make compila, y make test lo comprueba todo: los comandos de este capítulo se vuelven a correr, y las
salidas que no dependen de la máquina se comparan con las del texto. Los tiempos no se comparan. Lo que sí se
revisa son conteos: las cadenas, las comparaciones, los valores de los hashes.
El laboratorio
Esta semana hay una sola sesión de laboratorio, de 2 horas, porque la otra es para la Práctica 2. Por eso hay más código dado que de costumbre. Escribirán solo lo que es propio de una tabla hash.
make test-map       # HashMap: pasos 1 y 2
make test-calc      # el evaluador: paso 3
make test-hash      # las funciones hash y chain_lengths
make test-lab       # todo
make report         # la tabla del paso 4, con el diccionario real, con -O2 y sin sanitizers
Cada función sin hacer detiene el programa con un mensaje que dice cuál falta. Estos son los pasos, y el tiempo que deberían tomar:
HashMap<V>enlab/hash_map.h(unos 60 minutos). Ya están dadosNode, la regla de cinco,check_invariants,set_max_load_factory los invariantes escritos. Lean esas partes primero. Ustedes escribenfnv1a,find_node,set,get,contains,removeygrow. Empiecen confind_node, y dejengrowpara cuando lo demás pase.- Operaciones al azar contra
std::unordered_map, con ASan (unos 15 minutos). Ya están enlab/tests/map_suite.h:make test-maplas corre. El trabajo aquí es entender y corregir lo que falle. - La tabla de variables (unos 15 minutos).
lab/given/evaluator.hes un evaluador pequeño, ya hecho, con asignaciones,print,delyvars. Solo le faltalab/var_table.h, con cuatro métodos que usan suHashMap. Corran su programa conbuild/lab/calc lab/tests/program.calc. - Comparar los largos de las cadenas (unos 25 minutos). Escriban
sum_hashychain_lengthsenlab/chain_lengths.h. Antes de corrermake report, escriban su predicción enlab/report.md, y después respondan con sus números.
Algunas cosas que conviene saber antes de empezar:
- El origen de un movimiento queda vacío y se puede seguir usando, con
capacity() == 0. Es un contrato que elegimos, igual que en la semana 5. Entoncesfind_nodeyremovedeben responder bien sin casillas, ygrowdebe crearlas. Si olvidan esto, calcular% 0es comportamiento indefinido, y UBSan lo marca. Lo que pasa después depende de la máquina: aquí, en arm64, el programa sigue con un valor sin sentido, y en otras se detiene.
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/modulo_zero.cpp -o build/modulo_zero
$ build/modulo_zero
errors/modulo_zero.cpp:10:47: runtime error: division by zero
casilla: 13787086008247356304needs_growth(n)ya está dada. Dice si n claves superarían el máximo, y también responde que sí sin casillas. Enset, úsenla en unwhile: si alguien fijó un máximo muy bajo, un solo crecimiento puede no alcanzar.growno reserva nodos. Una prueba cuenta las reservas de memoria y otra las copias de valores: al crecer solo debe aparecer una reserva, la del arreglo nuevo. Si crean nodos nuevos, la tabla funcionará y esas dos pruebas fallarán. Además, ungetanterior al crecimiento dejaría de ser válido.- Bajar el máximo con
set_max_load_factorhace crecer de inmediato, si hace falta, para que el invariantesize_ <= max_load_ * capacity_valga siempre. Ya está escrito, pero depende de sugrow. - Las pruebas corren con ASan y UBSan. Una fuga hace fallar la prueba. Además, las de
fnv1aysum_hashse compilan con-fsigned-char, así que olvidar la conversión aunsigned charfalla en cualquier máquina.
En la semana 9 volverán a esta tabla: copiarán su hash_map.h para compararla con otra representación. Déjenla
limpia.
Resumen
- Un diccionario guarda pares (clave, valor) con claves sin repetir. Una tabla hash lo implementa con costo
O(1) esperado en
set,getyremove. - Una función hash convierte una clave en un número, y
h(k) mod mda su casilla. Debe ser determinista, rápida y repartir bien. Claves iguales deben dar hashes iguales: lo contrario no se pide. - Las colisiones son inevitables, por el principio del palomar, y aparecen muy pronto, por la paradoja del cumpleaños: cerca de √m claves.
- Sumar los bytes es una mala función: no ve el orden, y da unos pocos miles de valores, por muchas casillas
que haya. FNV-1a mezcla cada byte con XOR y una multiplicación, y reparte muy bien. Conviertan a
unsigned char. - Con encadenamiento, cada casilla tiene una lista de sus claves. Hay que comparar las claves, porque el hash solo dice dónde mirar.
- El factor de carga es α = n/m. Si la función reparte bien, una búsqueda con fallo mira α claves, y una con acierto, cerca de 1 + α/2: O(1 + α) esperado.
- Para mantener α acotado, al superar el máximo se duplica y se reinserta todo, porque cada índice depende de m. Copiar las casillas pierde cerca de la mitad de las claves. Hay menos de 2 reinserciones por inserción: es O(1) amortizado, además de esperado.
- El peor caso sigue siendo Θ(n). Con una función pública, un atacante puede elegir claves que caigan en una sola casilla. Una defensa es un hash con secreto al azar, como en Python.
std::unordered_mapda promedio constante, peor caso lineal ymax_load_factor1.0 por el estándar. La función concreta y los tamaños primos son de libstdc++. Sus claves no salen ordenadas, y el orden puede cambiar al crecer.operator[]inserta.- Una clave que ya está en la tabla no se modifica: quedaría en una casilla equivocada. Por eso en la
biblioteca es
const. - Prefieran un arreglo ordenado si necesitan rangos u orden, si los datos casi no cambian, o si quieren peor
caso garantizado. Recuerden que
std::stringordena por bytes:áqueda después dez.
Ejercicios
- Sin correr nada, ¿qué da
sum_hashparasoly paralos? Encuentren otras dos palabras del español con la misma suma que no sean anagramas, y compruébenlo con el programa. - Una tabla con 200 casillas y encadenamiento guarda 500 claves. ¿Cuál es α? ¿Cuántas comparaciones esperan en
una búsqueda con fallo? ¿Y en una con acierto? Cambien
load_experiment.cpppara comprobar su respuesta con esos m y n. - Dibujen una tabla de 4 casillas y usen la suma de bytes: inserten
ab,ba,c,den ese orden. Muestren cada cadena. Después, borrenbay muestren qué punteros cambian. ¿Y si se borra primeroab? Comprueben las casillas con un programa. - ¿Qué opinan de estas funciones hash? Digan si son correctas (claves iguales, hash igual) y si reparten bien.
a) La longitud de la clave. b) El primer byte de la clave. c)
h(k) = 7. d) Un número al azar distinto en cada llamada. e) La dirección de memoria delstd::stringque recibe. - Sigan a mano
crecerpara una tabla de 2 casillas con las claves de hash 3, 5 y 6. Dibujen las cadenas antes y después, si pasa a 4 casillas. ¿En qué casillas pueden terminar las claves de la casilla 1? - Con un factor de carga máximo de 0.5, ¿cuántas reinserciones hay por clave insertada, en el peor momento?
¿Qué se gana y qué se pierde respecto a 1.0? Justifiquen con la cuenta de
growth_count.cpp, modificándolo. - Supongan que la tabla crece de 1000 casillas en 1000 casillas, en lugar de duplicarse. Calculen cuántas
reinserciones hay en total tras n inserciones. Comparen con
growth_count.cpppara n = 10⁶. - Reemplacen
fnv1aenhash_compare.cpppor la funciónh = 31 * h + byte, partiendo de 0. Comparen con las columnasusadasyla_mayor, sobreterminos.tsvy conpalabras.txt, con m = 2²⁰. Expliquen el resultado. - Con
std::unordered_map, escriban un contador de palabras paratradiciones.txt: separen las palabras por lo que no sean letras, cuidando las tildes. ¿Por qué no pueden imprimir el resultado ordenado por frecuencia sin otra estructura? Hagan eso con unstd::vectorystd::sort. - Agrupen todos los anagramas de
terminos.tsvcon unstd::unordered_map, usando como clave la palabra con sus bytes ordenados. ¿Por qué esa clave junta los anagramas? ¿Qué pasa con las palabras con tilde, al ordenar bytes y no letras? ¿Cuál es el grupo más grande? - En
flood.cpp, midan cómo crece el tiempo delstd::unordered_mapcon claves elegidas para n = 2000, 4000 y 8000. ¿Se ve el comportamiento cuadrático? Hagan tres corridas. Expliquen por qué elegir las claves también cuesta más, y cuánto, a medida que n crece. - Agreguen a su
HashMapdel laboratorio un métodostd::vector<std::string> keys() const. ¿Qué orden pueden prometer sus claves? Escriban una prueba que no dependa de ese orden. Luego, agreguen encoger a la mitad al bajar de α = 1/4, y demuestren contando reservas que alternarsetyremoveen el borde no reserva todo el tiempo.