Apuntes · Capítulo 9Diccionarios
Direccionamiento abierto
Direccionamiento abierto
Antes del parcial, en la semana 7, construimos una tabla hash con encadenamiento: un arreglo de casillas, y en cada
casilla una lista enlazada con las claves que caen ahí. Funciona, su análisis es limpio, y std::unordered_map
se le parece mucho. Pero tiene un costo que el análisis no muestra. Cada clave vive en un nodo propio, con su
reserva de memoria y su puntero, y buscar significa saltar de un nodo a otro por la memoria.
Hoy cambiamos esa decisión: todo se guarda dentro del arreglo. Si la casilla de una clave está ocupada, se prueba la siguiente. Probar casillas hasta dar con la clave o con una vacía se llama probing, y esta forma, la más simple, linear probing. Sin nodos, sin punteros y sin reservas por clave. La idea es de 1954 y se publicó en 1957, y aun así las tablas de Go y de Python, que se usan a diario en muchísimos programas, son variantes suyas.
La idea trae un problema que el encadenamiento no tenía: borrar. Vaciar una casilla rompe las búsquedas de otras claves. También trae una pregunta práctica que vamos a responder midiendo: el análisis dice que el encadenamiento hace menos trabajo, y sin embargo se suele decir que el linear probing es más rápido porque sus casillas están contiguas. Veremos en qué casos eso se cumple en nuestra máquina y en cuáles no. La respuesta no es la que uno espera de un eslogan. Después leeremos dos diseños reales, y terminaremos con un corrector ortográfico que usa un millón de palabras para comparar cuatro formas de guardar un diccionario.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Todo dentro del arreglo, Linear probing y Agrupamiento primario.
- En clase: Borrar: por qué no se puede vaciar la casilla, Una tabla de verdad, Encadenamiento frente a linear probing, Caso de estudio: Swiss Tables, Caso de estudio: el
dictde CPython y Qué cambió y qué no.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El laboratorio: un corrector ortográfico y El código de la semana. Opcional: Open Data Structures, sec. 5.2 (LinearHashTable); CLRS, capítulo Hash Tables, 4.ª edición, que resalta el linear probing por el efecto de la cache; Faster Go maps with Swiss Tables, Go Blog, 2025.
Código. Los programas de este capítulo están en
code/week-09. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Todo dentro del arreglo
Empecemos por lo que no cambia. Seguimos con el tipo abstracto diccionario de la semana 7: set, get, contains
y remove. Seguimos con una función hash que lleva una clave a un número, y con m casillas. Seguimos con el factor de
carga α = n/m, donde n es la cantidad de claves. Lo único que cambia es qué se hace cuando dos claves quieren la
misma casilla.
Definición. En el direccionamiento abierto (open addressing), cada casilla guarda como máximo una clave y no hay ninguna estructura fuera del arreglo. Cada clave k tiene una secuencia de probing, que es el orden en que se prueban las casillas para esa clave:
s(k, 0), s(k, 1), s(k, 2), ...Insertar es recorrer esa secuencia hasta encontrar una casilla libre. Buscar es recorrer la misma secuencia hasta encontrar la clave o una casilla vacía.
Dos consecuencias salen de inmediato de la definición:
- Como cada casilla guarda una sola clave, n ≤ m. Es decir, α nunca pasa de 1. Con encadenamiento, α = 3 significa listas de 3 en promedio. Aquí α = 3 no existe.
- Toda búsqueda se detiene en una casilla vacía. Por tanto, debe quedar al menos una casilla vacía. Si no, una búsqueda sin éxito daría vueltas para siempre.
Las diferentes formas de direccionamiento abierto solo se distinguen por la secuencia de probing. La más simple de todas es probar la siguiente.
Linear probing
Definición. En el linear probing, la secuencia de la clave k es
s(k, i) = (h(k) + i) mod mA h(k) la llamaremos la casilla inicial de k. Si está ocupada se prueba la de al lado, y al llegar al final del arreglo se da la vuelta a la casilla 0.
El programa probe_trace es una tabla mínima, con enteros como claves y h(k) = k mod m, que muestra cada paso. Se le
da la cantidad de casillas y una lista de órdenes: i inserta y f busca. Con 11 casillas, las claves 14, 25 y 36
tienen la misma casilla inicial, la 3:
$ ./build/probe_trace 11 i14 i25 i36 i5 f36 f47 f6
insertar 14 (inicio 3): 3 <- aquí
insertar 25 (inicio 3): 3 4 <- aquí
insertar 36 (inicio 3): 3 4 5 <- aquí
insertar 5 (inicio 5): 5 6 <- aquí
buscar 36 (inicio 3): 3 4 5 -> está, 3 casillas
buscar 47 (inicio 3): 3 4 5 6 7 -> no está, 5 casillas
buscar 6 (inicio 6): 6 7 -> no está, 2 casillas
tabla: [0:_] [1:_] [2:_] [3:14] [4:25] [5:36] [6:5] [7:_] [8:_] [9:_] [10:_]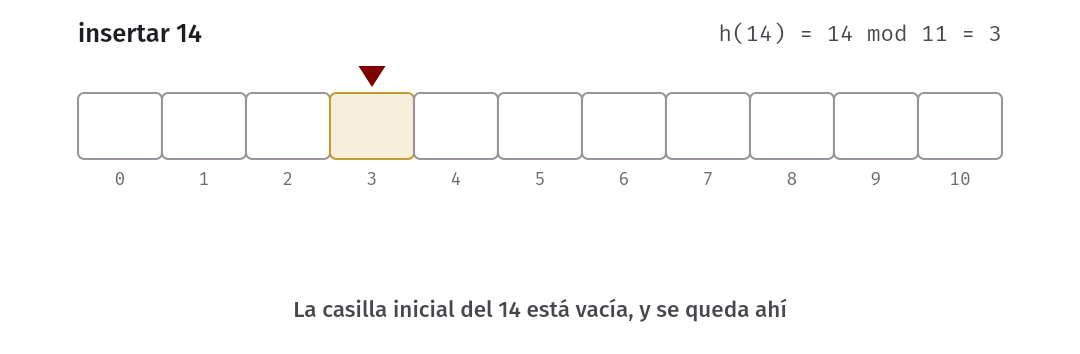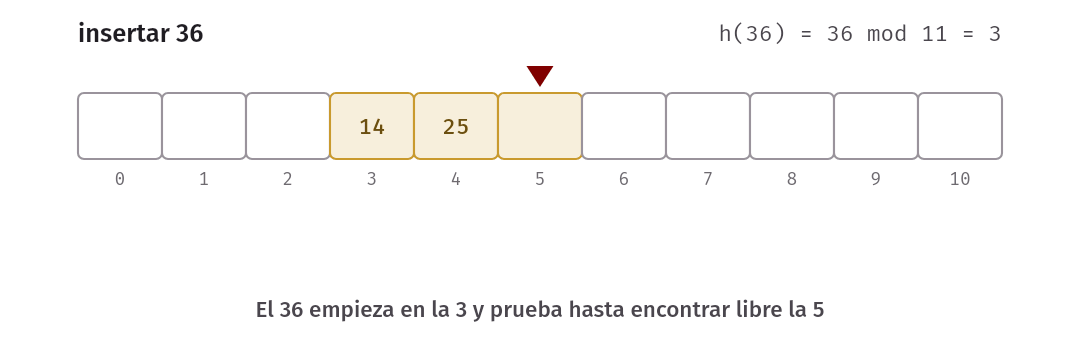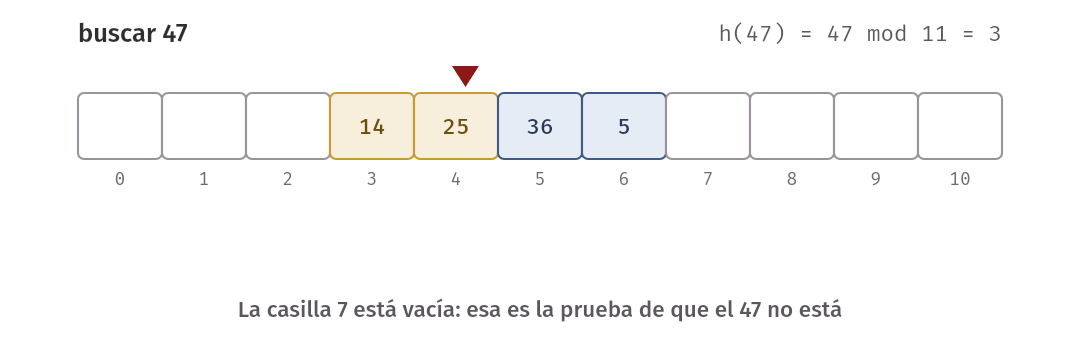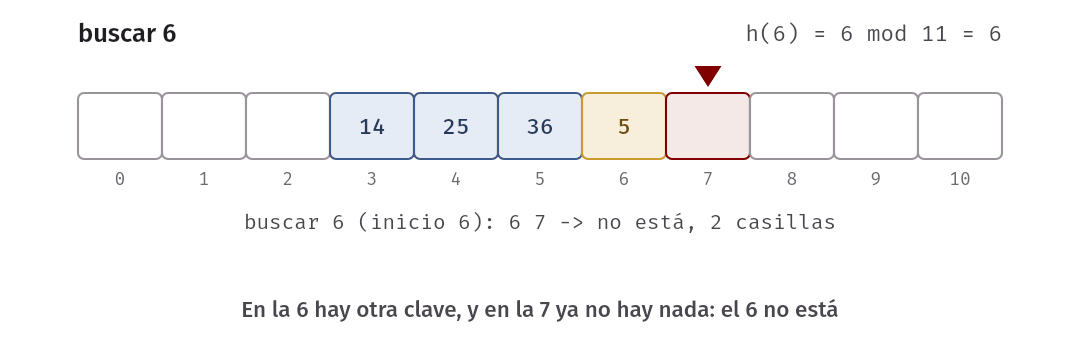
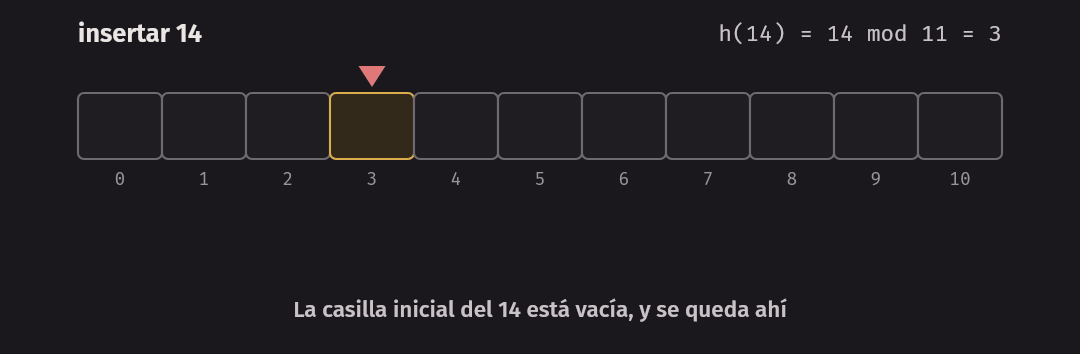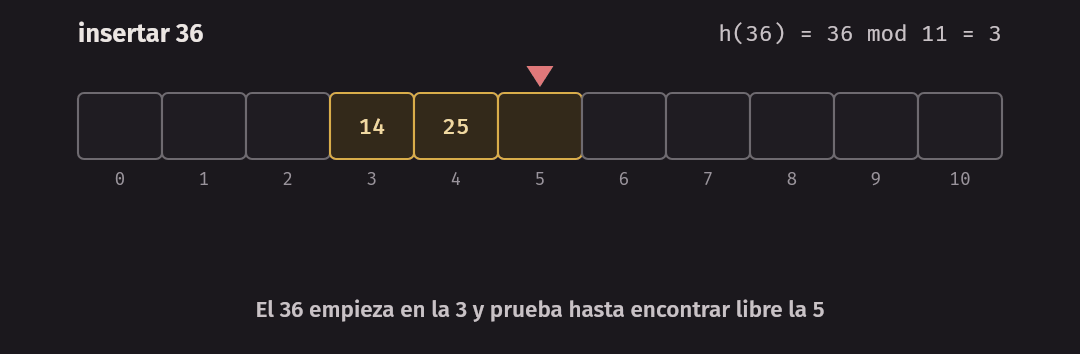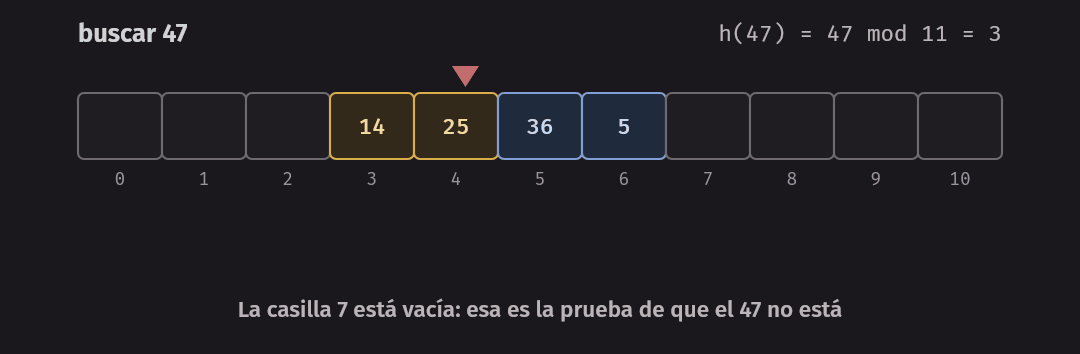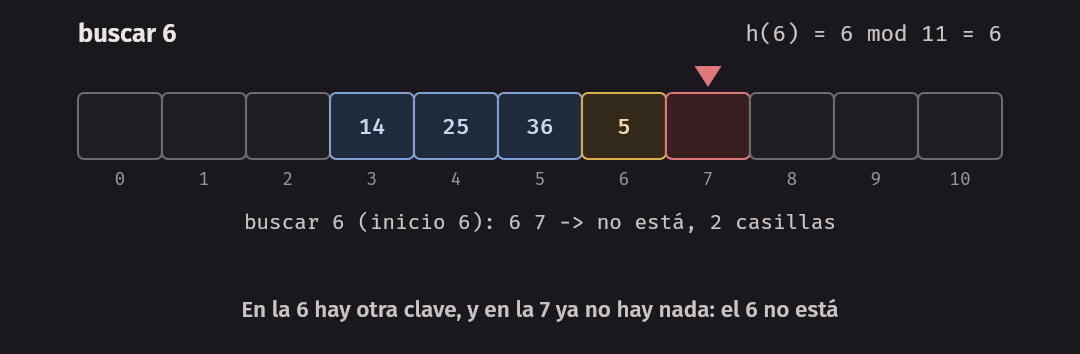
Lean la salida con calma, porque aquí está toda la mecánica. El 25 quería la casilla 3, la encontró ocupada y se quedó en la 4. El 36 terminó en la 5. El 5 no chocó con ninguna clave de su misma casilla inicial, y aun así tuvo que moverse, porque la casilla 5 ya la había tomado el 36. Eso es nuevo: en encadenamiento, dos claves solo compiten si tienen el mismo hash módulo m. Aquí compiten también las que caen cerca.
Buscar 47 termina porque la casilla 7 está vacía. Si el 47 estuviera en la tabla, al insertarlo se habría quedado en esa casilla o antes. Una casilla vacía en el camino es la prueba de que la clave no está.
En todo este capítulo contamos casillas revisadas, incluida la última: la que tiene la clave, o la vacía donde termina la búsqueda. Buscar 47 revisa 5 casillas, aunque compara claves solo en 4 de ellas.
algoritmo buscar(tabla, m, k)
    i ← h(k) mod m
    mientras tabla[i] no esté vacía hacer
        si tabla[i] tiene la clave k entonces
            devolver i
        fin si
        i ← (i + 1) mod m
    fin mientras
    devolver -1
fin algoritmo
La vuelta al final del arreglo no tiene nada de especial. En una tabla de 7 casillas, las claves 6, 13 y 20 tienen todas la
casilla inicial 6. La primera se queda ahí, y las otras dos siguen por la 0 y la 1. Un cúmulo puede cruzar el final del arreglo,
y por eso el mod m no es un adorno:
$ ./build/probe_trace 7 i6 i13 i20 f20 f27
insertar 6 (inicio 6): 6 <- aquí
insertar 13 (inicio 6): 6 0 <- aquí
insertar 20 (inicio 6): 6 0 1 <- aquí
buscar 20 (inicio 6): 6 0 1 -> está, 3 casillas
buscar 27 (inicio 6): 6 0 1 2 -> no está, 4 casillas
tabla: [0:13] [1:20] [2:_] [3:_] [4:_] [5:_] [6:6]
Lean la última búsqueda. El 27 tiene casilla inicial 6, y revisa la 6, la 0, la 1 y la 2, que está vacía. Si nos olvidamos de dar la vuelta, el programa se saldría del arreglo, y ahí sí se enteraría ASan.
La razón por la que este algoritmo es correcto se puede escribir como un invariante de la tabla, y es el invariante más importante de la semana:
Idea clave. Para toda clave k guardada en la casilla j, ninguna de las casillas entre h(k) y j, dando la vuelta si hace falta y sin contar j, está vacía.
Buscar es correcto si y solo si esto se cumple. Insertar lo conserva, porque pone la clave en la primera casilla libre de su camino. Toda operación nueva que escribamos debe conservarlo también, y como vamos a ver, vaciar una casilla no lo conserva.
Esto no se demuestra por inducción; basta mirar cada operación. Si la tabla cumple la propiedad antes de la operación, se revisa que siga cumpliéndola después. La casilla que acaba de ocuparse no estaba en el camino de ninguna clave como casilla vacía, porque si lo hubiera estado, esa clave no cumplía la propiedad antes.
Agrupamiento primario
El linear probing tiene un defecto que se ve en el ejemplo anterior. Las claves 14, 25, 36 y 5 formaron un bloque continuo de casillas ocupadas, de la 3 a la 6. Un bloque así se llama cúmulo (cluster).
Definición. El agrupamiento primario (primary clustering) es la tendencia de los cúmulos a crecer y a fusionarse.
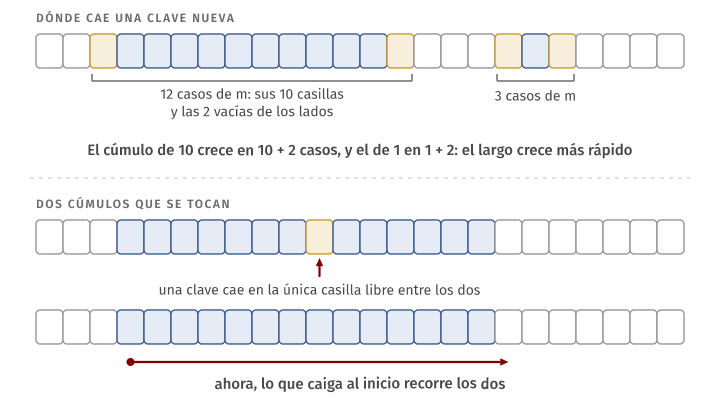
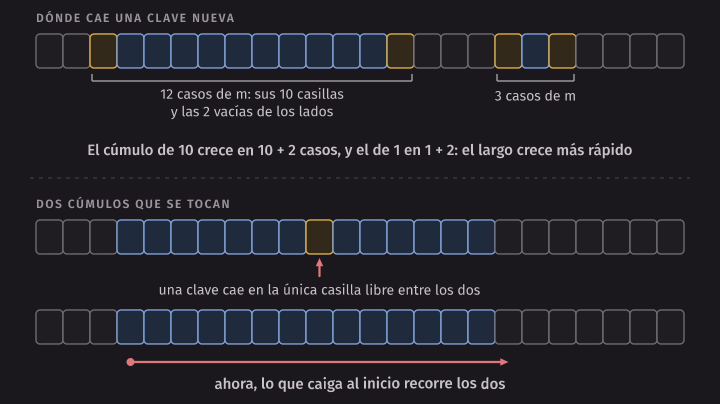
La intuición es sencilla, y es del tipo “al que más tiene, más se le da”. Supongan una tabla con un cúmulo de 10 casillas y otro de 1. Una clave nueva con casilla inicial al azar:
- Alarga el cúmulo de 10 si cae en cualquiera de sus 10 casillas o en una de las dos vacías que lo rodean, porque al llenarse queda pegada a él. Son 12 casos de m.
- Alarga el cúmulo de 1 solo en 3 casos de m.
Así, los cúmulos largos crecen más rápido que los cortos. Y cuando dos cúmulos crecen hasta tocarse, se vuelven uno solo, y buscar algo que caiga al inicio de ese cúmulo recorre los dos. Por eso el costo no crece suave con α: al acercarse a 1 se dispara.
¿Cuánto? Hay un análisis clásico de Knuth, de 1963, que no vamos a demostrar porque necesita probabilidad que todavía no han llevado. Si las casillas iniciales son uniformes e independientes, el promedio de casillas revisadas es:
búsqueda con éxito:   (1 + 1/(1 - α)) / 2
búsqueda sin éxito:   (1 + 1/(1 - α)²) / 2
Una fórmula sin demostración hay que comprobarla, y eso sí podemos hacer. El programa probing_counts llena una tabla
de 2²⁰ casillas con números al azar de 64 bits, con semilla fija, y cuenta. Aquí no hay reloj: solo conteos, así
que da lo mismo en cualquier máquina donde corra. También cuenta con encadenamiento, en nodos visitados, y con un
tercer esquema, el double hashing, donde el salto entre casillas depende de la clave. Dos claves con
la misma casilla inicial siguen caminos distintos, así que no hay agrupamiento primario, y sirve de comparación: lo
que el linear probing cuesta de más sobre esa columna es el precio de los cúmulos.
$ ./build/probing_counts
Con éxito: casillas o nodos revisados por búsqueda, promedio
 alfa   linear fórmula   double  cadenas
 0.25     1.17     1.17     1.15     1.12
 0.50     1.50     1.50     1.39     1.25
 0.70     2.17     2.17     1.72     1.35
 0.80     3.02     3.00     2.01     1.40
 0.90     5.64     5.50     2.56     1.45
 0.95    10.97    10.50     3.16     1.48
 0.99    52.49    50.50     4.67     1.50

Sin éxito: casillas o nodos revisados por búsqueda, promedio
 alfa   linear fórmula   double  cadenas
 0.25     1.39     1.39     1.33     0.25
 0.50     2.50     2.50     2.00     0.50
 0.70     6.05     6.06     3.33     0.70
 0.80    13.11    13.00     4.99     0.80
 0.90    52.97    50.50     9.96     0.90
 0.95   209.49   200.50    19.91     0.95
 0.99  4468.88  5000.50    99.87     0.99
Tres cosas para mirar:
- La fórmula y la medición coinciden muy bien para α ≤ 0.9. Con α = 0.99 la búsqueda sin éxito se separa: revisa 4469 casillas en vez de 5000. No es un desacuerdo con la fórmula, que habla de un promedio. Con α tan alto, ese promedio depende de unos pocos cúmulos gigantes, y una sola tabla varía mucho: al repetirlo con otras tres semillas, en otro programa, salieron unas 3400, 5600 y 6400.
- Con α = 0.5, una búsqueda sin éxito revisa 2.5 casillas. Con α = 0.9, 53. Con α = 0.99, más de 4000. Pasar de 0.9 a 0.99 agrega solo 9 puntos de carga y multiplica el costo por más de 80.
- En la búsqueda sin éxito, a α = 0.9, el double hashing revisa 10 casillas. El linear probing revisa 53. Esa diferencia es el agrupamiento primario.
¿Y si tomamos otra secuencia? El quadratic probing salta 1, 2, 3, … casillas, y evita los cúmulos contiguos, pero dos claves con la misma casilla inicial todavía recorren el mismo camino: eso se llama agrupamiento secundario. El double hashing evita también ese, porque cada clave calcula su propio salto. La pregunta, entonces, es qué se paga por dejar de probar la casilla de al lado. Lo responderemos dos veces: una midiendo el linear probing, y otra al ver lo que deciden Go y CPython.
Idea clave. Hay que mantener α lejos de 1. Con el linear probing, no es una recomendación de estilo: es la diferencia entre revisar 3 casillas y revisar miles.
Eso explica los números que usan las tablas reales. El blog de Go dice que el factor de carga máximo típico de una
tabla abierta está entre 70 % y 90 %. El dict de CPython no pasa de 2/3.
Borrar: por qué no se puede vaciar la casilla
Con encadenamiento, borrar es sacar un nodo de una lista. Aquí tratemos de hacer lo más natural, que es marcar
la casilla como vacía. La orden e de probe_trace hace exactamente eso, a propósito:
$ ./build/probe_trace 11 i14 i25 i36 e25 f14 f36
insertar 14 (inicio 3): 3 <- aquí
insertar 25 (inicio 3): 3 4 <- aquí
insertar 36 (inicio 3): 3 4 5 <- aquí
borrar 25 vaciando la casilla 4
buscar 14 (inicio 3): 3 -> está, 1 casillas
buscar 36 (inicio 3): 3 4 -> no está, 2 casillas
tabla: [0:_] [1:_] [2:_] [3:14] [4:_] [5:36] [6:_] [7:_] [8:_] [9:_] [10:_]
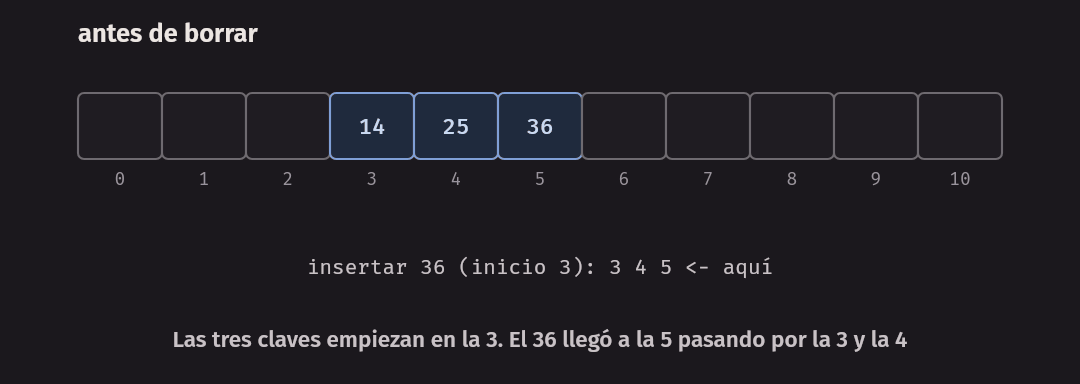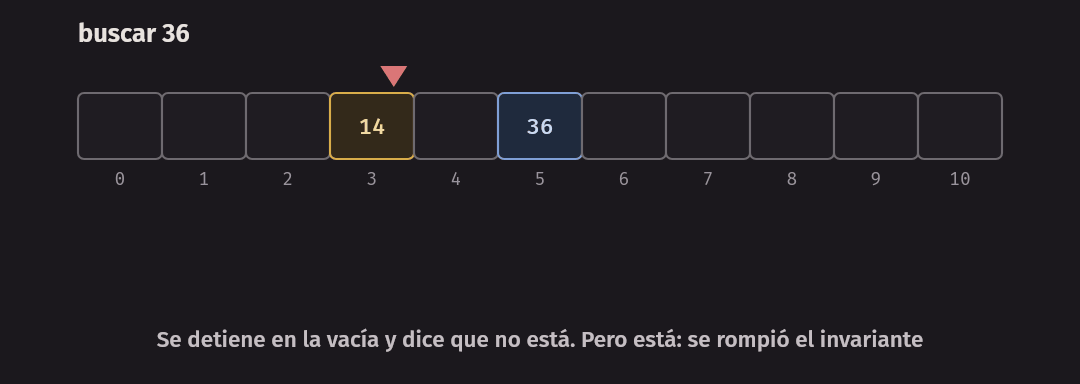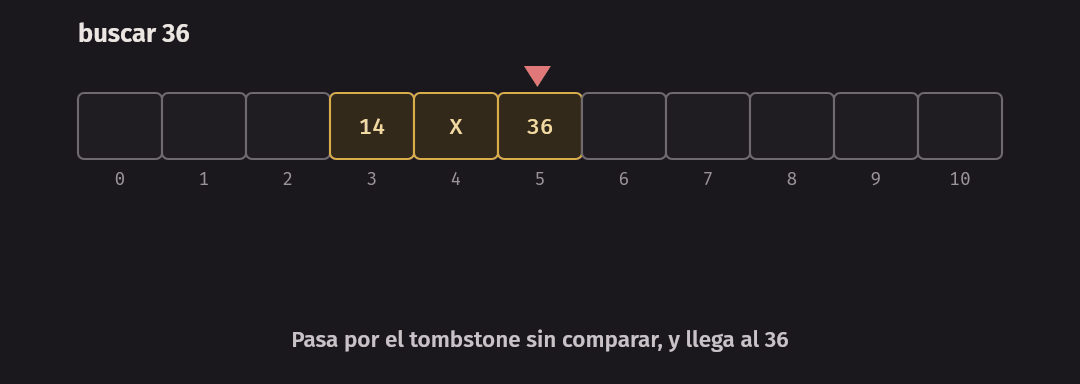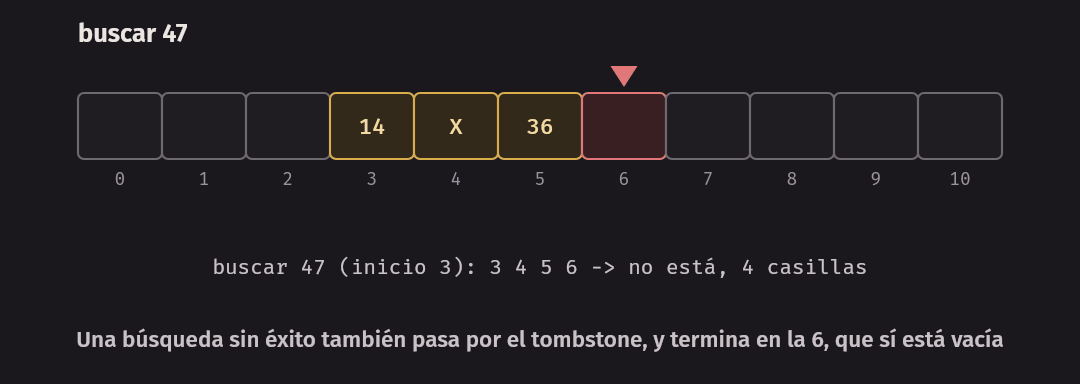
El 36 sigue en la tabla, en la casilla 5, y ya no se puede encontrar. Su búsqueda empieza en la 3, sigue a la 4, ve una casilla vacía y concluye, correctamente según el invariante, que el 36 no está. Lo que está mal es que el invariante se rompió: entre la casilla inicial del 36 y su casilla ahora hay una vacía.
Y no es un error que se note enseguida. El programa no se cae y ASan no dice nada, porque no hay ningún acceso inválido a la memoria. Solo se pierden datos, y solo algunos: las claves que estaban después de la borrada, en el mismo camino.
Tombstones
La solución es que una casilla tenga tres estados, y no dos.
Definición. Un tombstone es una marca en una casilla que dice “aquí hubo una clave, ya no está, y el camino sigue”.
| Estado | ¿Tiene clave? | Al buscar | Al insertar |
|---|---|---|---|
| Vacía | No | Termina: la clave no está | Se puede usar |
| Llena | Sí | Compara la clave y, si no es, sigue | Compara la clave y, si no es, sigue |
| Tombstone | No | Sigue, sin comparar | Se puede usar, si la clave no está más adelante |
Con la orden t, el mismo ejemplo funciona. La X es el tombstone:
$ ./build/probe_trace 11 i14 i25 i36 t25 f14 f36
insertar 14 (inicio 3): 3 <- aquí
insertar 25 (inicio 3): 3 4 <- aquí
insertar 36 (inicio 3): 3 4 5 <- aquí
borrar 25 con tombstone en la casilla 4
buscar 14 (inicio 3): 3 -> está, 1 casillas
buscar 36 (inicio 3): 3 4 5 -> está, 3 casillas
tabla: [0:_] [1:_] [2:_] [3:14] [4:X] [5:36] [6:_] [7:_] [8:_] [9:_] [10:_]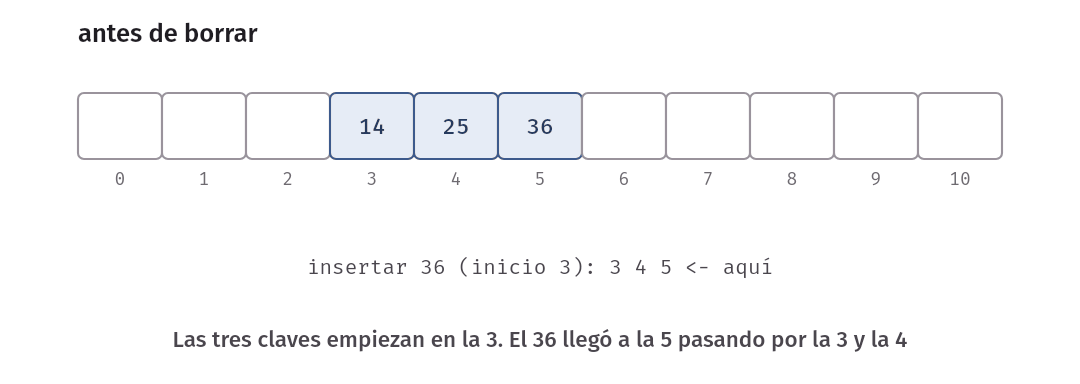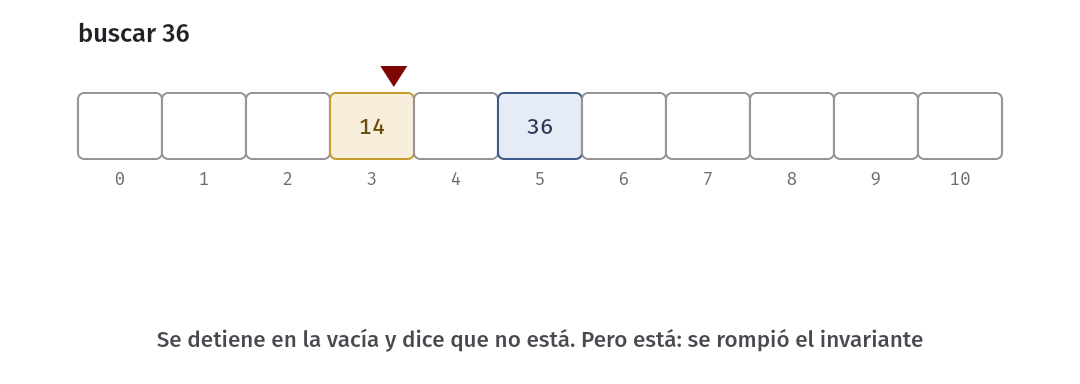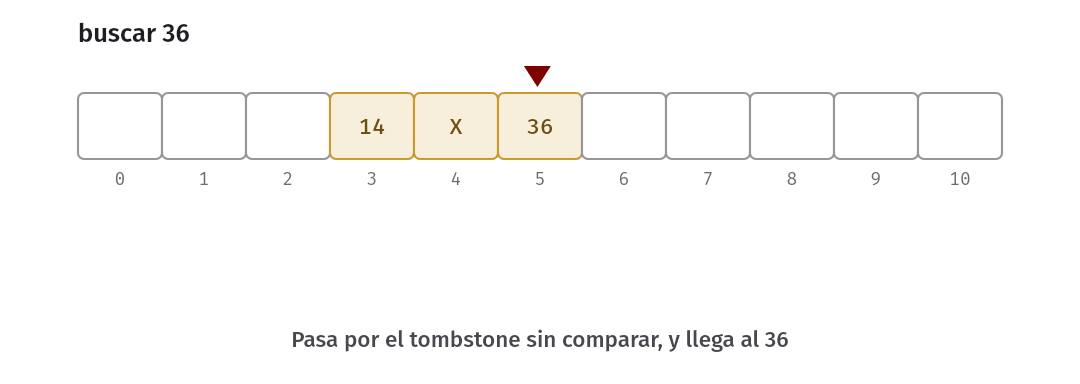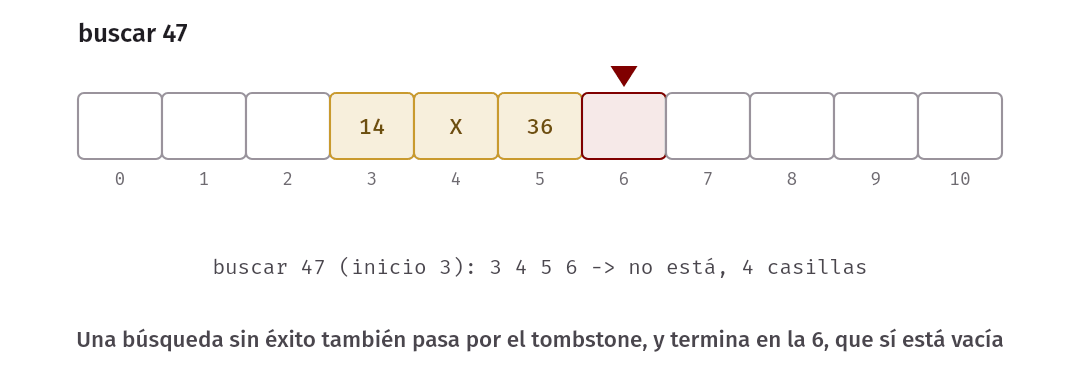
algoritmo borrar(tabla, m, k)
    i ← buscar(tabla, m, k)
    si i = -1 entonces
        devolver falso
    fin si
    marcar tabla[i] como tombstone
    devolver verdadero
fin algoritmo
Error común. Buscar hasta el primer tombstone en vez de hasta la primera casilla vacía. El programa
errors/stop_at_tombstone.cpptiene este error en una sola línea. Un tombstone no dice nada sobre lo que viene después: es justamente la casilla que no debe detener la búsqueda.
$ g++ -Wall -Wextra -std=c++20 errors/stop_at_tombstone.cpp -o build/stop_at_tombstone && ./build/stop_at_tombstone
contains(8) = 1
contains(22) = 0  <- la clave sigue en la tabla
Este error es peligroso porque casi todas las pruebas lo dejan pasar. Si borran una clave y buscan otra de un camino distinto, todo sale bien. Solo falla cuando la clave buscada estaba después de la borrada, en el mismo camino.
Insertar en una tabla con tombstones
Primero veamos cómo se ve un camino con tombstones. El 36 sigue en su casilla 5 después de borrar el 25, y la búsqueda del 47 pasa por el tombstone, porque no sabe qué hay más adelante, y solo se detiene en la casilla 6, que sí está vacía:
$ ./build/probe_trace 11 i14 i25 i36 t25 f47
insertar 14 (inicio 3): 3 <- aquí
insertar 25 (inicio 3): 3 4 <- aquí
insertar 36 (inicio 3): 3 4 5 <- aquí
borrar 25 con tombstone en la casilla 4
buscar 47 (inicio 3): 3 4 5 6 -> no está, 4 casillas
tabla: [0:_] [1:_] [2:_] [3:14] [4:X] [5:36] [6:_] [7:_] [8:_] [9:_] [10:_]
Un tombstone es una casilla libre, así que conviene reusarlo al insertar. Pero aquí hay una trampa, y es el segundo error típico de la semana. La clave que se quiere insertar puede estar más adelante, pasando el tombstone.
Error común. Insertar en el primer tombstone sin terminar de buscar la clave. Si estaba más adelante, ahora está dos veces, y borrarla después deja viva la otra copia.
$ g++ -Wall -Wextra -std=c++20 errors/duplicate_at_tombstone.cpp -o build/duplicate_at_tombstone && ./build/duplicate_at_tombstone
copias de 15 en la tabla: 2
El programa inserta 8 y 15, los dos con casilla inicial 1, y por eso el 15 queda en la casilla 2. Al borrar el 8 queda un tombstone en la 1. Y cuando vuelve a insertar el 15, la casilla 1 parece libre: se queda ahí, y el otro 15 sigue en la 2.
La regla correcta tiene dos pasos. Primero se recorre el camino hasta una casilla vacía, recordando el primer tombstone que aparezca. Si en el camino sale la clave, se reemplaza su valor y se acabó. Si se llega a la vacía, la clave no está, y se usa el tombstone recordado o, si no hubo ninguno, la casilla vacía. Reusar un tombstone tiene una ventaja adicional: no aumenta la cantidad de casillas no vacías.
Muchos tombstones vuelven lenta una tabla casi vacía
Los tombstones resuelven el problema de borrar, pero no salen gratis. Toda búsqueda sin éxito se detiene en una casilla vacía, y cada tombstone es una casilla que ya no está vacía. Para el costo de buscar, un tombstone pesa igual que una clave.
El programa tombstone_counts lo muestra con una tabla de 1024 casillas, en la que siempre hay solo 100 claves. Es
decir, α = n/m ≈ 0.10, muy por debajo de cualquier límite. Un cambio borra una clave al azar e inserta otra nueva.
Son tres políticas, y de nuevo todo es conteo:
$ ./build/tombstone_counts
Tabla de 1024 casillas con 100 claves vivas (alfa real = 0.10).
Un cambio borra una clave e inserta otra. "casillas" es el promedio que revisa
una búsqueda sin éxito, con 2000 búsquedas.

Nunca se limpia y nunca se reúsa:
   cambios tombstones     casillas     rebuilds
         0          0          1.1            0
       100        100          1.3            0
       500        500          3.4            0
       923        923        515.2            0
(solo queda una casilla vacía: sin reusar tombstones ya no se puede insertar)

Se reúsan tombstones al insertar:
   cambios tombstones     casillas     rebuilds
         0          0          1.1            0
       100         96          1.3            0
       500        388          1.9            0
      1000        601          3.2            0
      5000        921        185.9            0
     50000        924       1024.0            0

Se reúsan y se reconstruye al pasar 0.7:
   cambios tombstones     casillas     rebuilds
         0          0          1.1            0
       100         96          1.3            0
       500        388          1.9            0
      1000        601          3.2            0
      5000        597          3.1            4
     50000        612          3.3           48
La primera tabla nunca reúsa tombstones: tras 923 cambios le queda una sola casilla vacía, y una búsqueda sin éxito revisa en promedio la mitad de la tabla. La segunda las reúsa, y solo se demora más en llegar a un final parecido. Con 50 000 cambios no le queda ninguna vacía, y una búsqueda sin éxito revisa las 1024 casillas de una tabla que tiene 100 claves. Reusar no basta, porque una inserción consume una vacía cada vez que su clave no encuentra un tombstone en el camino, y ninguna operación devuelve casillas vacías.
Idea clave. Lo que decide el costo de buscar no es α = n/m, sino (n + t)/m, donde t es la cantidad de tombstones. Por eso una tabla con muchos tombstones es lenta aunque tenga pocos elementos: para una búsqueda sin éxito, está llena.
La tercera política arregla esto de raíz. Cuando las casillas no vacías pasan de un límite, reconstruye: reserva un arreglo nuevo, reinserta solo las claves vivas y olvida los tombstones. Con eso se queda en unas 3 casillas por búsqueda, sin importar cuántos cambios pasen.
Limpiar y crecer son la misma operación
Vean que reconstruir ya lo sabíamos hacer: es lo que hace una tabla al crecer. Solo cambia el tamaño nuevo.
- Si la tabla llegó a su límite con muchas claves, se duplica.
- Si llegó con pocas claves y muchos tombstones, se reconstruye con la misma capacidad, y eso solo limpia.
Open Data Structures hace lo mismo con otros números. Su LinearHashTable lleva un contador q de casillas no vacías
y reconstruye cuando 2(q + 1) supera el tamaño. Allí también hay reducción: si 8n baja del tamaño, reconstruye con menos
casillas.
¿Cuánto cuesta limpiar? Una reconstrucción cuesta Θ(m). Pero si solo limpiamos cuando n es a lo sumo la mitad del límite α_max · m, entonces las casillas no vacías pasan a ser pocas, y hacen falta al menos α_max · m / 2 inserciones que consuman una casilla vacía para volver al límite. Es el mismo argumento de la semana 4: repartido entre esas inserciones, el costo por operación es O(1) amortizado.
Y si la tabla llega al límite con más de la mitad de claves vivas, entonces conviene duplicar, porque limpiar liberaría poco y habría que volver a limpiar pronto. Esa regla, con ese umbral, es la que usarán en el laboratorio.
Una tabla de verdad
En el laboratorio van a escribir ProbingHashMap<V> con la misma interfaz y el mismo comportamiento que HashMap<V> de la semana 7: una
tabla nueva tiene 8 casillas, bajar el factor de carga máximo la hace crecer de inmediato, y una tabla de la que se movió queda vacía y
usable, con capacity() igual a 0. Las pruebas comunes de lab/tests/map_suite.h son una copia exacta de las de la semana 7, con los
mismos nombres, y por eso sus dos tablas pasan por la misma lista. Aquí van las decisiones de
diseño. No damos el código de set ni de rebuild_for, que es lo que ustedes van a escribir.
Cada casilla guarda su estado, su clave y su valor:
enum class State : unsigned char { empty, full, tombstone };

struct Slot {
    State state = State::empty;
    std::string key;
    V value{};
};
La clase declara sus invariantes y check_invariants los comprueba. Fíjense en los dos últimos: el primero es lo que
garantiza que toda búsqueda termina, y el segundo es la idea clave de este capítulo, puesta en un comentario.
// Invariantes:
// - capacity_ == 0 si y solo si slots_ es nulo. Solo ocurre en un objeto del que se movió.
// - Si capacity_ > 0, capacity_ es 8 multiplicado por una potencia de 2.
// - size_ cuenta las casillas llenas y tombstones_ los tombstones.
// - size_ + tombstones_ <= max_load_ * capacity_, con max_load_ < 1: siempre queda al menos una
//   casilla vacía, y por eso toda búsqueda termina.
// - No hay claves repetidas. Entre la casilla inicial de una clave y la casilla donde está, sin
//   contar esta última, no hay ninguna casilla vacía.
La capacidad es una potencia de 2. Así, h(k) mod m es un simple hash & (capacity_ - 1), sin dividir. La misma
máscara sirve para dar la vuelta. Esto solo es razonable si los bits bajos del hash reparten bien, y FNV-1a, que usamos
desde la semana 7, los reparte razonablemente. Una tabla con hash de mala calidad usaría un número primo de casillas,
o mezclaría más los bits.
El factor de carga máximo tiene que ser menor que 1. set_max_load_factor rechaza 1 o más con un assert, porque
sin una casilla vacía una búsqueda sin éxito no termina. Lo mismo no pasa con HashMap<V>, que acepta 2 o 4 sin ningún
problema: la lista de una casilla crece lo que haga falta. Por eso los valores por defecto son distintos: 1.0 en la semana 7, y
0.7 aquí, dentro del rango de 70 % a 90 % que menciona el blog de Go.
Lo que se cuenta contra el límite es size_ + tombstones_. Eso es lo que dicta la idea clave anterior.
FNV-1a va dentro de la clase. Su corrector incluye esta tabla y la de la semana 7, y esa ya define una función libre
fnv1a. Si esta tabla definiera otra función con el mismo nombre, el programa no compilaría. Por eso aquí se llama
ProbingHashMap::hash_of:
static std::uint64_t hash_of(const std::string& key) {Una función extra: probes_for. Dice cuántas casillas revisa buscar una clave, contando la última. Sirve para
probar que la tabla no se vuelve lenta sin usar el reloj: las pruebas cuentan casillas, que siempre dan lo mismo, en vez
de tiempos, que cambian con la máquina.
Cómo probar una tabla de este tipo
Las operaciones al azar contra std::unordered_map son indispensables, pero casi nunca hacen caer a alguien en los dos errores de
los tombstones. Con pocos borrados y una tabla poco cargada, las claves rara vez comparten camino. Por eso hacen falta pruebas
dirigidas: buscar claves que tengan la misma casilla inicial, borrar la primera y pedir la segunda. map_tests.cpp las fabrica con
una función corta, probando números hasta encontrar colisiones:
std::vector<std::string> colliding_keys(std::size_t capacity, std::size_t count) {La otra pieza es check_invariants, que aquí comprueba mucho más que un contador. Para cada clave recorre su camino y verifica que
no haya una casilla vacía antes de llegar a ella. Una tabla con el invariante roto puede responder bien a muchas consultas y
fallar en la siguiente, y esta función la delata de inmediato.
Por último, la prueba que pide la guía: insertar y borrar muchas veces y comprobar que las búsquedas no se vuelven lentas. El reloj
no sirve para eso, porque cambia con la máquina y con lo que esté corriendo. En cambio, probes_for cuenta casillas. Después de
50 000 cambios con 100 claves vivas, el promedio de casillas de una búsqueda sin éxito debe ser pequeño. Sin limpiar tombstones, sería
casi el tamaño de la tabla.
En C++.
new Slot[capacity]construye todas las casillas, así queVdebe tener constructor por defecto. Es una limitación real de esta tabla, yHashMap<V>con nodos no la tiene: cada nodo se construye con su valor. Se puede evitar con memoria sin inicializar, pero no vale la pena aquí. Por la misma razón, un tombstone conserva unstd::stringy unVvacíos, que hay que dejar en su estado inicial al borrar. Si no, unVque tenga memoria reservada la retiene hasta la siguiente reconstrucción, y hay una prueba para eso.
Error común. Guardar el puntero que devuelve
gety seguir insertando. Sisetreconstruye la tabla, el arreglo cambia de lugar y el puntero queda colgando, igual que un iterador destd::vectordespués de crecer, como vimos en la semana 4.
En la biblioteca.
std::unordered_mapno puede ser una tabla abierta como esta. La norma de C++ pide que insertar no invalide punteros ni referencias a los elementos, aunque sí pueda invalidar los iteradores. También ofrece una interfaz de casillas,begin(n)yend(n), para recorrer una casilla. Si los elementos estuvieran dentro del arreglo, crecer los movería. La pruebatest_demos.cppcomprueba que un puntero sobrevive a todas las reconstrucciones. Por eso libstdc++ reserva un nodo por elemento, y por eso existen otras tablas, como las que veremos abajo: quien acepta perder esa garantía puede tener un diseño más compacto.
Encadenamiento frente a linear probing
Ya tenemos todo para comparar. Empecemos por lo que dice el análisis, en la tabla de probing_counts:
| α | Con éxito, linear | Con éxito, cadenas | Sin éxito, linear | Sin éxito, cadenas |
|---|---|---|---|---|
| 0.50 | 1.50 | 1.25 | 2.50 | 0.50 |
| 0.70 | 2.17 | 1.35 | 6.05 | 0.70 |
| 0.90 | 5.64 | 1.45 | 52.97 | 0.90 |
Son conteos, no tiempos. Con encadenamiento se cuentan nodos visitados, y una búsqueda sin éxito puede visitar cero nodos si la lista está vacía. En cualquiera de las dos columnas, el encadenamiento revisa menos, y la diferencia crece con α. Esto no es una opinión, sale del conteo y es lo que dice el análisis.
Sin embargo, hay un argumento fuerte a favor del linear probing, y es por el que CLRS lo destaca en su 4.ª edición. No todo acceso a la memoria cuesta lo mismo. Recuerden la semana 5: la CPU trae de la memoria bloques enteros, las líneas de cache, así que leer la casilla de al lado suele ser gratis una vez que se leyó la anterior, mientras que seguir un puntero a un nodo cualquiera puede costar un viaje a la RAM. Revisar 3 casillas contiguas podría ser más rápido que visitar 1 nodo.
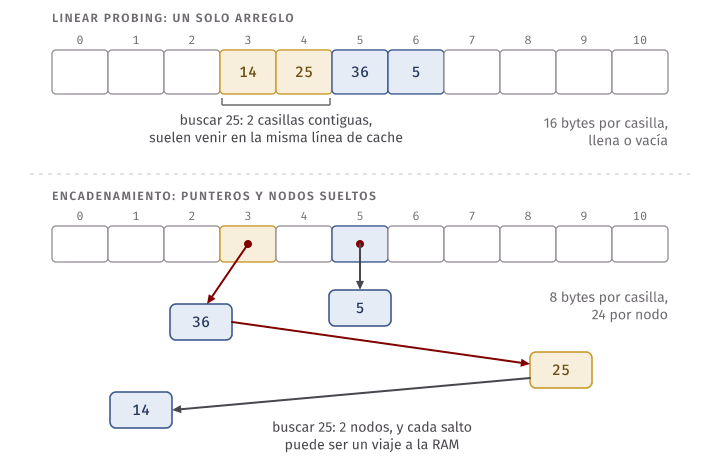
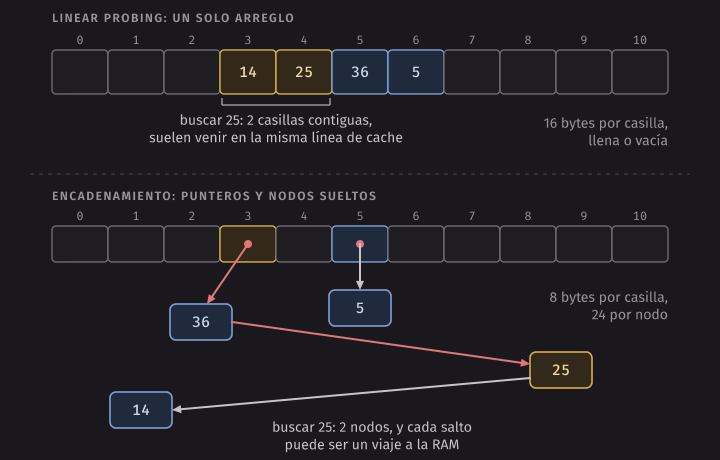
Hay que medir para saber si es cierto, y en qué casos. layout_bench usa las mismas claves enteras al azar, las mismas
casillas y el mismo α en las dos tablas, y mide búsquedas en orden al azar. Se compila con -O2 y sin sanitizers, cada
número es la mediana de 5 rondas de un millón de búsquedas, y los tiempos son de un contenedor arm64 en una máquina
ocupada con otros procesos, así que lo absoluto cambia de corrida en corrida. Las últimas dos columnas son bytes por
clave.
$ ./build/layout_bench
ns por búsqueda, mediana de 5 rondas de 1000000. Bytes por clave.
cas.   alfa   lin.hit   cad.hit  lin.miss  cad.miss     lin.B     cad.B
2^12   0.50       5.6       3.2      11.1       5.5      32.0      40.0
2^12   0.75       8.5       4.6      15.9       8.7      21.3      34.7
2^12   0.90      13.3       6.3      49.8      11.3      17.8      32.9
2^16   0.50       7.5       6.1      18.9       9.1      32.0      40.0
2^16   0.75      13.1       7.5      28.4      14.4      21.3      34.7
2^16   0.90      22.6       9.9      71.0      14.3      17.8      32.9
2^20   0.50      10.0      14.1      29.1      16.1      32.0      40.0
2^20   0.75      14.3      15.3      36.7      18.5      21.3      34.7
2^20   0.90      20.7      14.7      79.1      21.6      17.8      32.9
2^22   0.50      12.8      17.7      45.6      19.0      32.0      40.0
2^22   0.75      22.4      21.5      83.8      26.8      21.3      34.7
2^22   0.90      46.2      27.5     150.1      30.1      17.8      32.9
Corrimos esto tres veces, y solo vamos a afirmar lo que se repitió en las tres:
- Búsquedas sin éxito: el encadenamiento ganó en las tres corridas y en todas las filas. No hay sorpresa, y el conteo lo explica: con α = 0.5 revisa 0.5 nodos, y el linear probing, 2.5 casillas.
- Tablas pequeñas (2¹² y 2¹⁶): el encadenamiento ganó siempre, también con éxito. Una clave es un
uint64_t, y el conteo también favorece al encadenamiento: 1.25 contra 1.50, con α = 0.5. - Tablas grandes con α = 0.5, búsquedas con éxito: aquí el linear probing ganó las tres veces, a pesar de revisar más casillas. En 2²⁰ casillas: 10.0 contra 14.1 ns, 7.0 contra 9.0 y 8.0 contra 11.3. En 2²²: 12.8 contra 17.7, 15.4 contra 23.6 y 14.4 contra 23.6.
- Tablas grandes con α = 0.9: ganó el encadenamiento las tres veces, porque ya se notan las 5.6 casillas contra 1.45 nodos.
- Con α = 0.75 en tablas grandes: el resultado cambió entre corridas o las diferencias fueron pequeñas. No concluimos nada.
- Memoria: el linear probing usó menos bytes por clave en todas las filas, porque no paga un puntero por casilla más un nodo por clave, y este conteo no incluye lo que el reservador agrega a cada nodo.
El cambio entre 2¹⁶ y 2²⁰ casillas es lo que se esperaría del efecto de la cache: una tabla pequeña cabe entera en la cache
y una grande no, así que recién en la grande cada salto a un nodo cuesta caro. Probablemente esa sea la explicación, y
es lo que dice CLRS, pero en este contenedor no tenemos perf para contar los fallos de cache, así que no lo hemos
medido. Tampoco sabemos por qué el linear probing es más lento que el encadenamiento en las tablas pequeñas por más de lo
que explica el conteo: 5.6 contra 3.2 ns con α = 0.5, para 1.50 contra 1.25 revisiones. Una hipótesis son los saltos mal
predichos del ciclo, porque no se sabe cuántas vueltas dará, y queda como eso, una hipótesis.
Idea clave. El análisis favorece al encadenamiento cuando α sube, y la memoria contigua favorece al linear probing cuando la tabla es grande y α es moderado. Ninguno de los dos gana siempre. La frase “el linear probing es más rápido por la cache” solo es cierta en una parte de esta tabla, y nada reemplaza a medir con sus datos y en su máquina.
Hay otra ventaja del linear probing que sí es clara y aquí aún no se ve: insertar no reserva memoria. Con encadenamiento, cada inserción pide un nodo. Lo veremos en el corrector, donde cargar un millón de palabras es más del doble de rápido con linear probing.
Caso de estudio: Swiss Tables
Las Swiss Tables son una familia de tablas presentada por un equipo de Google en 2017 y publicada en 2018 como parte
de la biblioteca Abseil de C++, con los nombres absl::flat_hash_map y absl::node_hash_map. Go 1.24, de febrero de
2025, reescribió su tipo map basándose en este diseño. Son direccionamiento abierto: un solo arreglo, con probing y con
tombstones. Solo se agrega una idea, pero es muy buena.
La observación
Miren lo que hace el linear probing cuando la tabla está cargada: comparar claves completas, una tras otra, y casi todas son de otras claves. Con cadenas, cada comparación puede significar un acceso más a la memoria. Casi todo ese trabajo es inútil, y se podría evitar si tuviéramos un resumen muy pequeño de cada clave.
Un byte por casilla
Una Swiss Table guarda, además de las casillas, un byte de metadatos por casilla, llamado byte de control. Divide el hash de 64 bits en dos partes:
- H1, 57 bits según las notas de diseño, que escoge dónde empezar a buscar.
- H2, los otros 7 bits, que se guardan en el byte de control.
Un byte tiene 8 bits, así que queda uno para decir qué tipo de byte es. Si el bit alto es 0, la casilla está llena y los otros 7 son su H2. Si es 1, la casilla no tiene clave, y el valor dice cuál es su estado:
| Byte de control | Significado |
|---|---|
0xxxxxxx |
Llena, con H2 = xxxxxxx |
10000000 |
Vacía |
11111110 |
Borrada: un tombstone |
Es decir, los mismos tres estados de nuestra tabla, más 7 bits del hash. Esto responde para qué sirven esos 7 bits: para evitar comparar claves. Si el H2 de la casilla no coincide con el de la clave buscada, seguro que esa no es la clave, sin haber leído la clave. Si coincide, hay que comparar: dos claves distintas tienen el mismo H2 con probabilidad 1/128, si el hash reparte bien. Una coincidencia falsa cuesta una comparación, y nunca da una respuesta equivocada.
Comparar un grupo entero de una vez
Lo otro es que las casillas se revisan por grupos. Un grupo es un bloque de casillas contiguas, y sus bytes de control están juntos, así que se pueden leer como un solo número y comparar todos a la vez.
En una Swiss Table de Go, un grupo tiene 8 casillas y sus 8 bytes de control forman una palabra de 64 bits. El truco
parece magia, y no necesitan memorizarlo, pero conviene ver que existe y que es corto. Va en nuestro mini_swiss.h, con
la misma fórmula de la implementación portable de Go:
inline std::uint64_t match_h2(std::uint64_t ctrl, unsigned char h2) {
    const std::uint64_t v = ctrl ^ (kLowBits * h2);
    return (v - kLowBits) & ~v & kHighBits;
}
kLowBits * h2 repite h2 en los 8 bytes. El ^ deja en cero justo los bytes que coinciden. Y la última línea es un
truco conocido para marcar bytes en cero: al restar 1 a un byte en cero, le pide prestado al siguiente y deja su bit alto
en 1. El resultado tiene el bit alto encendido en cada byte candidato. group_match lo prueba con una palabra de ejemplo:
$ ./build/group_match
palabra de control: 0x8007fe5980325917
bytes por casilla: 23 89 50 128 89 254 7 128
buscar h2 =  89: casillas candidatas: 1 4
buscar h2 =  50: casillas candidatas: 2
buscar h2 = 100: casillas candidatas: ninguna
casillas vacías: 3 7
otra palabra, bytes por casilla: 2 3 128 128 128 128 128 128
buscar h2 =   2: casillas candidatas: 0 1
Con unas pocas operaciones de bits se revisaron 8 casillas, y solo la 1 y la 4 merecen una comparación de claves. Las dos últimas
líneas muestran, con otra palabra, un detalle honesto del truco: un falso positivo adicional. El byte de la casilla 1
vale 3, no 2, y aun así se marca, porque el préstamo de la resta se propaga al byte siguiente. El propio código de Go lo advierte en un
comentario: esto solo pasa justo después de una coincidencia real, y no molesta, porque de todos modos se comparan las
claves. Una marca de más cuesta una comparación; lo importante es que nunca se pierde una coincidencia real, y eso se
comprueba en test_demos.cpp contra la versión byte por byte, con 200 000 palabras al azar.
Una búsqueda, paso a paso
Usemos los mismos bytes de group_match, y busquemos una clave k en ese grupo. Supongamos que su hash da H2 = 89.
- Con H1 se elige el grupo. Aquí es el que tenemos.
match_h2marca las casillas 1 y 4.- Se compara k con la clave de la casilla 1. Si es igual, terminamos. Si no, se pasa a la 4.
- Si la casilla 4 tampoco tiene a k,
match_emptydice si el grupo tiene alguna vacía. Aquí tiene la 3 y la 7. Por tanto, k no está, y no hace falta mirar otro grupo.
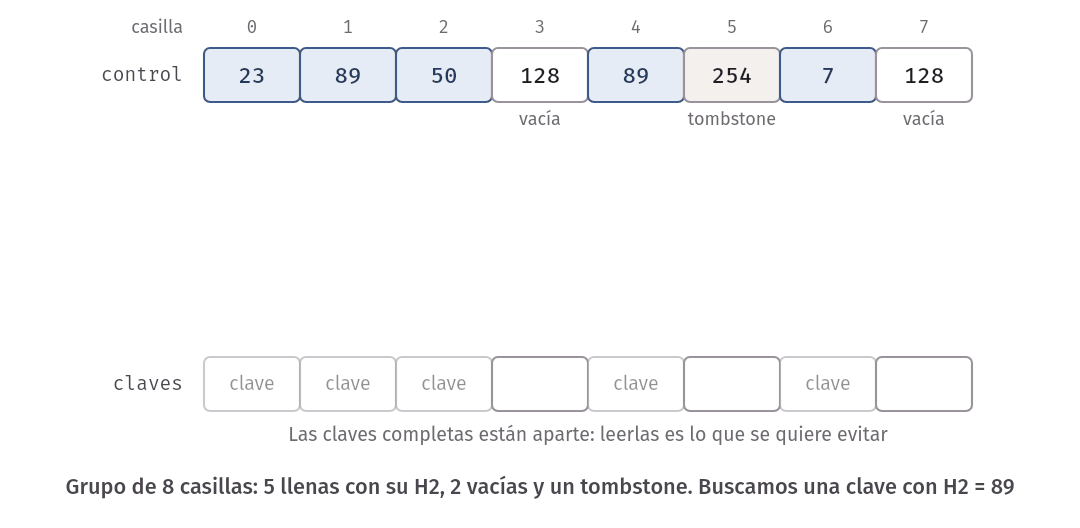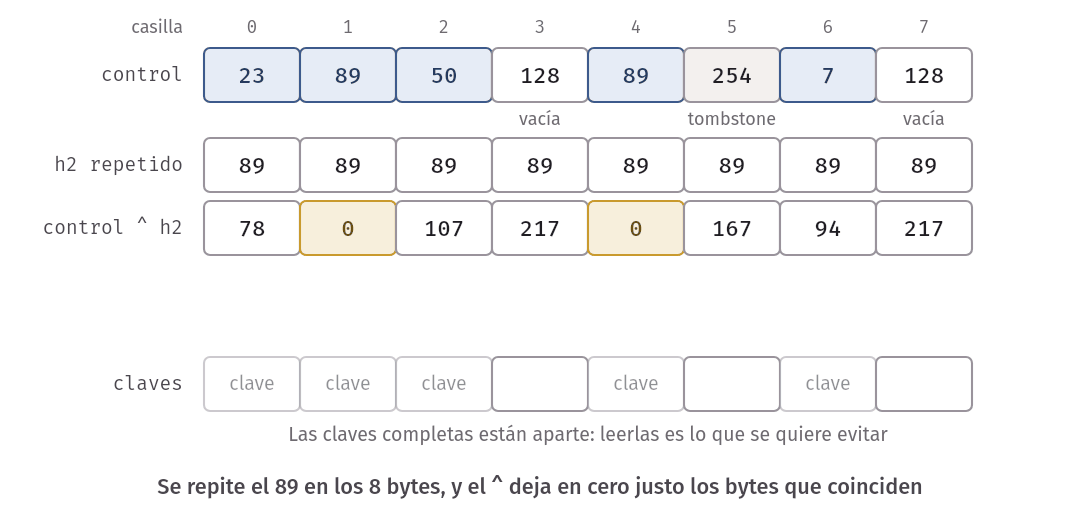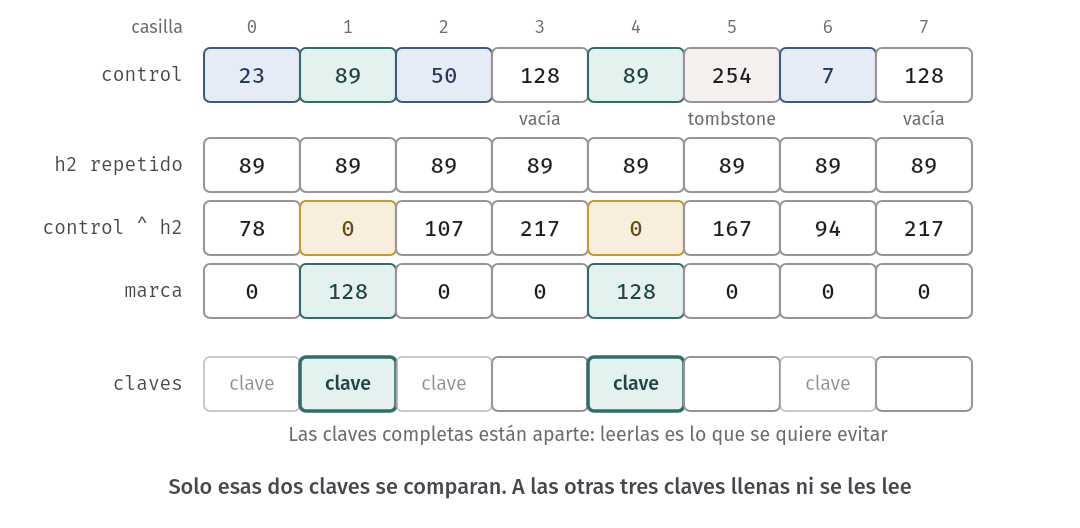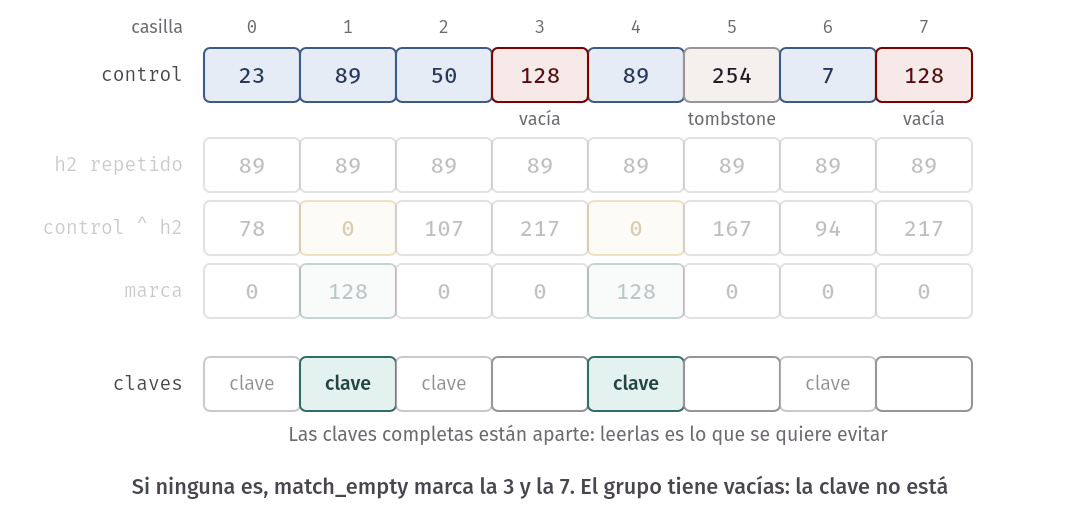
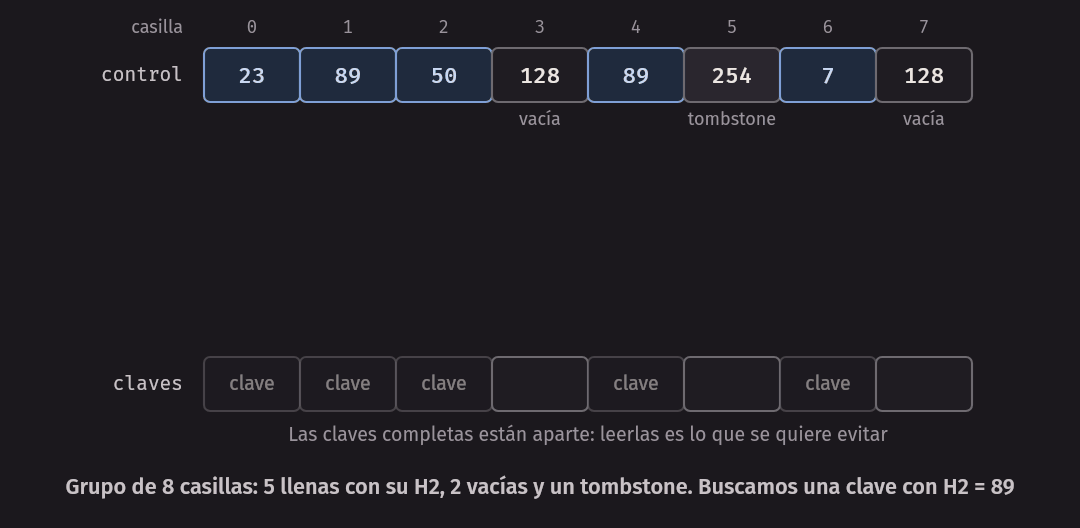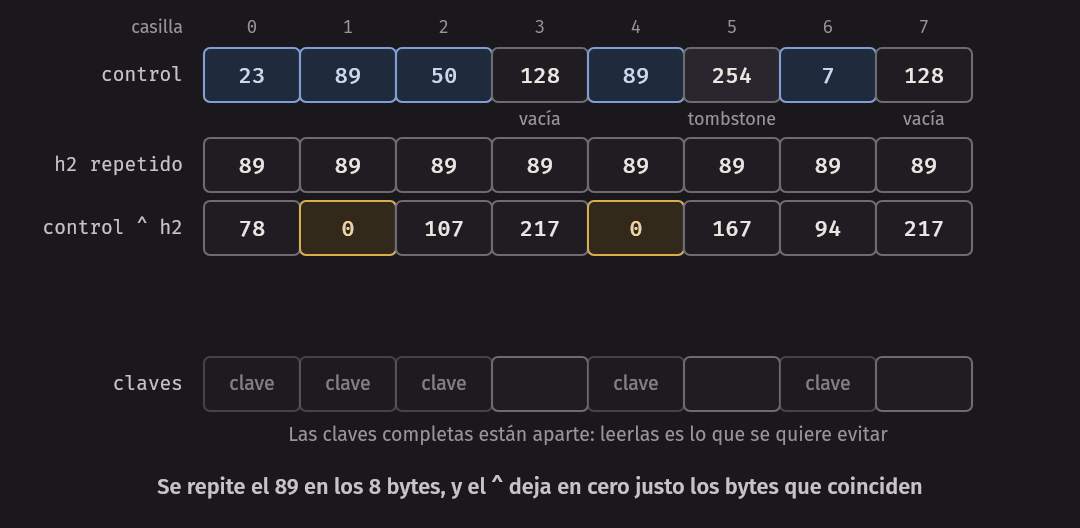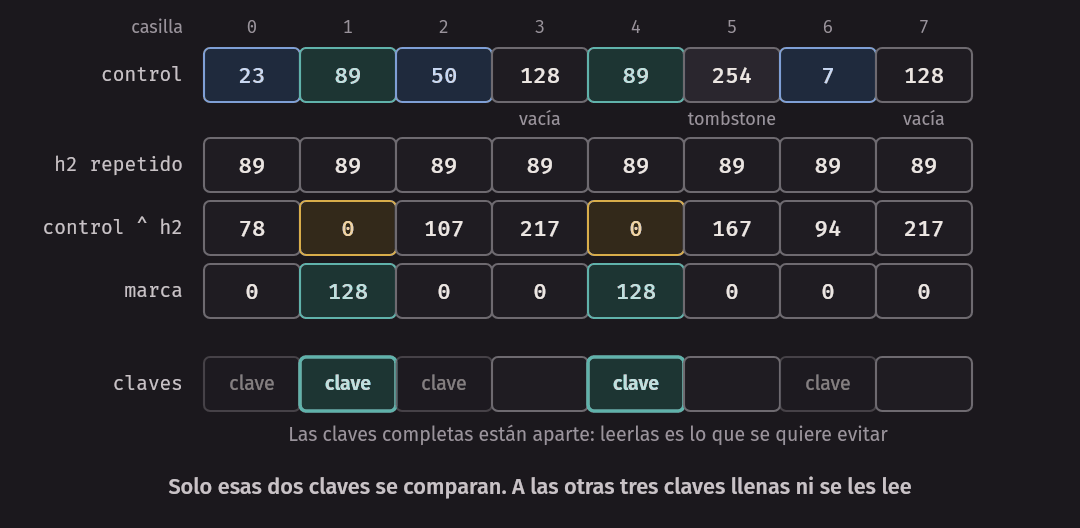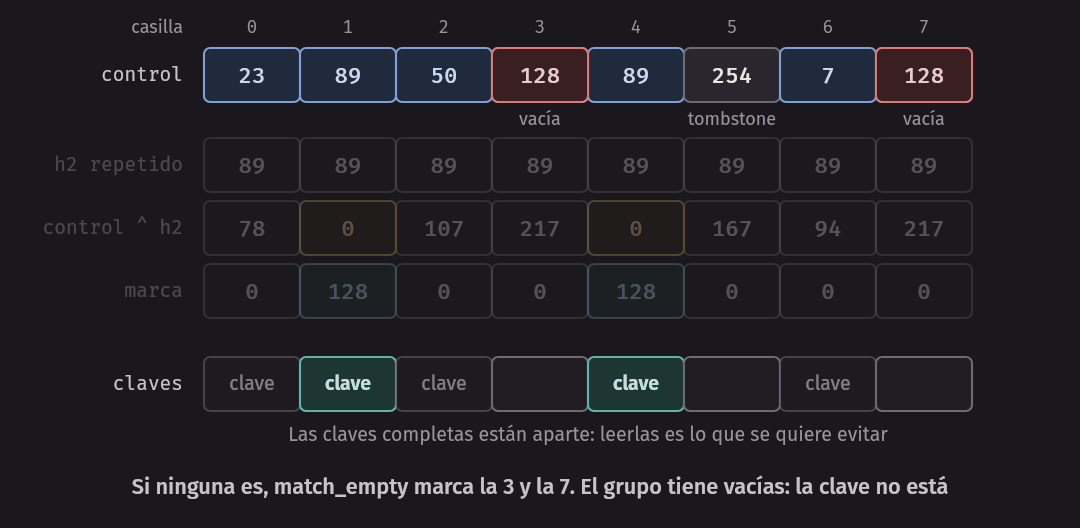
Con 8 casillas de las que 5 están llenas, hicimos 2 comparaciones de claves y, en la mayoría de las búsquedas de otra clave, ninguna. Insertar hace lo mismo, y si k no está, toma la primera casilla libre de ese grupo o de los siguientes.
¿Hasta dónde se busca?
Las reglas son las que ya conocen, con un cambio de escala: un grupo que tiene una casilla vacía termina la búsqueda. Si la clave estuviera más adelante, la inserción habría usado esa casilla. Una casilla borrada no termina nada, igual que en nuestra tabla. Las notas de diseño de Abseil lo dicen con estas palabras: “a deleted element does not cease probing, though an empty element would”.
Entre un grupo y el siguiente no se usa linear probing: Abseil y Go usan quadratic probing, con saltos que aumentan de a uno. Así, los grupos llenos no forman cúmulos tan largos.
Cuánto se ahorra
Nuestra tabla de juguete, MiniSwiss, sigue el diseño de Go y cuenta en vez de medir el tiempo. Con las palabras
de palabras.txt, mezcladas con semilla fija, en 2²⁰ casillas, compara cuántas comparaciones de claves completas hace
contra un linear probing normal. La columna grupos dice cuántos grupos revisa MiniSwiss.
$ ./build/swiss_counts ../../data/palabras.txt
1048576 casillas. Promedios por búsqueda.
      --- con éxito: compara ---          --- sin éxito: compara ---
 alfa       linear        swiss   grupos       linear        swiss   grupos
 0.25         1.17         1.01     1.00         0.39       0.0156     1.00
 0.50         1.50         1.02     1.01         1.51       0.0333     1.06
 0.70         2.17         1.02     1.06         5.03       0.0620     1.39
 0.80         3.00         1.03     1.13        11.99       0.0989     1.92
 0.88         4.48         1.04     1.23        31.14       0.1694     3.01
Con α = 7/8, un linear probing hace 31 comparaciones de cadenas para una búsqueda sin éxito. MiniSwiss hace 0.17, y lee 3
grupos. Con éxito, 4.48 contra 1.04. Es por esto que las Swiss Tables pueden trabajar con α = 7/8, donde el linear probing ya
sufre. Y una α más alta significa menos memoria desperdiciada. Fíjense en que no estamos midiendo tiempo: esta tabla de
juguete no está escrita para ser rápida. Lo que muestra es de dónde sale el ahorro.
Idea clave. Una Swiss Table no cambia lo que hace una tabla abierta, sino dónde mira: primero en un resumen de un byte por casilla, leído por grupos. Las claves se tocan casi solo cuando van a coincidir.
Lo que dicen las fuentes, con sus diferencias
“Swiss Table” es un diseño, no un programa, y las implementaciones difieren. Conviene no mezclarlas. Todo lo que sigue se revisó en las notas de diseño de Abseil, en el código de Abseil, en el blog de Go y en el código de Go 1.24.0:
| Abseil (C++) | Go 1.24 | |
|---|---|---|
| Casillas por grupo | 16 con SSE2 en x86; 8 con NEON o la versión portable | 8 |
| Bytes de control | En un arreglo aparte de las casillas | Una palabra de 64 bits en cada grupo |
| Grupos | No necesariamente alineados: empiezan donde caiga el hash | Fijos: bloques del arreglo |
| H2 | 7 bits del hash; en el código revisado, los más altos | Los 7 bits más bajos |
| Entre grupos | Quadratic probing | Quadratic probing |
| Factor de carga máximo | 7/8 en tablas grandes | 7/8 (7 de 8 casillas por grupo, en promedio) |
| Crecimiento | Toda la tabla de una vez | Una tabla por partes, con cada parte de hasta 1024 entradas |
| Comparación | SSE en x86; bits u otras instrucciones en otras arquitecturas | Bits, como arriba; SIMD de 8 bytes en amd64 |
La fila de crecimiento muestra que no es solo un detalle. Go se usa mucho en servidores, donde una pausa larga al duplicar
una tabla de 1 GB es inaceptable. Por eso cada map de Go son varias tablas independientes, y crecer solo afecta a una
de ellas, de como máximo 1024 entradas. Go también permite modificar un map mientras se recorre, cosa que Abseil
prohíbe, y el blog cuenta que eso fue lo más complicado de toda la implementación.
Hay otro detalle de Go que vale la pena porque matiza lo que dijimos sobre borrar. Si el grupo de la clave borrada todavía tiene una casilla vacía, Go puede marcar la casilla como vacía sin dejar un tombstone: las búsquedas que llegan a ese grupo se iban a detener ahí de todos modos. Solo deja un tombstone si el grupo está lleno. Esto es posible porque la unidad que decide terminar la búsqueda es el grupo, no la casilla, así que no contradice lo que vimos para el linear probing.
¿Y cuánto se ganó? El blog de Go da dos números, y conviene mirar los dos: en microbenchmarks, las operaciones de map
son hasta 60 % más rápidas que en Go 1.23; en aplicaciones completas, la mejora de tiempo de CPU es de alrededor de 1.5 %
(media geométrica). Ninguno miente. Una tabla mucho más rápida se nota poco en un programa que hace muchas otras cosas.
Caso de estudio: el dict de CPython
Python usa diccionarios para casi todo: las variables globales, los atributos de un objeto y los argumentos con nombre. Su
tabla es de direccionamiento abierto, y de nuevo hay una idea nueva. Lo que sigue describe CPython 3.14.10, la versión
del entorno del curso, y se revisó en los comentarios de
Objects/dictobject.c y en la documentación de esa
misma versión. Es una descripción de CPython, no del lenguaje: otras implementaciones de Python pueden hacerlo distinto.
Dos arreglos
Una tabla abierta típica desperdicia memoria: si cada casilla ocupa 24 bytes (hash, puntero a la clave y puntero al valor) y hay un tercio de casillas libres, ese tercio son 24 bytes por casilla que no guardan nada. La idea de CPython es separar la tabla en dos arreglos:
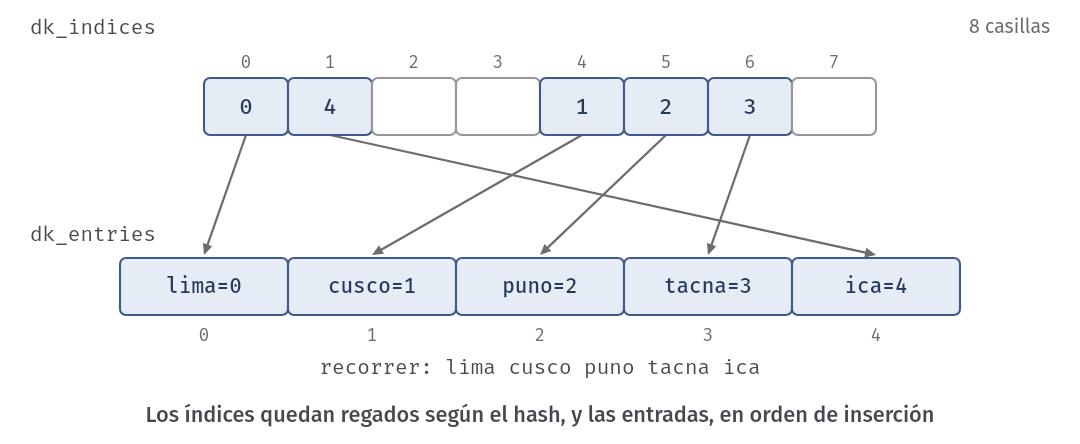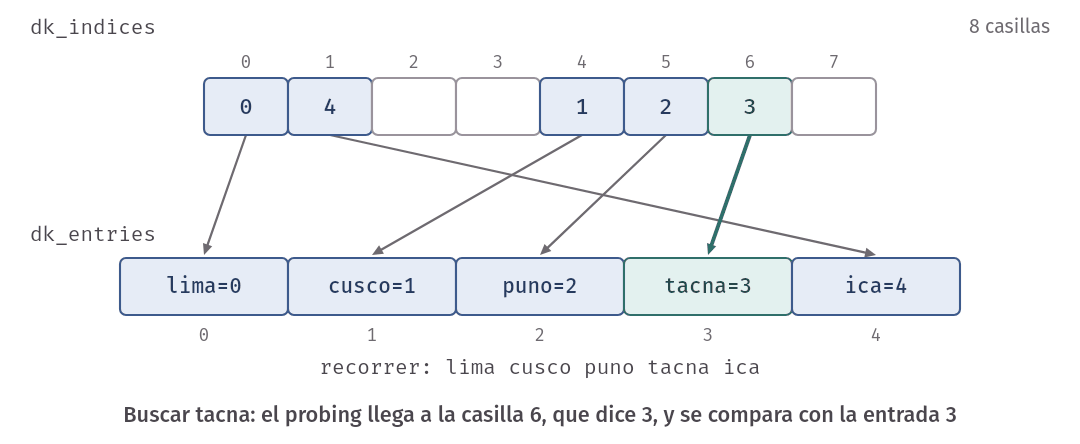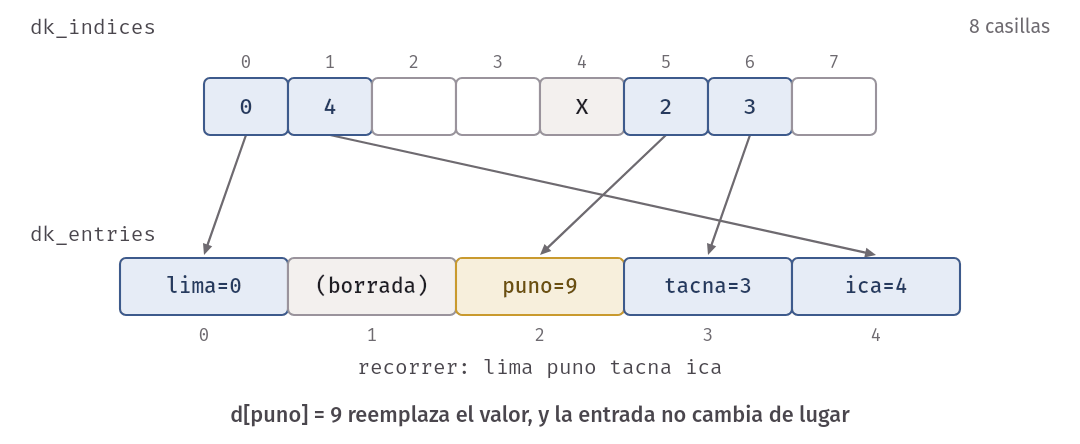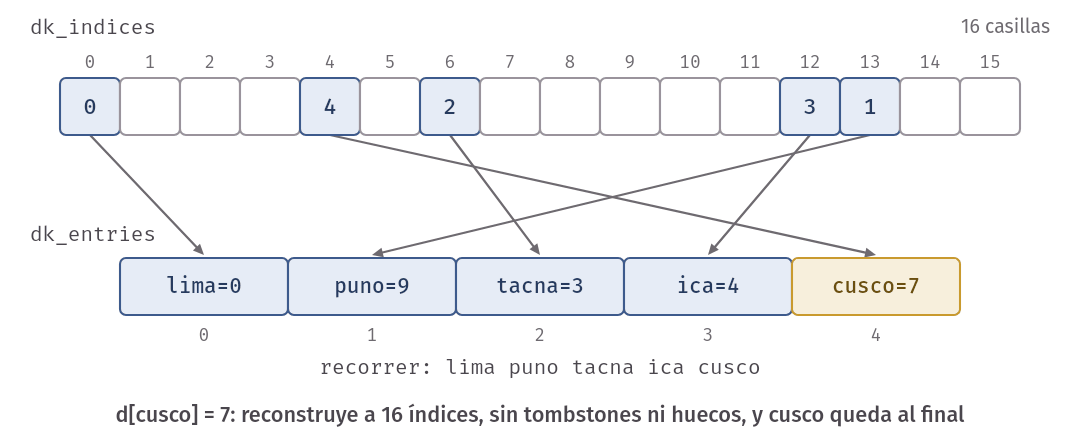
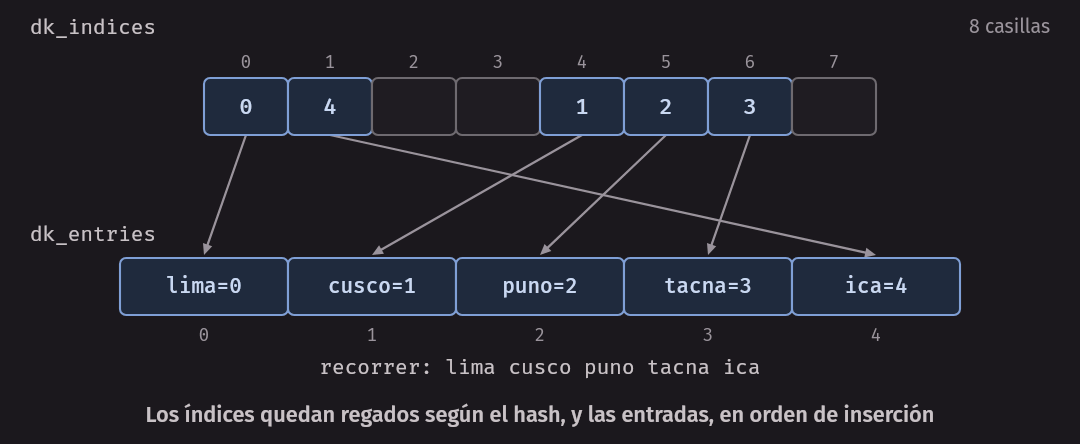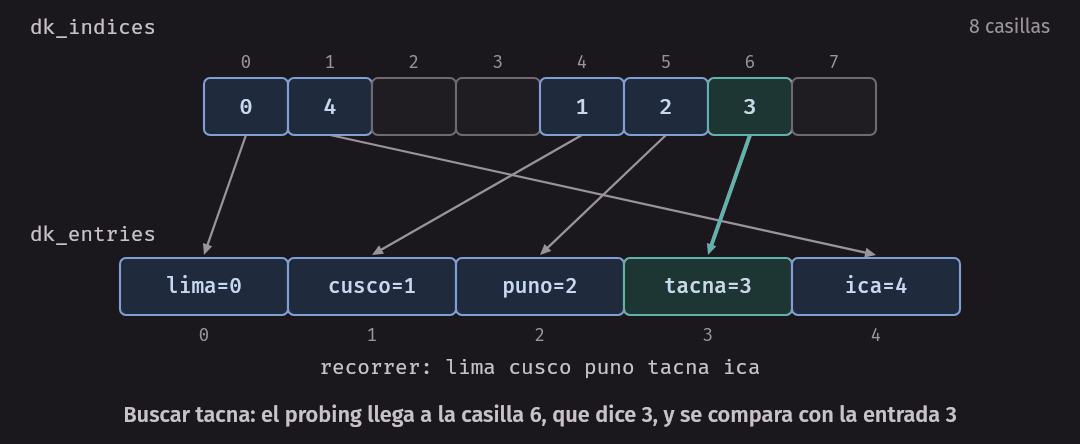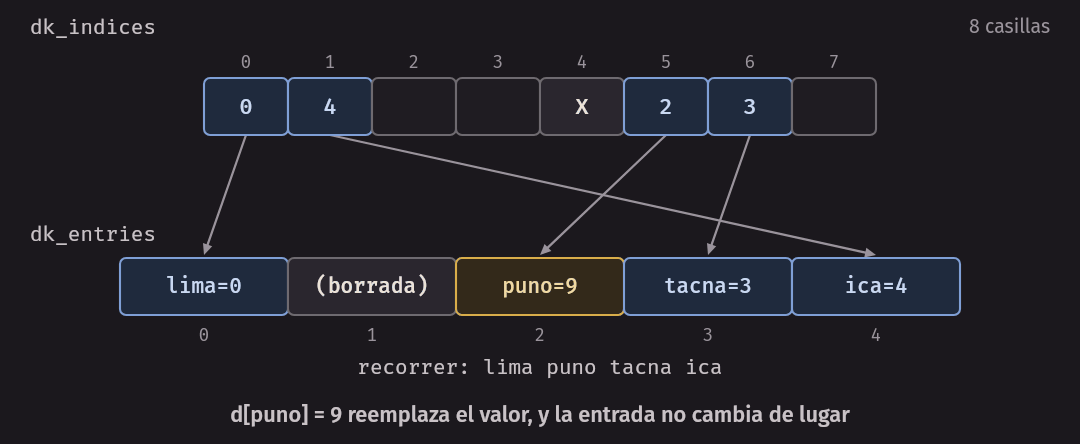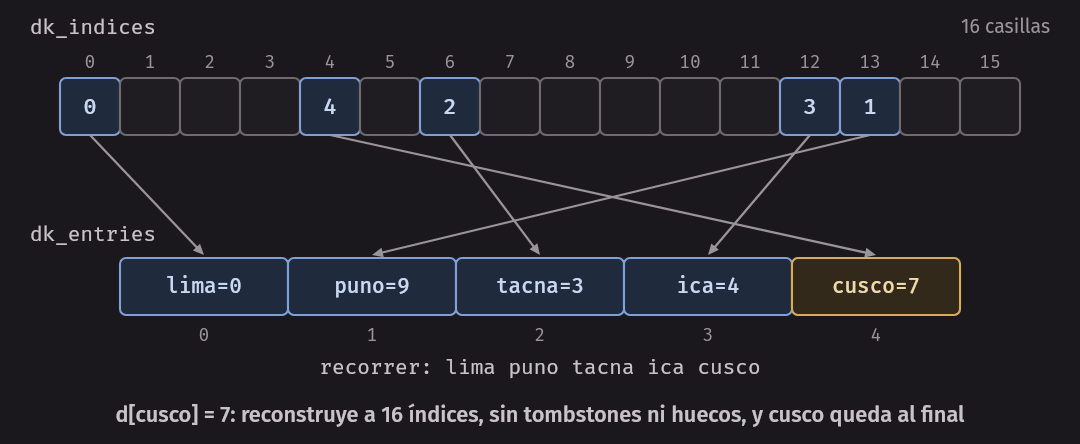
dk_indiceses la tabla hash de verdad. Cada casilla es un número pequeño: un índice al otro arreglo, o bienDKIX_EMPTY(-1), o bienDKIX_DUMMY(-2), que es su nombre para el tombstone.dk_entriesguarda las entradas, una tras otra, en el orden en que se insertaron. Tiene espacio para 2/3 de las casillas dedk_indices.
Las casillas libres ahora cuestan 1 byte y no 24: los índices son int8 hasta 128 casillas, int16 hasta 2¹⁵, int32
hasta 2³¹ y int64 después.
Buscar es: calcular el hash, hacer probing en dk_indices, y por cada índice válido comparar con la entrada correspondiente. El
programa compact_dict reduce este diseño a lo esencial y muestra los dos arreglos. Usa FNV-1a, así que sus casillas no son
las de Python real, porque Python usa otro hash, y para cadenas lo cambia en cada ejecución; pero la forma es esa, con las
mismas reglas de tamaño.
$ ./build/compact_dict
d[lima] = 0
d[cusco] = 1
d[puno] = 2
d[tacna] = 3
d[ica] = 4
  índices (8): 0 4 _ _ 1 2 3 _
  entradas: 0:lima=0 1:cusco=1 2:puno=2 3:tacna=3 4:ica=4
  recorrer: lima cusco puno tacna ica
del d[cusco]
  índices (8): 0 4 _ _ X 2 3 _
  entradas: 0:lima=0 1:(borrada) 2:puno=2 3:tacna=3 4:ica=4
  recorrer: lima puno tacna ica
d[puno] = 9 (reemplaza: no cambia de lugar)
  índices (8): 0 4 _ _ X 2 3 _
  entradas: 0:lima=0 1:(borrada) 2:puno=9 3:tacna=3 4:ica=4
d[cusco] = 7 (vuelve, y va al final)
  (reconstruye: 4 en uso, 8 -> 16 índices)
  índices (16): 0 _ _ _ 4 _ 2 _ _ _ _ _ 3 1 _ _
  entradas: 0:lima=0 1:puno=9 2:tacna=3 3:ica=4 4:cusco=7
  recorrer: lima puno tacna ica cusco
Fíjense primero en índices y entradas después de las cinco inserciones: los índices están regados por la tabla, según el
hash, y las entradas están en orden. Recorrer el diccionario es recorrer entradas, sin mirar la tabla hash.
- Reemplazar un valor no mueve nada.
punosigue en su lugar. - Borrar deja una
Xen los índices, porque la búsqueda debe poder seguir. También deja un hueco en las entradas, que el recorrido se salta. - Volver a insertar una clave borrada la pone al final, porque se agrega al final de
entradas. - Reconstruir elimina a la vez los tombstones y los huecos, conservando el orden.
Reconstruir ocurre cuando se acaban las entradas usables, y el tamaño nuevo se calcula con GROWTH_RATE, que es
used * 3, donde used son las claves vivas. El comentario de ese código explica por qué: sin borrados, esto duplica, y
con muchos borrados, la tabla queda del mismo tamaño o incluso menor. Es exactamente la decisión de “limpiar o crecer” que
vimos arriba, con otra fórmula.
Qué se gana: orden y memoria
Hay que cuidar el sentido de la causa. El orden es una consecuencia del diseño, porque el arreglo de entradas solo
crece al final. Los comentarios de dictobject.c lo dicen: “Since dk_entries is mostly append only, we can get insertion
order by just iterating dk_entries”. La historia también va en ese sentido:
- Python 3.6 adoptó este diseño. Su documentación dice que el
dictusa entre 20 % y 25 % menos memoria que en 3.5. Y advierte que conservar el orden es un detalle de implementación, del que no hay que depender. - Python 3.7 lo volvió parte del lenguaje: Dictionary order is guaranteed to be insertion order. Desde entonces, otra implementación de Python también tiene que conservarlo, aunque use otra estructura.
Esto se puede comprobar en Python real. El programa corre con el Python del entorno:
$ python3 dict_demo.py
Python 3.14.10 cpython
creado:          ['lima', 'cusco', 'puno']
reemplazar puno: ['lima', 'cusco', 'puno']
borrar cusco y agregar tacna: ['lima', 'puno', 'tacna']
volver a agregar cusco:       ['lima', 'puno', 'tacna', 'cusco']
popitem saca el último: ('cusco', 7)

1000 claves: 26032 bytes; al borrar 990: 26032 bytes
tras 366 altas y bajas, con 10 claves: 464 bytes

claves  sys.getsizeof  casillas  usables  predicción
     1            184         8        5         184
     6            272        16       10         272
    11            464        32       21         464
    22            832        64       42         832
    43           1584       128       85        1584
    86           3328       256      170        3328
   171           6576       512      341        6576
   342          13056      1024      682       13056
La primera parte coincide con lo que mostró compact_dict: reemplazar no cambia el orden, una clave que vuelve va al final
y popitem saca la última. Es exactamente lo que dice la documentación.
La segunda muestra GROWTH_RATE en acción. Borrar por sí solo no libera nada, porque las entradas y los tombstones siguen ahí, igual
que en nuestra tabla. Pero cuando las altas y bajas gastan las entradas, used * 3 da un número pequeño, y el diccionario se
achica de 26 032 a 464 bytes.
La tercera parte es una prueba de que estamos leyendo bien el código fuente. Las columnas casillas, usables y predicción no
miran a sys.getsizeof: salen de las reglas de dictobject.c. Se empieza con 8 casillas, y al acabarse las usables se pasa a la menor
potencia de 2 que llegue a used * 3. El tamaño predicho suma 64 bytes del objeto dict, 32 del encabezado de las claves, los índices y
2/3 de las casillas en entradas de 16 bytes. En 3.14, una tabla cuyas claves son solo cadenas no guarda el hash en la entrada, porque ya
está dentro de la cadena, y por eso 16 bytes y no 24. La predicción coincide con sys.getsizeof en todas las filas. Y fíjense
en cuándo crece: al insertar la clave 6, 11, 22 o 43, una más que el 2/3 usable de cada tamaño. Con 8 casillas caben 5 claves,
exactamente lo que dice un comentario del código: “8 allows dicts with no more than 5 active entries”.
Una búsqueda real por dentro, siguiendo el dibujo de compact_dict, sería así, para tacna. Se calcula su hash, y el probing
empieza en la casilla que indique. Digamos que encuentra un índice 3. Va a la entrada 3, compara la clave, y la encuentra. Si el
índice hubiera sido _, la clave no está. Si hubiera sido X, seguiría con la siguiente casilla de su secuencia. Lo que cambia con
respecto a nuestra tabla es solo que hay un paso más para llegar a la clave.
¿De dónde sale el ahorro? Hagamos la cuenta con 128 casillas y entradas de 24 bytes, que es el caso de claves generales. Esta es una cuenta con los tamaños, no una medición:
una sola tabla:       128 casillas × 24 bytes = 3072 bytes
índices y entradas:   128 × 1 byte + 85 × 24 bytes = 2168 bytes
Una secuencia de probing que no es lineal
La última diferencia es la secuencia de probing. El dict no prueba la casilla siguiente, sino que usa esta recurrencia,
copiada de dictobject.c:
perturb >>= 5
i = (i*5 + perturb + 1) mod 2^k
Al principio perturb es el hash completo, y con cada paso se le quitan 5 bits, así que la secuencia termina dependiendo de todos
los bits del hash. Al final, perturb vale 0. Entonces la recurrencia es solo i = 5i + 1 mod 2ᵏ, y esa, como dice el comentario del código,
pasa por todas las casillas exactamente una vez antes de repetirse. Por eso encontrar una vacía está garantizado.
$ ./build/probe_order 8 0 9
casillas 8, hash 0: 0 1 6 7 4 5 2 3 0
$ ./build/probe_order 32 2654435769 12
casillas 32, hash 2654435769: 25 11 22 29 21 25 0 1 6 31 28 13
La primera línea es la del comentario de CPython: 0, 1, 6, 7, 4, 5, 2, 3, y otra vez 0.
¿Por qué no lineal? El comentario lo explica muy bien, y la razón está en su función hash, no en la teoría general. En Python,
el hash de un entero pequeño es el propio entero: hash(i) da i. Para claves consecutivas es lo ideal, porque cada una cae en
una casilla distinta. Pero si colisionan, tomar la casilla siguiente es lo peor posible: es justamente la casilla de la
próxima clave consecutiva. “Linear probing is deadly in this case”, dice el comentario. Con la recurrencia, el camino de una
colisión no se parece al de las claves consecutivas, y así se evitan los cúmulos.
A cambio, se pierde lo que veníamos ganando con el linear probing: las casillas probadas no están contiguas. CPython lo acepta porque su carga no pasa de 2/3, y porque, según el mismo comentario, casi siempre encuentra la clave en el primer intento.
En la biblioteca. Las tres tablas de esta semana responden de forma distinta a la misma pregunta, y ninguna es la “correcta” en general.
std::unordered_mapda estabilidad de punteros. Abseil y Go dan muchas búsquedas rápidas con α alto. CPython da orden y memoria compacta, y su lenguaje depende de esa tabla en todas partes.
Qué cambió y qué no
Volvamos a mirar lo que hemos visto. Si alguien del año 1960 leyera el código de una tabla moderna, entendería casi todo:
| Idea | Linear probing de esta clase | Swiss Tables | dict de CPython |
|---|---|---|---|
| Una función hash y m casillas | Sí | Sí | Sí |
| Todo en un arreglo, sin nodos | Sí | Sí | Sí (dos arreglos) |
| Termina en una casilla vacía | Sí | Sí (en el grupo) | Sí |
| Tombstones | Sí | Sí | Sí |
| Mantener α lejos de 1 | Sí | 7/8 | 2/3 |
| Crecer reinsertando todo | Sí | Sí | Sí |
Lo nuevo no es matemática. Es la atención a la memoria: un byte de resumen por casilla, grupos que se comparan de una vez, índices de 1 byte para no pagar 24 bytes por una casilla vacía. Lo único realmente distinto entre la tabla que ustedes van a escribir y la de Go es a qué se le presta atención, y eso es lo que les va a pedir este curso de aquí en adelante.
El laboratorio: un corrector ortográfico
En el laboratorio, la tabla se usa para algo concreto. Un corrector lee un diccionario, revisa un texto y, por cada palabra que no conoce, propone las que están a un cambio de distancia.
Definición. Un cambio es una de estas tres operaciones sobre una palabra: borrar una letra, reemplazar una letra por otra, o insertar una letra en cualquier posición. Intercambiar dos letras vecinas no cuenta como un cambio: son dos.
Letras, no bytes
Aquí hay una trampa que no es de la tabla, sino de los datos. Los archivos están en UTF-8, un std::string guarda bytes, y una
letra como ñ ocupa dos. Un corrector que cambie un char a la vez parte esa letra en dos, y prueba cadenas que ni siquiera son
UTF-8 válido. Por eso el laboratorio les da hecho lab/utf8.h, con una función que parte una palabra en letras, y que no es
el tema de la semana:
inline std::vector<std::string> split_letters(const std::string& word) {Con eso, año son tres letras aunque std::string("año").size() sea 4. El alfabeto son las 33 letras que aparecen en
palabras.txt: de la a a la z, y además á, é, í, ñ, ó, ú y ü. También les damos extract_words, que saca las palabras de un
texto y las pasa a minúsculas, incluidas las mayúsculas con tilde, algo que std::tolower no hace con bytes de UTF-8.
¿Cuántos candidatos tiene una palabra de L letras? L borrados, 32 L reemplazos y 33 (L + 1) inserciones, en total 66 L + 33. Para una palabra de 8 letras, 561 preguntas al diccionario, y casi todas con respuesta “no”. Esto importa: un corrector es un programa de búsquedas sin éxito, y ya sabemos que esas son las que más castigan al linear probing.
Cuatro diccionarios, una interfaz
El corrector es un template que solo necesita contains, y por eso funciona con cualquiera de estos cuatro:
| Diseño | Cargar | Buscar | Nota |
|---|---|---|---|
TableDict<HashMap> |
O(1) amortizado por palabra | O(1 + α) esperado | Su tabla de la semana 7 |
TableDict<ProbingHashMap> |
O(1) amortizado por palabra | O(1) esperado si α < 1 fijo | La de esta semana |
StdDict |
O(1) amortizado por palabra | O(1) esperado | std::unordered_map |
SortedDict |
O(n log n) al ordenar | O(log n) | Búsqueda binaria de la semana 6 |
Una versión del corrector ya terminada, corrida sobre un diccionario de 18 palabras, se ve así. Los comandos usan la solución
del curso. Con la de ustedes, cambien solution por lab:
$ ./build/solution/spell lab/tests/fixtures/mini_dict.txt lab/tests/fixtures/mini_text.txt 12
diccionario: 18 palabras
texto: 26 palabras
desconocidas: 19 apariciones de 12 palabras distintas
la (2):
del (1):
tiene (1):
una (2):
el (3):
bebe (2):
y (2):
cafe (2): café
no (1):
pesa (1): mesa pera
un (1):
casq (1): casa caso
Con los archivos de verdad, son 708 palabras distintas. Aquí va el resumen, y solo cuatro de ellas:
$ ./build/solution/spell ../../data/palabras.txt ../../data/tradiciones.txt 708 | head -3
diccionario: 1045757 palabras
texto: 48004 palabras
desconocidas: 1378 apariciones de 708 palabras distintas
$ ./build/solution/spell ../../data/palabras.txt ../../data/tradiciones.txt 708 | grep -E '^(fué|rodillas|gatita|i) '
gatita (8): gaita gamita garita gotita
i (22): a di e ib id in ...
fué (114): fié fu fue fufé fui ful ...
rodillas (3): rodilla rodillos
Estos resultados muestran los límites de los datos, y no son errores del programa. Fué es una grafía antigua, común en los libros
de esa época, que el diccionario actual no trae, y lo mismo pasa con la i usada como conjunción. Gatita es un diminutivo que
tampoco está. Rodillas es una palabra de todos los días que simplemente falta en este
diccionario, aunque tenga rodilla. Y las sugerencias salen en orden de bytes, no en orden alfabético del español. En ese
orden, á y ñ van después de la z, porque cada una empieza con un byte mayor que el de cualquier letra sin tilde:
$ printf 'zeta\náfrica\nñandú\n' | LC_ALL=C sort
zeta
áfrica
ñandú
La trampa del factor de carga
Al medir con varios factores de carga máximos, hay algo que parece un error. Con linear probing, 1 045 757 palabras, y α máximo de 0.5 o 0.7, el factor de carga real es el mismo. La tabla duplica su capacidad, y por eso α no toma el valor que pedimos: 2²¹ casillas alcanzan para las dos, y el factor real es 0.499.
Error común. Comparar por el factor de carga máximo y no por el real. Con este diccionario, pedir 0.5 o 0.7 da exactamente la misma tabla. Por eso
make benchtiene una columna con el máximo pedido y otra con el real.
Los números
make bench usa palabras.txt y tradiciones.txt, compila con -O2 y sin sanitizers, y da la mediana de 3 cargas y de 5
revisiones o rondas de preguntas, en menos de un minuto. Estos números dependen de la máquina, y en otras tres corridas, con la máquina más ocupada, los absolutos fueron hasta un 50 % mayores, con las mismas conclusiones. La columna pregunta mide solo las
búsquedas, con la lista exacta de preguntas que hace revisar el texto. revisar incluye fabricar los candidatos, que es
costoso, y por eso las diferencias se ven menos. MB cuenta 1 MB como 2²⁰ bytes, por lo que la semana 7 daba más para el mismo arreglo, y es lo reservado con new por la estructura ya cargada.
$ make bench
diccionario: 1045757 palabras. texto: 48004 palabras. preguntas al revisar: 454027.
cargar y revisar en ms; preguntar en ns por pregunta; MB reservados por el diccionario.
Mediana de 3 cargas y de 5 revisiones o rondas de preguntas.

diseño           máx   real  cargar  revisar pregunta      MB
arreglo ordenado     -      -     106     99.2      119    33.5
unordered_map     1.00      -     410     67.9       66    60.5
encadenamiento    0.50  0.499     297     53.5       40    65.4
encadenamiento    1.00  0.997     341     60.9       56    57.4
encadenamiento    2.00  1.995     395     89.0       83    53.4
encadenamiento    4.00  3.989     510    103.3      145    51.4
linear probing    0.25  0.249     113     46.8       26   194.7
linear probing    0.50  0.499     109     62.2       67    98.7
linear probing    0.70  0.499     132     62.2       66    98.7

Mismas 2^20 casillas, mismas preguntas. ns por pregunta.
diseño            real pregunta
encadenamiento    0.550       37
encadenamiento    0.700       46
encadenamiento    0.800       50
encadenamiento    0.900       55
encadenamiento    0.950       56
linear probing    0.550       65
linear probing    0.700       91
linear probing    0.800      109
linear probing    0.900      196
linear probing    0.950      516
Lo que se repitió en tres corridas:
- Cargar. El linear probing con α real de 0.499 tardó menos de la mitad que el encadenamiento con el mismo α: de 109 a 137 ms
contra 297 a 301. El encadenamiento hace una reserva de memoria por palabra, y el probing no. Las dos pagan además la reserva de las
claves largas, porque un
std::stringde más de 15 bytes reserva la suya, y eso es alrededor del 9 % de este diccionario. El arreglo ordenado cargó en un tiempo parecido al del probing, de 106 a 107 ms, pero tiene truco:palabras.txtya viene ordenado, así que elstd::sortcasi no tiene que mover nada. Uno de los ejercicios lo mide con el archivo barajado. - Preguntar, con el mismo α real. Aquí gana el encadenamiento: de 40 a 41 ns contra 63 a 67 con α = 0.499. Casi todas son búsquedas sin éxito, y el conteo ya lo anunciaba.
- Preguntar, gastando más memoria. El linear probing con α = 0.249 es lo más rápido, con 26 ns. Cuesta 194.7 MB, tres veces lo que usa el encadenamiento con α = 0.499 y casi seis veces el arreglo ordenado.
- El sube y baja de α. Con las mismas casillas, de α = 0.55 a α = 0.95, el encadenamiento pasa de unos 37 ns a unos 55, y el linear probing, de unos 64 a unos 520, un aumento de unas 8 veces. La fórmula predice que las casillas revisadas sin éxito crecen unas 67 veces en ese rango. No es proporcional porque cada pregunta también calcula el hash y compara cadenas, y eso cuesta lo mismo con cualquier α.
- El arreglo ordenado. En la primera tabla, es el más lento para preguntar de los que tienen un α de hasta 2, con 116 a 119 ns, y aun así el corrector con él tarda menos de 0.1 segundos. Y es el que menos memoria usa, 33.5 MB. Si el diccionario nunca cambia, no es una mala respuesta.
- Memoria. Con cadenas, cada casilla de una tabla abierta, llena o vacía, guarda un
std::stringentero, que en esta biblioteca ocupa 32 bytes: con el estado y el valorchar, la casilla ocupa 48. Por eso aquí el linear probing gasta más que el encadenamiento (98.7 MB contra 65.4), al revés de lo que pasaba con enteros. El diseño de CPython atacaba justamente esto. Además, los dos factores reales disponibles son 0.25 y 0.5: con este tamaño de diccionario, el siguiente paso, 2²⁰ casillas, daría α = 0.997, y ninguna tabla sensata se queda ahí.
Resumamos esto en una tabla para decidir, recordando que los números son de esta máquina y de este problema:
| Si lo que importa es… | Mejor | Por qué |
|---|---|---|
| Cargar rápido una tabla grande | Linear probing | Sin una reserva de memoria por clave |
| Preguntas que casi siempre fallan, con el mismo α | Encadenamiento | Pocas revisiones: el conteo manda |
| La búsqueda más rápida, sin importar la memoria | Linear probing con α bajo | Casi no hay cúmulos |
| Poca memoria, con cadenas | Arreglo ordenado | No hay casillas vacías |
| Que los punteros a los elementos no cambien | std::unordered_map |
Es lo que pide la norma |
| Orden de inserción | Dos arreglos, como dict |
Las entradas se agregan al final |
Vean que no hay un ganador. Un corrector con diccionario fijo y poca memoria puede preferir el arreglo ordenado. Si se carga muchas veces, el linear probing. Si casi todas las preguntas fallan y hay espacio, el linear probing con α muy bajo o el encadenamiento. Su informe debe decir lo mismo, con sus propios números.
El código de la semana
| Archivo | Qué es |
|---|---|
probe_trace.cpp |
Tabla mínima que muestra cada paso, incluido el borrado incorrecto |
probing_counts.cpp |
Cuenta casillas contra las fórmulas: linear probing, double hashing y cadenas |
tombstone_counts.cpp |
Lo que hacen los tombstones con tres políticas distintas |
demo_tables.h, layout_bench.cpp |
Tablas de enteros y medición con cada diseño |
mini_swiss.h, group_match.cpp, swiss_counts.cpp |
Swiss Table de juguete, comparación de un grupo y conteos |
compact_dict.cpp, probe_order.cpp, dict_demo.py |
El diseño del dict, su probing y Python real |
test_demos.cpp |
Pruebas de los programas de la clase |
errors/ |
Los dos errores comunes con tombstones |
lab/ |
Lo que ustedes completan |
make test corre todo esto, comprueba que la salida copiada en estos apuntes siga siendo cierta y prueba la solución del laboratorio
cuando está presente. Ninguna prueba mide tiempo: todas cuentan casillas, comparaciones, candidatos o preguntas. Las dos mediciones
de arriba son lo único que se copió de una corrida sin volver a compararla, porque cambian cada vez.
Cómo organizar las dos sesiones
| Sesión | Qué hacen | Tiempo estimado |
|---|---|---|
| 1 | Leer lo dado en probing_hash_map.h, correr las pruebas |
15 min |
| 1 | probes_for, get, contains: un solo recorrido, tres usos |
20 min |
| 1 | set, con la regla del primer tombstone; rebuild_for |
45 min |
| 1 | remove, y dejar pasando make test-table |
15 min |
| 1 | my_churn_test en lab/churn_test.h: el paso 2 de la guía |
25 min |
| 2 | one_edit_candidates, trabajando con letras |
25 min |
| 2 | suggest y check_words |
25 min |
| 2 | Copiar su HashMap, completar TableDict y StdDict |
20 min |
| 2 | make bench varias veces y report.md |
50 min |
Las pruebas de la sesión 1 no necesitan la tabla de la semana 7. Las dos sesiones se pueden probar por separado:
make test-table
make test-spell
Lo primero que verán al correr make test-table antes de escribir nada son las pruebas fallando, cada una con el método que le falta.
Por ejemplo, para set_and_get:
$ ./build/lab/map_tests set_and_get 2>&1 | head -1
sin implementar: ProbingHashMap::get
En lab/ hay dos cosas para las dos sesiones. La primera, probing_hash_map.h, con el constructor, las copias, los movimientos,
check_invariants y lo demás ya hecho, para que ustedes se dediquen a set, get, contains, remove, probes_for y
rebuild_for. Después, spell_checker.h y dictionaries.h, con utf8.h, load_words.h, SortedDict, el programa spell y la
medición dados. La tabla de la semana 7 se trae copiándola:
cp ../week-07/lab/hash_map.h lab/hash_map.hHasta entonces, un archivo con el mismo nombre detiene el programa con un mensaje claro, y las pruebas de la sesión 2 fallan.
Resumen
- En el direccionamiento abierto, todo está dentro del arreglo, y cada clave tiene una secuencia de probing. α no puede pasar de 1, y tiene que quedar al menos una casilla vacía.
- En el linear probing, se prueba la casilla siguiente. Su invariante: entre la casilla inicial de una clave y su casilla no hay ninguna vacía.
- El agrupamiento primario hace que los cúmulos crezcan y se fusionen. El costo de una búsqueda sin éxito es (1 + 1/(1−α)²)/2, así que α debe mantenerse lejos de 1.
- Vaciar una casilla rompe el invariante. Un tombstone lo conserva: la búsqueda pasa por él hasta una casilla vacía. Insertar puede reusarlo, pero solo después de confirmar que la clave no está más adelante.
- Para el costo, un tombstone pesa como una clave: importa (n + t)/m. Reconstruir los limpia, con la misma capacidad si había pocas claves o duplicando si había muchas.
- Encadenamiento o linear probing. El conteo favorece al encadenamiento. La memoria contigua favorece al linear probing en algunos casos: tablas grandes, α moderado, búsquedas con éxito. Medimos que insertar sin reservar es mucho más rápido. No hay ganador absoluto.
- Una Swiss Table guarda 7 bits del hash en un byte por casilla, compara un grupo entero de una vez y casi no toca las claves. Go 1.24 la usa con grupos de 8, y Abseil con grupos de 16 en x86.
- El
dictde CPython separa índices y entradas. De ahí salen el orden de inserción y el ahorro de memoria. El orden está garantizado en el lenguaje desde 3.7. Su probing usaperturb, y no es lineal. - Las ideas son las de hace décadas. Lo nuevo es la atención a la memoria.
Ejercicios
- Inserten en una tabla de 11 casillas, con h(k) = k mod 11 y linear probing, las claves 22, 33, 1, 12 y 2. Dibujen la tabla. ¿Cuántas
casillas revisa buscar 23? Compruébenlo con
probe_trace. - En la tabla anterior, borren el 33 con tombstone. Digan qué casillas revisa buscar el 12, y por qué pasa por el tombstone. Luego inserten el 44. ¿Dónde queda?
- Sin correr nada: con α = 0.8, ¿cuántas casillas espera revisar en promedio una búsqueda con éxito y una sin éxito? Comparen con la tabla
de
probing_counts. - Una tabla tiene 1000 casillas, 50 claves y 600 tombstones. ¿Qué factor de carga tiene? ¿Con qué α se comporta una búsqueda sin éxito? Usen la fórmula para estimar cuántas casillas revisa.
- Una tabla sin tombstones llega a su límite. ¿
rebuild_fordebería limpiar o duplicar? ¿Y una tabla con 3 claves, capacidad 1024 y 700 tombstones? Justifiquen con la regla de la mitad. - Escriban en pseudocódigo la inserción con tombstones, siguiendo las reglas de este capítulo, sin mirar su código. Expliquen qué prueba de
map_tests.cppdetecta cada uno de los dos errores comunes. - Si una tabla usara
h(k) = k mod mcon linear probing, ¿qué pasa con las claves 0, m, 2m, 3m, …? ¿Y con las claves 0, 1, 2, 3, …? ¿Cuál de los dos casos ayuda a resolver CPython conperturb? - Con el truco de
match_h2y una palabra de control de 8 bytes, expliquen por qué un byte vacío (10000000) nunca sale como candidato para un h2 de 7 bits. Pista: miren qué bit alto queda al hacer el^. - Agreguen a
compact_dict.cppuna segunda ronda de borrados e inserciones. ¿Qué pasa con el tamaño de los índices si borran casi todo y después insertan? Comparen con la reglaused * 3deldict. - Calculen con la fórmula de
dict_demo.pycuánto ocupa undictcon claves de texto y 100 elementos. Compruébenlo consys.getsizeof. ¿Cuántos bytes por clave son? ¿Y con 171? - Agreguen a
layout_bench.cppuna tabla de 2²⁴ casillas, si su máquina tiene memoria. ¿Se repite lo que vimos? Corran tres veces y digan solo lo que se repita. - En
bench_spell.cpp, barajenentriescon semilla fija antes de medirSortedDict. ¿Cuánto más tarda cargar el arreglo ordenado? ¿Cambia la conclusión sobre cargar? Corran tres veces. - Reto. Escriban
MiniSwiss::erasecon la regla de Go: marca la casilla como vacía si el grupo tiene otra vacía, y deja un tombstone si no. Agreguen una prueba contrastd::unordered_set, y expliquen por qué esa regla no rompe ninguna búsqueda.