Apuntes · Capítulo 10Diccionarios
Árboles binarios de búsqueda
Árboles binarios de búsqueda
Las semanas 7 y 9 terminaron con un diccionario muy bueno: una tabla hash busca, inserta y borra en O(1) en
promedio, con encadenamiento o con linear probing. Ahora le haremos preguntas que no sabe responder. ¿Cuál es la
clave más pequeña? ¿Cuál es la primera palabra después de rodilla? ¿Qué palabras empiezan con pre? Una
función
hash reparte las claves a propósito, sin ningún orden, así que para responder cualquiera de esas preguntas la
tabla
tiene que mirar todas sus claves.
Hoy construimos otro diccionario, que guarda las claves de una forma que conserva el orden: el árbol binario
de
búsqueda (binary search tree). Es la idea de la búsqueda binaria de la semana 6 convertida en una estructura
de
nodos, de modo que también se puede insertar y borrar sin mover nada. Buscar, insertar y borrar cuestan lo que
mide su
altura, y esa es la palabra clave de la semana: con claves al azar la altura es pequeña, y con claves
ordenadas el
árbol se vuelve una lista enlazada. Lo mediremos con un caso que no es inventado: nuestro palabras.txt viene
ordenado, y al insertarlo tal como viene, el árbol pasa de tardar segundos a tardar, según estimaremos, cerca de
una hora.
Las semanas 11 y 12 arreglan ese problema con AVL y con árboles rojinegros, sobre el mapa que ustedes escribirán en el laboratorio de hoy.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Lo que una tabla hash no da, Árboles binarios, El árbol binario de búsqueda, Buscar y Insertar.
- En clase: Recorridos, Destruir un árbol, Borrar, Consultas ordenadas, El puntero al padre, La altura lo decide todo y
std::mapfrente astd::unordered_map.- Después de clase: repasen con el Resumen y los Ejercicios, y lean El código de la semana. Opcional: Open Data Structures, secs. 6.1 (BinaryTree) y 6.2 (BinarySearchTree); CLRS, capítulo Binary Search Trees.
Código. Los programas de este capítulo están en
code/week-10. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Lo que una tabla hash no da
Comparemos los dos diccionarios de la biblioteca con la misma pregunta. El programa map_queries guarda las 100
000
claves 0, 3, 6, 9… en un std::map y en un std::unordered_map, usando una clave que cuenta sus comparaciones.
Luego
busca el techo de 100 000: la menor clave que sea mayor o igual a ese número.
$ build/map_queries
std::map, techo de 100000: 100002, comparaciones: 16
std::unordered_map, techo de 100000: 100002, claves visitadas: 100000
std::map, piso de 100000: 99999, comparaciones: 16
std::map, claves en [100000, 100030): 10, comparaciones: 32
std::map, primeras: 0 3 6 9 12
std::unordered_map, primeras: 232704 299571 35535 21798 182190
Las dos líneas de arriba dicen lo principal: 16 comparaciones frente a mirar las 100 000 claves. La tabla hash
no es
mala, pero no guarda ningún orden. En g++, std::hash<int> es la identidad, y aun así el módulo y la lista interna de
nodos entregan las claves desordenadas. El estándar no promete ningún orden. Si
solo
van a preguntar “¿está esta clave?”, la tabla gana, y lo mediremos. Si van a preguntar por el orden, necesitan
otra
estructura. Estas son las preguntas de hoy:
| Consulta | Qué devuelve |
|---|---|
| mínimo, máximo | La clave menor, la clave mayor |
| piso de x (floor) | La mayor clave ≤ x |
| techo de x (ceiling) | La menor clave ≥ x |
| rango [a, b) | Todas las claves k con a ≤ k < b, en orden |
| recorrido | Todas las claves, en orden |
Un arreglo ordenado con std::lower_bound de la semana 6 responde todo esto en O(log n), más lo que haya que devolver. Su problema es otro:
insertar
o borrar obliga a mover Θ(n) elementos. Queremos consultar como un arreglo ordenado y modificar como una lista.
Árboles binarios
Primero el vocabulario, que usaremos todo el resto del curso.
Definición. Un árbol binario (binary tree) es un conjunto de nodos, quizá vacío, en el que cada nodo tiene como máximo dos hijos, un hijo izquierdo y un hijo derecho, y todo nodo menos uno tiene exactamente un padre. El nodo sin padre es la raíz (root), y desde la raíz se llega a todos los demás. Un nodo sin hijos es una hoja (leaf). El subárbol de un nodo es ese nodo con todos los que se alcanzan bajando desde él.
Se dibuja al revés que en la naturaleza, con la raíz arriba:
          5           raíz
        /   \
       3     8        5 es padre de 3 y de 8
      / \   /
     1   4 7          1, 4 y 7 son hojas
Definición. La profundidad (depth) de un nodo es la cantidad de aristas del camino desde la raíz hasta él: la raíz tiene profundidad 0. La altura (height) de un árbol es la mayor profundidad de sus nodos. Por convenio, un solo nodo tiene altura 0 y el árbol vacío tiene altura −1.
En el dibujo, el 8 tiene profundidad 1, el 7 tiene profundidad 2, y la altura del árbol es 2.
Error común. Algunos libros cuentan nodos en vez de aristas, y entonces un solo nodo tiene altura 1. Las dos convenciones son válidas y difieren en 1. En este curso se cuentan aristas: lo necesitaremos igual en AVL. Cuando lean otra fuente, revisen cuál usa antes de comparar números.
Un árbol binario en C++ es lo que ya saben hacer con punteros: cada nodo guarda sus dos enlaces. Es una lista enlazada con dos “siguientes” en vez de uno. Ningún nodo necesita estar cerca de otro en la memoria.
El árbol binario de búsqueda
Un árbol binario solo dice cómo están unidos los nodos. Lo que lo vuelve útil es una invariante sobre las claves.
Definición. Un árbol binario de búsqueda es un árbol binario en el que cada nodo tiene una clave y, para cada nodo x, todas las claves del subárbol izquierdo de x son menores que la clave de x, y todas las del subárbol derecho son mayores.
Intuición: la raíz parte las claves en dos grupos, como el elemento del medio en una búsqueda binaria. Cada hijo vuelve a partir su grupo. Una comparación descarta un subárbol entero sin mirarlo, y por eso se puede buscar sin recorrer todo.
Fíjense en la palabra todas. No basta que el hijo izquierdo sea menor que su padre. El árbol de la derecha parece correcto si se mira cada nodo con sus hijos, y está roto:
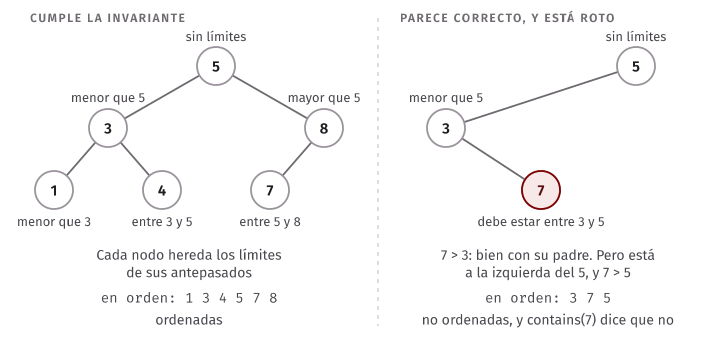
El programa errors/local_check.cpp arma exactamente ese árbol. Su revisión mira solo a los hijos directos, y
lo aprueba:
$ g++ -Wall -Wextra -std=c++20 errors/local_check.cpp -o build/local_check && build/local_check
revision local: todo bien
contains(7): no
La revisión dice “todo bien” y la clave 7, que está en el árbol, no se puede encontrar: al compararla con el 5, la búsqueda se va a la derecha y nunca llega.
Error común. Escribir
check_invariantscomparando cada nodo solo con sus hijos. Ese error es el peor de todos, porque el programa que debe avisarles les da la razón. La comprobación correcta baja con dos límites: cada nodo debe quedar entre el mayor antepasado por el que se giró a la derecha y el menor por el que se giró a la izquierda.
Empezamos por un conjunto: solo claves, sin valores. Lo llamamos BstSet, y se compara únicamente con <:
template <typename K>
class BstSet {
    struct Node {
        K key;
        Node* left = nullptr;
        Node* right = nullptr;
    };
...
    Node* root_ = nullptr;
    std::size_t size_ = 0;
};
Sus invariantes, en un comentario y en check_invariants, como siempre desde la semana 2:
- En cada nodo, todas las claves del subárbol izquierdo son menores que la suya, y todas las del derecho son mayores. Por eso no hay claves repetidas.
- El árbol tiene exactamente
size_nodos, yroot_es nulo si y solo sisize_ == 0.
La comprobación pasa los límites hacia abajo. Un puntero nulo significa “sin límite por este lado”:
static std::size_t count_checked(const Node* node, const K* low, const K* high) {
    if (node == nullptr) {
        return 0;
    }
    assert(low == nullptr || *low < node->key);
    assert(high == nullptr || node->key < *high);
    return 1 + count_checked(node->left, low, &node->key)
             + count_checked(node->right, &node->key, high);
}
Al bajar a la izquierda, la clave del nodo se vuelve el nuevo límite superior; al bajar a la derecha, el nuevo límite inferior. Los límites de arriba se heredan, y así el 7 del dibujo se compara con el 5, aunque no sea su padre.
En C++.
Ksolo necesitaoperator<. Dos claves a y b son la misma si nia < bnib < a. Así funciona tambiénstd::map: el estándar pide de su comparador un orden débil estricto (strict weak ordering), y nunca usa==. Es lo mismo que pedimos a los comparadores de la semana 6.
Buscar
Se baja desde la raíz. En cada nodo hay tres posibilidades: la clave buscada es menor, es mayor o es esta.
bool contains(const K& key) const {
    const Node* node = root_;
    while (node != nullptr) {
        if (key < node->key) {
            node = node->left;
        } else if (node->key < key) {
            node = node->right;
        } else {
            return true;
        }
    }
    return false;
}
Sigamos contains(4) y contains(6) en el árbol del dibujo:
| Paso | contains(4): nodo |
decisión | contains(6): nodo |
decisión |
|---|---|---|---|---|
| 1 | 5 | 4 < 5, izquierda | 5 | 5 < 6, derecha |
| 2 | 3 | 3 < 4, derecha | 8 | 6 < 8, izquierda |
| 3 | 4 | ni menor ni mayor: está | 7 | 6 < 7, izquierda |
| 4 | nulo | no está |
Cada paso baja un nivel, así que se hacen como máximo altura + 1 pasos, sin importar cuántos nodos haya en los subárboles descartados. Por eso:
Idea clave. Buscar cuesta O(altura), y Θ(altura) en el peor caso, cuando se llega hasta el nodo más profundo. No cuesta “O(log n)”. Eso solo será cierto cuando la altura sea logarítmica, y nada lo garantiza todavía.
Se escribe con un ciclo y no con recursión, porque no hace falta recordar nada al volver. El ciclo no gasta pila, y como veremos, eso importa en un árbol alto.
Insertar
Insertar es buscar: se baja exactamente igual, y al caer en un enlace nulo, ese es el lugar donde debe estar la clave. Si colgamos el nodo ahí, la invariante se mantiene, porque la búsqueda giró en cada antepasado según la comparación con esa misma clave. Nada más cambia: un árbol solo crece por sus hojas.
Hace falta recordar qué enlace hay que cambiar: el left de un nodo, el right de otro, o root_. Son
tres casos con un mismo tipo: Node*. Si
guardamos un puntero a ese enlace, un Node**, los tres casos son uno solo:
bool insert(const K& key) {
    Node** link = &root_;
    while (*link != nullptr) {
        if (key < (*link)->key) {
            link = &(*link)->left;
        } else if ((*link)->key < key) {
            link = &(*link)->right;
        } else {
            return false;
        }
    }
    *link = new Node{key};
    size_++;
    return true;
}
En C++.
new Node{key}inicializa el primer miembro conkeyy los demás con sus valores por defecto, los= nullptrde la declaración.Nodees un agregado: unastructsin constructores, cuyos miembros se inicializan en orden.Node**es lo mismo que conocen de C: un puntero a un puntero, y*link = ...escribe en el enlace, sea cual sea.
Insertemos 5, 3, 8, 1, 4 y 7, en ese orden, y veamos cómo crece:
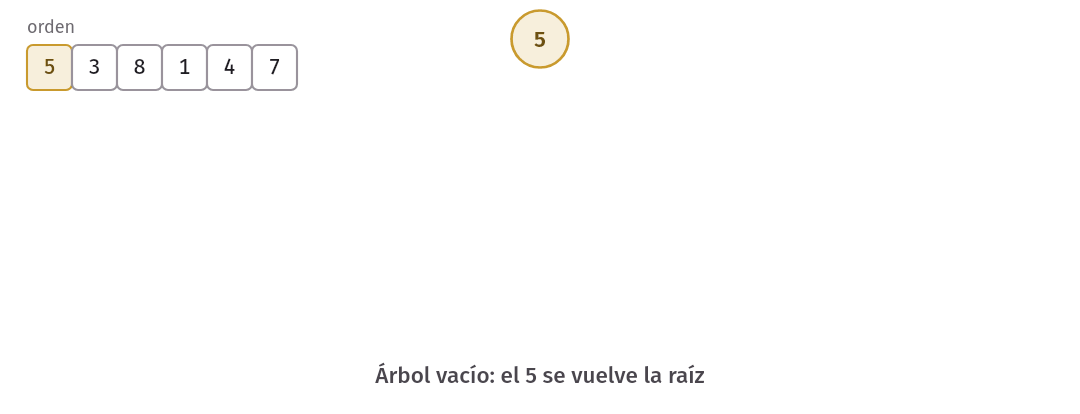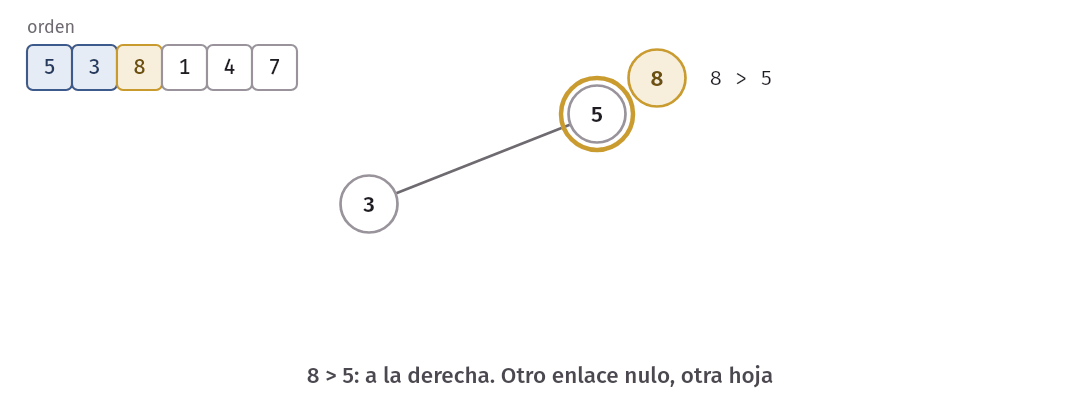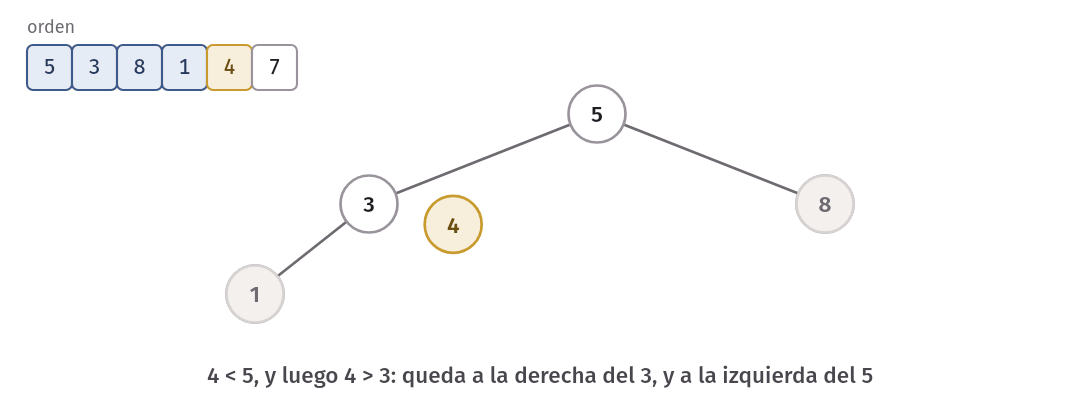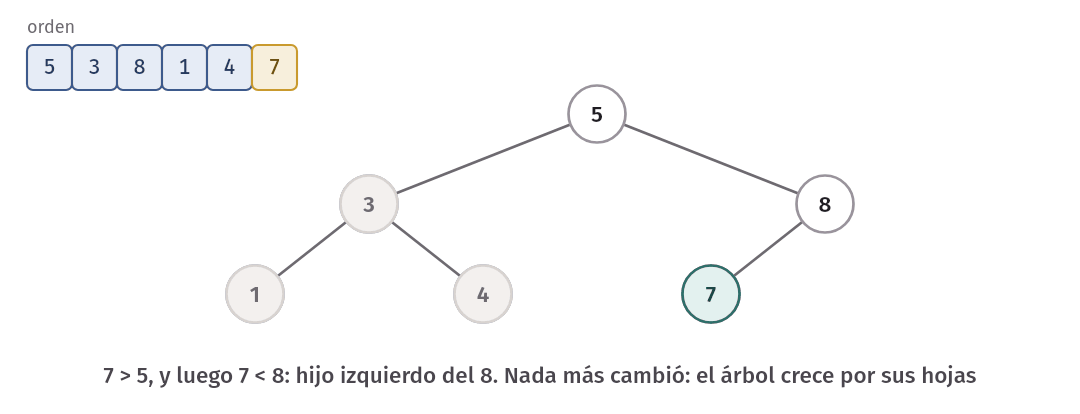
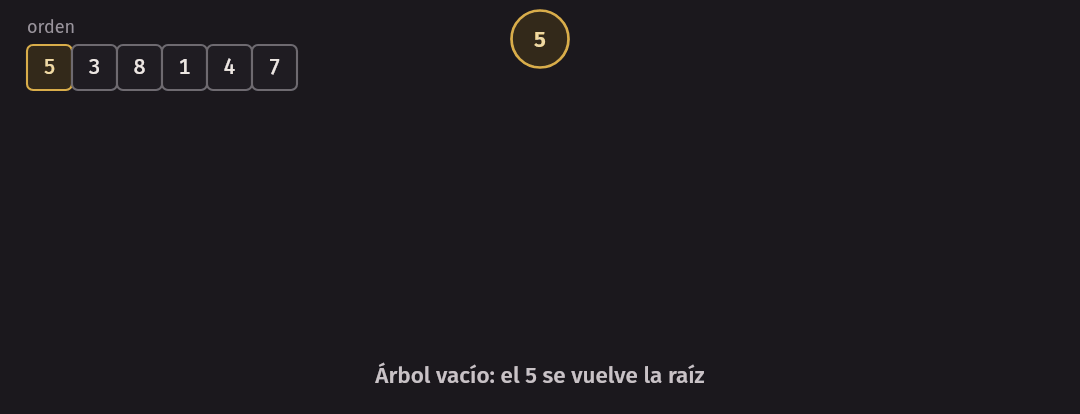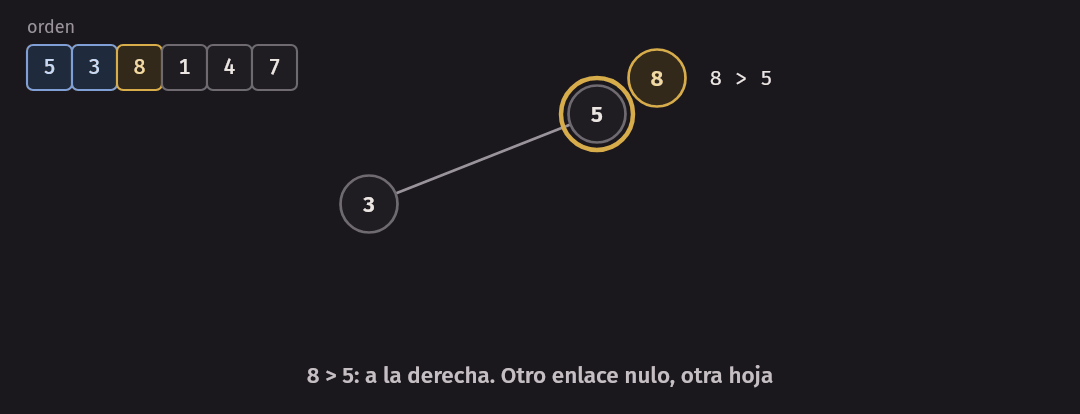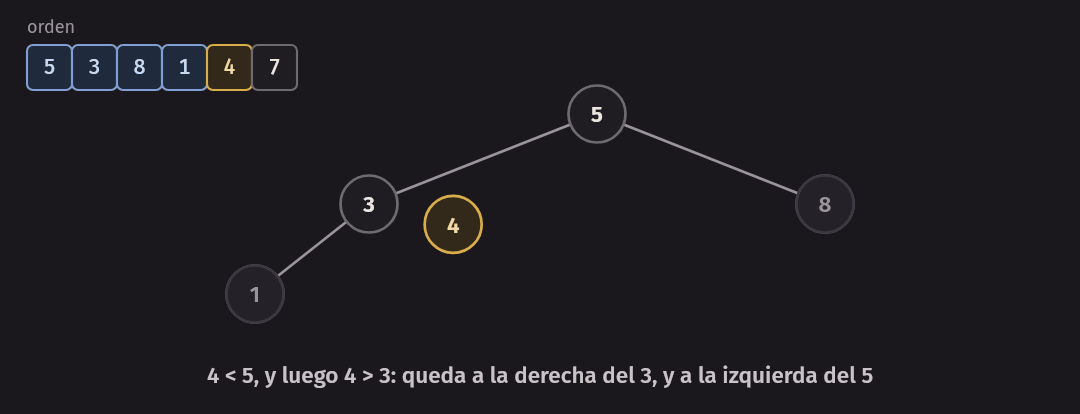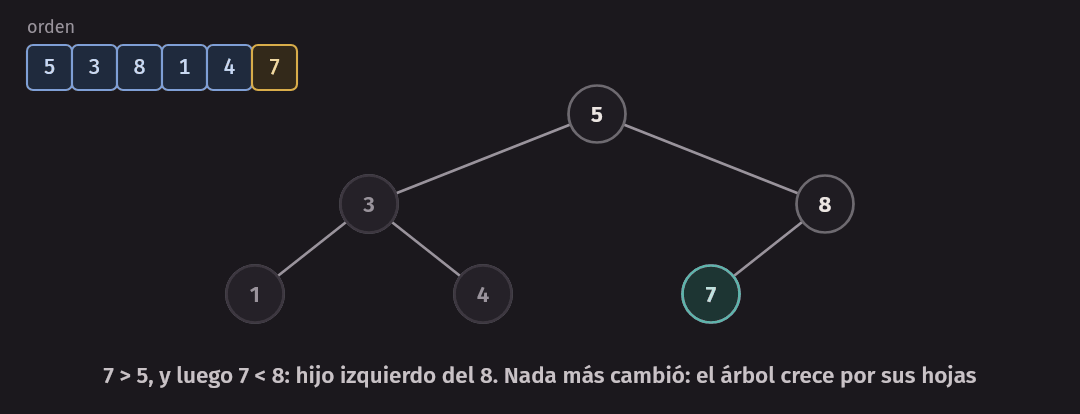
Cada una baja desde la raíz: 7 compara con 5, va a la derecha, compara con 8, va a la izquierda y encuentra un enlace nulo. El costo es el mismo que el de buscar: O(altura), más una reserva de memoria.
Observen que el orden de inserción decide la forma. Las mismas claves en otro orden dan otro árbol, y ahí estará el problema.
Error común. Comparar con
<=para “permitir repetidos”. Rompe la invariante, que pide estrictamente mayores, y hace quecontainsyeraseencuentren solo una de las copias. Un mapa no guarda claves repetidas: si la clave ya está, no se crea otro nodo.
Recorridos
Un recorrido (traversal) visita todos los nodos una vez. Hay tres clásicos, según cuándo se visita el nodo con respecto a sus dos subárboles:
| Recorrido | Orden |
|---|---|
| en orden (in-order) | izquierdo, nodo, derecho |
| preorden (pre-order) | nodo, izquierdo, derecho |
| postorden (post-order) | izquierdo, derecho, nodo |
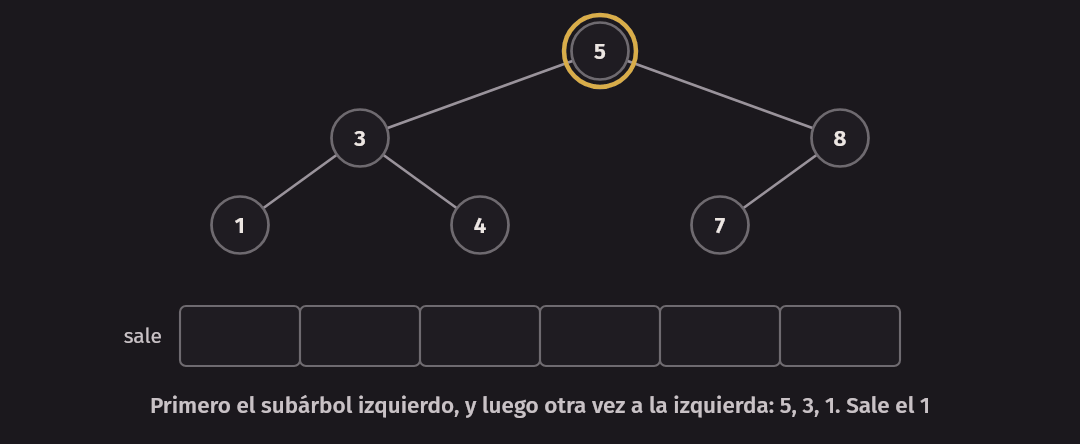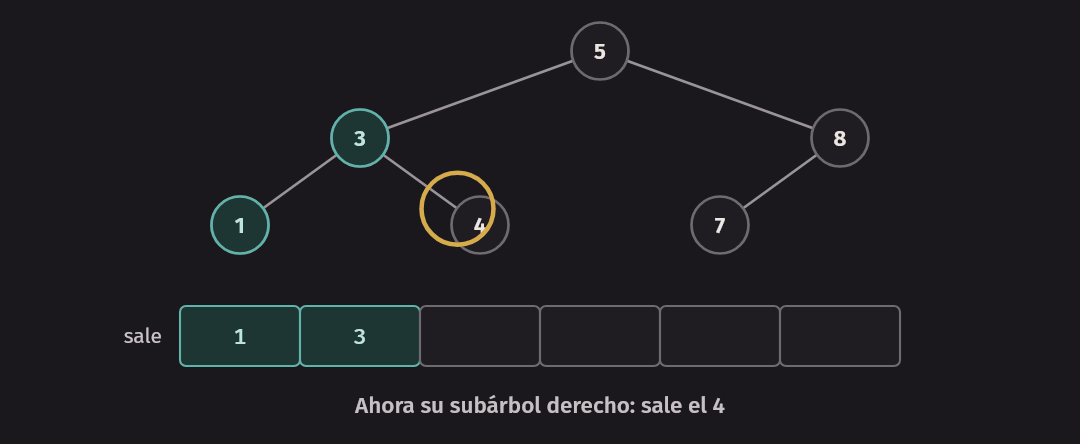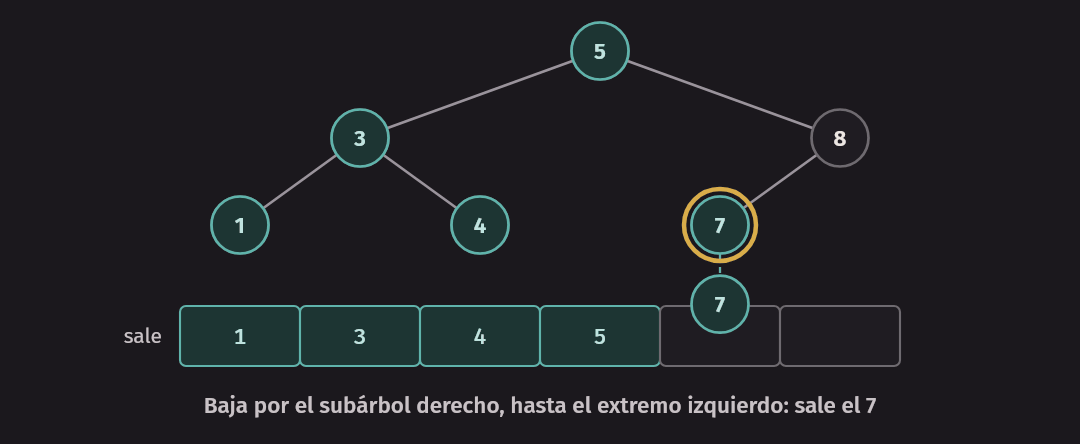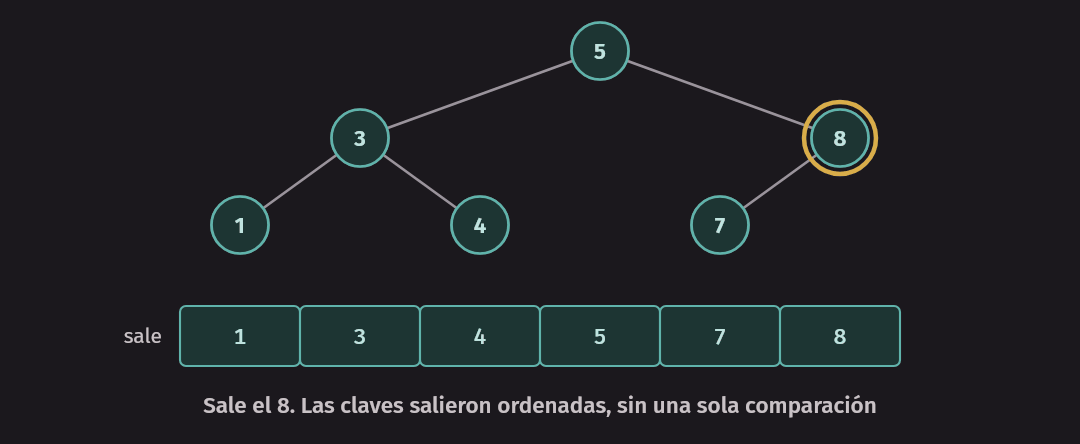
Los tres se escriben igual, moviendo una línea. Este es el recorrido en orden:
static void walk_in(const Node* node, std::vector<K>& keys) {
    if (node == nullptr) {
        return;
    }
    walk_in(node->left, keys);
    keys.push_back(node->key);
    walk_in(node->right, keys);
}
Cada uno pasa una vez por cada nodo y hace trabajo constante en él, así que cuesta Θ(n). Este es el resultado sobre nuestro árbol:
$ build/tree_demo
forma: 5(3(1,4),8(7,_))
en orden: 1 3 4 5 7 8
preorden: 5 3 1 4 8 7
postorden: 1 4 3 7 8 5
altura: 2
sin el 5: 7(3(1,4),8)
en orden: 1 3 4 7 8
La línea forma escribe el árbol en una línea: clave(izquierdo,derecho), con _ si falta un hijo. Lo
usaremos para mostrar árboles sin dibujarlos.
Las dos últimas líneas son para la sección de borrado.
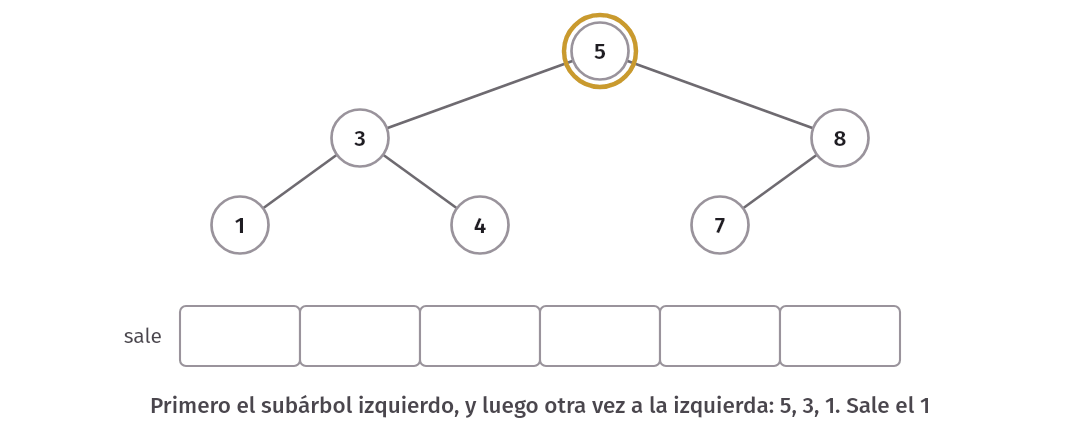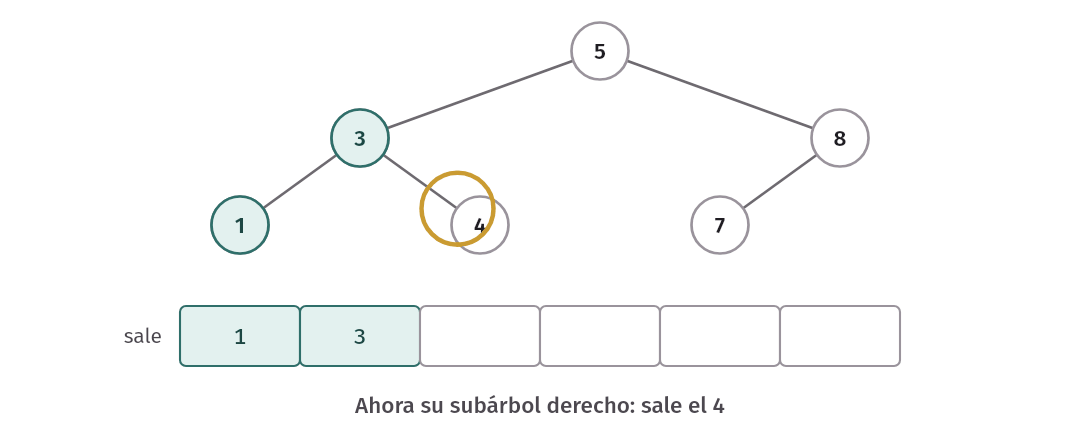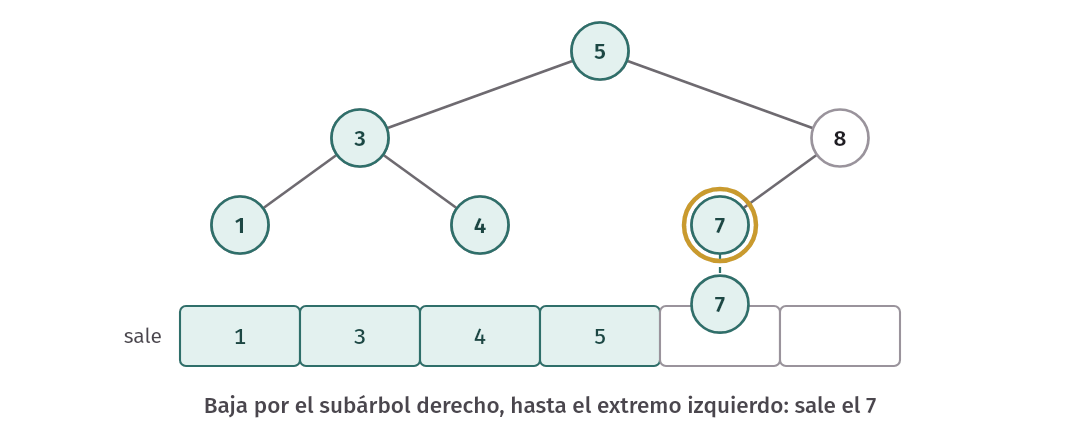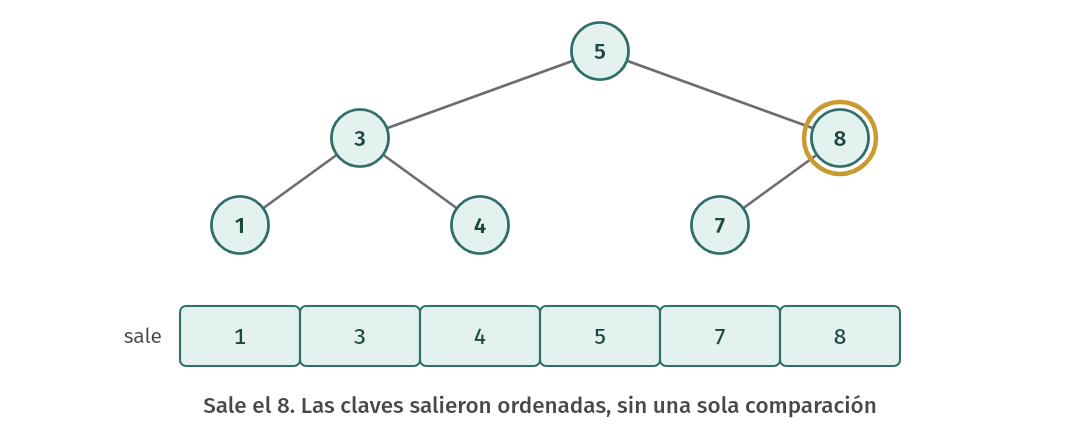
En orden: las claves ordenadas
Afirmación. En un árbol binario de búsqueda, el recorrido en orden entrega las claves de menor a mayor.
Tomen dos claves cualesquiera a < b, y busquen el nodo x más profundo que tiene a las dos en su subárbol. No puede ocurrir que a y b estén ambas en el mismo subárbol de x, porque entonces habría uno más profundo. Quedan tres casos:
- a es la clave de x. Entonces b está a su derecha, y “nodo” se visita antes que “derecho”.
- b es la clave de x. Entonces a está a su izquierda, y “izquierdo” se visita antes que “nodo”.
- a está en el subárbol izquierdo y b en el derecho, y “izquierdo” se visita antes que “derecho”.
La invariante descarta la posibilidad contraria, como a en el derecho y b en el izquierdo. En los tres casos a sale antes que b, y eso para cualquier par: las claves salen ordenadas. Noten que esto no necesitó inducción: solo usa la invariante en el nodo x.
Idea clave. Un árbol binario de búsqueda es una forma de guardar una secuencia ordenada. El recorrido en orden es esa secuencia. Lo demás, como sucesor, piso, techo o rango, consiste en encontrar posiciones de esa secuencia sin recorrerla toda.
Preorden: la forma
El preorden visita cada nodo antes que a sus descendientes. Por eso, si insertan las claves en preorden en un árbol vacío, cada nodo encuentra ya puestos a todos sus antepasados y cae en el mismo lugar: el preorden reconstruye la forma. Sirve para guardar un árbol en un archivo, para copiarlo y para que una prueba compare formas exactas. Las pruebas del laboratorio lo usan, y en la semana 11 servirá para comprobar rotaciones.
El recorrido en orden no sirve para esto: todos los árboles con las mismas claves tienen el mismo recorrido en orden, sin importar la forma.
Postorden: primero los hijos
El postorden visita cada nodo después de sus descendientes. Sirve cuando la respuesta de un nodo depende de la de sus hijos: la altura de un subárbol se calcula con la de sus dos hijos, y el tamaño también. El ejemplo más importante es liberar la memoria.
Destruir un árbol
Para borrar un nodo hay que haber liberado antes sus hijos, o por lo menos haber guardado sus punteros: después
de delete node, leer node->left es
comportamiento indefinido. Así que la destrucción natural es en postorden:
void destroy(Node* node) {
    if (node == nullptr) {
        return;
    }
    destroy(node->left);
    destroy(node->right);
    delete node;
}
Sigamos su orden en nuestro árbol. La pila de llamadas crece al bajar y se vacía al volver:
| Llamada activa más profunda | Pila de llamadas | Se libera |
|---|---|---|
destroy(1) |
5, 3, 1 | 1 |
destroy(4) |
5, 3, 4 | 4 |
destroy(3) |
5, 3 | 3 |
destroy(7) |
5, 8, 7 | 7 |
destroy(8) |
5, 8 | 8 |
destroy(5) |
5 | 5 |
Salen 1, 4, 3, 7, 8, 5: el postorden de tree_demo. La pila nunca tuvo más de 3 nodos, sin contar las llamadas con nulo: la altura más 1.
Es correcta, corta, y puede tumbar el programa. Cada llamada ocupa un marco de llamada en la pila, y hay una llamada activa por nivel del árbol. La pila de un programa es pequeña y fija. En nuestro entorno son 8 MB:
$ bash -c 'ulimit -s'
8192
En un árbol con altura 40, eso sobra. En un árbol con un millón de nodos en una cadena, no.
errors/recursive_destroy.cpp arma una cadena directamente, sin
usar insert, y la libera con esa función:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/recursive_destroy.cpp -o build/recursive_destroy && build/recursive_destroy 1000000
AddressSanitizer:DEADLYSIGNAL
=================================================================
==25264==ERROR: AddressSanitizer: stack-overflow on address 0xffffce2a9ff0 (pc 0xaaaae87d1e68 bp 0xffffce2aa010 sp 0xffffce2aa010 T0)
...
SUMMARY: AddressSanitizer: stack-overflow errors/recursive_destroy.cpp:12 in destroy(Node*)
Eso es un stack overflow. No es un error de la lógica: la función es correcta y con 200 000 nodos todavía funciona. Dónde falla depende del tamaño del marco, es decir, del compilador y de sus opciones. Aquí, con la pila de 8 MB y probando valores de n:
| Compilación | n que funcionó | n que falló |
|---|---|---|
| Sin optimizar, con y sin sanitizers | 200 000 | 300 000 |
-O2, sin sanitizers |
600 000 | 1 000 000 |
No confíen en esos valores: cambian de una máquina a otra. Lo que vale es la conclusión: la recursión gasta memoria de pila proporcional a la altura, y esa memoria es mucho menos que la del montón.
Error común. Probar un destructor recursivo solo con árboles pequeños o al azar, ver que funciona, y confiarse. Falla únicamente en el caso degenerado, y en producción, con datos reales que resultaron venir ordenados. Es un bug clásico también en listas enlazadas con destructores recursivos.
La solución es no usar la pila de llamadas. La más directa es una pila propia en el montón: se sacan los hijos del nodo a una lista de pendientes antes de borrarlo.
~BstSet() {
    std::vector<Node*> pending;
    if (root_ != nullptr) {
        pending.push_back(root_);
    }
    while (!pending.empty()) {
        Node* node = pending.back();
        pending.pop_back();
        if (node->left != nullptr) {
            pending.push_back(node->left);
        }
        if (node->right != nullptr) {
            pending.push_back(node->right);
        }
        delete node;
    }
}
Esto ya no es postorden, porque borra cada padre antes que sus hijos. Es seguro porque los hijos ya se copiaron
a pending. Lo importante es que sigue liberando todo: cada nodo entra una vez
a pending y sale una vez. Sin embargo, tiene una molestia: un destructor que reserva memoria, y que podría
fallar justo al liberar. Más adelante veremos cómo el puntero al padre elimina incluso esa
necesidad, y deja un postorden real sin memoria adicional.
BstSet conserva recursión en sus recorridos y en check_invariants, porque son más claros así y solo se usan
con árboles de altura razonable: height y total_depth, en cambio, van nivel por nivel, porque los usaremos
con cadenas largas. Si necesitan recorrer un árbol
que puede estar degenerado, recuerden lo que vieron aquí.
Borrar
Borrar es la operación con más casos. Primero se busca el nodo, y luego depende de cuántos hijos tiene:
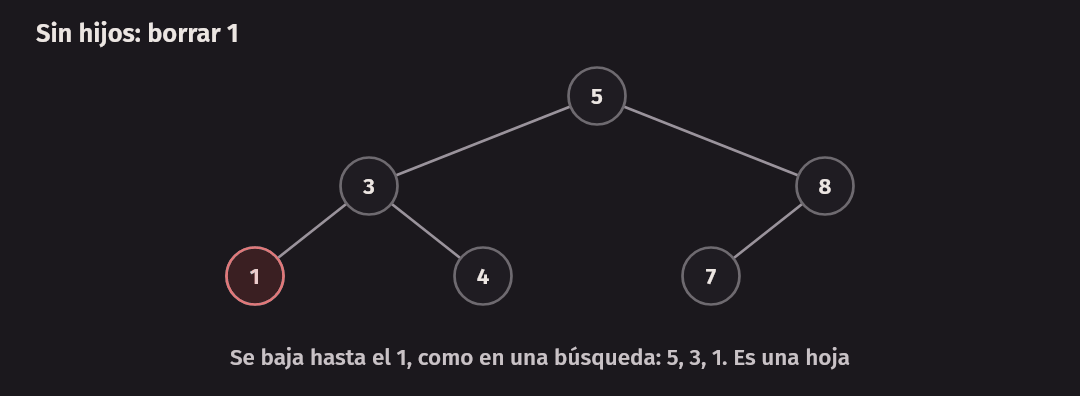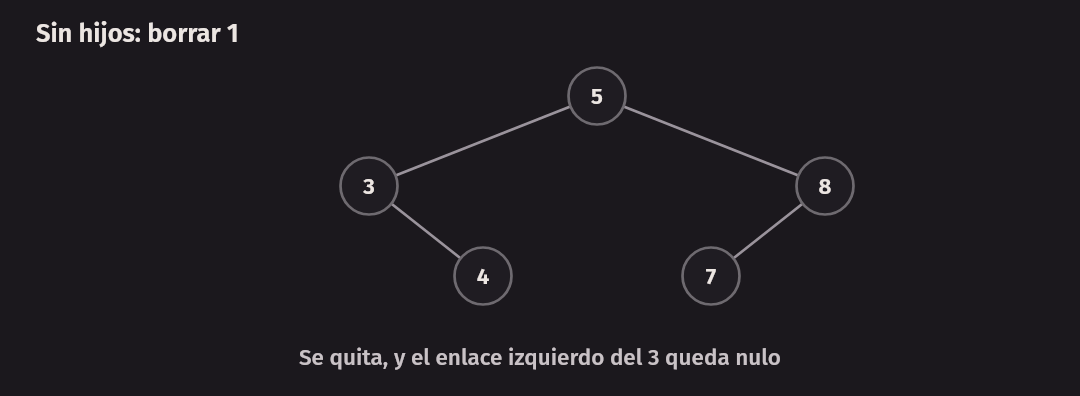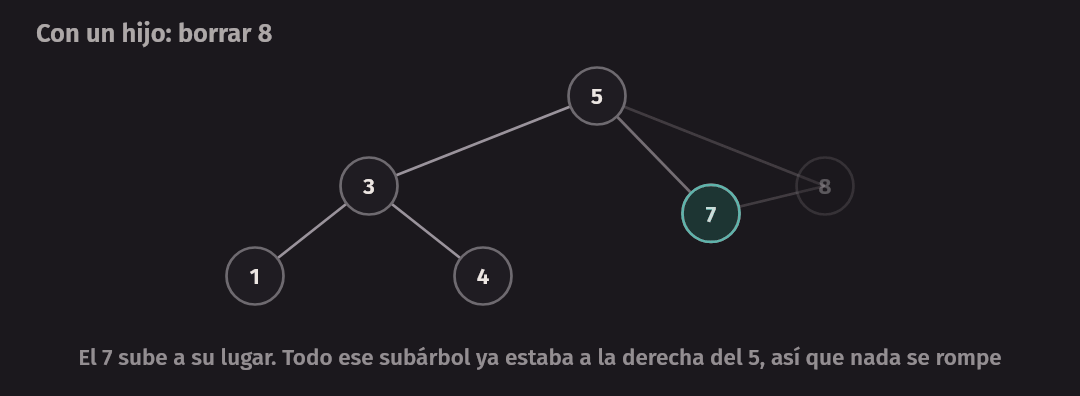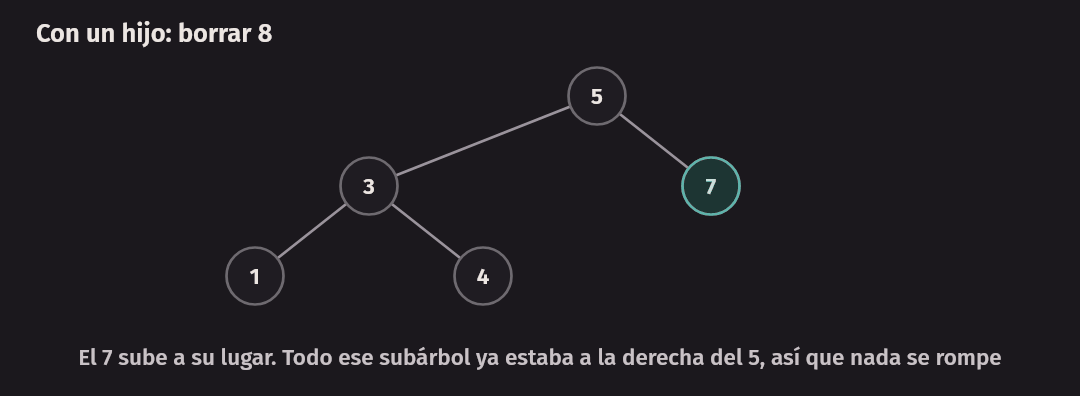
Sin hijos. Se quita: el enlace que lo apuntaba queda nulo.
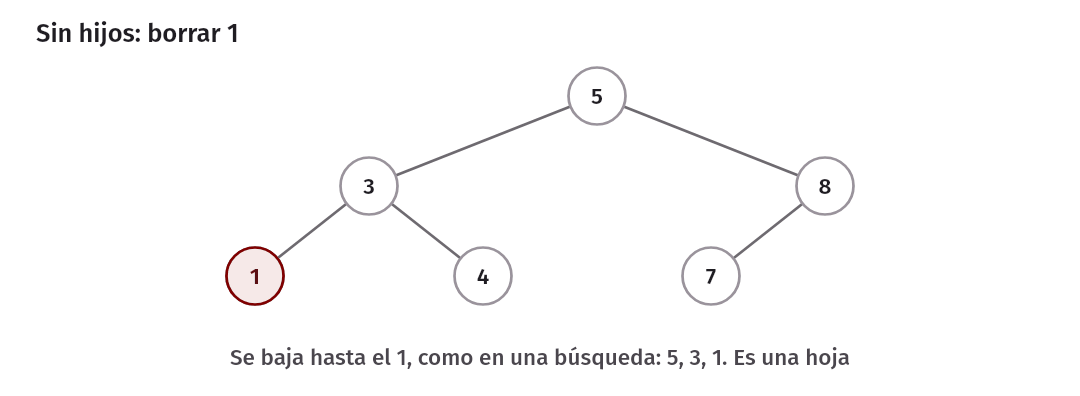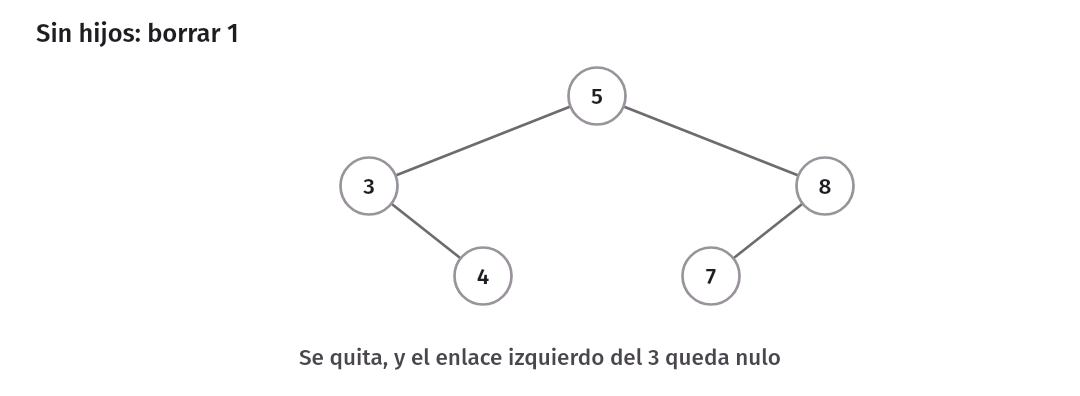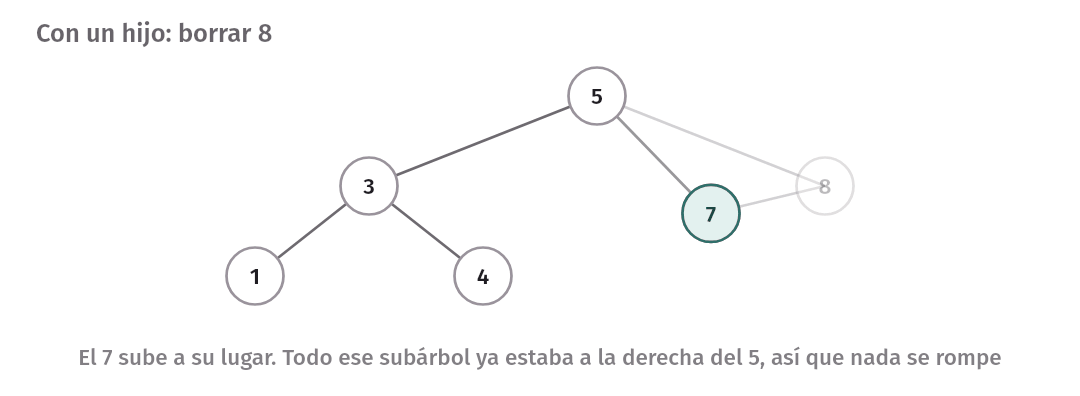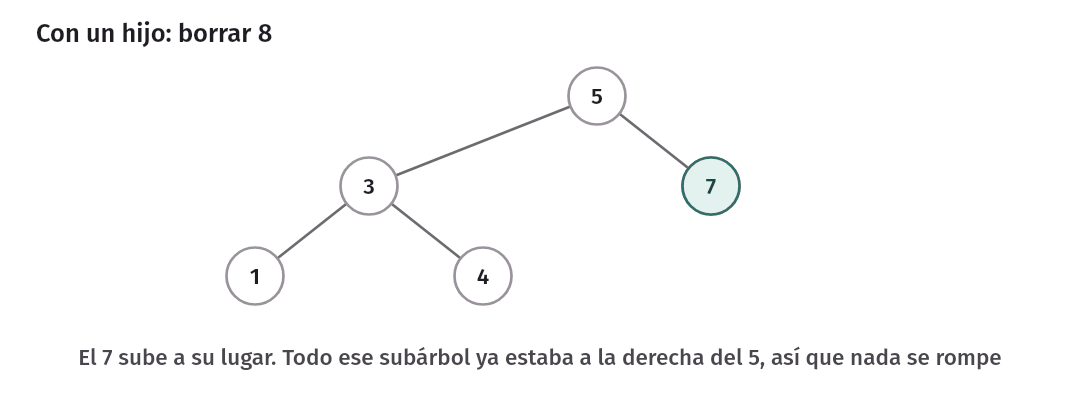
Con un hijo. Su único hijo sube a ocupar su lugar. La invariante se mantiene: ese subárbol entero ya estaba del lado correcto de todos los antepasados del nodo borrado.
Con dos hijos. No hay un lugar para los dos hijos en el enlace que apuntaba al nodo. La idea: mantenemos el nodo donde está, y le cambiamos el contenido por el de otra clave que pueda ocupar ese sitio sin romper nada. Esa clave debe ser mayor que todo el subárbol izquierdo y menor que todo el derecho. Hay exactamente dos candidatas: el sucesor (la clave siguiente en el orden) y el predecesor (la anterior).
Definición. El sucesor de una clave es la siguiente clave en el recorrido en orden. Si el nodo tiene subárbol derecho, es el mínimo de ese subárbol: se baja una vez a la derecha, y luego a la izquierda hasta que no se pueda más.
Dos propiedades hacen que todo funcione:
- El sucesor sirve de reemplazo. Está en el subárbol derecho, así que es mayor que todo el subárbol izquierdo. Es el mínimo del derecho, así que es menor que todo lo que quede en él.
- El sucesor no tiene hijo izquierdo. Si lo tuviera, ese hijo sería una clave menor en el mismo subárbol, y no sería el mínimo. Por lo tanto, quitar su nodo es uno de los dos casos fáciles.
Así que el borrado con dos hijos se reduce a dos pasos: copiar la clave del sucesor al nodo, y quitar el nodo del sucesor. Veamos borrar el 5, con pseudocódigo primero:
algoritmo borrar(arbol, clave)
    enlace ← enlace de arbol que apunta al nodo con esa clave
    si no existe ese enlace entonces
        devolver falso
    fin si
    nodo ← el nodo al que apunta enlace
    si nodo tiene dos hijos entonces
        enlace ← enlace derecho de nodo
        mientras el nodo al que apunta enlace tenga hijo izquierdo hacer
            enlace ← enlace izquierdo de ese nodo
        fin mientras
        sucesor ← el nodo al que apunta enlace
        clave de nodo ← clave de sucesor
        nodo ← sucesor
    fin si
    enlace apunta al único hijo de nodo, o a NULO si no tiene
    liberar nodo
    devolver verdadero
fin algoritmo
Y en C++, ya con el enlace como Node**:
Node* node = *link;
if (node->left != nullptr && node->right != nullptr) {
    // Dos hijos: el sucesor es el mínimo del subárbol derecho.
    Node** next_link = &node->right;
    while ((*next_link)->left != nullptr) {
        next_link = &(*next_link)->left;
    }
    node->key = (*next_link)->key;
    // Ahora el que se quita es el nodo del sucesor, que no tiene hijo izquierdo.
    link = next_link;
    node = *link;
}
*link = node->left != nullptr ? node->left : node->right;
delete node;
size_--;
return true;
Observen la última parte: la misma línea sirve para los dos casos fáciles. Si el nodo no tiene hijos, los dos enlaces son nulos y el enlace queda nulo.
Sigamos el borrado del 5:
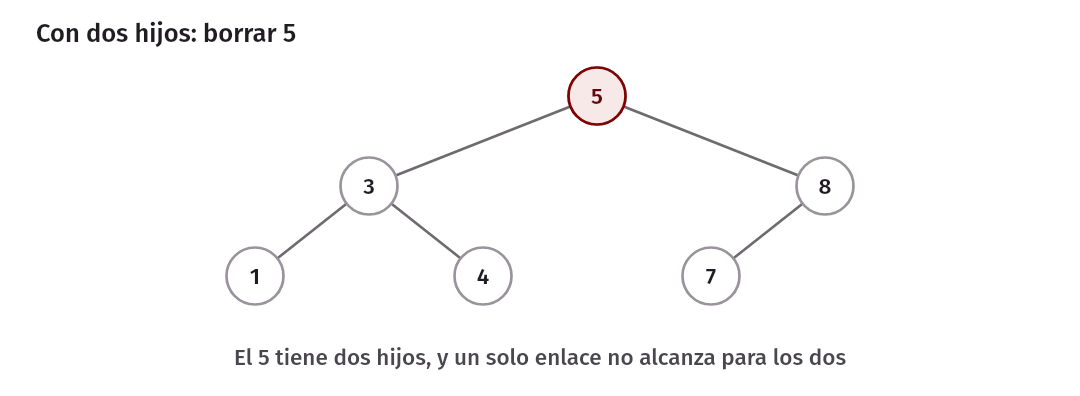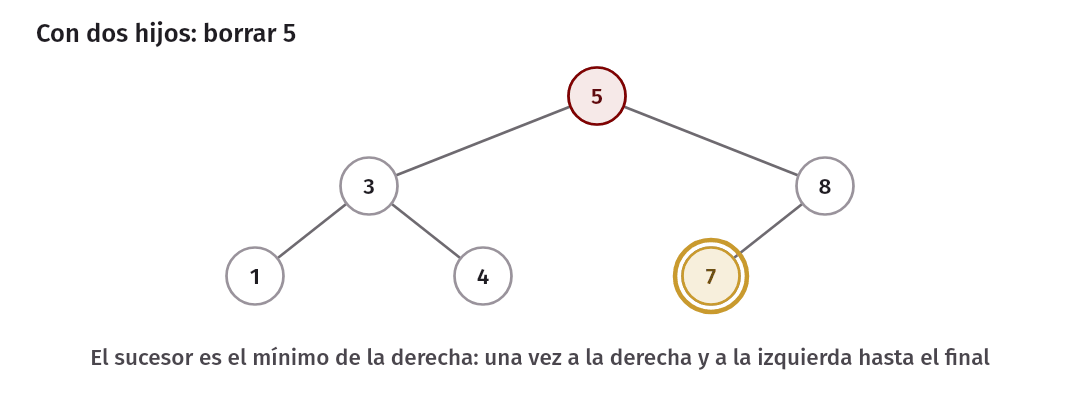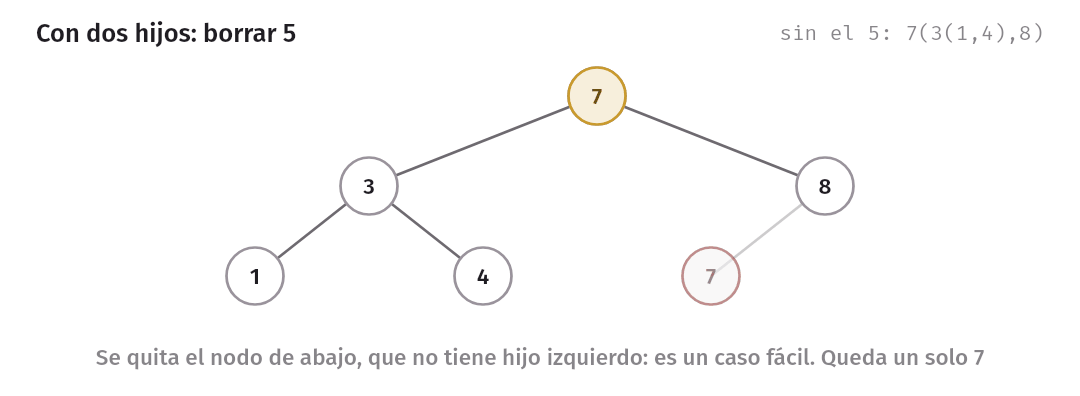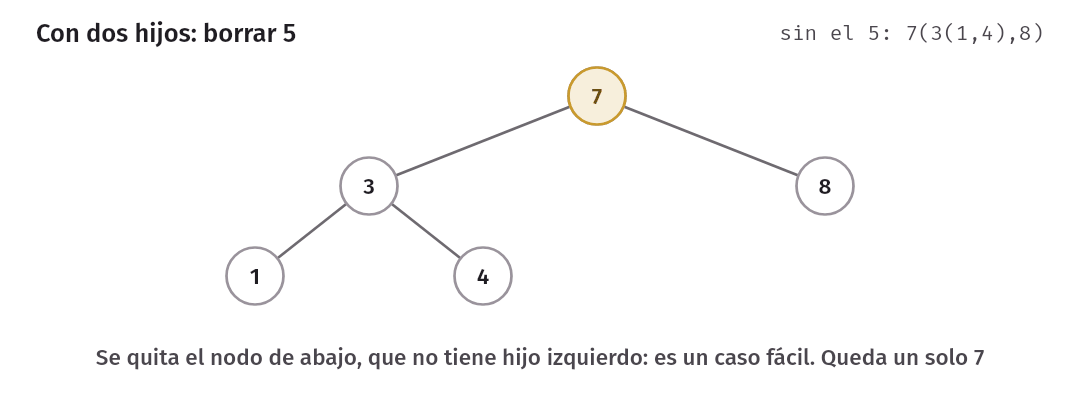
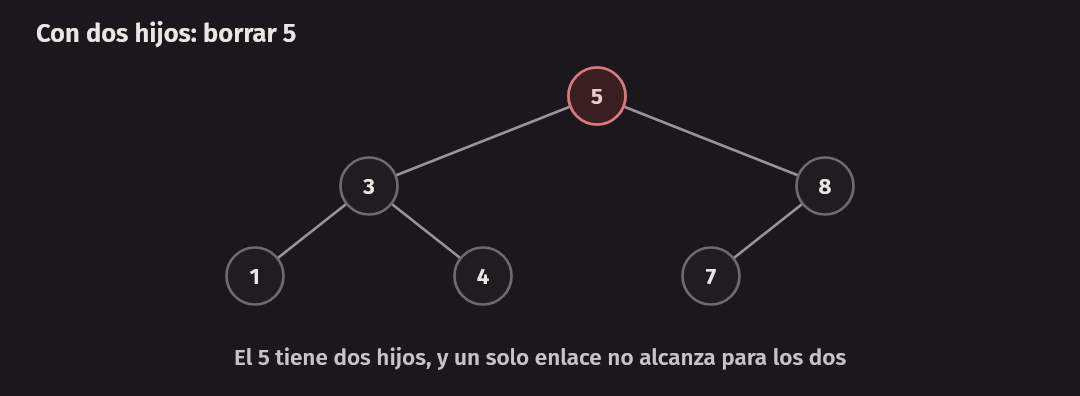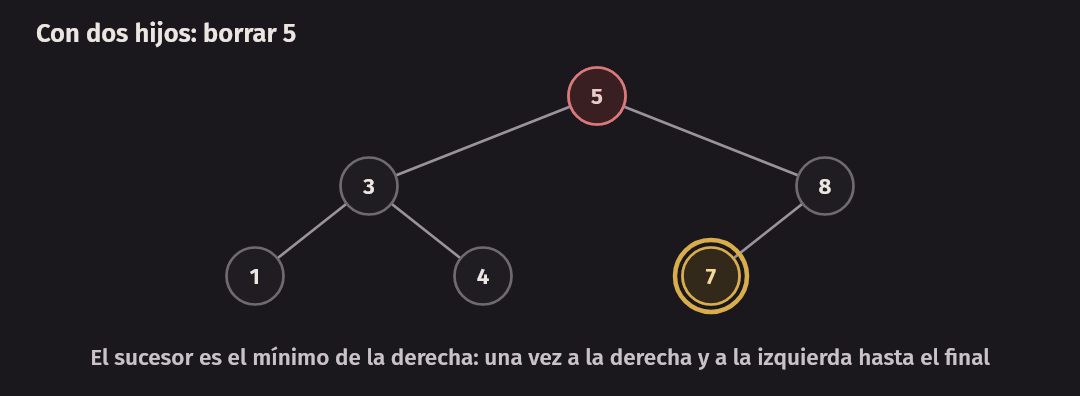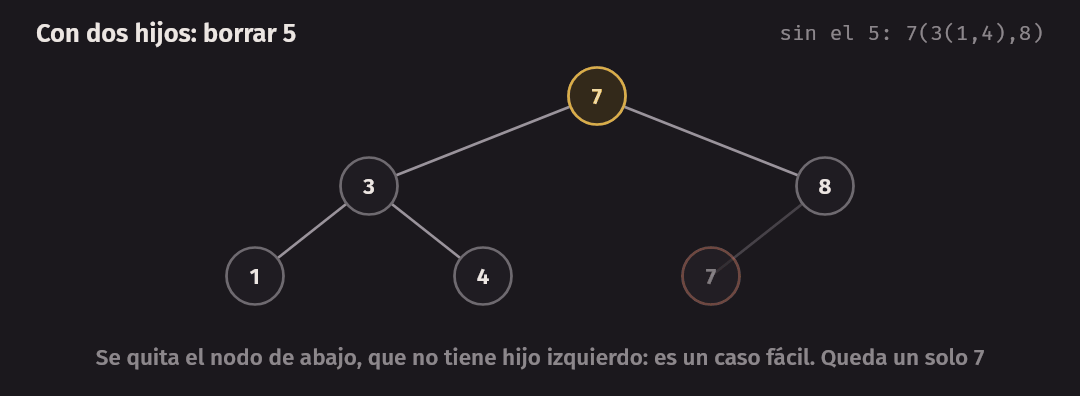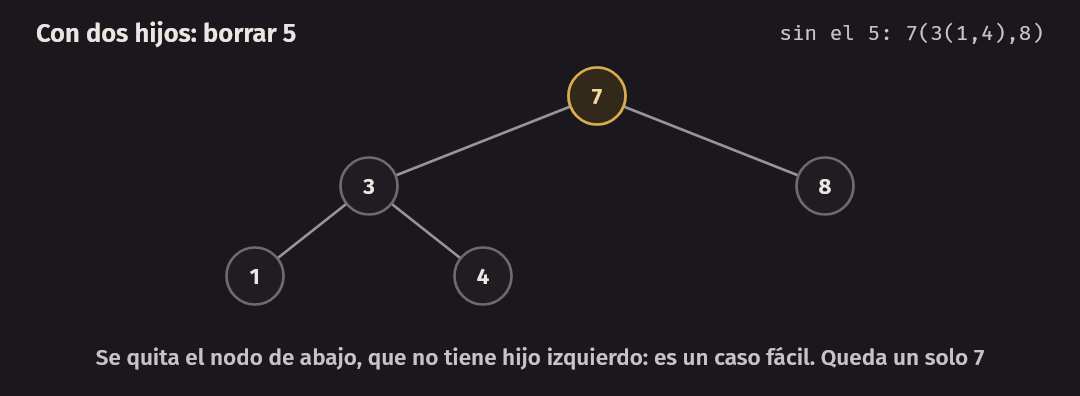
La salida de build/tree_demo de la sección anterior lo confirma: sin el 5: 7(3(1,4),8). El costo es
O(altura): una bajada hasta el nodo, y otra desde ahí hasta el sucesor, que suman como máximo la altura.
Error común: olvidar el nodo del sucesor
Error común. En el borrado con dos hijos, copiar la clave del sucesor y olvidar borrar el nodo del sucesor. La clave queda dos veces,
size_queda mal, y el programa sigue funcionando un buen rato, porque la búsqueda encuentra la primera copia.
errors/forgot_successor.cpp hace exactamente eso. El recorrido en orden ya muestra el 7 repetido, y
check_invariants lo detiene:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/forgot_successor.cpp -o build/forgot_successor && build/forgot_successor
1 3 4 7 7 8
forgot_successor: errors/forgot_successor.cpp:73: static std::size_t BrokenSet::count_checked(const Node*, const int*, const int*): Assertion `low == nullptr || *low < node->key' failed.
La invariante que falló es la de los límites: el segundo 7 tiene como límite inferior al primero. Por eso
check_invariants se llama después de cada operación en las pruebas al azar.
Todos los casos, sobre un árbol más grande
erase_demo borra, cada vez sobre el mismo árbol, una clave de cada tipo. Para leer las formas, conviene
dibujar la primera:
                50
             /      \
          30          70
         /  \        /  \
       20    40    60    80
             /      \      \
           35       65     90
$ build/erase_demo
borrar 20: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 50(30(_,40(35,_)),70(60(_,65),80(_,90)))
borrar 80: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 50(30(20,40(35,_)),70(60(_,65),90))
borrar 60: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 50(30(20,40(35,_)),70(65,80(_,90)))
borrar 30: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 50(35(20,40),70(60(_,65),80(_,90)))
borrar 50: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 60(30(20,40(35,_)),70(65,80(_,90)))
borrar 70: 50(30(20,40(35,_)),70(60(_,65),80(_,90)))
queda: 50(30(20,40(35,_)),80(60(_,65),90))Revisen tres casos. Borrar 20 es una hoja. Borrar 80 y 60 sube a su único hijo. Borrar 50 tiene dos hijos, y su sucesor, 60, está a varios niveles: 60 sube a la raíz, y su hijo 65 ocupa su sitio, por el caso de un hijo. Borrar 70 también tiene dos hijos, pero su sucesor es 80, su propio hijo derecho, sin ir a la izquierda ni una vez: ese es el caso en que más errores se cometen al programar con punteros al padre, y las pruebas del laboratorio lo revisan aparte.
Usar el predecesor en vez del sucesor es igual de correcto y da otro árbol. Elegimos siempre el sucesor para que todos obtengan la misma forma; las pruebas del laboratorio comparan formas exactas.
Lo que cuesta copiar la clave
Copiar la clave del sucesor es sencillo, y tiene un precio que es bueno conocer: el contenido cambia de nodo. Si alguien tenía un puntero a la clave 7, su nodo acaba de desaparecer, aunque el 7 sigue en el conjunto:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/pointer_after_erase.cpp -o build/pointer_after_erase && build/pointer_after_erase
sigue el 7: 1
=================================================================
==25275==ERROR: AddressSanitizer: heap-use-after-free on address 0x503000000130 at pc 0xaaaaea40c824 bp 0xffffda269b20 sp 0xffffda269b38
READ of size 4 at 0x503000000130 thread T0
    #0 0xaaaaea40c820 in main errors/pointer_after_erase.cpp:15
...
0x503000000130 is located 0 bytes inside of 24-byte region [0x503000000130,0x503000000148)
freed by thread T0 here:
...
    #1 0xaaaaea40ed4c in BstSet<int>::erase(int const&) errors/../bst_set.h:114
Nuestro contrato es entonces: los punteros a claves valen hasta el próximo borrado. También hay una versión que
no copia nada, sino que reenlaza el nodo del sucesor en el lugar del borrado. Es lo que hace falta para la
garantía de std::map, como veremos, y es el ejercicio 11.
Consultas ordenadas
Vamos a las preguntas del inicio.
Mínimo y máximo. El mínimo es el nodo que se alcanza bajando siempre a la izquierda: todo lo que esté a la derecha de un nodo de ese camino es mayor. El máximo es simétrico. Cuestan O(altura).
Piso. Se baja como en una búsqueda, y se recuerda el mejor candidato encontrado hasta el momento.
algoritmo piso(arbol, x)
    nodo ← raiz de arbol
    candidato ← NULO
    mientras nodo ≠ NULO hacer
        si x < clave de nodo entonces
            nodo ← hijo izquierdo de nodo
        sino si clave de nodo < x entonces
            candidato ← nodo
            nodo ← hijo derecho de nodo
        sino
            devolver nodo
        fin si
    fin mientras
    devolver candidato
fin algoritmo
La razón está en lo que cada comparación descarta. Si la clave del nodo es mayor que x, ni el nodo ni su subárbol derecho pueden ser el piso: hay que ir a la izquierda. Si es menor, el nodo puede ser la respuesta, y lo que sea mejor solo puede estar a su derecha, porque a la izquierda solo hay claves más chicas.
Sigamos piso(6) sobre nuestro árbol:
| nodo | comparación | candidato |
|---|---|---|
| 5 | 5 < 6, derecha | 5 |
| 8 | 6 < 8, izquierda | 5 |
| 7 | 6 < 7, izquierda | 5 |
| nulo | termina | 5 |
El techo es simétrico, y lo escriben en el laboratorio. Cada paso baja un nivel: O(altura). Nunca hace falta volver atrás para “probar el otro lado”.
Rango. Queremos las claves de [a, b), en orden, sin mirar el árbol completo. Es un recorrido en orden con poda (pruning):
algoritmo rango(nodo, a, b, salida)
    si nodo = NULO entonces
        devolver
    fin si
    si a < clave de nodo entonces
        rango(hijo izquierdo de nodo, a, b, salida)
    fin si
    si a ≤ clave de nodo y clave de nodo < b entonces
        agregar clave de nodo a salida
    fin si
    si clave de nodo < b entonces
        rango(hijo derecho de nodo, a, b, salida)
    fin si
fin algoritmo
Sigamos rango con [4, 8) en nuestro árbol. La hoja 1 queda sin visitar:
| Nodo | ¿a < clave? | ¿en rango? | ¿clave < b? |
|---|---|---|---|
| 5 | 4 < 5: baja a la izquierda | después de la izquierda: sale 5 | 5 < 8: baja a la derecha |
| 3 | 4 < 3 no: poda el 1 | no | 3 < 8: baja a la derecha |
| 4 | 4 < 4 no: sin hijo que podar | sale 4 | 4 < 8: sin hijo derecho |
| 8 | 4 < 8: baja a la izquierda | después de la izquierda: 8 no entra | 8 < 8 no: poda lo de la derecha |
| 7 | 4 < 7: sin hijo izquierdo | sale 7 | 7 < 8: sin hijo derecho |
La salida es 4, 5, 7, ya en orden, sin haber tocado el 1.
Si la clave del nodo es ≤ a, todo su subárbol izquierdo es menor que a: se poda. Si es ≥ b, todo el subárbol derecho es ≥ b: se poda. Los nodos que se visitan son de dos tipos: los que están en el rango, que se devuelven, y los que están en los dos caminos que bajan hasta los bordes a y b, que son como máximo 2(altura + 1). En total, el costo es O(altura + k), si k es la cantidad de claves del rango.
Comprobémoslo contando comparaciones en un árbol perfecto de 1023 claves, de altura 9:
$ build/query_demo
claves: 1023, altura: 9
contains(5000): 1, comparaciones: 17
contains(5001): 0, comparaciones: 17
floor(5001): 5000, comparaciones: 17
range con 1 claves, comparaciones: 38
range con 10 claves, comparaciones: 78
range con 100 claves, comparaciones: 426
range con 1000 claves, comparaciones: 4018
Con 1 clave, 38 comparaciones: la bajada, y algo más por los bordes. Después crece unas 4 comparaciones por
clave: lo que hace rango en cada nodo. El costo no depende de que el árbol tenga 1023 claves, sino de su
altura y de cuántas devuelve. Una tabla hash no puede hacer esto: tendría que mirar sus 1023.
En la biblioteca.
std::mapno tiene funciones llamadas piso ni techo, sinolower_bound(x), que da la primera clave ≥ x, yupper_bound(x), que da la primera clave > x. El techo eslower_bound(x). El piso es el elemento anterior aupper_bound(x), siupper_bound(x)no esbegin(). Un rango [a, b) es desdelower_bound(a)hastalower_bound(b). Olvidar el casobegin()y hacerstd::prevsobre él es comportamiento indefinido.
El puntero al padre
Nos falta una operación: dado un nodo, ¿cuál es el siguiente? Es decir, el sucesor de un nodo cualquiera,
incluso si no tiene hijo derecho. La necesitamos para tener iteradores, como en la semana 5: for (auto [clave, valor] : mapa) debe entregar las claves en orden, y cada ++ debe saber adónde ir.
Si el nodo tiene hijo derecho, ya lo sabemos: el mínimo de ese subárbol. Si no lo tiene, hay que subir. Y
BstSet no puede subir: sus nodos solo conocen a sus hijos. Hay dos soluciones:
- Que el iterador guarde una pila con el camino desde la raíz.
- Que cada nodo guarde un puntero a su padre.
El mapa del laboratorio usa la segunda, y std::map también en la biblioteca del curso. Cuesta 8 bytes por nodo
y una asignación más al enlazar, y da varias cosas a cambio:
- Un iterador es solo un puntero a un nodo, y sigue valiendo si otro insertó algo. Una pila guardada quedaría desactualizada.
- El destructor puede ser un postorden real, sin recursión y sin memoria adicional.
- Las semanas 11 y 12 tienen que subir desde el nodo nuevo hasta la raíz, reparando. El padre les da ese camino.
La invariante nueva es: si x tiene hijo h, entonces h->parent == x, y la raíz tiene padre nulo.
check_invariants también debe comprobarla. Toda línea que cambie un left o un right tiene que pensar en el
parent del otro lado: es el error que más verán.
El sucesor con padre
Si un nodo no tiene hijo derecho, todo lo que ya se recorrió de su subárbol termina en él. El siguiente es el primer antepasado del que venimos por la izquierda, porque es el primero que todavía no se visitó en el orden:
algoritmo sucesor(nodo)
    si nodo tiene hijo derecho entonces
        devolver minimo(hijo derecho de nodo)
    fin si
    padre ← padre de nodo
    mientras padre ≠ NULO y nodo es hijo derecho de padre hacer
        nodo ← padre
        padre ← padre de padre
    fin mientras
    devolver padre
fin algoritmo
En nuestro árbol, el sucesor de 4: no tiene hijo derecho. Es hijo derecho de 3, así que subimos. 3 es hijo
izquierdo de 5, así que paramos: es 5. El sucesor de 8: no tiene hijo derecho, es hijo derecho de 5, subimos, y
5 no tiene padre: devuelve nulo. Ese nulo es el final del recorrido, y el end() del iterador.
Esta es la secuencia completa de un recorrido con iteradores por nuestro árbol. begin() baja al mínimo, y cada
++ hace lo que dice la tabla:
| Desde | Regla | Camino | Llega a |
|---|---|---|---|
begin() |
mínimo desde la raíz | 5, 3, 1 | 1 |
| 1 | sin derecho; es hijo izquierdo de 3 | sube a 3 | 3 |
| 3 | tiene derecho; mínimo de ese subárbol | baja a 4 | 4 |
| 4 | sin derecho; hijo derecho de 3, que es hijo izquierdo de 5 | sube a 3, a 5 | 5 |
| 5 | tiene derecho; mínimo de ese subárbol | baja a 8, a 7 | 7 |
| 7 | sin derecho; es hijo izquierdo de 8 | sube a 8 | 8 |
| 8 | sin derecho; hijo derecho de 5, que es la raíz | sube a 5, a nulo | end() |
Cuenten las flechas de la columna Camino, sin contar la que llega a nulo desde la raíz: cada una de las 5
aristas del árbol aparece dos veces, una bajando y otra subiendo.
Costo. Un solo ++ puede costar Θ(altura), por ejemplo al pasar de 4 a 5 en un árbol grande. Pero recorrer
el árbol completo con iteradores cuesta Θ(n), no Θ(n · altura): cada arista se baja una vez y se sube una vez, y
un árbol de n nodos tiene n − 1 aristas. Es el mismo argumento de contabilidad del costo amortizado de la semana
4: ++ cuesta O(1) amortizado sobre un recorrido completo.
Postorden sin pila
Con padres, el destructor se puede escribir como un postorden verdadero y sin memoria adicional: se baja hasta una hoja, se borra, y se vuelve al padre con el enlace ya cortado. Así, ese padre se ve con un hijo menos, y al final se vuelve hoja él mismo:
algoritmo destruir(arbol)
    nodo ← raiz de arbol
    mientras nodo ≠ NULO hacer
        si nodo tiene hijo izquierdo entonces
            nodo ← hijo izquierdo de nodo
        sino si nodo tiene hijo derecho entonces
            nodo ← hijo derecho de nodo
        sino
            padre ← padre de nodo
            si padre ≠ NULO entonces
                poner en NULO el enlace de padre que apunta a nodo
            fin si
            liberar nodo
            nodo ← padre
        fin si
    fin mientras
fin algoritmo
Cada arista se baja una vez y se sube una vez: Θ(n), con memoria adicional O(1).
La altura lo decide todo
Buscar, insertar y borrar cuestan O(altura). ¿Entre qué valores se mueve la altura de un árbol de n nodos?
El máximo es n − 1. Si cada nodo tiene un solo hijo, el árbol es una cadena: una lista enlazada con pasos de más.
El mínimo es ⌊log₂ n⌋. A profundidad d caben como máximo 2^d nodos, porque cada nivel tiene a lo sumo el doble que el anterior. Un árbol de altura h tiene como máximo 1 + 2 + 4 + … + 2^h = 2^(h+1) − 1 nodos. Si n ≤ 2^(h+1) − 1, entonces h ≥ log₂(n + 1) − 1, y como h es un entero, h ≥ ⌊log₂ n⌋.
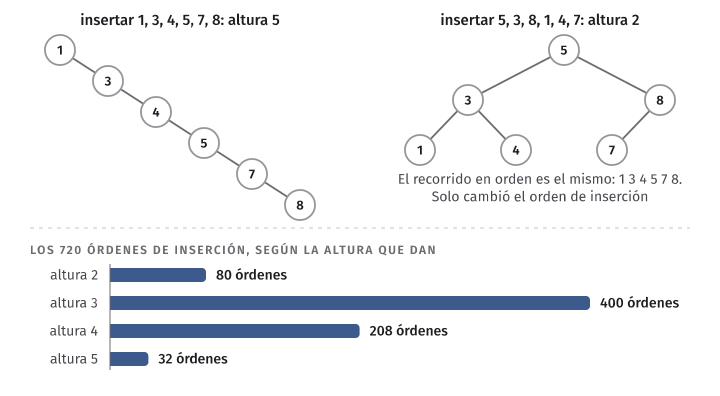
Son valores muy distintos: con un millón de nodos, la altura está entre 19 y 999 999. Y la decide solo el orden
de inserción. Volvamos a las claves 1, 3, 4, 5, 7 y 8. Hay 6! = 720 órdenes posibles de inserción.
insertion_orders los prueba todos:
$ build/insertion_orders
ordenes: 720
altura 2: 80 ordenes
altura 3: 400 ordenes
altura 4: 208 ordenes
altura 5: 32 ordenes
La mayor altura con 6 claves es 5. Se alcanza con los 32 órdenes que forman una cadena. El más evidente es el orden creciente, 1, 3, 4, 5, 7, 8. Pero también son cadenas el decreciente y otros en zigzag, como 1, 8, 3, 7, 4, 5: cada clave insertada debe ser la menor o la mayor de las que quedan, porque si no, parte las siguientes en dos lados. La última no tiene opción: son 2 × 2 × 2 × 2 × 2 × 1 = 32.
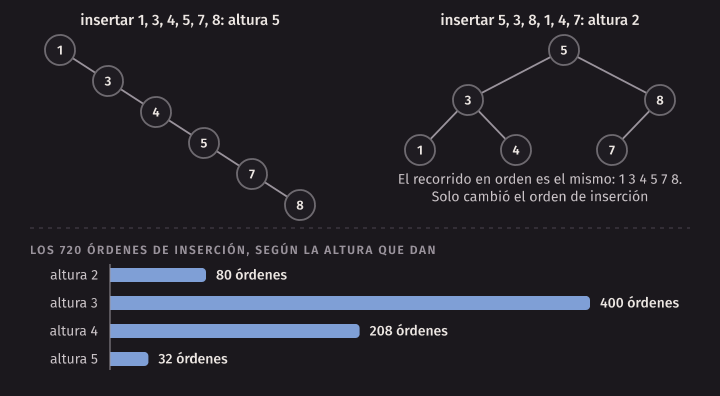
Ordenadas: una lista
Si se insertan claves crecientes, cada una baja por toda la cadena, y BstSet hace dos comparaciones por nodo
para seguir a la derecha. La inserción número i baja por i nodos, y la suma 0 + 1 + … + (n − 1) es n(n − 1)/2
nodos. Por lo tanto, se hacen exactamente n(n − 1) comparaciones. No es una aproximación:
$ build/height_table
Claves al azar, tres semillas
        n  log2n    h1    h2    h3  h/log2n prof.media  prof/log
     1000   10.0    21    25    19     2.17      11.28      1.13
     4000   12.0    28    26    25     2.20      13.51      1.13
    16000   14.0    33    31    30     2.24      16.52      1.18
    64000   16.0    39    36    38     2.36      19.32      1.21
   256000   18.0    46    42    42     2.41      22.01      1.23
  1024000   20.0    55    46    47     2.47      24.52      1.23
Claves ordenadas
        n   altura  comparaciones         n(n-1)
     1000      999         999000         999000
     2000     1999        3998000        3998000
     4000     3999       15996000       15996000
     8000     7999       63992000       63992000
    16000    15999      255984000      255984000
Al azar: se mide, no se demuestra
La primera tabla es lo interesante. Si se barajan las claves, la altura se queda entre 2.17 y 2.47 veces log₂ n en estas corridas, y la profundidad media, que es lo que cuesta una búsqueda típica, entre 1.13 y 1.23 veces. Con un millón de claves, una búsqueda típica recorre unos 25 nodos, y no medio millón.
Tres cosas honestas sobre esta tabla:
- “Cercana a log n” significa de ese orden, no igual. La altura medida es más del doble de log₂ n. Las
columnas
h/log2nyprof/logsuben despacio, y estos datos no alcanzan para decir en qué valor se detienen. Lo que sí muestra es que crecen muchísimo menos que n. - No lo demostramos. Existe una demostración de que la altura esperada es O(log n) con claves en orden al azar. Necesita probabilidad y va más allá de este curso. Aquí es una medición, con la semilla fija para que pueda repetirse.
- Esto solo mide inserciones. Con millones de borrados e inserciones mezclados la forma cambia, porque nuestro borrado siempre toma del lado derecho. No lo medimos aquí. Pueden hacerlo en el ejercicio 9.
Idea clave. Un árbol binario de búsqueda sin balance es rápido si tiene suerte. Nadie le garantiza esa suerte, y los datos ordenados son lo más común del mundo. La semana que viene, en vez de confiar en la suerte, reparamos la forma.
El reloj
Comprobemos que el reloj dice lo mismo que los conteos. insert_times mide insertar n enteros, al azar y en
orden, con la mediana de 5 repeticiones, en -O2, sin sanitizers. Los tiempos dependen de la máquina; estos son
de la del curso, con otras tareas corriendo, y la forma se repitió en 3 corridas. La columna x dice por cuánto
se multiplicó el tiempo respecto de la fila anterior:
$ build/insert_times
        n    azar(s)         x    orden(s)         x
     1000    0.00003       0.0     0.00090       0.0
     2000    0.00009       2.6     0.00357       4.0
     4000    0.00023       2.6     0.01438       4.0
     8000    0.00070       3.0     0.06098       4.2
    16000    0.00194       2.8     0.24795       4.1
    32000    0.00513       2.6     1.06629       4.3
Con claves ordenadas, duplicar n multiplica el tiempo por 4, muy cerca de lo que predice el conteo: es Θ(n²). Con 32 000 claves, ya tarda del orden de 200 veces más que al azar, y esa razón sigue creciendo con n.
Con claves al azar, duplicar n multiplica el tiempo por algo entre 2.2 y 3.2 en estas tres corridas, en vez del poco más de 2 que predicen los conteos, n log n. En una corrida anterior, con más carga, la última fila llegó a 4.0, así que no le den importancia a una fila suelta. Lo más probable es la cache: al crecer el árbol, sus nodos dejan de caber y cada
paso cuesta más, como vimos con las listas barajadas de la semana 5. Eso no lo medimos directamente, y no
tenemos perf en este entorno.
Un caso real: el diccionario
Nuestro palabras.txt tiene poco más de un millón de palabras. Viene ordenado por bytes, así que es el peor
caso, sin necesidad de buscarlo. dictionary_order lo comprueba, y mide con 20 000 palabras tal como vienen, y
luego barajadas. -O2, mediana de 3:
$ build/dictionary_order ../../data/palabras.txt
orden de bytes: si
tal como vienen: 20000 palabras, altura 19999, 1.17084 s
barajadas: 20000 palabras, altura 31, 0.00478758 s
barajadas: 1045757 palabras, altura 49, 1.73514 s
std::map, tal como vienen: 1045757 palabras, 0.174806 s
Las mismas 20 000 palabras tardan del orden de 200 veces más, sin ningún cambio en el código: solo cambió el
orden. Con el archivo completo no vale la pena intentarlo. Si el costo sigue siendo Θ(n²), que es lo que muestra
insert_times, multiplicar n por 52 multiplica el tiempo por unas 2700: alrededor de 3200 segundos, casi una hora, contra menos de 2 segundos barajando. Es una extrapolación, no una medición. La altura sí se sabe: 1 045 756.
La última línea es la que prepara la semana 11. std::map recibió el archivo completo en el mismo orden malo, y tardó 0.17 segundos. No tuvo suerte. Se reparó a sí mismo.
std::map frente a std::unordered_map
Ahora podemos comparar los dos diccionarios de la biblioteca. Conviene separar lo que promete el estándar de lo que hace nuestra biblioteca, libstdc++.
En la biblioteca. El estándar de C++ exige que
std::mapmantenga las claves ordenadas, y quefind,insertyerasede una clave cuesten O(log n). También promete que insertar no invalida ningún iterador ni referencia, y que borrar invalida solo los del elemento borrado. No dice cómo. Que sea un árbol rojinegro es una decisión de la biblioteca. En libstdc++ se ve enbits/stl_tree.h, donde_Rb_tree_node_basetiene un color y tres punteros: padre, izquierdo y derecho. Son los mismos tres punteros que usarán ustedes en el laboratorio.
Las garantías y el costo por nodo se pueden comprobar:
$ build/map_guarantees
puntero al 7 tras mil inserciones y un borrado: 70
reservas de std::map al insertar 1000 claves: 1000
bytes por nodo de std::map<int, int>: 40
bytes por nodo de std::unordered_map<int, int>: 16
El programa guarda un puntero al 7, inserta mil claves, y borra el 5, que tiene al 7 como sucesor y dos hijos:
el puntero sigue valiendo, a diferencia de BstSet. Y std::map hace una reserva de memoria por clave, de 40
bytes en esta biblioteca para un int y un int: 8 del par, 24 de los punteros y 8 del color con su relleno.
El nodo de std::unordered_map pide 16, pero además tiene su arreglo de buckets, que este conteo no incluye:
comparar esas dos cifras directamente no dice cuál ocupa menos.
Midamos con claves reales: las palabras barajadas de palabras.txt, en -O2, con la mediana de 3 repeticiones,
y tiempo en nanosegundos por palabra. ins es insertar, bus es buscar, y ord es sacar todas las claves en
orden: el mapa las recorre, y la tabla las tiene que ordenar. La columna x es cuántas veces gana el más rápido
de los dos. Dependen de la máquina:
$ build/map_vs_unordered ../../data/palabras.txt
  (tiempo por palabra, en ns; mediana de 3)
        n   ins.map  ins.hash      x   bus.map  bus.hash      x   ord.map  ord.hash      x
    10000       209        85    2.5       158        34    4.6        16       144    8.8
   100000       369       133    2.8       500        66    7.6        63       298    4.7
  1045757      1600       479    3.3      1542       220    7.0       140       640    4.6
En 4 corridas, la tabla ganó entre 2.5 y 3.7 veces al insertar y entre 4.6 y 9.0 veces al buscar. El mapa ganó entre 3.4 y 9.1 veces al sacar todo en orden. Esas son las proporciones que importan, no los nanosegundos.
std::map |
std::unordered_map |
|
|---|---|---|
| Buscar, insertar, borrar | O(log n) en el peor caso | O(1) en promedio, O(n) en el peor caso |
| Recorrer en orden | Sí, Θ(n) | No: hay que copiar y ordenar |
| Mínimo, piso, techo, siguiente | O(log n) | Θ(n) |
| Rango con k claves | O(log n + k) | Θ(n) |
| Qué pide a la clave | < |
hash e igualdad |
| Referencias a los elementos | Estables | Estables |
| Iteradores | Estables | Se invalidan al redistribuir (rehash) |
| En esta máquina, buscar | Unas 5 a 9 veces más lento | Más rápido |
Qué se gana con std::map: el orden, y lo que sale de él, como el piso, el techo y los rangos. Además, un peor
caso garantizado: ninguna clave desafortunada ni mal hash lo vuelve lineal. Qué se paga: varias veces más tiempo
por búsqueda, porque cada búsqueda hace unas 20 comparaciones de cadenas y persigue otros tantos punteros,
probablemente lejos en la memoria, mientras que la tabla calcula un hash y va casi directo.
Idea clave. Si no necesitan el orden, usen una tabla hash. Si necesitan piso, techo, rangos o recorrer ordenado, o un peor caso garantizado, usen un árbol. No es cuestión de gusto: es la pregunta que van a hacerle al diccionario.
Error común.
mapa[clave]en unstd::mapinserta la clave si no estaba, con un valor por defecto. Por eso no se puede usar en unconst std::map, y por eso un programa que “solo consultaba” termina con más claves. Para consultar usenfindocontains. También:insertno sobrescribe si la clave ya estaba; para eso estáinsert_or_assign.
Qué es orden para una cadena
std::string compara bytes, y UTF-8 codifica á, ñ y las demás letras con tilde con bytes mayores que los de
la z. Así que el orden “alfabético” de un mapa de cadenas no es el del diccionario:
$ build/byte_order ../../data/palabras.txt
ultima: úvulas
[a, b): 157836, de a a aúpo
[á, â): 261, de ábaco a ázoes
[n, o): 8267, de naaguán a núñez
[ñ, ò): 92, de ña a ñuñoa
[pre, prf): 9580, de preadamita a preñó
[z, {): 5959, de za a zúñiga
despues de zuzos: zuña
piso de rodillas: rodilla, siguiente: rodillazo
Fíjense en lo que dice esto:
- Una palabra que empieza con
áno está en el rango [a, b). Hay 261 de ellas después de laz. Lañno está entre lany lao:[n, o)no incluyeña. Y la última palabra del “alfabeto” esúvulas. - Un rango de prefijo funciona igual: las palabras con
preson [pre,prf), porqueprfes lo primero que ya no empieza conpre. Solo incluye las que empiezan con esos tres bytes: una palabra conpréqueda fuera, porqueéva después def. - Dentro de una palabra pasa igual:
zuñaqueda después dezuzos, porque ñ va después de z. - El diccionario tiene huecos.
rodillasno está: el piso derodillasesrodilla, y la que sigue esrodillazo. Es un límite de los datos, no de la estructura.
Para un orden alfabético de verdad habría que comparar con otra función, que no vea bytes sino letras, o guardar una versión de cada clave sin tildes para ordenar. Nuestro laboratorio se queda con el orden de bytes y lo dice. El ejercicio 10 les pide resolverlo.
El código de la semana
En code/week-10:
| Archivo | Qué contiene |
|---|---|
bst_set.h, tree_demo.cpp, erase_demo.cpp |
El conjunto BstSet, sus recorridos y su borrado |
query_demo.cpp, counted_key.h |
Consultas ordenadas, contando comparaciones |
insertion_orders.cpp, height_table.cpp |
La altura, con conteos y no con tiempos |
insert_times.cpp, dictionary_order.cpp, bench.h |
Mediciones con -O2 y sin sanitizers |
map_queries.cpp, map_guarantees.cpp, map_vs_unordered.cpp, alloc_counter.h |
std::map frente a std::unordered_map |
byte_order.cpp |
Rangos de palabras, y el orden de bytes |
test_structures.cpp |
Pruebas de BstSet: dirigidas y al azar, contra std::set |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo. Eso incluye volver a correr los comandos de este capítulo. Las
mediciones no se comparan, porque dependen de la máquina; lo que se compara son conteos, como las alturas y las
comparaciones.
El laboratorio
Escribirán BstMap<K, V> en lab/bst_map.h: un mapa con valores y con puntero al padre. No es BstSet con
un campo más: el puntero al padre cambia casi todas las líneas que tocan un enlace. Cada método sin hacer
detiene el programa con un mensaje que dice cuál falta.
make test-basics    # paso 1: insert, find, recorrido, destructor, check_invariants
make test-erase     # paso 2: erase, contra std::map
make test-queries   # paso 3: floor, ceiling, range, iterador
make test-words     # paso 4: el programa de frecuencias
make test-lab       # todo
make bench          # paso 5: la tabla para su informe, con -O2 y sin sanitizers
El nodo es este, y no conviene cambiarlo, porque las semanas 11 y 12 parten de él agregando un campo al final:
struct Node {
    K key;
    V value;
    Node* parent = nullptr;
    Node* left = nullptr;
    Node* right = nullptr;
};
Algunas cosas que conviene saber antes de empezar:
- La copia, el movimiento,
heightypre_order_keysya vienen hechos. Ya escribieron la regla de cinco tres veces. Léanlos: la copia usa el puntero al padre para no hacer recursión, y copia el nodo completo, así que un campo nuevo se copia solo. También viene dadosplit_words, enlab/words.h, que parte un texto en UTF-8 en palabras, y pasa a minúsculas también las letras con tilde. insertse comporta como enstd::map. Si la clave ya está, no cambia el valor y devuelvefalse.operator[]sí la crea conV{}y devuelve una referencia: es lo que hace corto al programa de frecuencias.- Sugerimos seis funciones privadas.
min_node,successor,find_node,insert_node,replace_childyremove_nodeevitan repetir código, y la semana siguiente las usará.replace_childes la que pone en orden el problema de los enlaces: actualiza el enlace del padre, oroot_, y elparentdel hijo.remove_nodedevuelve el padre del nodo que salió del árbol: es de ahí de donde subirá la reparación de AVL. check_invariantspuede ser recursiva, porque las pruebas la usan en árboles pequeños. Pero no puede ser local. Las pruebasbroken_*dañan árboles sanos y exigen que los detecte: un orden roto a dos niveles, una clave repetida, un padre equivocado y un tamaño mal llevado.- El destructor y la inserción no pueden ser recursivos. Una prueba arma una cadena de 6000 nodos y la destruye con solo 128 KB de pila. Usen el pseudocódigo de la sección anterior.
rangeyfindno pueden recorrerlo todo. Las pruebas usan una clave que cuenta sus comparaciones, y que solo tieneoperator<.- Un iterador entrega un
Entry, unastructconkeyyvalue, que son referencias.keyesconst, para que nadie rompa el orden desde afuera;std::maphace lo mismo con sustd::pair<const K, V>. Eso permitefor (auto [word, count] : counts). rangees semiabierto: [low, high), como en toda la biblioteca. Por eso es natural con prefijos.- Los punteros que entrega el mapa valen hasta el próximo
erase. Está en el comentario de la clase; así es en nuestra versión, y no enstd::map.
El programa del paso 4, lab/word_freq.cpp, cuenta las palabras de un texto:
build/lab/word_freq ../../data/tradiciones.txt             # todas, en orden de bytes
build/lab/word_freq ../../data/tradiciones.txt pre prf     # solo las de ese rango
En el paso 5, make bench les da la altura y el tiempo con claves al azar y ordenadas, y se detiene en el caso
ordenado cuando una corrida pasa de un segundo. Con esa tabla responden lab/report.md: qué vale h/log2n, por
cuánto se multiplica cada tiempo, y hasta qué n aguantó. Digan qué midieron y qué supusieron.
Resumen
- Una tabla hash no conserva el orden: mínimo, piso, techo y rango le cuestan Θ(n). Un árbol binario de búsqueda los responde bajando desde la raíz.
- Invariante: en cada nodo, todas las claves de la izquierda son menores y todas las de la derecha mayores. Se comprueba con límites que bajan, no mirando solo a los hijos.
- La altura es la mayor profundidad, contando aristas: −1 si está vacío, 0 con un nodo. Está entre ⌊log₂ n⌋ y n − 1.
- Buscar, insertar y borrar cuestan O(altura). Insertar agrega siempre una hoja.
- Borrar tiene tres casos: sin hijos se quita, con un hijo este sube, y con dos hijos se copia el sucesor y se quita su nodo, que no tiene hijo izquierdo.
- El recorrido en orden da las claves ordenadas. El preorden reconstruye la forma. El postorden procesa los hijos primero, por ejemplo para destruir.
- Un destructor recursivo gasta pila proporcional a la altura, y falla con una cadena muy larga. Se reemplaza con una pila propia o con punteros al padre.
- Con puntero al padre, el sucesor de cualquier nodo se obtiene subiendo, y
++cuesta O(1) amortizado sobre un recorrido completo. - Piso, techo y rango bajan recordando un candidato o podando: O(altura) y O(altura + k). En
std::mapse llamanlower_boundyupper_bound. - Insertar claves ordenadas da altura n − 1 y n(n − 1) comparaciones. Claves al azar dieron una altura de unas 2.2 a 2.5 veces log₂ n: es una medición.
std::mappromete O(log n) en el peor caso y el orden, y referencias estables.std::unordered_mapfue varias veces más rápido al buscar. Se elige por la pregunta que se le hace al diccionario.- Una
std::stringcompara bytes:áyñvan después dez.
Ejercicios
- Inserten 40, 20, 60, 10, 30, 50, 70 en un árbol vacío. Dibújenlo, escriban los tres recorridos, y borren
luego el 40, el 20 y el 70, dibujando después de cada borrado. Comprueben sus respuestas con
BstSetyshape(). - Dibujen dos árboles de búsqueda distintos con las claves 1, 2, 3 y 4. ¿Tienen el mismo recorrido en orden? ¿Y el mismo preorden? ¿Qué orden de inserción da cada uno?
- ¿Es este un árbol binario de búsqueda:
10(5(2,12),15)? Digan qué invariante rompe, y qué clave no se puede encontrar. ¿Lo detectalooks_finedeerrors/local_check.cpp? - Escriban
ceilingenBstSet, con su pseudocódigo y su tabla de pasos paratecho(6)en el árbol de 5, 3, 8, 1, 4 y 7. - Escriban
int height_of(const Node*), recursiva, en postorden. Cópienla a un programa que arme una cadena directamente, comoerrors/recursive_destroy.cpp. ¿Desde qué n falla con-O2y sin optimizar? ¿Por qué no le pasa a la versión deBstSetque va nivel por nivel, y cuánta memoria usa esa versión en una cadena y en un árbol perfecto? - Sobre
BstSet, agreguenconst K* kth(std::size_t i) const, que devuelva la clave número i en orden. Háganlo primero con el recorrido, en Θ(i + altura). ¿Qué tendrían que guardar en cada nodo para hacerlo en O(altura)? ¿Qué tendrían que actualizar al insertar y al borrar? - El mapa del laboratorio solo tiene
++. Escriban--para el iterador, primero en pseudocódigo. ¿Qué le falta para retroceder desdeend(), si este es un nodo nulo, y cómo lo resolverían? - Con una clave contada, midan cuántas comparaciones hace
std::mapal buscar en un mapa con 2^k claves, para k de 10 a 20. ¿Qué concluyen de la altura destd::map, si la biblioteca no la expone? ¿Podrían afirmarlo sin ver el código? - Inserten 100 000 claves al azar en
BstSet. Luego repitan muchas veces: borrar una clave al azar e insertar una nueva. Impriman la altura y la profundidad media cada 100 000 pasos. ¿Cambian? Prueben a alternar entre sucesor y predecesor al borrar. Corran con 3 semillas antes de concluir. - En
word_freq, hagan que el orden sea el del diccionario español: guarden como clave una versión sin tildes de cada palabra, y como valor la lista de formas con sus cantidades. ¿Dónde queda lañ? ¿Qué pasa conañoyano, y cómo lo arreglarían? - Escriban una versión de
eraseen elBstMapdel laboratorio que no copie nada y reenlace el nodo del sucesor en el lugar del borrado. Luego escriban una prueba con un puntero guardado, comoerrors/pointer_after_erase.cpp, que falle con la versión anterior y pase con esta. ¿Qué requisito deKyVdesaparece? - Al final del paso 5 estimaron el tiempo de insertar
palabras.txten orden. Propongan una forma de construir, a partir de un arreglo ordenado, un árbol de altura mínima, y escríbanla. Sigue el mismo camino queadd_balanceddequery_demo.cpp. ¿Cuánto tarda con el archivo completo? ¿Por qué no resuelve el problema si después siguen llegando inserciones?