Apuntes · Capítulo 13Prioridades y grafos
Heaps y colas de prioridad
Heaps y colas de prioridad
Las semanas 10, 11 y 12 construyeron árboles que guardan todo el orden de sus claves: se les puede pedir el mínimo, el sucesor de cualquier clave o un rango entero. Muchos problemas piden bastante menos. Un sistema operativo quiere el proceso más urgente. Un programa que busca rutas quiere el lugar pendiente más cercano. Nadie les pregunta por el tercero, ni por los que están entre dos valores: solo importa el siguiente.
Cuando se pide menos, se puede gastar menos. Hoy veremos el heap binario (binary heap): un árbol sin punteros, guardado en un arreglo común, con un orden tan débil que no sirve para buscar, pero que entrega el mínimo en O(1) y lo saca en O(log n). Con él vienen tres sorpresas. Construirlo con n elementos de una vez cuesta Θ(n), y no Θ(n log n), aunque insertar uno cueste O(log n). Basta un heap pequeño para hallar las 10 palabras más frecuentes de un libro sin ordenarlas todas. Y con el heap se arma un compresor de archivos de verdad, el de Huffman, que escribirán en el laboratorio. La semana 15 volverá a usar su heap para buscar rutas sobre un mapa.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): El tipo abstracto cola de prioridad, La invariante del heap y Un árbol completo, sin punteros.
- En clase: Insertar: agregar al final y subir, Sacar la raíz: bajar, Construir de abajo hacia arriba, Heapsort, Los k mayores de una secuencia,
std::priority_queuey Códigos de Huffman.- Después de clase: repasen con el Resumen y los Ejercicios, y lean Un compresor de verdad y El código de la semana. Opcional: Open Data Structures, secs. 10.1 (BinaryHeap) y 11.1.3 (Heap-sort); CLRS, capítulo Heapsort.
Código. Los programas de este capítulo están en
code/week-13. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
El tipo abstracto cola de prioridad
Definición. Una cola de prioridad (priority queue) es un tipo abstracto de datos que guarda elementos con un orden entre ellos y tiene tres operaciones:
| Operación | Qué hace |
|---|---|
push(x) |
Agrega el elemento x |
top() |
Devuelve el mínimo, sin sacarlo |
pop() |
Saca el mínimo |
No se puede pedir otra cosa: ni buscar, ni recorrer en orden, ni pedir el segundo. El elemento que sale no depende de cuándo entró, sino de su valor. Se parece a la cola de la semana 4 solo en el nombre: una sala de emergencias atiende primero al más grave, no al que llegó antes. Si dos elementos empatan, una cola de prioridad no promete cuál sale primero.
Aquí hablamos del mínimo, y la variante con el máximo es igual con el orden al revés. Ambas se usan. Lo que cuenta como “mínimo” lo decide un comparador, como los de la semana 6: en una cola de tareas, el “mínimo” puede ser la de mayor urgencia.
Como con todo tipo abstracto, la pregunta es qué estructura lo implementa. Con lo que ya conocen hay varias opciones:
| Implementación | push |
top |
pop |
|---|---|---|---|
| Arreglo sin ordenar | O(1) amortizado | Θ(n) | Θ(n) |
| Arreglo ordenado, con el mínimo al final | O(n) | O(1) | O(1) |
| Lista enlazada ordenada | O(n) | O(1) | O(1) |
| AVL o rojinegro | O(log n) | O(log n) | O(log n) |
El arreglo sin ordenar paga al sacar: tiene que mirar todo para hallar el mínimo, y lo saca cambiándolo con el último. Las dos versiones ordenadas pagan al insertar: en el peor caso, recorren o mueven todo para abrir el lugar. Ninguna de las tres ingenuas sirve si hay tantas inserciones como salidas: n de cada una cuesta Θ(n²) en el peor caso.
El árbol balanceado sí resuelve el problema, y un std::map con claves repetidas (std::multimap) funcionaría como
cola de prioridad. Pero mantiene un orden total que nadie consultará, y paga por él con un nodo en memoria dinámica
por elemento y varios punteros. Queremos solo lo necesario.
La invariante del heap
Definición. Un min-heap es un árbol binario completo en el que cada padre es menor o igual que sus hijos.
Dejemos “completo” para la próxima sección, y miremos el orden:
          1
        /   \
       3     8          1 ≤ 3, 1 ≤ 8
      / \               3 ≤ 5, 3 ≤ 4
     5   4
Es la invariante más débil que hemos visto. Comparen con un árbol binario de búsqueda: allí todo el subárbol izquierdo es menor que el nodo, y todo el derecho mayor, de modo que el orden completo está determinado. En un heap, un nodo no dice nada sobre hermanos ni primos: el 8 es mayor que el 5 y el 4, aunque está más arriba. Cada comparación solo vale a lo largo de un camino hacia la raíz.
¿Dónde está el mínimo? Tomen cualquier nodo y suban hasta la raíz: en cada paso el valor es menor o igual, así que la
raíz es menor o igual que ese nodo. Como vale para todos, la raíz es un mínimo. Si hay repetidos, otros nodos
pueden valer lo mismo, pero nadie vale menos. Por eso top es O(1).
¿Y el máximo? No tiene un lugar fijo. Con claves distintas, un nodo que tiene hijos no puede ser el máximo, porque
tiene un hijo mayor que él. Entonces el máximo está en una hoja, pero puede ser cualquier hoja. El programa
where_is_max revisa las 5040 permutaciones de 7 claves distintas y cuenta dónde queda cada extremo en las que son
heaps:
$ build/where_is_max
permutaciones: 5040, son heaps: 80
indice  minimo  maximo
     0  80      0
     1  0      0
     2  0      0
     3  0      20
     4  0      20
     5  0      20
     6  0      20
[1 2 2 2] es heap: si, y el indice 1 vale el maximo y tiene un hijo
El mínimo está en un solo lugar, y el máximo se reparte entre las cuatro hojas. La última línea es la excepción que hay que tener en cuenta: con claves repetidas, un nodo interno puede valer tanto como el máximo. En ese caso, lo correcto es decir que alguna hoja tiene el valor máximo. Hallar el máximo de un min-heap es Θ(n): hay que revisar las hojas, que son la mitad de los nodos.
Idea clave. Un heap está “ordenado a medias”: lo justo para que el mínimo esté a la vista, y nada más. Esa debilidad es lo que lo vuelve barato. Hay 80 heaps posibles con esas 7 claves, frente a uno solo de orden total: hay mucha libertad, y mantener la invariante pide pocos cambios.
Error común. Buscar en un heap como si fuera un árbol de búsqueda. El programa
errors/heap_as_bst.cppbaja a la izquierda si la clave es menor y a la derecha si es mayor, y busca cada elemento de un heap sano:$ g++ -Wall -Wextra -std=c++20 errors/heap_as_bst.cpp -o build/heap_as_bst && build/heap_as_bst busca 1: esta busca 3: NO ESTA busca 8: esta busca 5: NO ESTA busca 4: NO ESTABuscar el 3 falla porque, en la raíz, 3 > 1 lo manda a la derecha, y el 3 está a la izquierda. El heap no dice de qué lado está nada. Buscar en un heap cuesta Θ(n) en el peor caso: un heap solo poda cuando la clave buscada es menor que el nodo, porque nada de abajo puede valer menos. Si necesitan buscar, necesitan otra estructura.
Un árbol completo, sin punteros
Definición. Un árbol binario es completo (complete) si todos sus niveles están llenos, salvo quizá el último, que se llena de izquierda a derecha.
Esta forma es la otra mitad de la invariante, y tiene dos consecuencias.
La altura es pequeña. El nivel d de un árbol tiene como máximo 2^d nodos. En un árbol completo de altura h, los niveles 0 a h − 1 están llenos, con 2^h − 1 nodos, y el nivel h tiene al menos uno y como máximo 2^h. Entonces
2^h ≤ n < 2^(h+1) y por lo tanto h = ⌊log₂ n⌋No es “cerca de log n” en promedio ni con claves al azar: es exactamente eso, siempre, para cualquier heap no vacío. Nada de rotaciones, porque la forma no depende de los valores: la decide solo n.
No hacen falta punteros. Numeren los nodos por niveles, de izquierda a derecha, empezando en 0. Como no hay huecos, se pueden guardar en un arreglo en ese orden:
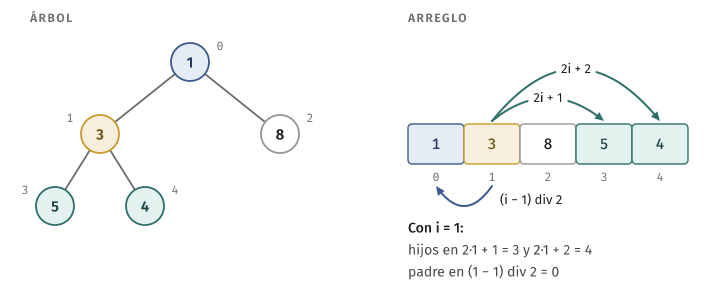
Moverse por el árbol es aritmética:
hijo izquierdo de i:   2i + 1
hijo derecho de i:     2i + 2
padre de i:            (i - 1) div 2,    si i > 0
¿Por qué esas fórmulas? Antes del nodo i, en el orden por niveles, hay i nodos. Cada uno tiene sus dos hijos antes que los hijos de i, y además está la raíz, que no es hijo de nadie. Así que antes del hijo izquierdo de i hay 2i + 1 nodos, y por eso ese es su índice. El derecho va justo después. El padre es la fórmula al revés: 2i + 1 y 2i + 2, restando 1 y dividiendo entre 2 con división entera, dan i en los dos casos.
Una tercera fórmula sale gratis. El nodo i es hoja si 2i + 1 ≥ n, es decir, si i ≥ ⌊n/2⌋. Con 5 elementos, los índices 0 y 1 tienen hijos y los índices 2, 3 y 4 son hojas. Por lo menos la mitad de los nodos son hojas: lo usaremos para construir.
Lo que se gana es grande. Un nodo de árbol de búsqueda con punteros a hijos y a padre guarda 24 bytes de enlaces en una
máquina de 64 bits, y además pide un bloque propio de memoria dinámica. Un heap de int es un arreglo de int: no
guarda nada más.
En C++. Con índices
std::size_t,(i - 1) / 2coni == 0no da 0: la resta da el número más grande posible, porquesize_tno tiene negativos, y el resultado es un índice absurdo. Por eso el ciclo que sube se detiene conwhile (i > 0), antes de calcular el padre.
Insertar: agregar al final y subir
Un elemento nuevo tiene que entrar sin romper la forma, y hay un solo lugar donde puede estar: justo después del último, en el primer hueco del último nivel. Eso conserva la forma, aunque puede romper el orden, pero solo en un punto: entre el nuevo y su padre. Se arregla subiendo (sift up): mientras el nuevo sea menor que su padre, cambian de lugar.
algoritmo insertar(arreglo, x)
    agregar x al final del arreglo
    i ← último índice
    mientras i > 0 hacer
        padre ← (i - 1) div 2
        si arreglo[padre] ≤ arreglo[i] entonces
            salir del ciclo
        fin si
        cambiar arreglo[padre] con arreglo[i]
        i ← padre
    fin mientras
fin algoritmo
La clase IntHeap de int_heap.h lo escribe así:
void push(int value) {
    items_.push_back(value);
    sift_up(items_.size() - 1);
}
void sift_up(std::size_t i) {
while (i > 0) {
std::size_t parent = (i - 1) / 2;
comparisons_++;
if (items_[parent] <= items_[i]) {
return;
}
std::swap(items_[parent], items_[i]);
i = parent;
}
}¿Por qué no se rompe nada al cambiar? Sea p el padre y x el nodo que sube, con x < p. Después del cambio, x queda encima de p y del otro hijo de p. El otro hijo era mayor o igual que p, así que también es mayor que x. El orden queda bien en ese lugar, y el único problema posible se movió un nivel hacia arriba.
Sigamos la inserción de 5, 3, 8, 1 y 4 en un heap vacío:
| Inserta | Arreglo al agregar | Qué sube | Arreglo final |
|---|---|---|---|
| 5 | 5 |
Nada, es la raíz | 5 |
| 3 | 5 3 |
3 < 5: cambia con la raíz | 3 5 |
| 8 | 3 5 8 |
Nada: 3 ≤ 8 | 3 5 8 |
| 1 | 3 5 8 1 |
1 < 5, y luego 1 < 3: dos cambios | 1 3 8 5 |
| 4 | 1 3 8 5 4 |
Nada: 3 ≤ 4 | 1 3 8 5 4 |
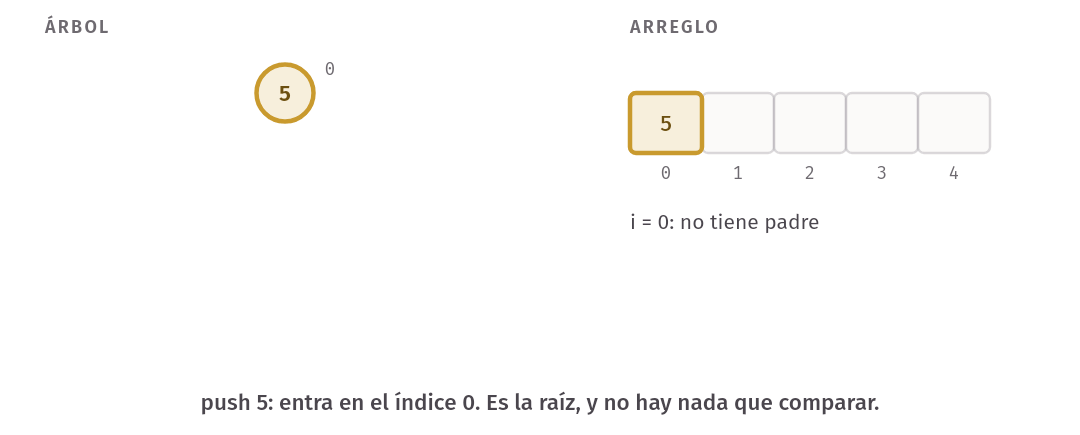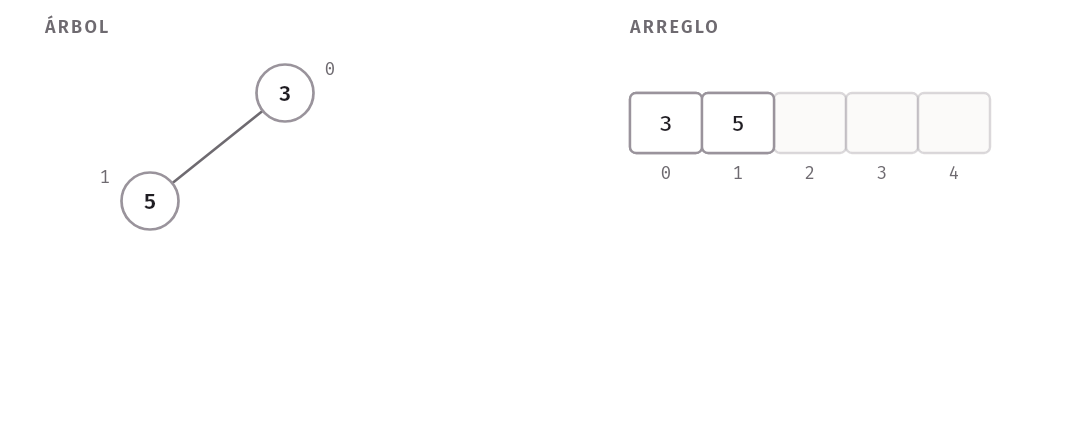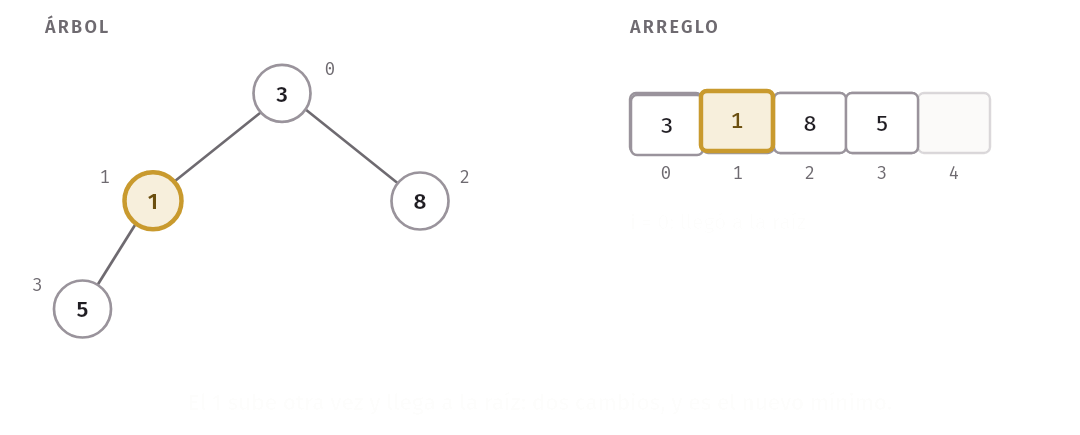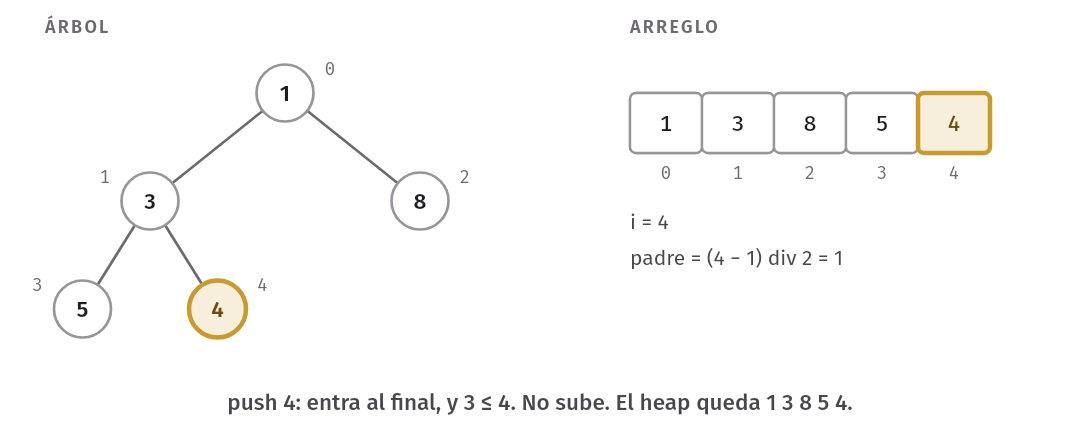
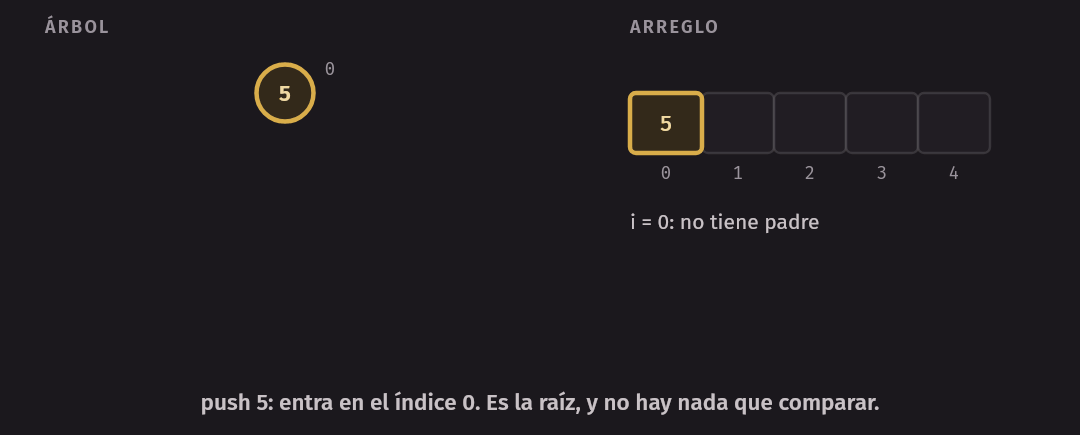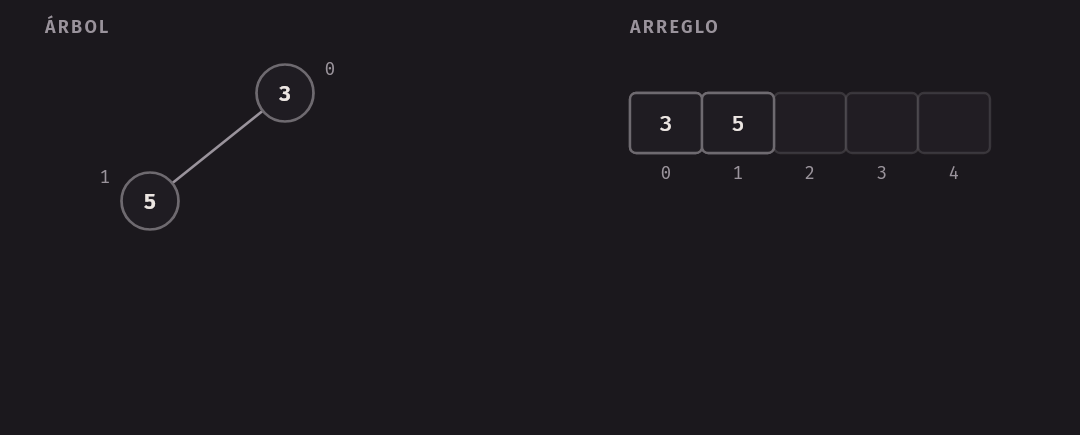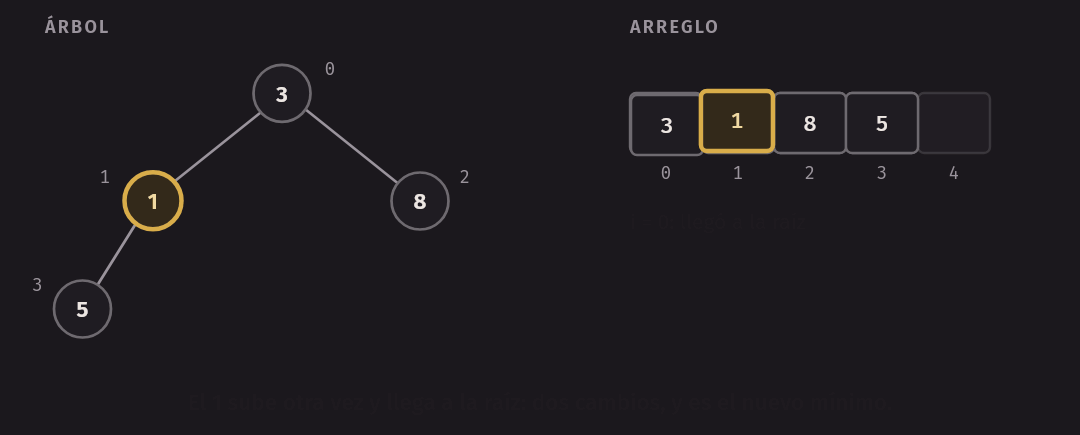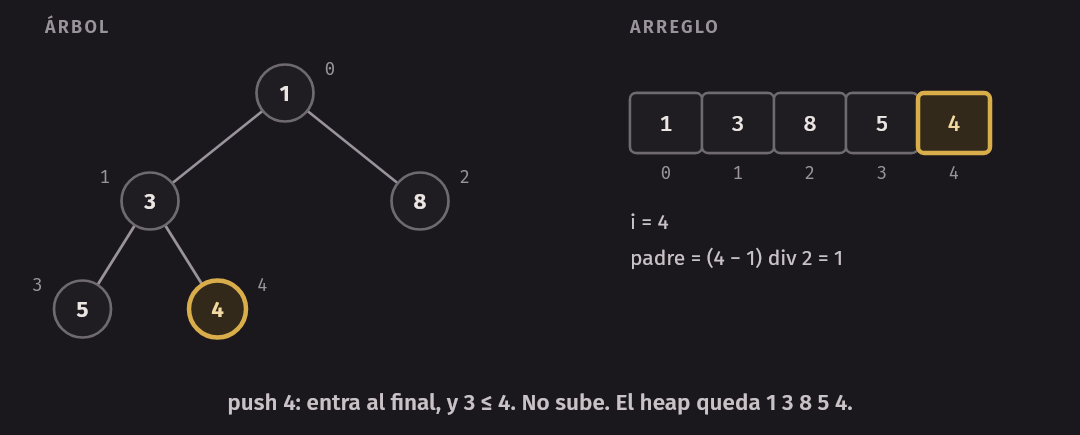
Con la misma secuencia corre el programa heap_demo:
$ build/heap_demo
push 5: [5]
push 3: [3 5]
push 8: [3 5 8]
push 1: [1 3 8 5]
push 4: [1 3 8 5 4]
pop  1: [3 4 8 5]
Costo. Cada paso hace una comparación y sube un nivel, así que push hace como máximo h = ⌊log₂ n⌋ comparaciones.
A esto hay que sumarle el push_back, que es O(1) amortizado por lo que vimos en la semana 4: una sola inserción puede
copiar el arreglo entero, pero el total de n inserciones no pasa de O(n log n).
Sacar la raíz: bajar
Hay que quitar la raíz, y el hueco que deja no puede quedar en la raíz. Pero la forma solo permite quitar la última hoja. Por eso se hacen las dos cosas a la vez: la última hoja pasa a ocupar la raíz. La forma queda bien, y el orden solo puede fallar entre la nueva raíz y sus hijos. Se arregla bajando (sift down): mientras algún hijo sea menor, se cambia con el menor de sus hijos.
algoritmo sacar_minimo(arreglo)
    arreglo[0] ← último elemento
    quitar el último elemento
    i ← 0
    mientras verdadero hacer
        menor ← i
        para cada hijo h de i dentro del arreglo hacer
            si arreglo[h] < arreglo[menor] entonces
                menor ← h
            fin si
        fin para
        si menor = i entonces
            salir del ciclo
        fin si
        cambiar arreglo[i] con arreglo[menor]
        i ← menor
    fin mientras
fin algoritmo
Saquemos el mínimo del heap de la sección anterior, 1 3 8 5 4:
| Paso | i | Hijos | Menor | Arreglo |
|---|---|---|---|---|
| El último pasa a la raíz | 0 | 4 3 8 5 |
||
| Compara 4 con 3 y 8 | 0 | 3, 8 | 3 | 3 4 8 5 |
| Compara 4 con 5 | 1 | 5 | 4 se queda | 3 4 8 5 |
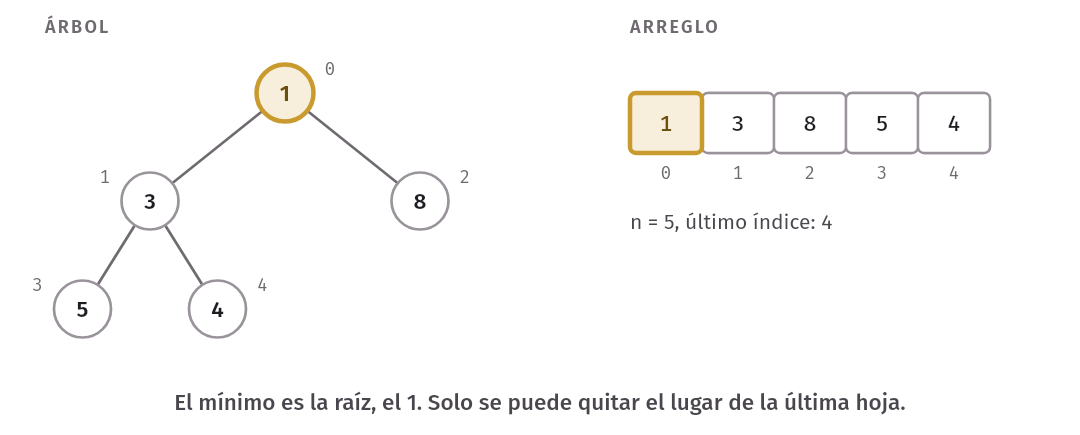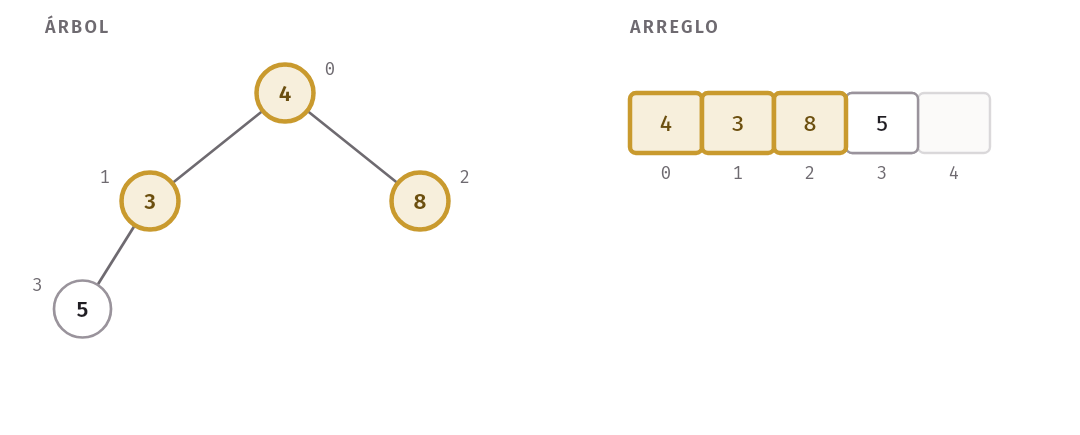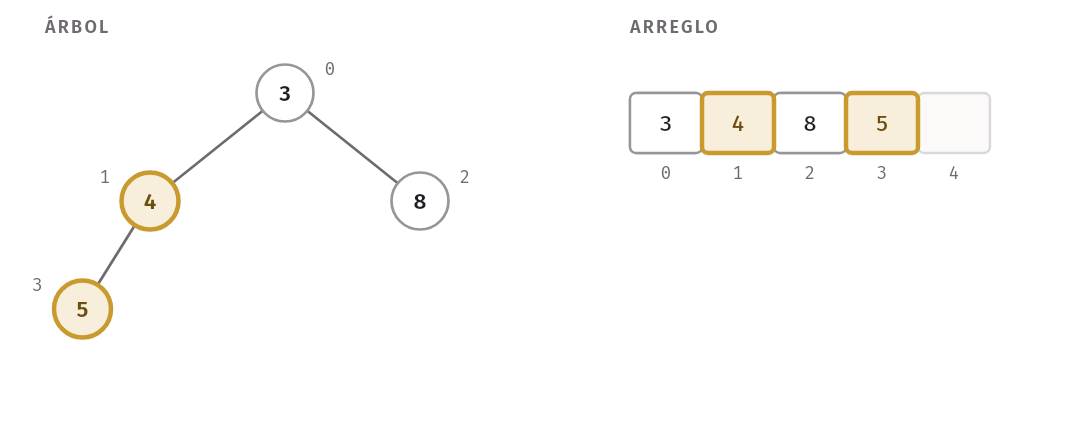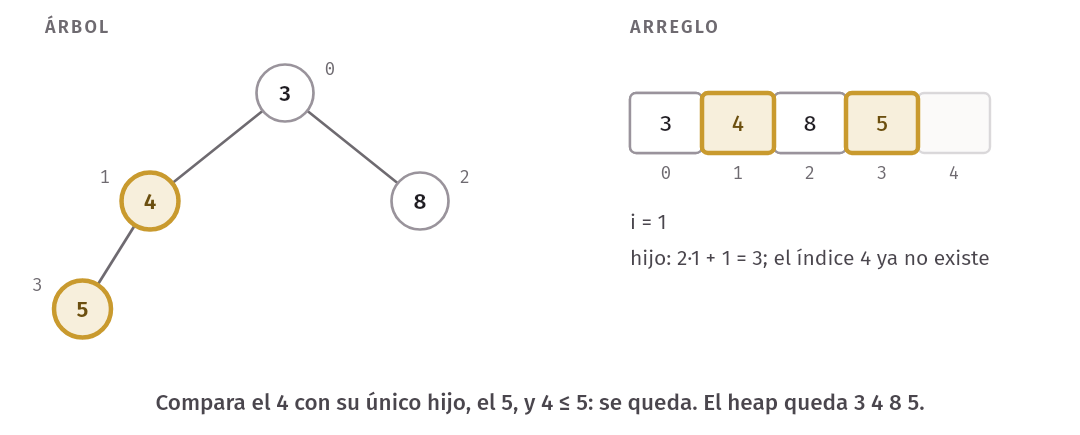
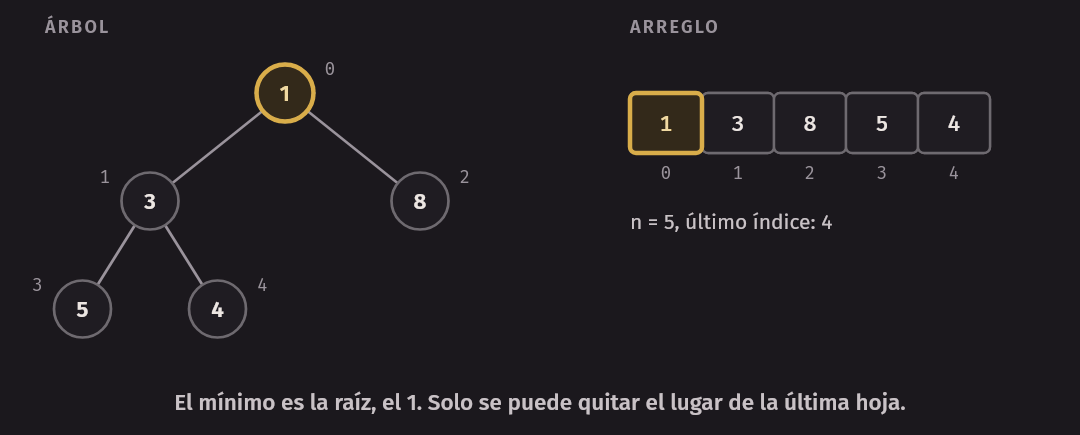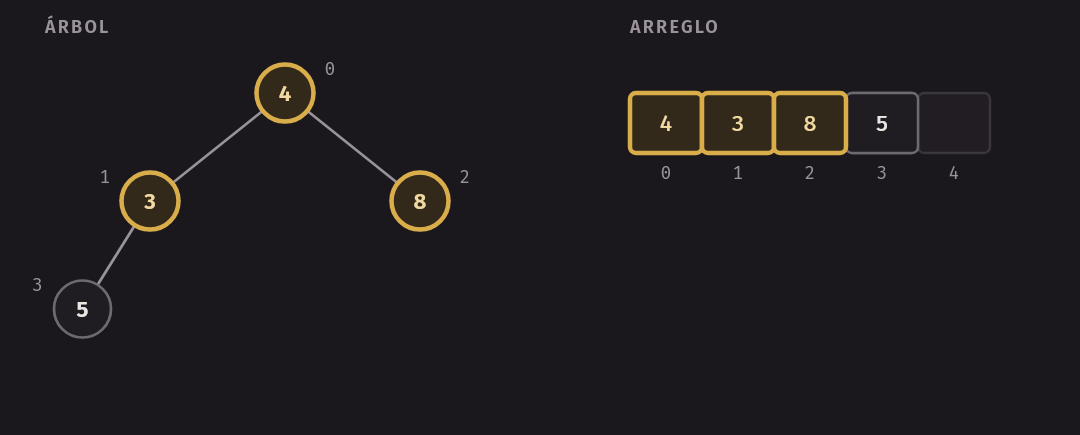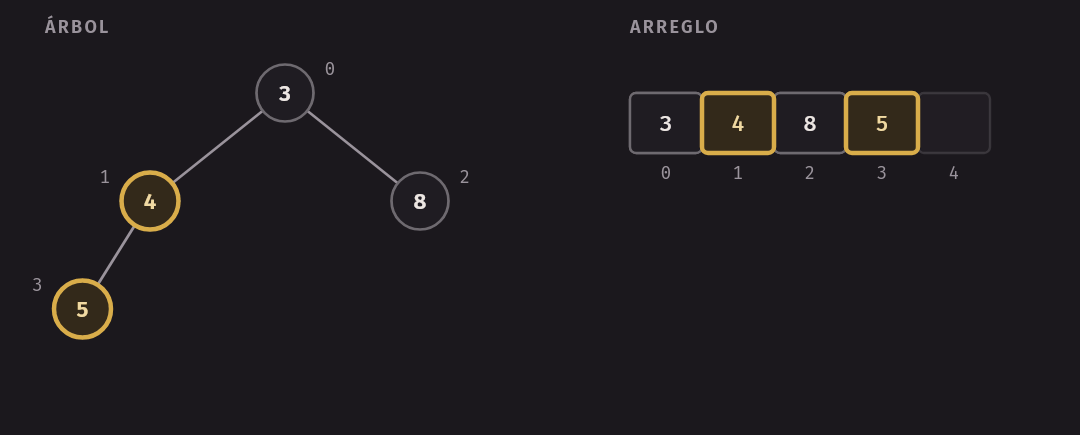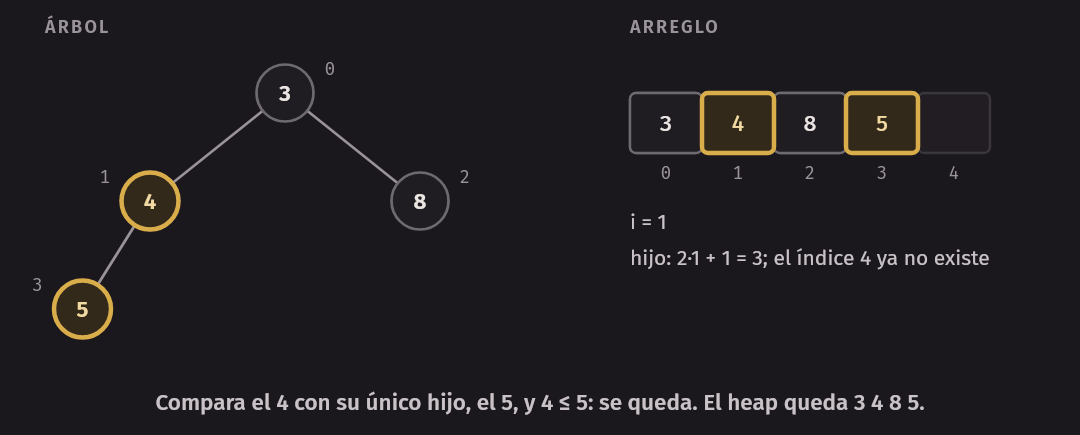
Es la última línea de heap_demo: [3 4 8 5]. ¿Por qué el menor de los hijos? Porque el que suba quedará encima
de su hermano. Si sube el menor, el orden queda bien. Si sube el mayor, queda mal, porque será padre de su hermano, que
es menor que él.
Error común. Cambiar siempre con el hijo izquierdo. Pasa muchas pruebas pequeñas, porque el defecto solo aparece cuando el derecho es el menor.
errors/left_child_only.cpplo muestra, con un heap sano:$ g++ -Wall -Wextra -std=c++20 errors/left_child_only.cpp -o build/left_child_only && build/left_child_only antes de sacar: es heap: si arreglo: 3 4 2 5 6 raiz: 3, es heap: noEl mínimo es 2, y
topdevolvería 3. Por estocheck_invariantsrevisa cada nodo con su padre, y por esto las pruebas al azar sacan todo y lo comparan constd::priority_queue.
Costo. Cada nivel usa dos comparaciones, una por hijo, así que pop hace como máximo 2⌊log₂ n⌋ comparaciones. A
diferencia de push, el elemento que baja venía de una hoja, y suele ser grande, así que es de esperar que baje mucho.
Lo veremos contado en heapsort: con un millón de claves al azar, cada bajada usa unas 35 comparaciones en promedio, con un máximo de 2⌊log₂ n⌋ = 38.
Con esto el heap ya cumple lo prometido:
| Implementación | push |
top |
pop |
|---|---|---|---|
| Heap binario | O(log n), más el push_back amortizado |
O(1) | O(log n) |
Ninguna de estas cotas depende del orden de llegada, y no hizo falta balancear nada.
En C++.
topypoptienen una precondición: el heap no puede estar vacío. Igual que enstd::priority_queue,popno devuelve el elemento. Si lo devolviera y la copia lanzara una excepción, el elemento ya habría salido y se perdería. Por esostd::stacky los demás adaptadores lo separan en dos funciones. Una referencia detopdeja de valer con el siguientepushopop, porque el arreglo puede cambiar de lugar o el elemento puede moverse.
Construir de abajo hacia arriba
A veces ya tienen todos los elementos: un arreglo de n números, y quieren un heap con ellos. La forma obvia son n inserciones, y la cota que acabamos de ver da O(n log n). Hay una mejor, y su análisis es uno de los resultados más bonitos del curso.
La idea. Las hojas ya son heaps, cada una por separado: no tienen hijos que comparar. Tomen el último padre, en el índice ⌊n/2⌋ − 1. Sus dos subárboles son heaps, y solo él puede estar mal: lo que necesita es exactamente bajar. Luego el padre anterior, y así, hasta la raíz. Cuando le toca a un nodo, los subárboles de sus hijos ya son heaps, porque se trataron antes.
algoritmo construir(arreglo, n)
    i ← n div 2
    mientras i > 0 hacer
        i ← i - 1
        bajar el elemento de i
    fin mientras
fin algoritmo
El ciclo está escrito así a propósito, con el índice que baja hasta 0 sin pasar por debajo. Con size_t, la versión
ingenua for (size_t i = n / 2 - 1; i >= 0; i--) no termina nunca, porque i >= 0 siempre es cierto, y con n = 0 o
n = 1 ya arranca con un índice enorme. En heapsort.h, con un heap que deja al mayor en la raíz (pronto verán por
qué), queda así:
template <typename T, typename Less>
std::size_t build_max_heap(std::vector<T>& items, Less less) {
    std::size_t total = 0;
    for (std::size_t i = items.size() / 2; i > 0; i--) {
        total += sift_down_max(items, i - 1, items.size(), less);
    }
    return total;
}
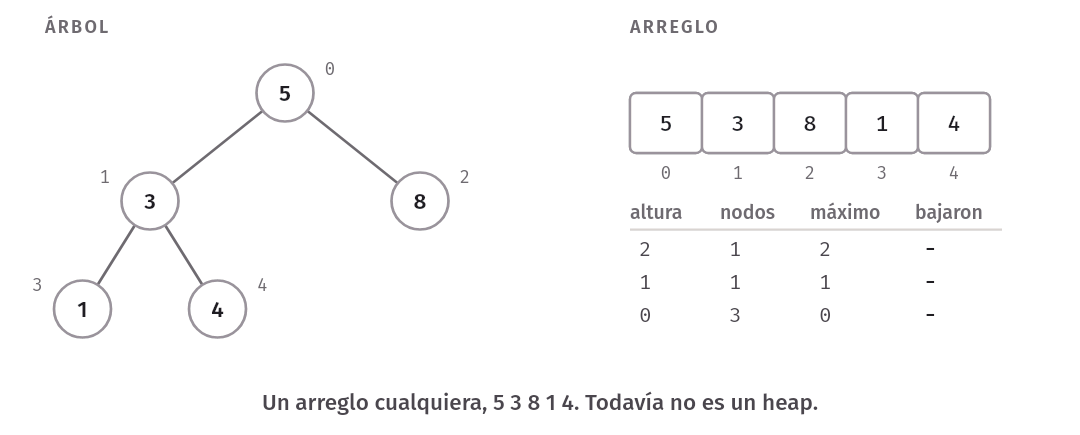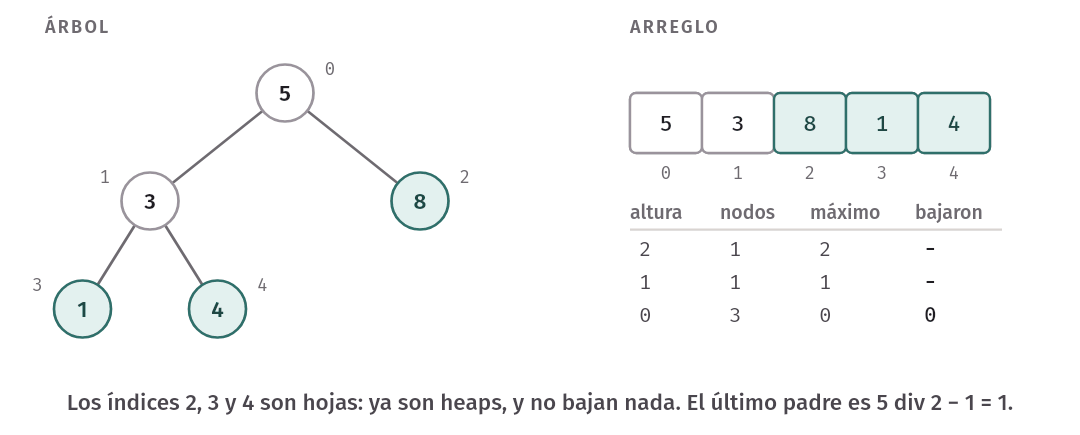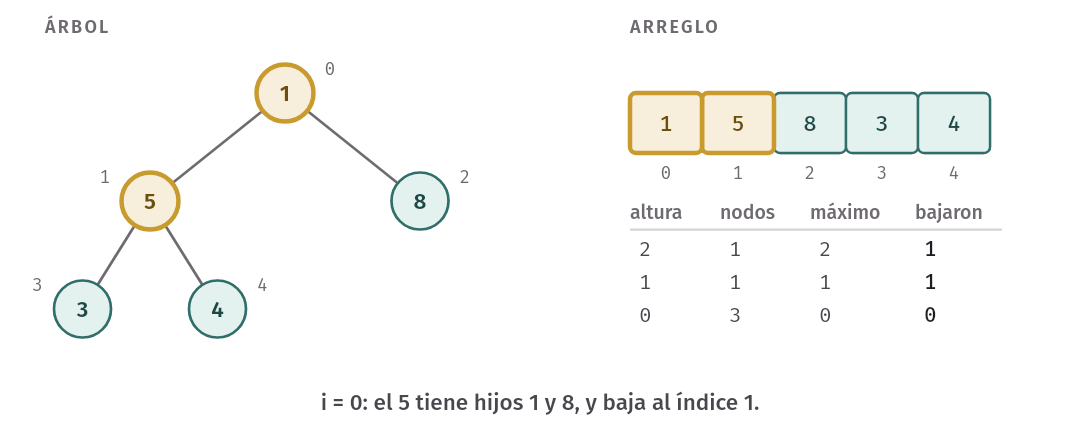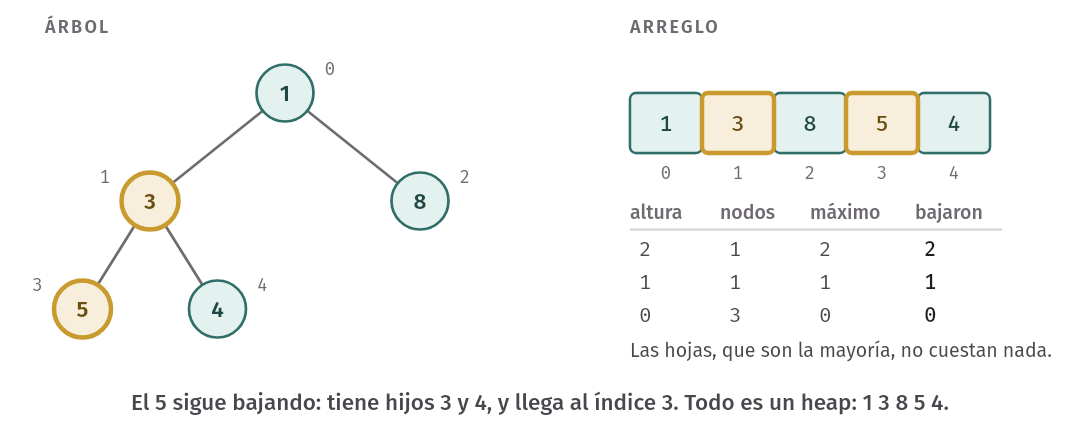
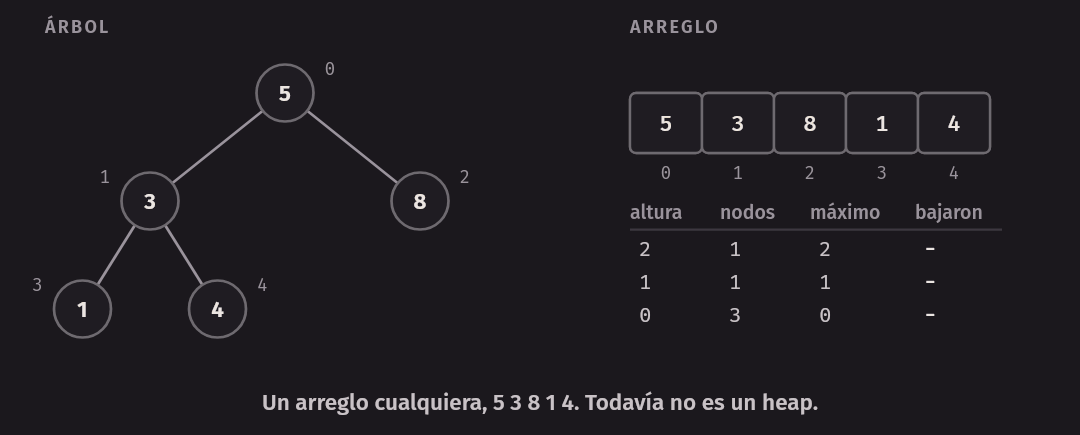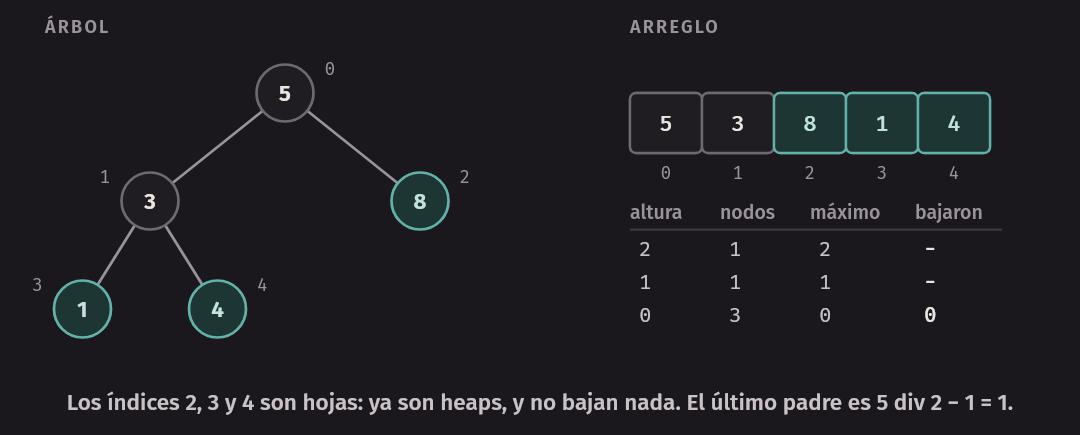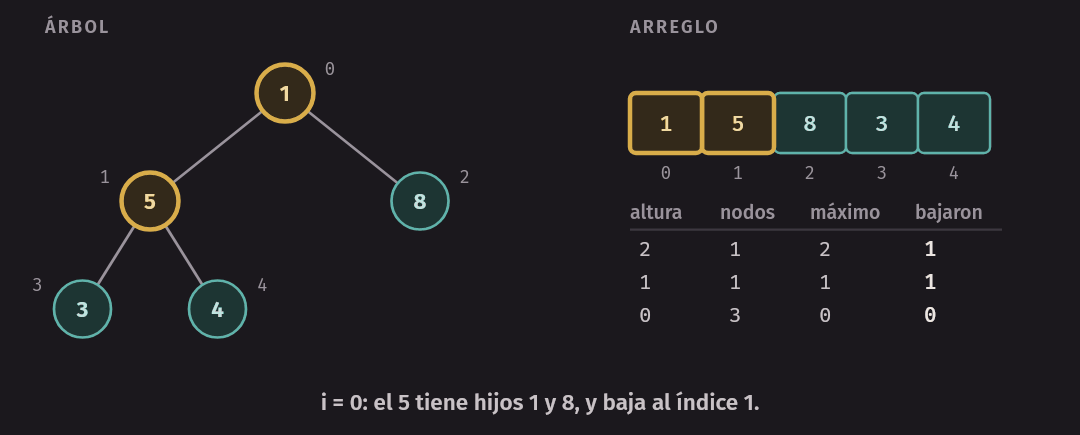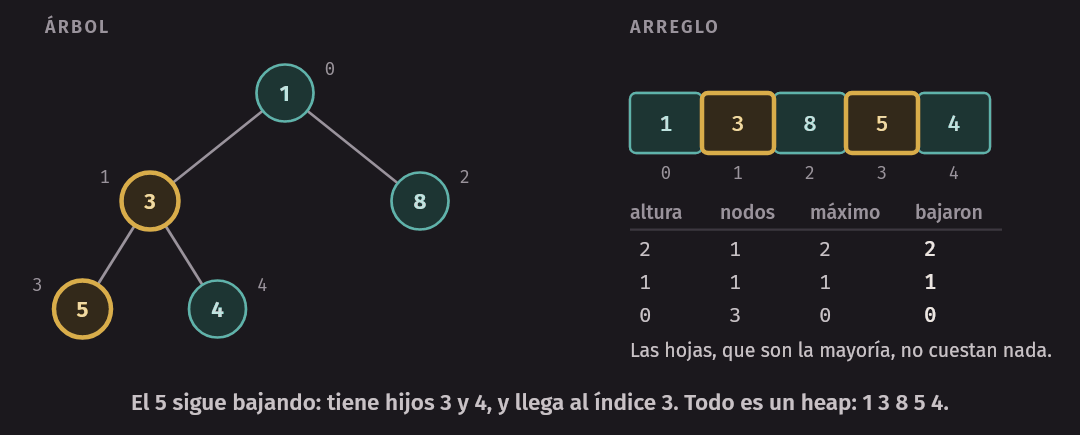
Sigamos un ejemplo con un min-heap, a partir de 5 3 8 1 4. Con n = 5, el último padre está en el índice 1:
| i | Hijos | Qué pasa | Arreglo |
|---|---|---|---|
| 1 | 1, 4 | El 3 baja al índice 3 | 5 1 8 3 4 |
| 0 | 1, 8 | El 5 baja al índice 1 | 1 5 8 3 4 |
| 1 | 3, 4 | El 5 sigue bajando, al índice 3 | 1 3 8 5 4 |
Por qué cuesta Θ(n)
Los dos métodos parecen iguales, n operaciones que cuestan O(log n), pero no lo son. Al subir, cuesta caro lo que está abajo, y abajo está casi todo. Al bajar, cuesta caro lo que está arriba, y arriba no hay casi nada.
Llamemos altura de un nodo a la distancia hasta su hoja más profunda. Un nodo de altura h baja como máximo h
niveles. Tomemos un árbol perfecto, con n = 2^(k+1) − 1 nodos y todas sus hojas abajo. Tiene 2^(k−h) nodos de altura h.
Para n = 1023, sumemos por niveles lo que cada nivel puede bajar como máximo. build_counts imprime la tabla y, además, cuenta lo
que bajaron de verdad con la peor entrada, un arreglo descendente:
$ build/build_counts | tail -n 13
Arbol perfecto con n = 1023, entrada descendente
 altura  nodos  bajan como maximo
      0    512                  0
      1    256                256
      2    128                256
      3     64                192
      4     32                128
      5     16                 80
      6      8                 48
      7      4                 28
      8      2                 16
      9      1                  9
suma: 1013, niveles que bajaron de verdad: 1013
La mitad de los nodos no baja nada. Un cuarto baja un nivel como máximo. El de la raíz, que puede bajar 9, es uno solo. Por eso la suma no llega a n. En general, con la suma por niveles:
total ≤ suma, para h de 1 a k, de h · 2^(k-h) = 2^k · suma de h / 2^hY 2^k es menos que n/2 + 1, de modo que todo depende de la suma de h/2^h. ¿Cuánto vale? Se puede ver sin inducción,
acomodándola como un triángulo. Cada h/2^h es 1/2^h repetido h veces, así que:
1/2 + 1/4 + 1/8 + 1/16 + ...   =   1
      1/4 + 1/8 + 1/16 + ...   =   1/2
            1/8 + 1/16 + ...   =   1/4
                  1/16 + ...   =   1/8
                                 ------
                                    2
Cada columna repite 1/2^h exactamente h veces, y la suma de cada fila sale de la serie geométrica que ya conocen. Con eso, como máximo total ≤ 2^k · 2 ≤ n + 1 niveles bajados, y con dos comparaciones por nivel son unas 2n comparaciones.
Eso es una cota superior, para árboles perfectos. Si el árbol no es perfecto, cabe dentro de uno perfecto de menos del doble de nodos, con cada nodo en el mismo índice, y por eso con una altura que no es mayor. El total sigue siendo O(n). Hay también una cota inferior: cada uno de los ⌊n/2⌋ padres hace por lo menos una comparación. Por lo tanto, construir cuesta Θ(n). Veámoslo contado, con comparaciones, que no dependen de la máquina:
$ build/build_counts | head -n 13
        n  orden  abajo-arriba  /n    n pushes  /n  log2n
     1023    asc          1022  1.00      1022  1.00 10.0
     1023   azar          1930  1.89      2348  2.30 10.0
     1023   desc          2026  1.98      8194  8.01 10.0
    16383    asc         16382  1.00     16382  1.00 14.0
    16383   azar         30692  1.87     37086  2.26 14.0
    16383   desc         32738  2.00    196610 12.00 14.0
   262143    asc        262142  1.00    262142  1.00 18.0
   262143   azar        492980  1.88    597088  2.28 18.0
   262143   desc        524250  2.00   4194306 16.00 18.0
  1048575    asc       1048574  1.00   1048574  1.00 20.0
  1048575   azar       1973024  1.88   2393134  2.28 20.0
  1048575   desc       2097110  2.00  18874370 18.00 20.0
Lean las dos columnas /n. De abajo hacia arriba se queda entre 1 y 2 comparaciones por elemento en todas las
filas, sea cual sea la entrada. Las pruebas de test_structures comprueban la cota de 2n con muchos otros tamaños. Con n inserciones, depende por completo de la entrada:
- Con la entrada descendente, cada elemento nuevo es el menor de todos y sube hasta la raíz: 18 comparaciones por elemento con un millón. Es el peor caso, y crece como n log n.
- Con la entrada ascendente, ninguno sube: una comparación por elemento.
- Con la entrada al azar, unas 2.3 comparaciones por elemento, sin crecer con n.
Esto último merece atención. Θ(n log n) para n inserciones es una afirmación sobre el peor caso. No dice que siempre cueste eso: con claves al azar, medimos un costo lineal. Una explicación razonable es que un elemento al azar suele ser mayor que su padre, y entonces sube poco. Aquí lo medimos y no lo demostramos. Construir de abajo hacia arriba tiene la ventaja de que su cota es para cualquier entrada, y además de eso usa menos comparaciones en cada caso de la tabla, salvo la entrada ascendente, donde empatan.
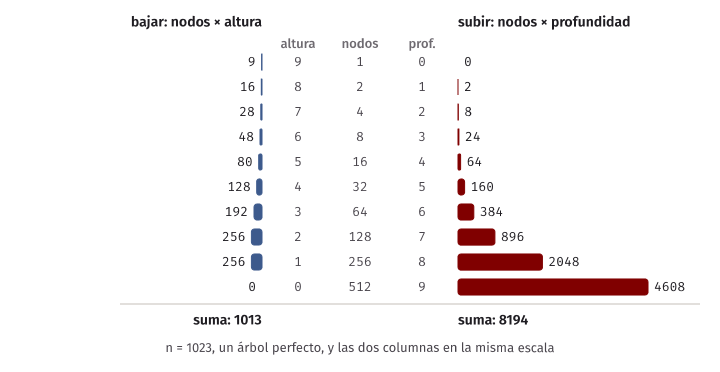
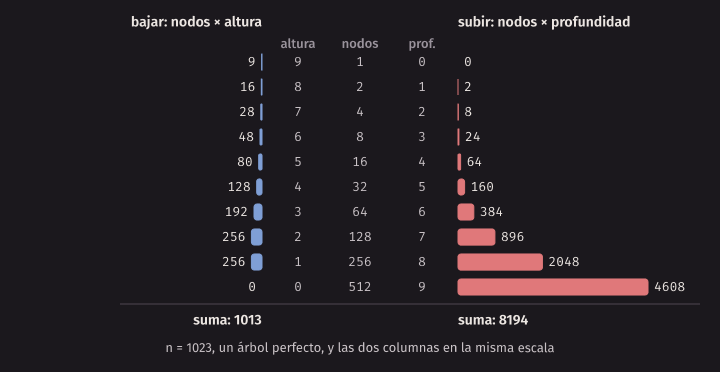
Idea clave. Subir cuesta según la profundidad, y bajar cuesta según la altura. La mayoría de los nodos de un árbol tiene mucha profundidad y poca altura. Por eso la construcción usa solo la operación barata para ellos.
Error común. Bajar en el orden equivocado, de la raíz hacia las hojas. Cuando el nodo i baja, sus subárboles tienen que ser heaps ya, y si se empieza por la raíz, no lo son. El resultado parece razonable, y no es un heap. Es el ejercicio 6.
Heapsort
Un heap da una forma de ordenar: se construye el heap y se saca todo. La gracia es hacerlo sin memoria extra, dentro del mismo arreglo.
El truco está en elegir el heap al revés. Usamos un heap con el mayor en la raíz. Sacar la raíz deja un hueco justo al final del heap, y ese hueco es el lugar definitivo del mayor:
algoritmo heapsort(arreglo, n)
    construir un heap con el mayor en la raíz
    fin ← n
    mientras fin > 1 hacer
        cambiar arreglo[0] con arreglo[fin - 1]
        fin ← fin - 1
        bajar el elemento de 0 dentro de arreglo[0 hasta fin - 1]
    fin mientras
fin algoritmo
template <typename T, typename Less>
void heapsort(std::vector<T>& items, Less less) {
build_max_heap(items, less);
for (std::size_t end = items.size(); end > 1; end--) {
// El mayor de items[0, end) pasa a su lugar definitivo.
std::swap(items[0], items[end - 1]);
sift_down_max(items, 0, end - 1, less);
}
}La invariante del ciclo: items[0, end) es un heap, items[end, n) está ordenado, y todo lo de la parte ordenada es mayor o igual que lo
del heap. La barra | de esta salida separa las dos partes:
$ build/heapsort_demo | head -n 7
entrada:   [4 1 7 3 9 2 |]
heap:      [9 4 7 3 1 2 |]
saca 9:    [7 4 2 3 1 | 9]
saca 7:    [4 3 2 1 | 7 9]
saca 4:    [3 1 2 | 4 7 9]
saca 3:    [2 1 | 3 4 7 9]
saca 2:    [1 | 2 3 4 7 9]
Lo bueno: en el lugar, y O(n log n) siempre
Heapsort usa O(1) de memoria extra, y hace O(n log n) comparaciones en el peor caso: Θ(n) para construir, y n − 1 bajadas de como máximo 2 log₂ n comparaciones. Compárenlo con lo de la semana 6: mergesort tiene la misma cota, pero necesita Θ(n) de memoria extra. Quicksort es en el lugar, salvo por su pila, pero sin cuidado llega a Θ(n²).
La cota es O, no Θ, y por una buena razón. Miren la fila de claves iguales:
$ build/heapsort_counts
        n  entrada  comparaciones   /n  /(n log2 n)
     1000     azar          16786  16.79         1.68
     1000      asc          17583  17.58         1.76
     1000     desc          15965  15.96         1.60
     1000  iguales           2994   2.99         0.30
    10000     azar         235432  23.54         1.77
    10000      asc         244460  24.45         1.84
    10000     desc         226682  22.67         1.71
    10000  iguales          29994   3.00         0.23
   100000     azar        3018834  30.19         1.82
   100000      asc        3112517  31.13         1.87
   100000     desc        2926640  29.27         1.76
   100000  iguales         299994   3.00         0.18
  1000000     azar       36793121  36.79         1.85
  1000000      asc       37692069  37.69         1.89
  1000000     desc       36001436  36.00         1.81
  1000000  iguales        2999994   3.00         0.15
Con claves distintas, en estas corridas, usa entre 1.6 y 1.9 veces n log₂ n, siempre debajo de la cota de 2n log₂ n. Pero con todas las claves iguales nada baja nunca, y son unas 3n comparaciones: lineal. Por eso sería falso decir que heapsort es Θ(n log n) para toda entrada.
Lo malo: no es estable
Los cambios largos, de la raíz al final, pasan por encima de claves iguales. El programa ordena tres pares por su número:
$ build/heapsort_demo | tail -n 2
entrada: 2a 2b 1c
salida:  1c 2b 2a
Dos claves iguales salieron en el orden contrario. Recuerden que un ordenamiento estable es el que permite ordenar primero por un campo y luego por otro, según vimos en la semana 6. Con heapsort no se puede, salvo que se agregue el índice original como desempate, y eso ya no es en el lugar.
Lo peor: salta por toda la memoria
Bajar va de i a 2i + 1: cada paso duplica el índice. En un arreglo grande, cada nivel profundo está lejos del anterior, y las lecturas
no van en secuencia. Mergesort, en cambio, recorre sus dos mitades en secuencia. Esto se ve en el reloj.
Son medianas de 5 corridas, con -O2 y sin sanitizers, en el entorno del curso sobre una laptop arm64, y los tiempos
dependen de la máquina:
$ build/heapsort_times
        n   heapsort  std::sort  stable_sort  heap/sort
   100000     0.0054     0.0056       0.0060       0.97
   200000     0.0128     0.0115       0.0130       1.11
   400000     0.0295     0.0246       0.0279       1.20
   800000     0.0690     0.0525       0.0586       1.31
  1600000     0.1555     0.1095       0.1239       1.42
  3200000     0.3668     0.2280       0.2610       1.61
Con 100 000 números empatan. Con 3.2 millones, heapsort tarda más que los otros: en tres corridas, entre 1.6 y 1.9 veces
std::sort. Las comparaciones no explican ese crecimiento: entre 100 000 y un millón, su proporción con n log₂ n apenas pasa de
1.82 a 1.85.
¿Es la cache? Probablemente, pero este entorno no tiene perf y no podemos medirla directamente. Lo que sí podemos es
contar. El programa heapsort_cache anota cada lectura y escritura de heapsort y de un mergesort escrito igual de simple, y las
pasa por un modelo de cache pequeña: 32 KB, líneas de 64 bytes, cada línea en un único lugar posible. Es un modelo, no la
cache de esta máquina:
$ build/heapsort_cache
        n  algoritmo     accesos       fallos  fallos/n
     1000   heapsort       28314           63      0.06
     1000  mergesort       28738          125      0.12
    10000   heapsort      384749         2123      0.21
    10000  mergesort      403636        17529      1.75
   100000   heapsort     4843204       426879      4.27
   100000  mergesort     4966873       276756      2.77
  1000000   heapsort    58341042      8949218      8.95
  1000000  mergesort    58715769      3469588      3.47
  4000000   heapsort   257368630     46618943     11.65
  4000000  mergesort   258862982     14982452      3.75
Las dos columnas de accesos son casi iguales. Los fallos, no: mientras el arreglo cabe en la cache o poco más, heapsort falla menos, y en 10 000 falla 8 veces menos. Pero cuando el arreglo es mucho más grande, sus fallos por elemento crecen con n, y los de mergesort apenas. Con 4 millones son 11.65 frente a 3.75. Eso concuerda con el reloj, sin demostrar que sea la causa.
En la biblioteca.
std::make_heapystd::sort_heaphacen juntas un heapsort, y el estándar pide desort_heapcomo máximo 2n log₂ n comparaciones.std::sortsolo promete O(n log n) comparaciones. Lo que hace libstdc++ por dentro es un quicksort que cambia a heapsort si la recursión se vuelve muy profunda (introsort, enstl_algo.h). Eso es de esta implementación, no del estándar. Es buen resumen de esta sección: heapsort se usa como red de seguridad, por su peor caso, y no como primera opción.
Los k mayores de una secuencia
Un archivo tiene dos millones de números, y queremos los 10 mayores. Ordenar todo es Θ(n log n) y funciona, pero ordena también los otros 1 999 990, que no interesan. ¿Se puede pagar solo por lo que se pide?
Lo primero que se les ocurre es un heap con el mayor en la raíz y sacar 10 veces. Sirve, pero guarda n elementos en memoria. La idea buena va al revés: un min-heap de tamaño k, que guarda los k mayores que se han visto hasta ahora. Su raíz es el peor de los buenos, el que hay que vencer para entrar.
algoritmo k_mayores(secuencia, k)
    heap ← heap vacío con el menor en la raíz
    para cada x en secuencia hacer
        si tamaño(heap) < k entonces
            insertar x en heap
        sino si k > 0 y x > raíz(heap) entonces
            sacar la raíz de heap
            insertar x en heap
        fin si
    fin para
    sacar todo de heap, y devolverlo al revés
fin algoritmo
La invariante es “el heap tiene los k mayores de lo leído”. Si x no vence a la raíz, no puede estar entre los k mayores, porque hay k que valen por lo menos lo mismo. Si la vence, la raíz deja de estar entre los k mayores, y x entra.
Costo. Cada elemento hace una comparación con la raíz. Si entra, hace O(log k) más. En total, O(n log k) en el peor
caso, y O(k) de memoria. Y no necesita tener la secuencia en memoria: sirve con datos que van llegando, sin saber
cuántos serán. top_k_bench lo compara con ordenar, y sus conteos no dependen de la máquina; los tiempos sí, y son
medianas de 3 corridas, con -O2:
$ build/top_k_bench
n = 2000000
       k  comp. heap  comp. sort  t. heap  t. sort
      10     2000548    50340211   0.0014   0.1373
    1000     2100616    50340211   0.0014   0.1381
  100000     9261431    50340211   0.0301   0.1376
 2000000    43849815    50340211   0.1853   0.1370
Con k = 10, son 25 veces menos comparaciones, y el reloj da unas 100 veces menos. La diferencia entre los dos factores no la podemos explicar con estos datos. Lo que sí vemos es que el costo casi no depende de k mientras k sea pequeño: con claves al azar, muy pocos elementos vencen a la raíz, y casi todo el trabajo es esa única comparación por elemento. Esas cifras son para datos al azar: una entrada ascendente hace que todos entren, y entonces se paga el log k completo.
Cuando k se acerca a n, el heap pierde. Con k = n hizo el trabajo de un heapsort, y std::sort fue más rápido,
aunque usó más comparaciones: otra señal de que contar comparaciones no lo es todo. No hay
una estructura que gane siempre: si piden casi todo, ordenen.
Error común. Usar un heap con el mayor en la raíz para los k mayores, y tirar lo que no entra. Con la raíz en el mayor, no se sabe quién es el peor de los k que hay que descartar, y eso es justo lo que se necesita. Para los k mayores, se usa un heap con el menor en la raíz, y al revés.
std::priority_queue
La biblioteca tiene la cola de prioridad lista. Es un adaptador, como std::stack: pone las operaciones de cola de
prioridad encima de un contenedor, por defecto std::vector. Tiene push, pop, top, empty y size, y nada más:
ni recorrido, ni búsqueda, ni forma de cambiar una prioridad.
Su convenio confunde a todo el mundo. El comparador dice quién va después, así que con el std::less de siempre,
top da el mayor:
$ build/pq_demo
std::less:    8 5 4 3 1
std::greater: 1 3 4 5 8
make_heap: 164961 comparaciones, cota 3n = 300000
pop_heap, peor de 1000: 18, cota 2 log2 n = 33
push_heap, peor de 1000: 16, cota log2 n = 16std::priority_queue<int> largest_first(std::less<int>(), values);
std::priority_queue<int, std::vector<int>, std::greater<int>> smallest_first(std::greater<int>(), values);Hay que escribir los tres parámetros de template para poner el comparador, y por eso la segunda línea es tan larga.
Error común. Traer el comparador de su
MinHeapastd::priority_queuesin invertirlo. En elMinHeapdel laboratorio,less(a, b)dice que a va más cerca de la raíz. Enstd::priority_queue,comp(a, b)dice que a va más lejos detop. Con el mismo comparador, uno da el menor y la otra el mayor. Pasa en Dijkstra, en la semana 15: si usanstd::priority_queuesinstd::greater, salen primero los lugares más lejanos.
En la biblioteca. El estándar define las operaciones de
std::priority_queuemediantestd::make_heap,std::push_heapystd::pop_heapsobre el contenedor, y les pone cotas: como máximo 3n comparaciones paramake_heap, log₂ n parapush_heapy 2 log₂ n parapop_heap. Las líneas de arriba cuentan esas comparaciones en una corrida, y las cumplen. Quepop_heaphaya usado solo 18 de las 33 permitidas es cosa de libstdc++, no del estándar: su__adjust_heapbaja el hueco hasta una hoja con una sola comparación por nivel, y luego sube lo que haga falta.
Códigos de Huffman
Ahora el heap se pone a trabajar en otro problema: comprimir. Un archivo de texto usa 8 bits por byte, pero sus bytes no son
igual de frecuentes. Es un desperdicio gastar en e lo mismo que en z.
Códigos sin prefijos comunes
Un código asigna a cada símbolo una cadena de bits. Con un código de longitud fija, decodificar es trivial: se corta cada
8 bits. Con longitud variable, aparece un problema. Tomen a = 0, b = 01 y c = 1. ¿Qué dice 01? Puede ser b, o puede ser a
seguido de c. No se sabe dónde termina cada símbolo.
Definición. Un código sin prefijos comunes (prefix-free code, o prefix code) es uno en el que ningún código es prefijo de otro.
Con esa condición no hacen falta separadores: en cuanto los bits leídos forman un código, ese símbolo es seguro, porque ningún otro código sigue por ese camino.
Y aquí entra el árbol. Un código sin prefijos comunes es lo mismo que un árbol binario con los símbolos en las hojas: izquierda es 0, derecha es 1, y el código de un símbolo es el camino desde la raíz hasta su hoja. ¿Por qué ningún código es prefijo de otro? Ser prefijo significaría que el camino de un símbolo pasa por la hoja de otro, y por una hoja no pasa nada: no tiene hijos. Eso también dice cómo decodificar sin separadores: se empieza en la raíz, cada bit baja un nivel, al llegar a una hoja se escribe su símbolo, y se vuelve a la raíz.
Si el símbolo s aparece f(s) veces y está a profundidad d(s), el archivo usa la suma de f(s) · d(s) bits. Hay que encontrar el árbol que minimiza esa suma: los frecuentes arriba y los raros abajo.
El algoritmo
David Huffman publicó en 1952 un algoritmo simple que encuentra el mejor árbol: empezar con una hoja por símbolo, y unir repetidamente los dos árboles de menor frecuencia. Un heap es justo lo que hace falta, porque saca los dos menores y recibe la unión.
algoritmo huffman(frecuencias)
    heap ← vacío
    para cada símbolo s con frecuencia mayor que 0 hacer
        insertar en heap una hoja con s y su frecuencia
    fin para
    mientras tamaño(heap) > 1 hacer
        a ← raíz(heap)
        sacar la raíz de heap
        b ← raíz(heap)
        sacar la raíz de heap
        insertar en heap un nodo con hijos a y b, y peso a.peso + b.peso
    fin mientras
    devolver la raíz de heap
fin algoritmo
Con k símbolos hace k − 1 uniones, y cada una, tres operaciones del heap: O(k log k), que con k ≤ 256 bytes distintos es un trabajo pequeño, sin importar el tamaño del archivo.
Hagámoslo con las frecuencias a: 5, b: 2, c: 1 y d: 1. El programa huffman_demo guarda cada árbol parcial con
sus códigos, y al unir dos árboles les agrega un bit adelante:
$ build/huffman_demo | head -n 8
une c:1 con d:1 -> 2
une b:2 con (cd):2 -> 4
une (b(cd)):4 con a:5 -> 9
a (5): 1
b (2): 00
c (1): 010
d (1): 011
bits: 15, suma de los pesos unidos: 15, con codigo fijo de 2 bits: 18
Esta animación arma el árbol, con el primero que salió del heap a la izquierda, y al final decodifica 010:
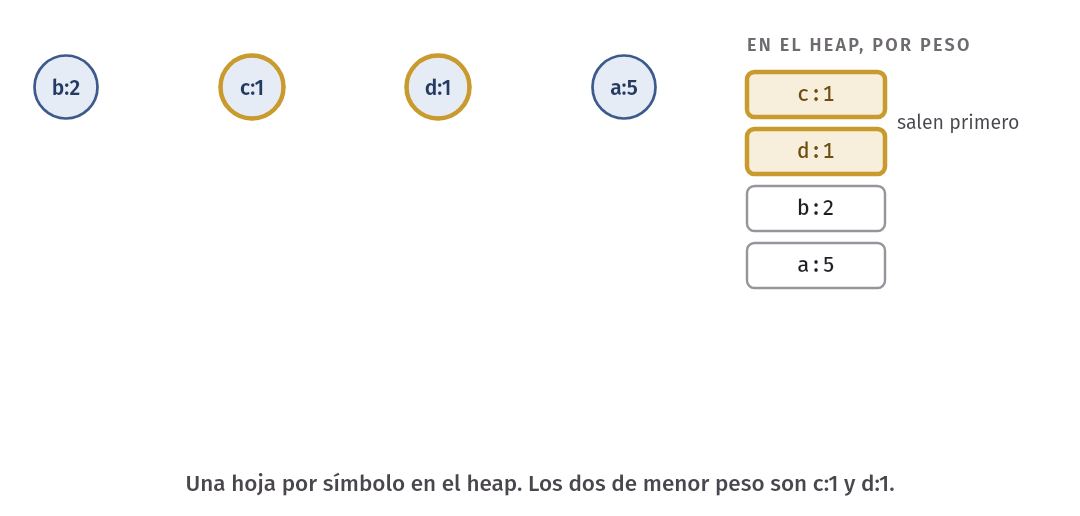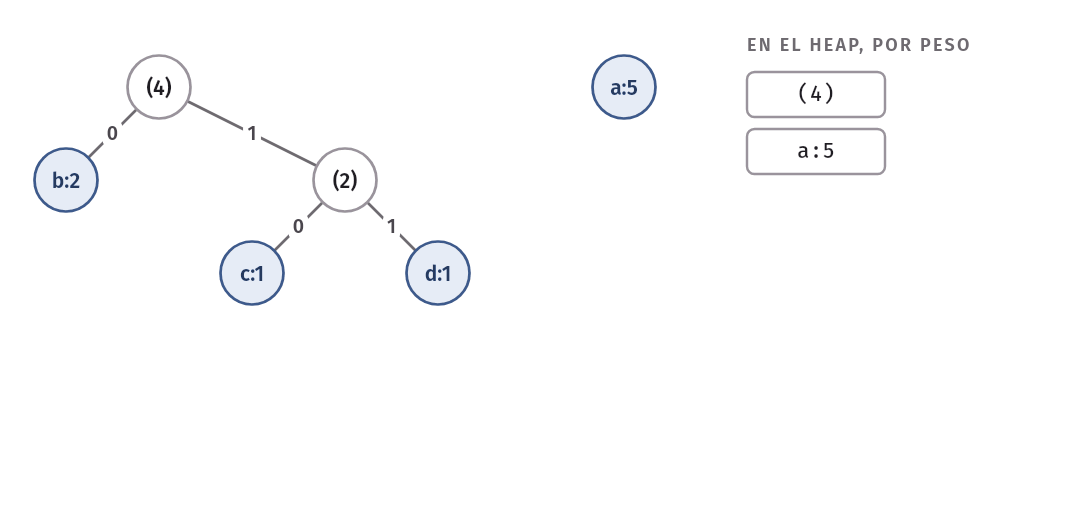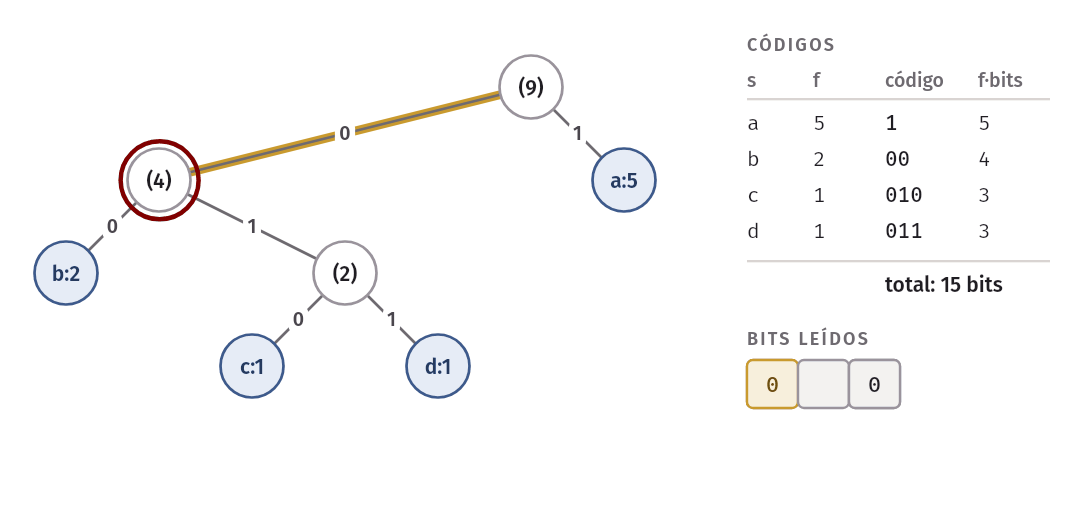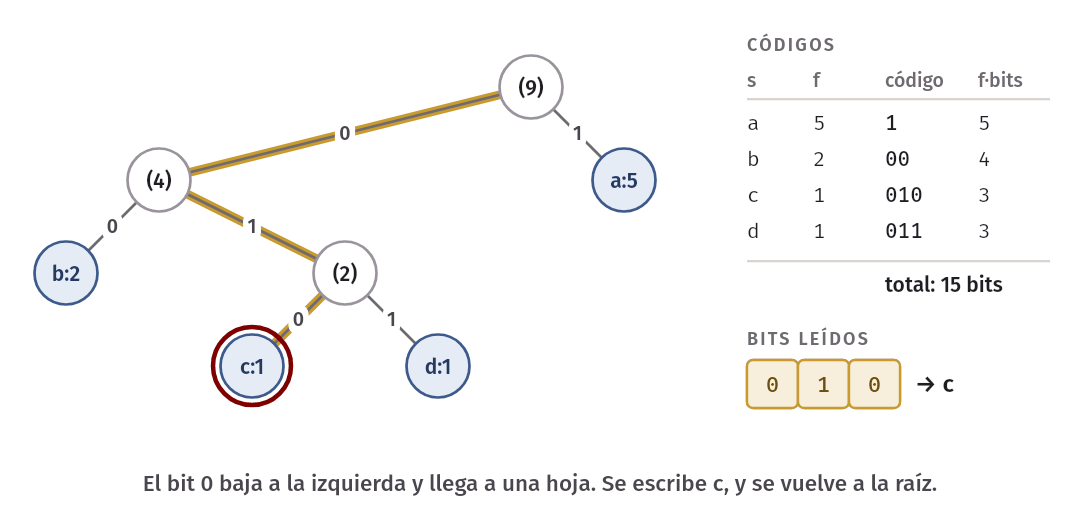
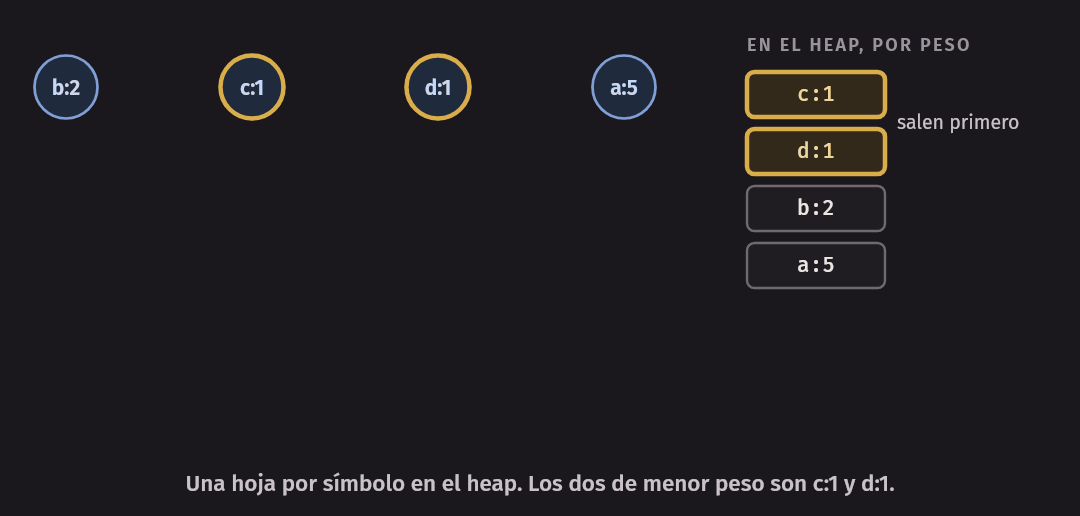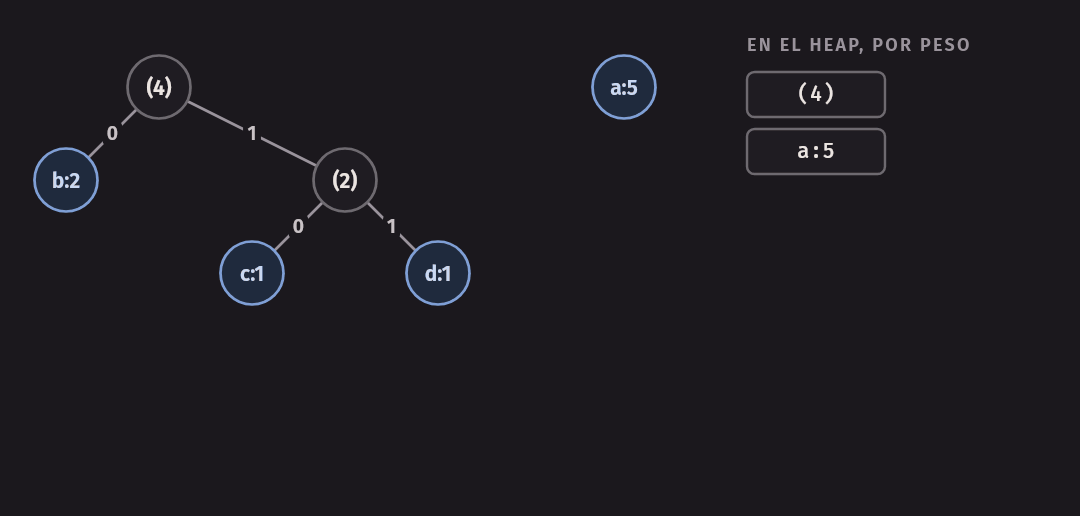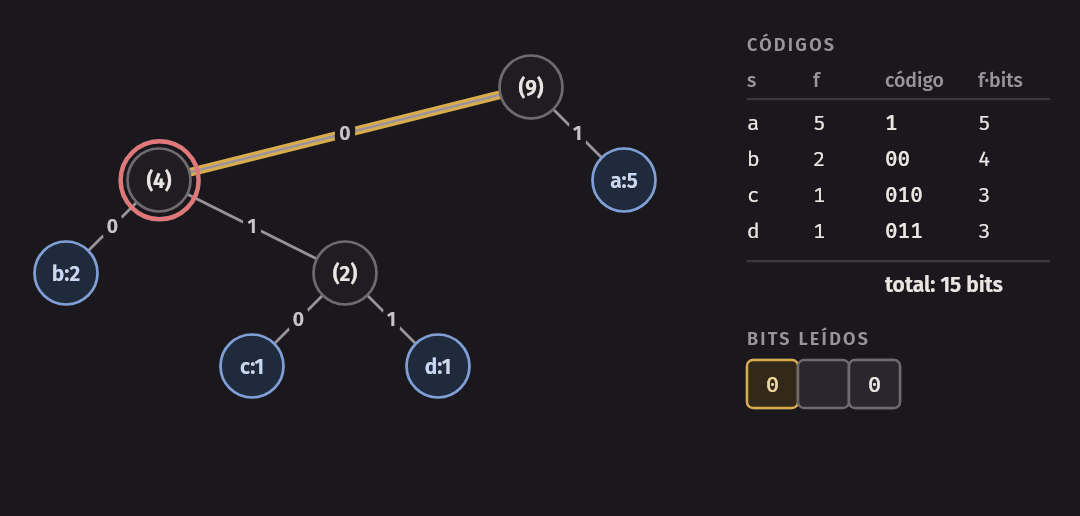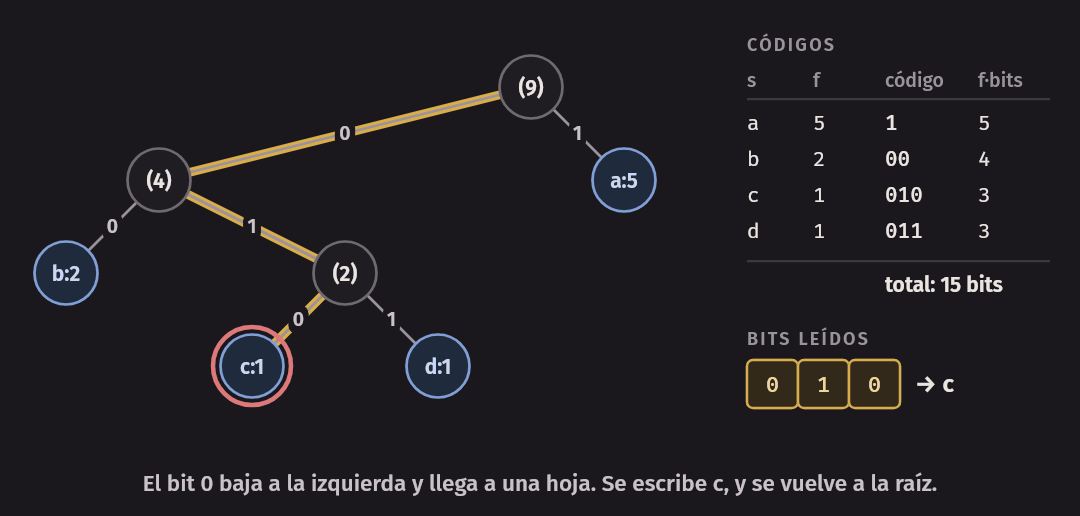
El texto completo usa 5·1 + 2·2 + 1·3 + 1·3 = 15 bits, frente a 18 con un código fijo de 2 bits. La última línea muestra una forma cómoda de calcularlo, sin mirar los códigos: la suma de los pesos de cada unión, 2 + 4 + 9 = 15. Cada unión agrega un bit a todos los símbolos del árbol que forma, y esos símbolos aparecen tantas veces como el peso del árbol.
La siguiente tabla del mismo programa da una proporción mejor:
$ build/huffman_demo | sed -n '10,20p'
une f:5 con e:9 -> 14
une c:12 con b:13 -> 25
une (fe):14 con d:16 -> 30
une (cb):25 con ((fe)d):30 -> 55
une a:45 con ((cb)((fe)d)):55 -> 100
a (45): 0
b (13): 101
c (12): 100
d (16): 111
e (9): 1101
f (5): 1100
Y la distribución uniforme no gana nada: con cuatro símbolos de frecuencia 1, Huffman da un código de longitud fija.
$ build/huffman_demo | tail -n 8
une a:1 con b:1 -> 2
une c:1 con d:1 -> 2
une (ab):2 con (cd):2 -> 4
a (1): 00
b (1): 01
c (1): 10
d (1): 11
bits: 8, suma de los pesos unidos: 8, con codigo fijo de 2 bits: 8
¿Es óptimo? Sí: ningún código sin prefijos comunes usa menos bits para esas frecuencias. Demostrarlo es un buen ejemplo de un algoritmo voraz, y queda para Algoritmos. Aquí lo aceptamos, y las pruebas del laboratorio comprueban el costo con la suma de los pesos.
Los empates. Cuando hay pesos iguales, se puede elegir, y elecciones distintas dan árboles distintos, con el mismo total de bits. En el ejercicio 10 encontrarán dos árboles distintos para las mismas frecuencias. Por eso nuestro formato no deja esto al azar: a igual peso, sale primero el nodo creado antes.
Un compresor de verdad
Pasar de esto a un programa que comprime archivos tiene más detalles que el árbol, y esos detalles son la parte del laboratorio donde es más fácil equivocarse.
Se comprimen bytes, no letras
Nuestros símbolos son bytes, y hay 256 posibles. Eso funciona con cualquier archivo: un texto, una imagen o un programa.
En un texto en UTF-8, una ñ son dos bytes, 0xC3 y 0xB1, y cada uno tiene su propio código. Volver a armar los
bytes en orden devuelve el texto exacto. Si contaran letras, comprimirían solo texto.
El formato
El archivo comprimido tiene que traer todo lo necesario para volver atrás:
bytes 0-3    "HUF1"
bytes 4-11   tamaño original, 64 bits, primero el byte menos significativo
después, solo si el tamaño no es 0, una corriente de bits:
    el árbol en preorden:
        nodo interno:  bit 0, y luego sus hijos, izquierdo y derecho
        hoja:          bit 1, y luego los 8 bits de su símbolo
    los códigos de los bytes del archivo, en orden
    ceros de relleno hasta completar el último byte
¿Por qué guardar el árbol, y no las frecuencias? Las dos cosas funcionan, pero con las frecuencias el descompresor tiene que volver a construir exactamente el mismo árbol, con los mismos desempates, y gastarían hasta 8 bytes por símbolo: 2048 bytes si son 256 símbolos con conteos de 64 bits. El preorden usa 1 bit por nodo interno y 9 por hoja: con los 256 símbolos, 255 + 2304 = 2559 bits, que son 320 bytes.
El preorden se puede leer sin marcas de fin porque cada bit dice qué sigue. Es la misma idea de la semana 10: el preorden conserva la forma.
Sigamos el ejemplo más pequeño, el archivo aab. Con a: 2 y b: 1, sale primero b, y queda b = 0, a = 1. Los bits son:
0  1 01100010  1 01100001  1 1 0  00
|  |           |           |      relleno
|  hoja b      hoja a      a a b
nodo interno
Al agruparlos de a 8 quedan 01011000, 10101100 y 00111000, que son 58 AC 38. Con la cabecera:
$ printf aab > build/aab.txt && build/solution/compress build/aab.txt build/aab.huf && xxd build/aab.huf
00000000: 4855 4631 0300 0000 0000 0000 58ac 38    HUF1........X.8
Son 15 bytes para guardar 3. La cabecera y el árbol son un costo fijo que solo se recupera en archivos más grandes.
El tamaño original es lo que evita tres errores
Al último byte se le agregan ceros para completar 8 bits. El descompresor no puede detenerse “cuando se acaban los bits”, porque esos ceros también decodifican:
$ g++ -Wall -Wextra -std=c++20 errors/padding_as_symbols.cpp -o build/padding_as_symbols && build/padding_as_symbols
original: aab
bits en el archivo: 11000000
sin mirar el tamano: aabbbbbb
con tamano 3: aab
Por eso el tamaño original va en la cabecera. Y ese mismo dato resuelve los dos casos especiales que pide el laboratorio, sin escribir casi nada aparte:
- Un archivo vacío tiene tamaño 0. No hay árbol que construir, ni símbolos. Son 12 bytes de cabecera y nada más, y al leerlos, el descompresor devuelve un archivo vacío sin mirar nada más.
- Un archivo con un solo símbolo tiene un árbol de una sola hoja, y su código es el camino de la raíz a sí misma: 0 bits. Son 14 bytes para cualquier tamaño: 12 de cabecera y 2 para los 9 bits de la hoja. Como la cabecera dice cuántas veces repetirlo, no hace falta ningún bit más. Tampoco hace falta un caso aparte: el ciclo de decodificar mira primero si ya está en una hoja, y con una sola, nunca lee bits.
Si el decodificador lee un bit antes de mirar si está en una hoja, este caso se rompe. errors/one_leaf.cpp lo hace, y
baja a un hijo que no existe, el -1. Lo atrapa ASan:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/one_leaf.cpp -o build/one_leaf && build/one_leaf
==1==ERROR: AddressSanitizer: heap-buffer-overflow on address 0x502000000008 at pc 0xaaaadc025aa0 bp 0xffffca57e4d0 sp 0xffffca57e4e8
READ of size 4 at 0x502000000008 thread T0
...
SUMMARY: AddressSanitizer: heap-buffer-overflow errors/one_leaf.cpp:18 in decode_one
Leer un archivo binario
Las operaciones de texto que se usan a diario pierden bytes de un archivo binario, y lo hacen sin avisar. El programa
errors/stop_at_ff.cpp escribe los 7 bytes a, espacio, b, 0xFF, c, salto de línea y d, y los cuenta de tres formas:
$ g++ -Wall -Wextra -std=c++20 -fsigned-char errors/stop_at_ff.cpp -o build/stop_at_ff && build/stop_at_ff
con char y EOF: 3 bytes de 7
con >>:         5 bytes de 7
con int y EOF: 7 bytes de 7get()devuelveint, nochar, para poder devolverEOF, que vale −1, como algo distinto de cualquier byte. Si lo guardan en uncharcon signo, el byte0xFFtambién vale −1, y el ciclo termina antes de tiempo.>>se salta los espacios en blanco, también si abrieron el archivo en modo binario.- El tipo correcto para el resultado de
get()esint.
Compilamos con -fsigned-char a propósito, porque el signo de char depende de la plataforma. En Linux sobre x86-64, char tiene signo. En
Linux sobre arm64, que es donde corre este entorno, no lo tiene. Sin esa opción, aquí el primer ciclo no termina nunca, porque 255
nunca es igual a −1 (el compilador avisa: “comparison is always true”). Un mismo programa falla de dos formas según la máquina.
El mismo problema aparece al contar frecuencias. Si c es un char con signo, 0xC3 vale −61, y counts[c] cae antes de la tabla:
$ g++ -Wall -Wextra -std=c++20 -g -fsigned-char -fsanitize=address,undefined errors/signed_byte.cpp -o build/signed_byte; build/signed_byte
errors/signed_byte.cpp: In function ‘int main()’:
errors/signed_byte.cpp:11:23: warning: array subscript has type ‘char’ [-Wchar-subscripts]
   11 |         counts.data()[c]++;
      |                       ^
contó 0
Contó 0 en lugar de 1, y en esta corrida ASan no dijo nada. Es probable que el índice haya saltado más allá de la zona que vigila, hacia
otra parte de la pila. Sin la advertencia del compilador, no habría pista. Por eso en el laboratorio los bytes son std::uint8_t, de 0 a
255 en toda plataforma, y read_file ya viene hecho:
inline Bytes read_file(const std::string& path) {
    std::ifstream in(path, std::ios::binary);
    if (!in) {
        throw std::runtime_error("no se pudo abrir " + path);
    }
    // Cada char pasa a uint8_t: 0xC3 vale 195 aquí, tenga o no signo el char.
    return Bytes(std::istreambuf_iterator<char>(in), std::istreambuf_iterator<char>());
}
std::istreambuf_iterator entrega cada byte tal cual, sin saltarse ninguno. ¿Y std::ios::binary? Le dice al sistema que no traduzca los
fines de línea. En Linux no cambia nada, y por eso ninguna prueba de este laboratorio puede detectar que falte. En Windows sí importa: en modo texto,
un \n se escribe como dos bytes y un archivo binario queda dañado. Se pone porque es lo correcto, no porque lo exija una prueba.
Escribir de a un bit
Un archivo se escribe por bytes. Para escribir bits, hay que juntar 8 antes de enviarlos, y al final completar el último.
BitWriter, en lab/bit_io.h, viene hecho. Lo central es esto:
void put_bit(bool bit) {
    current_ = static_cast<std::uint8_t>((current_ << 1) | (bit ? 1 : 0));
    used_++;
    if (used_ == 8) {
        out_.push_back(current_);
        current_ = 0;
        used_ = 0;
    }
}
Cada byte se llena desde su bit más significativo, y por eso los bits de aab se leen en el mismo orden en que los escribimos a mano.
Con 256 símbolos, el árbol puede ser una cadena, y un código puede tener hasta 255 bits. Más de 64 bits solo aparecen con frecuencias como
las de Fibonacci, en archivos de decenas de terabytes, pero una prueba del laboratorio le pasa esas frecuencias directamente a build_tree. Por eso los
códigos se guardan como std::string, de '0' y '1'. Es poco eficiente, pero alcanza: en nuestra medición, con -O2, los 13 MB de palabras.txt se comprimen en menos de un segundo.
En C++. Un archivo dañado no debe tumbar el programa.
BitReaderlanzastd::runtime_errorsi se acaban los bits, ydecompressatrapa la excepción, imprime un mensaje y termina con código 1, sin crear la salida. Hay un caso más sutil: un archivo lleno de ceros le dice aread_tree“nodo interno” una y otra vez, y una recursión sin límite agota la pila. Por eso se rechaza cualquier árbol con más de 255 niveles de profundidad o más de 256 hojas, que no puede venir de un compresor correcto.
Una defensa falta, y conviene decirlo. Una cabecera falsificada puede decir “este archivo tiene 2⁶⁰ bytes” con un árbol de una hoja, y el descompresor intentará producirlos sin leer un bit. Es una bomba de descompresión, y los compresores reales la tienen en cuenta. Es el ejercicio 11.
Cuánto comprime
Con el programa terminado se puede responder la pregunta. Estos tamaños son exactos, y no dependen de la máquina:
$ build/solution/bench_compress --sizes build/samples/empty.bin build/samples/one_byte.bin build/samples/single_symbol.bin build/samples/all_bytes.bin build/samples/random.bin build/samples/special.bin ../../data/tradiciones.txt ../../data/terminos.tsv ../../data/palabras.txt
archivo                original  comprimido       %
empty.bin                     0          12       -
one_byte.bin                  1          14  1400.0
single_symbol.bin        100000          14     0.0
all_bytes.bin            256000      256332   100.1
random.bin              1048576     1048908   100.0
special.bin              100000       29991    30.0
tradiciones.txt          285895      163986    57.4
terminos.tsv             317775      183507    57.7
palabras.txt           12943052     6969665    53.8
Hay mucho que leer en esta tabla:
- Texto en español: un 57%, unos 4.6 bits por byte en lugar de 8. Es lo que se puede esperar de mirar cada byte por separado.
special.bintiene 5 símbolos equiprobables, y baja al 30%. Con un código fijo se necesitarían 3 bits, un 37.5%. Con 5 símbolos al azar, Huffman da códigos de 2 y de 3 bits, y promedia unos 2.4.all_bytes.binyrandom.bincrecen. Sus bytes son igual de frecuentes, o casi, y en estas dos muestras el árbol da 8 bits a todos. Crecen exactamente 332 bytes: 12 de cabecera y 320 de árbol. Comprimir no es magia.- Un archivo de un byte se vuelve de 14. Con archivos muy pequeños, la cabecera domina.
Ningún compresor puede achicar todos los archivos. Hay 2ⁿ archivos de n bits, y menos de 2ⁿ archivos con menos de n bits. Si todos se achicaran, dos de ellos tendrían la misma salida, y uno no podría recuperarse. Por eso algunas entradas tienen que crecer, y lo que se elige es cuáles: un compresor aprovecha un patrón de cierta clase de archivos.
¿Qué tan bueno es esto? gzip también usa Huffman, pero lo combina con otra idea: reemplazar frases repetidas por una referencia a su copia anterior.
$ gzip -9n -c ../../data/tradiciones.txt | wc -c
118634
$ gzip -9n -c ../../data/palabras.txt | wc -c
2519173
Son 41.5% y 19.5%, frente a nuestros 57.4% y 53.8%. La distancia se nota más en palabras.txt, porque es una lista ordenada con formas que se repiten:
amar, amara, amaran… Huffman no puede aprovecharlo, porque solo ve las frecuencias de los bytes, y no lo que está al lado de cada uno. Y si se comprime
algo ya comprimido, los bytes parecen al azar, y se gasta la cabecera sin ganar nada:
$ gzip -9n -c ../../data/tradiciones.txt > build/tradiciones.gz && build/solution/bench_compress --sizes build/tradiciones.gz
archivo                original  comprimido       %
tradiciones.gz           118634      118966   100.3
El código de la semana
En code/week-13:
| Archivo | Qué contiene |
|---|---|
int_heap.h, heap_demo.cpp |
El min-heap de la clase, con enteros y contando comparaciones |
where_is_max.cpp |
Dónde pueden estar el mínimo y el máximo |
heapsort.h, heapsort_demo.cpp |
Construir de abajo hacia arriba, y heapsort |
build_counts.cpp, heapsort_counts.cpp |
Comparaciones, según la entrada |
heapsort_cache.cpp, heapsort_times.cpp, bench.h |
Lo que cuesta saltar: en un modelo, y con el reloj |
top_k_bench.cpp, pq_demo.cpp |
Los k mayores y std::priority_queue |
huffman_demo.cpp |
Huffman sobre una tabla pequeña |
test_structures.cpp |
Pruebas del heap y de heapsort: dirigidas y al azar, contra la biblioteca |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo. Eso incluye volver a correr los comandos de este capítulo. Las mediciones no se
comparan, porque dependen de la máquina; lo que se compara son conteos y tamaños.
El laboratorio
Escribirán tres cosas: MinHeap<T, Less> en lab/min_heap.h, top_k en lab/top_k.h con el programa lab/top_words.cpp, y el compresor
en lab/huffman.h. Cada función sin hacer detiene el programa con un mensaje que dice cuál falta.
make test-heap        # paso 1: MinHeap, contra std::priority_queue
make bench            # paso 2: construir frente a insertar, con -O2 y sin sanitizers
make test-top         # paso 3: top_k y top_words
make bench-top        # paso 3: heap de tamaño k frente a ordenar todo
make test-tree        # pasos 4 y 5: frecuencias, árbol, códigos, escribir y leer el árbol
make test-compress    # pasos 5 y 6: comprimir y descomprimir, con cmp
make roundtrip        # paso 6: sus archivos binarios, vacíos y de un símbolo, con cmp
make bench-compress   # paso 6: cuánto comprime cada archivo
make test-lab         # todo
Guarden su min_heap.h: la semana 15 lo usará en Dijkstra. Sus firmas no se pueden cambiar:
template <typename T, typename Less = std::less<T>>MinHeap() = default;
explicit MinHeap(Less less) : less_(std::move(less)) {}
explicit MinHeap(std::vector<T> items, Less less = Less()) : items_(std::move(items)), less_(std::move(less)) {
void push(T value) {
void pop() {
const T& top() const {
bool empty() const { return items_.empty(); }
std::size_t size() const { return items_.size(); }
void check_invariants() const { not_implemented("check_invariants"); }Algunas cosas que conviene saber antes de empezar:
- Se guarda en un
std::vector. El tema de hoy es el orden del heap, y la memoria ya la manejaron en las semanas anteriores. Por eso no hay regla de cinco que escribir: copiar y mover ya funcionan. - El
MinHeapno es copiarIntHeap. Tiene que funcionar con cualquierTy comparador, sinoperator<, y sin copiar elementos. Una prueba cuenta las copias. Ademásheapsort.hbaja con el mayor en la raíz, y el suyo va al revés. check_invariantsusa sololess_. Se detiene conassert, como en semanas anteriores. Las pruebasbroken_*dañan un heap sano y exigen que lo detecte.- Las pruebas cuentan comparaciones. Construir con n
pushno pasa la prueba de construcción, y un heap que ordena todo no pasa las depushypop. También cuentan cuántos objetos vivos hay a la vez, y por esotop_kno puede guardar una copia de todo. - En el paso 2, comparen las dos entradas. La tabla tiene claves al azar y descendentes. Ya vieron por qué la diferencia no es la misma.
- Vienen hechos
count_wordsysplit_words, para contar palabras;read_fileywrite_file, para los archivos;BitWriteryBitReader, para los bits;count_frequenciesymake_codes, que son cortas y conviene leer; y los programascompressydecompress, que solo los llaman. Ustedes escriben el corazón:build_tree,write_tree,read_tree,compress_bytesydecompress_bytes. - Los tipos y el formato ya están decididos, en
lab/huffman.h, y las pruebas comparan bytes exactos. Una de ellas leelab/tests/reference.huf, comprimido por otro programa: si lo leen bien, su formato coincide. - Los nodos viven en un
std::vector<HuffmanNode>, y se señalan por índice. No haynewnidelete, y-1hace de nulo. Cuidado: unpush_backennodesinvalida las referencias a los nodos. - El heap guarda
HeapEntry, con un peso y un índice de nodo, y compara conLighterEntry, que desempata por el nodo creado antes. Sin ese desempate hay árboles válidos, pero no el del formato.
Resumen
- Una cola de prioridad tiene
push,topypop. Un heap binario las da en O(log n), O(1) y O(log n), con el peor caso garantizado salvo por elpush_backamortizado. - Invariante: cada padre es menor o igual que sus hijos, y el árbol es completo. Es más débil que el orden de un árbol de búsqueda, y por eso no sirve para buscar.
- El mínimo está en la raíz. Con claves distintas, el máximo está en alguna hoja. Con repetidas, en alguna hoja hay un máximo.
- Un árbol completo tiene altura exacta ⌊log₂ n⌋ y va en un arreglo sin punteros: hijos en 2i + 1 y 2i + 2, y padre en (i − 1) div 2, con i > 0.
- Insertar: al final, y sube. Sacar: el último pasa a la raíz, y baja cambiando con el menor de los hijos.
- Construir de abajo hacia arriba es Θ(n), unas 2n comparaciones como máximo: la mayoría de los nodos tiene poca altura. n inserciones son Θ(n log n) en el peor caso, pero medimos unas 2.3n con claves al azar.
- Heapsort ordena en el lugar con O(n log n) comparaciones en el peor caso. No es estable, y salta por toda la memoria: en nuestras corridas, con muchos datos,
tardó más que
std::sort. - Los k mayores se hallan con un heap de tamaño k, con el menor en la raíz: O(n log k), y O(k) de memoria.
- En
std::priority_queue, el comparador dice quién va después: por defecto da el mayor. - Huffman une repetidamente los dos árboles de menor frecuencia. Da un código sin prefijos comunes óptimo, y eso se demuestra en Algoritmos.
- Un compresor necesita el tamaño original para no leer el relleno como datos, y para resolver el archivo de un solo símbolo.
- Los archivos binarios se leen como bytes sin signo, sin
>>y sin guardarget()en unchar. Ningún compresor achica todos los archivos.
Ejercicios
- Inserten 9, 4, 7, 1, 2, 6 y 3 en un min-heap vacío, y dibujen el arreglo después de cada inserción. Saquen luego el mínimo dos veces. Comprueben con
IntHeap. - Digan si cada arreglo es un min-heap, y si no, qué par rompe la invariante:
1 2 3 4 5 6 7;1 3 2 7 4;1 2 3 4 1;5. ¿Todo arreglo ordenado es un heap? ¿Todo heap es un arreglo ordenado? - Un heap d-ario tiene d hijos por nodo. Den las fórmulas del padre y de los hijos, y la altura. ¿Cuántas comparaciones hacen
pushypopen el peor caso? ¿Con qué operaciones conviene un d mayor que 2? - Escriban
bool contains(const std::vector<int>& heap, int key), que aproveche el orden del heap para no mirar lo que no hace falta. ¿Qué poda se puede hacer? Den un caso donde tenga que mirar todo. - Construyan el heap de
9 8 7 6 5 4 3 2 1de abajo hacia arriba, con una tabla como la de esta semana. Cuenten las comparaciones y comparen con 2n. Comprueben su resultado con la pruebabuild_example. - Alguien baja en el orden contrario, de i = 0 a i = ⌊n/2⌋ − 1. Encuentren un arreglo de 4 elementos donde el resultado no sea un heap. Luego, escriban una prueba al azar que lo detecte.
sift_uphace unstd::swapen cada nivel, es decir, tres movimientos. Reescríbanlo con un hueco: guarden el elemento aparte, muevan los padres hacia abajo y pónganlo al final. Cuenten los movimientos con un tipo contador. ¿Cambian las comparaciones?- Con
std::partial_sort, hallen los 10 mayores de 2 millones de números. ¿Qué cota da el estándar? Cuenten sus comparaciones con un comparador y compárenlas con la tabla detop_k_bench. Corran también con una entrada ascendente, para el peor caso de nuestro heap. - Hagan estable a heapsort agregando el índice original como desempate. ¿Cuánta memoria extra usa ahora? ¿Qué pierde frente a
std::stable_sort? - Con frecuencias a: 1, b: 1, c: 2 y d: 2, hay un empate al elegir la segunda unión. Dibujen los dos árboles posibles. ¿Qué longitudes de código da cada uno? Comprueben que ambos usan la misma cantidad de bits. ¿Cuál construye nuestro desempate?
- Armen a mano un archivo de 14 bytes que diga “un solo símbolo, 2⁴⁰ veces”. ¿Qué hace su
decompress? (Ojo: córranlo con un límite de memoria,ulimit -v, y contimeout.) Propongan una defensa y agréguenla, sin romper las pruebas. - Cambien el formato para que guarde las frecuencias en vez del árbol. ¿Cuánto crece la cabecera de
tradiciones.txt? ¿Qué se rompería sidecompressdesempatara de otra forma? Busquen dos archivos en los que uno de los dos formatos sea claramente mejor.