Apuntes · Capítulo 14Prioridades y grafos
Grafos y union-find
Grafos y union-find
La semana pasada, un heap nos dio el elemento más urgente, y Huffman armó un árbol con él. Hasta ahora, todo lo que guardamos tenía una forma fija: una secuencia, una tabla, un árbol. Muchos problemas no la tienen. Las calles de Lima no forman un árbol: hay muchas maneras de ir de un cruce a otro, y a veces se vuelve al punto de partida. Lo que importa en esos problemas es quién está conectado con quién, y esa conexión es el dato.
Hoy estudiamos el grafo, la estructura que guarda exactamente eso. Veremos dos maneras de representarlo y dos maneras de recorrerlo: BFS explora por niveles con una cola, y DFS baja todo lo posible con una pila. Los dos cuestan Θ(V + E) si tocan todo el grafo, y responden preguntas distintas. Luego veremos una estructura muy corta que responde una sola pregunta, “¿están conectados estos dos?”, incluso mientras las conexiones van llegando: union-find. En el laboratorio las juntarán: union-find genera un laberinto, y BFS y DFS lo resuelven.
La semana 15 agrega pesos a estas mismas listas de adyacencia, y calcula rutas sobre un mapa real con Dijkstra.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Grafos en todas partes y Dos representaciones.
- En clase: BFS: recorrer por niveles, DFS: bajar todo lo posible, El costo: Θ(V + E), Union-find y Union-find frente a DFS.
- Después de clase: repasen con el Resumen y los Ejercicios, y lean Generar un laberinto y El código de la semana. Opcional: Open Data Structures, secs. 12.1 (AdjacencyMatrix), 12.2 (AdjacencyLists) y 12.3 (Graph Traversal); CLRS, capítulos Elementary Graph Algorithms y Data Structures for Disjoint Sets.
Código. Los programas de este capítulo están en
code/week-14. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Grafos en todas partes
Antes de definir nada, tres ejemplos:
| Problema | Nodos | Aristas | ¿Dirección? | ¿Pesos? |
|---|---|---|---|---|
| Rutas en un mapa | Cruces de calles | Tramos de calle | A veces: calles de un sentido | Metros o minutos |
| Enlaces de la web | Páginas | Enlaces | Sí: A enlaza a B, no al revés | No |
| Dependencias de un Makefile | Archivos | “Este se construye con aquel” | Sí | No |
Son problemas muy distintos, y son la misma estructura. Por eso un algoritmo de esta semana sirve para los tres.
Definición. Un grafo (graph) es un conjunto V de nodos (nodes) y un conjunto E de aristas (edges), donde cada arista une dos nodos. Escribimos V y E también para sus cantidades, como en Θ(V + E).
- En un grafo no dirigido, la arista {u, v} se recorre en los dos sentidos. En un grafo dirigido, la arista u → v solo va de u a v.
- En un grafo con pesos, cada arista lleva un número: metros, minutos, costo. Sin pesos, solo importa si la arista existe.
- Dos nodos unidos por una arista son vecinos. El grado de un nodo es cuántas aristas tocan a ese nodo.
- Un camino (path) es una secuencia de nodos sin repetir, en la que cada uno es vecino del anterior. Su largo es su cantidad de aristas. Un ciclo (cycle) es una secuencia de ese tipo que al final vuelve a su primer nodo, sin repetir aristas.
- Una componente conexa de un grafo no dirigido es un grupo máximo de nodos en el que cada par está unido por algún camino. Un grafo es conexo si tiene una sola.
Un árbol, en este lenguaje, es un grafo no dirigido conexo y sin ciclos. Todo lo que hicimos con árboles sigue valiendo: un árbol es un grafo particular, y uno muy cómodo, porque entre dos nodos hay exactamente un camino.
Este será el grafo de la clase, con 7 nodos y 8 aristas:
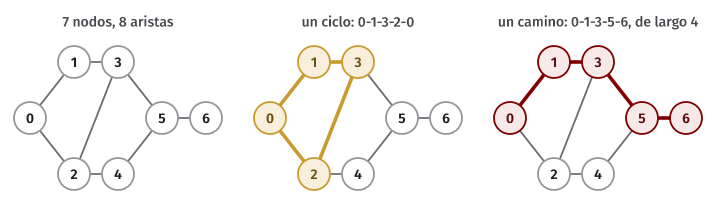
Las aristas son 0-1, 0-2, 1-3, 2-3, 2-4, 3-5, 4-5 y 5-6. Tiene ciclos, como 0-1-3-2-0. De 0 a 6 hay varios caminos: 0-1-3-5-6 tiene 4 aristas, y 0-1-3-2-4-5-6 tiene 6.
En este curso los nodos son enteros de 0 a V − 1. Si los nodos de su problema son palabras o cruces, se les da un número con un diccionario, como los de las semanas 7 y 10, y el grafo trabaja solo con números. Así puede guardar sus datos en arreglos, sin buscar nada.
Dos representaciones
Un grafo se puede guardar de dos maneras clásicas, y elegir entre ellas es el primer ejercicio de diseño.
Matriz de adyacencia
Definición. La matriz de adyacencia (adjacency matrix) es una tabla de V × V: la celda [u][v] dice si existe la arista de u a v. En un grafo no dirigido es simétrica.
class MatrixGraph {
public:
    explicit MatrixGraph(int node_count)
        : n_(node_count), cells_(static_cast<std::size_t>(node_count) * node_count, 0) {}

    void add_edge(int u, int v) {
        assert(u != v);
        cell(u, v) = 1;
        cell(v, u) = 1;
    }

    // Una sola lectura, sin importar cuántas aristas haya.
    bool has_edge(int u, int v) const { return cells_[index(u, v)] != 0; }
...
};
Guardamos la tabla en un solo std::vector<char>, fila tras fila: la celda [u][v] es la posición u · V + v, como en
una matriz de C. Preguntar por una arista es una lectura. Su debilidad son los dos costos que no dependen de cuántas
aristas haya: ocupa Θ(V²) memoria siempre, y para saber quiénes son los vecinos de u hay que leer su fila completa,
con Θ(V) lecturas, aunque u tenga un solo vecino.
Listas de adyacencia
Definición. Las listas de adyacencia (adjacency lists) guardan, por cada nodo, la lista de sus vecinos.
Para el grafo de la clase, junto a su matriz:
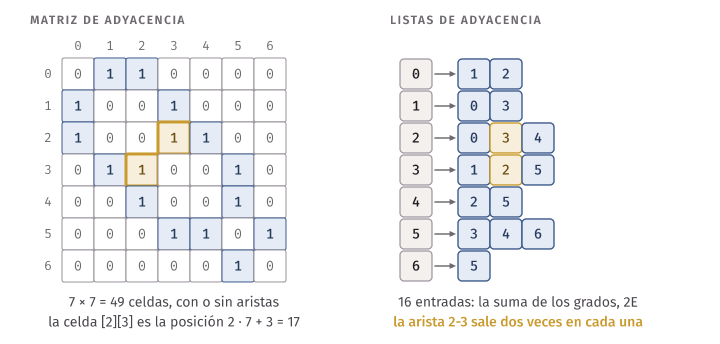
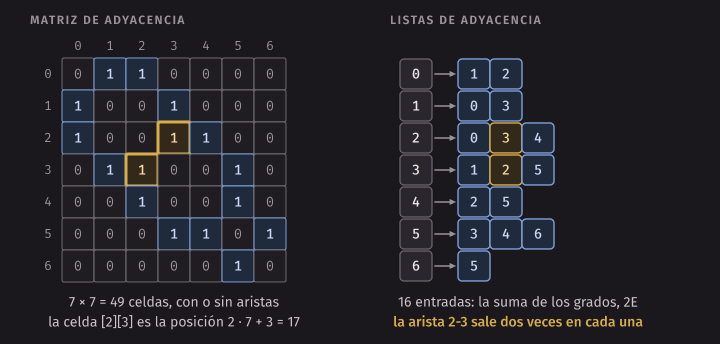
Cada arista no dirigida aparece dos veces, una en cada extremo. Las listas tienen entonces 2E entradas en total: aquí son 16, para 8 aristas. La suma de los grados de un grafo no dirigido siempre es 2E, porque cada arista aporta 1 a cada uno de sus extremos.
Esta es la clase que usaremos, y que la semana 15 reutiliza tal cual. Cada entrada guarda el destino y un peso, que hoy casi siempre vale 1:
struct Edge {
    int to;
    int weight;
};
class Graph {
public:
explicit Graph(int node_count, bool directed = false)
: adjacency_(node_count), directed_(directed) {}
void add_edge(int u, int v, int weight = 1) {
assert(valid(u) && valid(v));
assert(directed_ || u != v);
adjacency_[u].push_back({v, weight});
if (!directed_) {
adjacency_[v].push_back({u, weight});
}
edge_count_++;
}
...
const std::vector<Edge>& neighbors(int u) const {
assert(valid(u));
return adjacency_[u];
}
...
private:
...
std::vector<std::vector<Edge>> adjacency_;
std::size_t edge_count_ = 0;
bool directed_;
};Sus invariantes, en un comentario y en check_invariants, como siempre desde la semana 2:
- Todo destino de una lista es un nodo válido.
- Las listas suman E entradas si es dirigido, y 2E si no lo es.
- Si no es dirigido, cada entrada u → v con peso w tiene su pareja v → u con peso w, y no hay lazos (aristas de un nodo a sí mismo).
add_edge no revisa si la arista ya existe. Hacerlo costaría recorrer la lista en cada inserción, y quien carga un
grafo sin repetidos no tiene por qué pagarlo. Quien quiera revisarlo puede llamar antes a has_edge.
En C++. Aquí no hay
newnidelete. Ya construimos un arreglo dinámico en la semana 4, y no es el tema de hoy, así questd::vectores owner de toda la memoria: copiar, mover y destruir unGraphya funciona sin escribir nada.neighborsdevuelve una referencia a la lista. Por esofor (const Edge& edge : graph.neighbors(u))no copia nada. Como vieron en la semana 4, unadd_edgeque haga crecer esa lista invalida sus iteradores y las referencias a sus elementos, y eso es lo que usa elfor. No agreguen aristas mientras recorren.
En la biblioteca. La biblioteca estándar de C++ no trae ningún tipo de grafo. No hay un
std::graph. Se arma con lo que ya conocen, y por eso las pruebas de hoy no pueden comparar contra la biblioteca: comparan contra un cálculo por fuerza bruta.
Qué cuesta cada una
| Matriz de adyacencia | Listas de adyacencia | |
|---|---|---|
| Memoria | Θ(V²) | Θ(V + E) |
| ¿Existe la arista u-v? | Θ(1) | Θ(grado de u) en el peor caso |
| Recorrer los vecinos de u | Θ(V) | Θ(grado de u) |
| Recorrer todas las aristas | Θ(V²) | Θ(V + E) |
| Agregar una arista | Θ(1) | O(1) amortizado, por push_back |
Un grafo con muchas menos aristas que V² se llama disperso (sparse), y uno con un número de aristas cercano a V² se llama denso (dense). No hay una frontera exacta: lo que importa es comparar E con V². Casi todos los grafos reales son dispersos, porque un cruce no toca a todos los demás cruces de una ciudad.
Veamos los números de 1000 nodos y 3000 aristas. Hagan la cuenta a mano primero:
- Matriz: 1000 × 1000 = 1 000 000 de celdas. Con un byte por celda, 1 MB. Con un bit por celda serían 125 000 bytes, y seguirían siendo 1 000 000 de celdas.
- Listas: 2 × 3000 = 6000 entradas. Cada una tiene dos
int, así que son 48 000 bytes, a los que hay que sumar una cabecera destd::vectorpor nodo.
representations arma las dos, con las mismas 3000 aristas al azar, y compara:
$ build/representations
nodos: 1000, aristas: 3000
sizeof(std::vector<Edge>): 24, sizeof(Edge): 8
matriz, bytes: 1000032
listas, entradas: 6000, capacidad reservada: 7927
listas, bytes: 87456
lista mas larga: 16
preguntas has_edge: 1000000, respuestas si: 6000
lecturas por pregunta, matriz: 1.00, listas: 5.98199
recorrer todos los vecinos, matriz: 1000000 lecturas, listas: 6000 lecturas
Las listas ocupan unas 11 veces menos: 87 456 bytes frente a 1 000 032. Son más de los 48 000 + 24 000 = 72 000
que da la cuenta, porque cada vector guarda capacidad sobrante, como vieron en la semana 4: hay 7927 lugares para
6000 entradas. Esa cifra tampoco incluye lo que el administrador de memoria agrega a cada bloque, y sizeof(std::vector)
= 24 es de nuestra biblioteca, libstdc++: el estándar no lo fija.
La matriz gana exactamente una competencia: responder has_edge, con 1 lectura frente a 6 en promedio en este
grafo. Y las listas ganan por mucho al recorrer los vecinos: 6000 lecturas frente a 1 000 000. Como todo recorrido
de esta semana pasa la vida preguntando “¿quiénes son los vecinos de u?”, elegimos listas, salvo que el grafo sea
denso o que has_edge sea la operación principal.
Idea clave. Elijan la representación por la operación que más van a hacer, y por la relación entre E y V². Si casi todo es recorrer vecinos, y el grafo es disperso, usen listas.
Un grafo real
Hasta aquí, los números eran pequeños. Tomemos uno real. data/mapas/miraflores.txt tiene las calles de un rectángulo
alrededor de Miraflores: un nodo es un cruce o el extremo de una calle, y una arista es un tramo de calle, con su
largo en metros. Los datos son de © colaboradores de OpenStreetMap; data/README.md dice su
licencia y cómo se construyeron. La semana 15 calcula rutas sobre estos mapas. Hoy solo miramos su forma:
$ build/map_tour ../../data/mapas/miraflores.txt 1839 1883
nodos: 2242, aristas: 3474
grado medio: 3.09902, grado maximo: 6
aristas sobre las posibles: 0.138287 %
matriz de un byte por celda: 5026564 bytes
listas: 118256 bytes
componentes: 1
de 1839 a 1883:
BFS: 18 aristas, 1871 metros, nodos marcados: 492
DFS: 393 aristas, 32805 metros, nodos marcados: 543
Las primeras líneas confirman la intuición. Un cruce tiene unas 3 calles en promedio, y como máximo 6: de todas las
aristas posibles, solo existe el 0.14 %. La matriz ocuparía 42 veces más que las listas. Para lima.txt, con 79 050
nodos, la matriz necesitaría 79 050² bytes, más de 6 GB. Las listas de ese mismo mapa no tienen ese problema. Las
últimas dos líneas las explicamos más abajo: son la razón de que existan dos recorridos.
BFS: recorrer por niveles
Queremos visitar todo lo que se alcanza desde un nodo. El problema frente a un árbol es que en un grafo hay ciclos, y varias maneras de llegar al mismo nodo. Así que hace falta recordar por dónde ya pasamos.
BFS (breadth-first search, búsqueda en anchura) visita primero el origen, luego sus vecinos, luego los vecinos de esos que no se hayan visto, y así sigue. Avanza como una onda en el agua, y usa una cola para atender en el orden de llegada.
algoritmo bfs(grafo, origen)
    distancia[v] ← -1 para todo nodo v
    distancia[origen] ← 0
    padre[origen] ← origen
    meter origen a la cola
    mientras la cola no esté vacía hacer
        u ← sacar de la cola
        para cada vecino v de u hacer
            si distancia[v] = -1 entonces
                distancia[v] ← distancia[u] + 1
                padre[v] ← u
                meter v a la cola
            fin si
        fin para
    fin mientras
fin algoritmo
Decimos que un nodo está marcado cuando ya sabemos que lo atenderemos. Aquí la marca es distancia[v] ≠ -1, y se
pone al meter el nodo a la cola. Esa frase importa más de lo que parece, y volveremos a ella.
En C++ es igual de corto:
inline BfsResult bfs(const Graph& graph, int source) {
    int n = graph.node_count();
    BfsResult result{std::vector<int>(n, -1), std::vector<int>(n, -1), {}};
    std::queue<int> pending;
    result.distance[source] = 0;
    result.parent[source] = source;
    pending.push(source);
    while (!pending.empty()) {
        int u = pending.front();
        pending.pop();
        result.order.push_back(u);
        for (const Edge& edge : graph.neighbors(u)) {
            if (result.distance[edge.to] == -1) {  // se marca al meterlo a la cola
                result.distance[edge.to] = result.distance[u] + 1;
                result.parent[edge.to] = u;
                pending.push(edge.to);
            }
        }
    }
    return result;
}
std::queue es la cola de la biblioteca; por debajo usa un std::deque, el de la semana 5.
Paso a paso
bfs_trace corre BFS sobre el grafo de la clase desde el nodo 0. Cada fila dice qué nodo salió, qué nodos marcó, y
cómo quedó la cola:
$ build/bfs_trace
sale  marca     cola al terminar el paso
   -  0         0
   0  1 2       1 2
   1  3         2 3
   2  4         3 4
   3  5         4 5
   4            5
   5  6         6
   6
orden: 0 1 2 3 4 5 6
distancia: 0 1 1 2 2 3 4
padre: 0 0 0 1 2 3 5
camino a 6: 0 1 3 5 6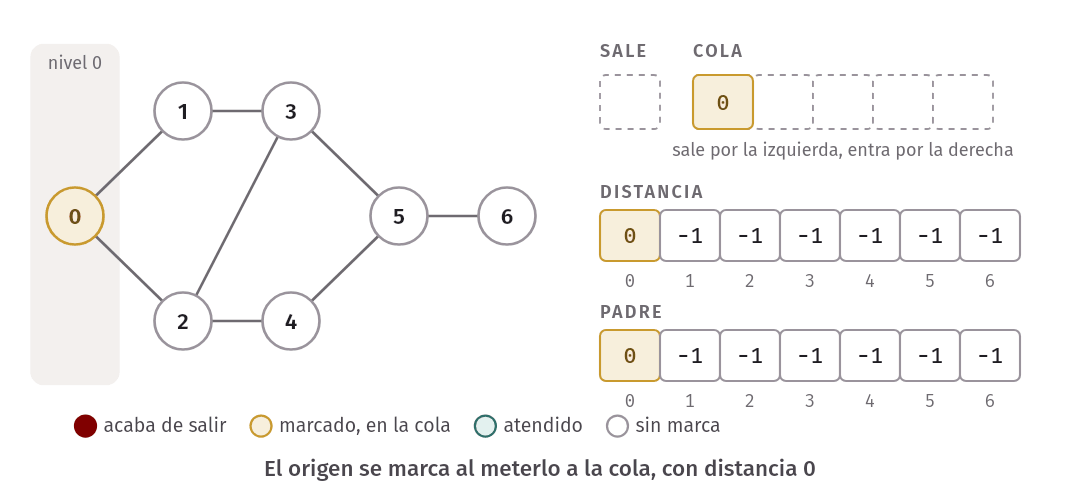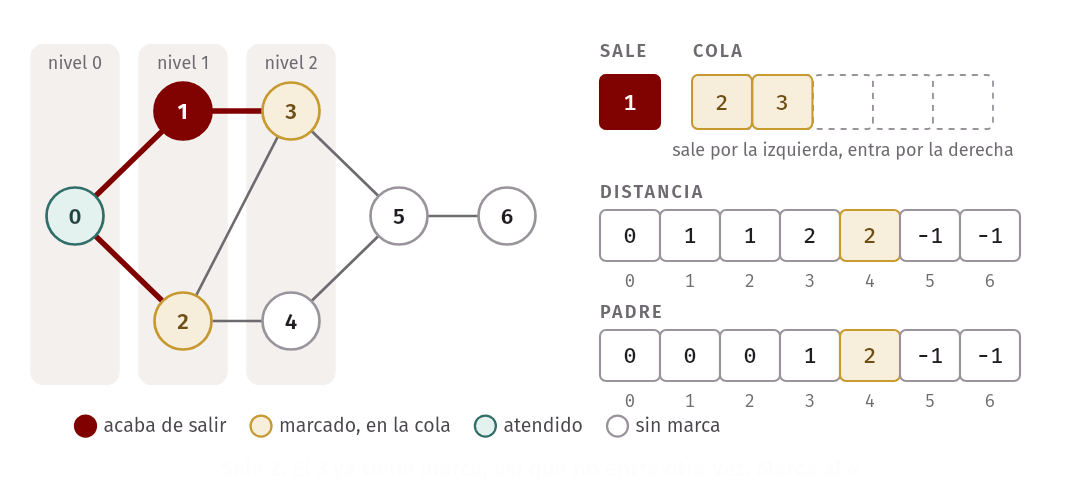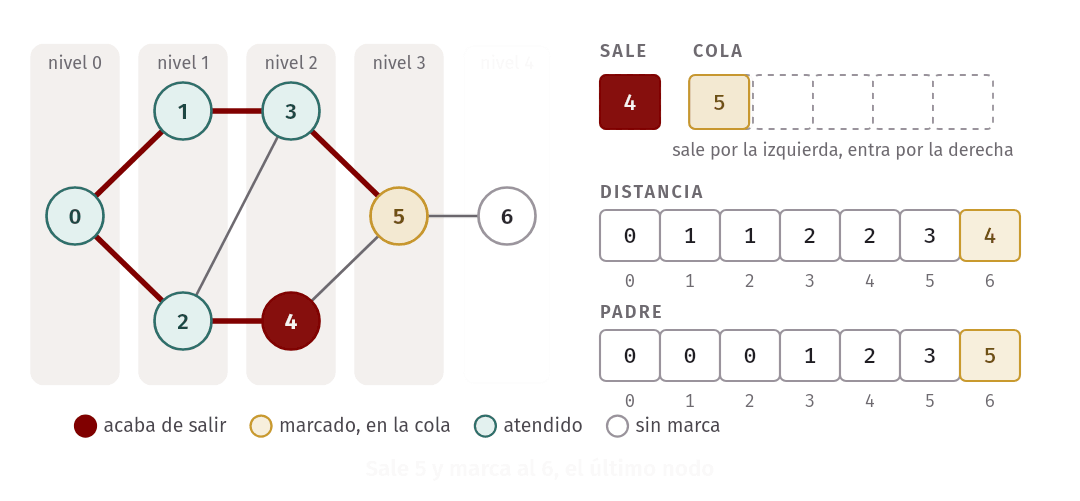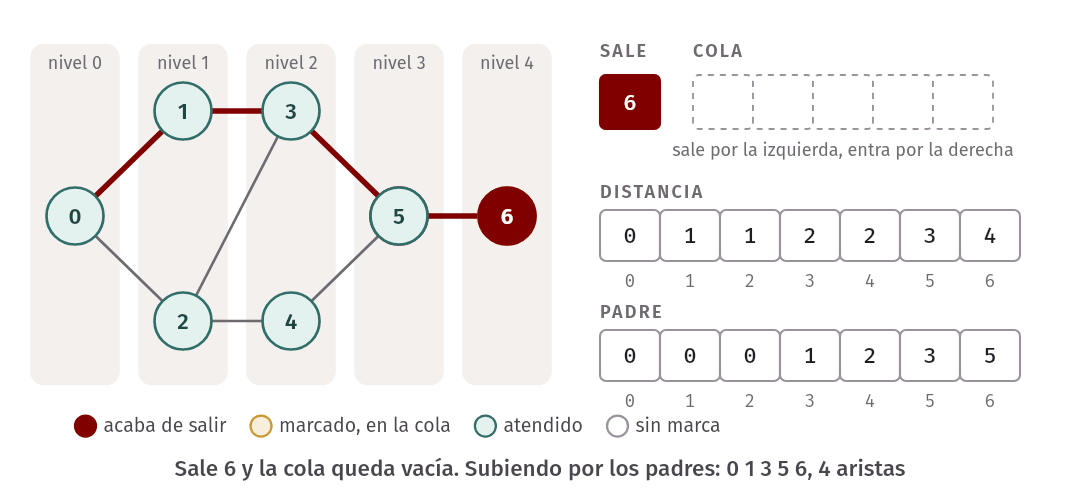
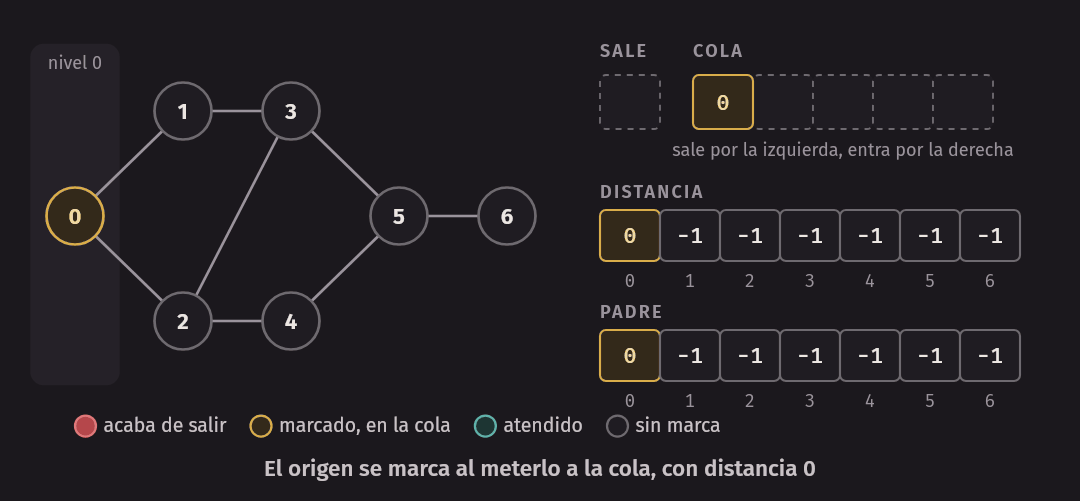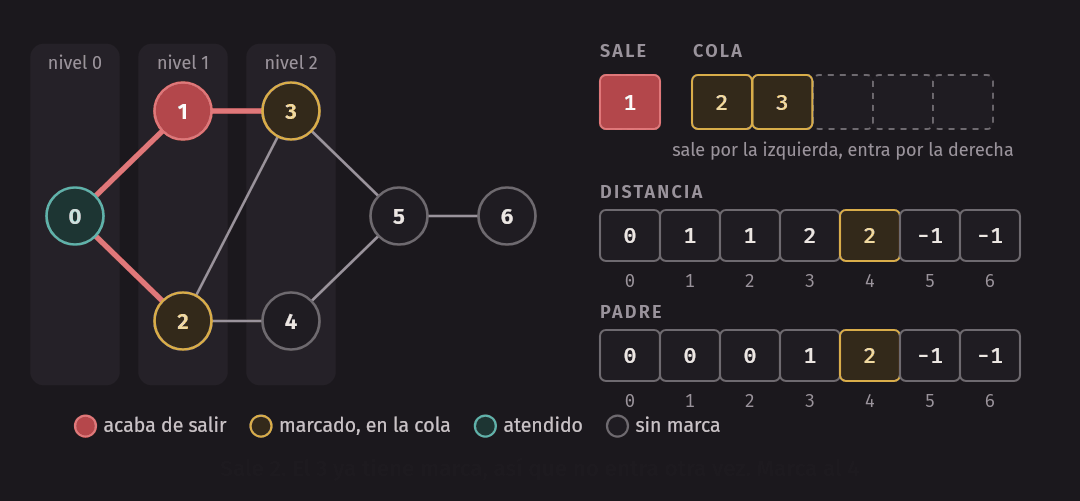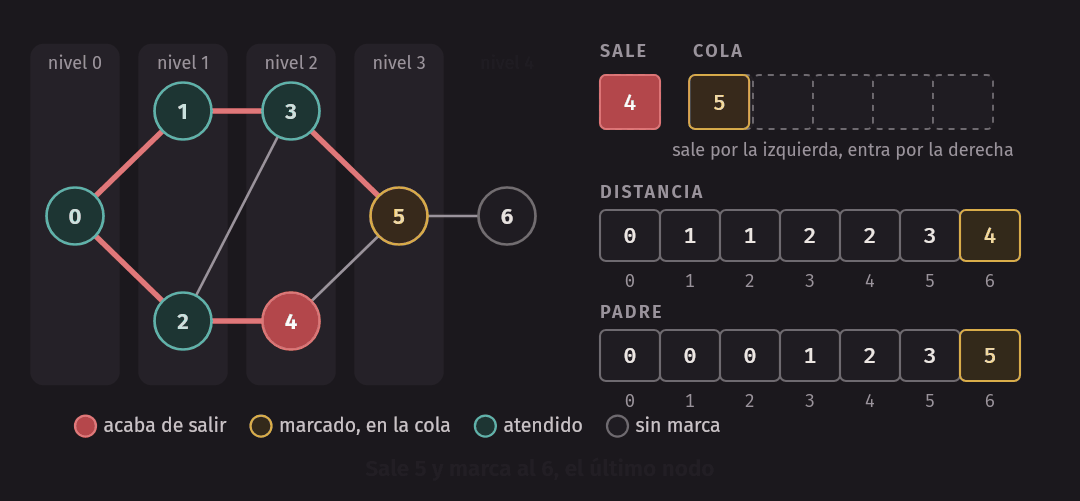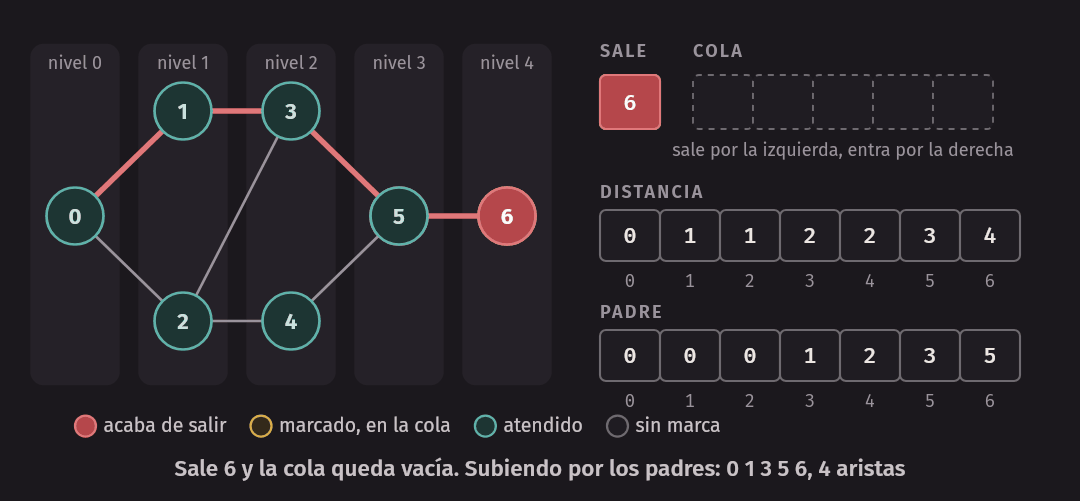
Fíjense en lo que pasa con el 3 y con el 2:
- Al sacar el 1, se marca el 3. Al sacar el 2, su vecino 3 ya está marcado, así que no entra otra vez. Por eso el padre del 3 es el 1, y no el 2.
- Al sacar el 4, sus vecinos 2 y 5 ya están marcados: no marca a nadie, y la fila queda vacía.
- La cola siempre tiene nodos de como máximo dos niveles seguidos. En la fila del 3, tiene al 4, de distancia 2, y al 5, de distancia 3.
La distancia tiene un nombre geométrico: los nodos de distancia d forman el nivel d. Aquí los niveles son {0}, {1, 2}, {3, 4}, {5} y {6}. Por eso se dice que BFS recorre por niveles.
Por qué da el camino con menos aristas
Afirmación. Cuando BFS termina, distancia[v] es el largo del camino más corto, en aristas, desde el origen
hasta v.
Necesitamos dos cosas.
La distancia nunca es menor que la verdadera. Cada valor salió de distancia[u] + 1, con u vecino de v: si seguimos
los padres desde v hasta el origen, tenemos un camino real con exactamente distancia[v] aristas. Ningún camino real
es más corto que el mínimo, así que la distancia guardada es mayor o igual que el mínimo.
La distancia nunca es mayor que la verdadera. La cola atiende por orden de llegada, y cada nodo entra con
distancia[u] + 1. Entonces los nodos salen con distancias que nunca bajan: primero todos los de distancia 0, luego
los de 1, y así. Por eso, si un vecino v de u ya estaba marcado cuando sale u, lo marcó alguien que salió antes que
u, de modo que distancia[v] ≤ distancia[u] + 1. Si no estaba marcado, lo marca u y vale justo eso.
Ahora tomen un camino más corto hasta t y recórranlo: origen = v₀, v₁, v₂… t. El v₁ queda con distancia ≤ 1, porque es vecino del origen. El v₂ queda con distancia ≤ 2, porque es vecino de v₁. Avanzando así por todo el camino, t queda con distancia ≤ su largo. Las dos cosas juntas dan la igualdad.
La parte importante es dónde se usó la cola: en que las distancias salen en orden. Eso es justo lo que una pila no da, y por eso DFS no tiene esta garantía.
Idea clave. BFS da el camino con menos aristas. No dice nada de metros: un camino de pocas aristas largas puede ser peor que uno de muchas aristas cortas. Para eso existe Dijkstra, la próxima semana.
Reconstruir el camino
BFS no guarda caminos enteros: sería demasiada memoria. Guarda algo mucho más barato, un solo entero por nodo: de dónde se llegó. Esos padres forman un árbol con raíz en el origen, el árbol de BFS. Para reconstruir el camino, se sube desde el destino hasta el origen, y se le da la vuelta:
inline std::vector<int> path_to(const std::vector<int>& parent, int target) {
    std::vector<int> path;
    if (parent[target] == -1) {
        return path;
    }
    int node = target;
    while (parent[node] != node) {
        path.push_back(node);
        node = parent[node];
    }
    path.push_back(node);
    std::reverse(path.begin(), path.end());
    return path;
}
Convenio: parent[v] vale −1 si no se llega a v, y el origen es su propio padre. Así el ciclo sabe dónde parar, y un
camino vacío significa “no se llega”. En nuestro ejemplo: el 6 viene del 5, el 5 del 3, el 3 del 1, y el 1 del 0. Al
revés da 0 1 3 5 6.
Marcar: por qué y cuándo
Sin marcas, una búsqueda que entra en un ciclo no termina. errors/no_marks.cpp hace BFS en un triángulo, sin
marcar nada, y solo se detiene porque el programa se corta a los 20 pasos:
$ g++ -Wall -Wextra -std=c++20 errors/no_marks.cpp -o build/no_marks && build/no_marks
cortado tras 20 pasos, con 21 entradas en la cola
Nadie olvida marcar dos veces. El error que sí cometerán es otro.
Error común. Marcar un nodo como visitado al sacarlo de la cola, en vez de al meterlo. Entre esos dos momentos, el nodo está en la cola y parece no visto, así que cualquier vecino lo vuelve a meter.
errors/bfs_mark_on_pop.cpp hace esto, en dos versiones. Una marca al sacar. La otra agrega el arreglo más común,
que es ignorar al sacar un nodo que ya estaba marcado:
        int u = pending.front();
        pending.pop();
        if (skip_marked && marked[u]) {
            continue;
        }
        marked[u] = true;  // demasiado tarde
        for (const Edge& edge : graph.neighbors(u)) {
            if (!marked[edge.to]) {
                distance[edge.to] = distance[u] + 1;
                pending.push(edge.to);
                pushes++;
            }
        }
$ g++ -Wall -Wextra -std=c++20 errors/bfs_mark_on_pop.cpp -o build/bfs_mark_on_pop && build/bfs_mark_on_pop
triangulo, distancia de 0 a 2 (la verdadera es 1):
marcando al sacar: 2
e ignorando los ya marcados: 2
rombos nodos aristas entradas a la cola ignorando marcados
2 7 8 13 9
4 13 16 61 17
8 25 32 1021 33
12 37 48 16381 49
16 49 64 262141 65Son dos daños distintos:
- La distancia queda mal. En el triángulo 0-1-2, al sacar el 0 se meten el 1 y el 2, con distancia 1. Al sacar el 1, el 2 todavía no está marcado, y su distancia se sobrescribe con 2. Con los padres pasa lo mismo.
- La cola explota. Un “rombo” son dos caminos de dos aristas que se juntan. Con rombos en fila, cada cruce entra dos veces por cada vez que entró el anterior: en estas filas, la cuenta da 2^(k+2) − 3 con k rombos. Con 16 rombos y 49 nodos, ya son 262 141 entradas. Ese crecimiento ya no es un Θ(V + E): es exponencial.
La línea del arreglo evita la explosión. Con ella, la cola recibe como máximo 2E + 1 entradas, pero la distancia del triángulo sigue mal, porque el daño ocurrió al meter. Y aun corrigiendo eso, la cola guardaría hasta 2E entradas y no V. La solución de verdad es una línea más arriba: se marca al meter, y cada nodo entra una sola vez.
Idea clave. La marca significa “alguien ya se encargó de este nodo”, no “ya lo atendí”. Se pone en el momento en que el nodo entra a la cola.
DFS: bajar todo lo posible
DFS (depth-first search, búsqueda en profundidad) hace lo contrario. Desde un nodo, va al primer vecino sin marcar, y desde ahí al primer vecino sin marcar de ese, y así sigue. Solo cuando no le queda ningún vecino nuevo, retrocede al nodo anterior y prueba el siguiente vecino. Es como recorrer un laberinto con una mano en la pared. Lo natural es escribirlo con recursión, porque el “nodo anterior” es el marco de llamada anterior:
algoritmo dfs(grafo, u)
    marcado[u] ← verdadero
    para cada vecino v de u hacer
        si no marcado[v] entonces
            dfs(grafo, v)
        fin si
    fin para
fin algoritmo
inline void dfs_visit(const Graph& graph, int u, std::vector<bool>& marked, std::vector<int>& order) {
marked[u] = true;
order.push_back(u);
for (const Edge& edge : graph.neighbors(u)) {
if (!marked[edge.to]) {
dfs_visit(graph, edge.to, marked, order);
}
}
}Sigamos DFS en el grafo de la clase, desde el 0, con los vecinos en el orden de las listas:
| Paso | Estoy en | Pila de llamadas | Qué pasa |
|---|---|---|---|
| 1 | 0 | 0 | Marco 0. Su primer vecino sin marcar es 1 |
| 2 | 1 | 0 1 | Marco 1. Vecinos: 0 ya está, sigue 3 |
| 3 | 3 | 0 1 3 | Marco 3. Vecinos: 1 ya está, sigue 2 |
| 4 | 2 | 0 1 3 2 | Marco 2. Vecinos: 0 y 3 ya están, sigue 4 |
| 5 | 4 | 0 1 3 2 4 | Marco 4. Vecinos: 2 ya está, sigue 5 |
| 6 | 5 | 0 1 3 2 4 5 | Marco 5. Vecinos: 3 y 4 ya están, sigue 6 |
| 7 | 6 | 0 1 3 2 4 5 6 | Marco 6. No hay vecinos nuevos: empieza a volver |
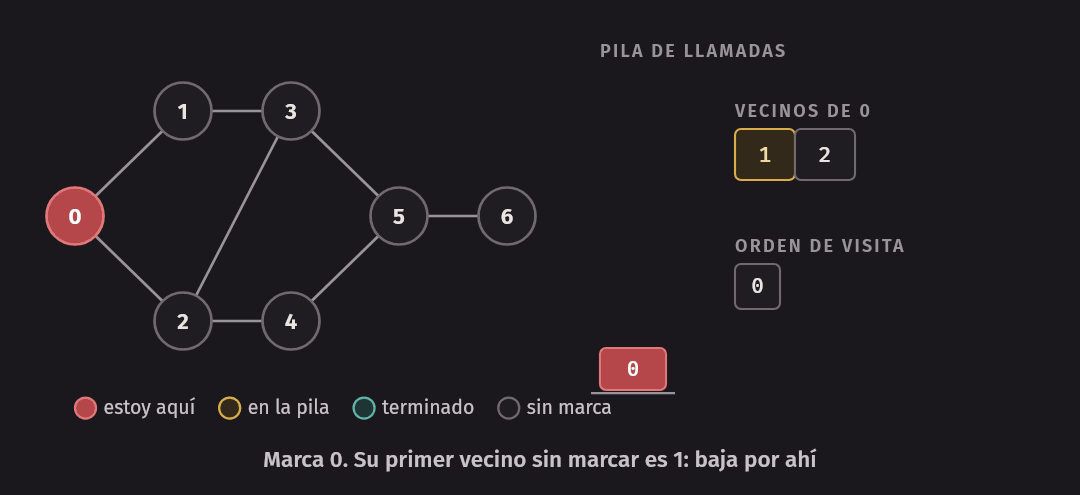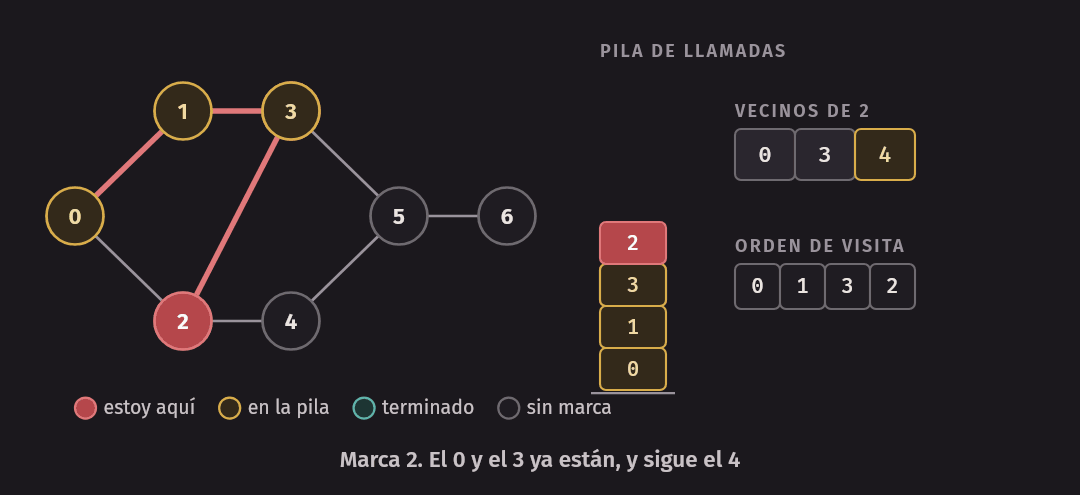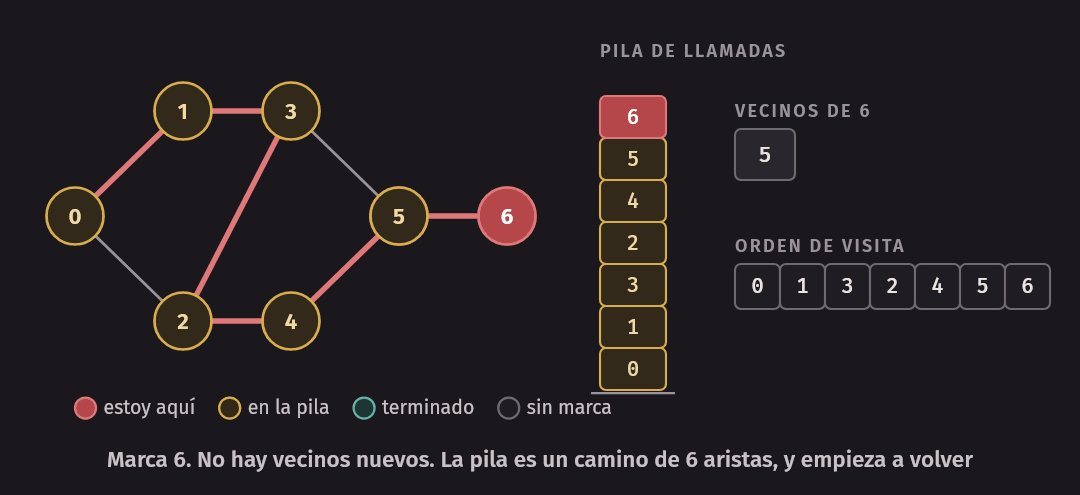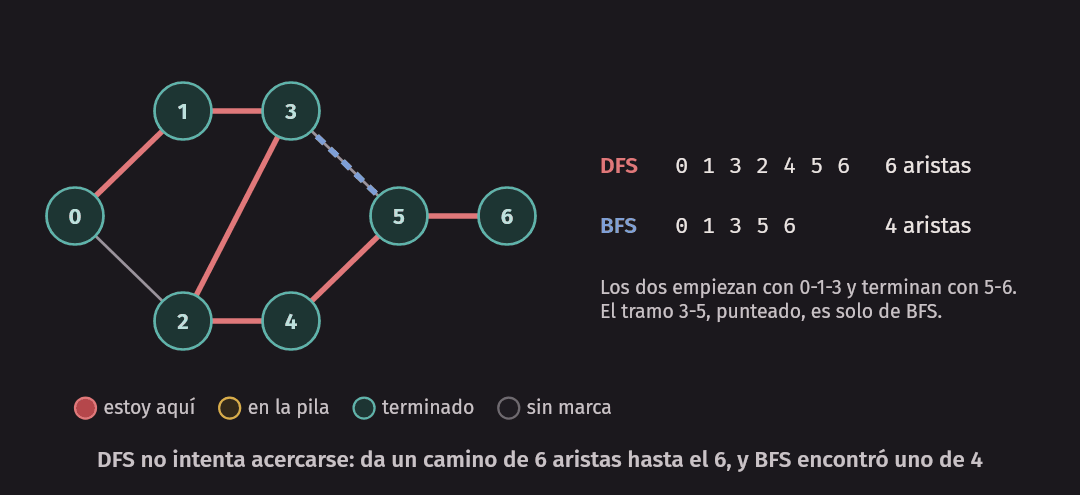
La pila de llamadas, en cada momento, es un camino desde el origen. Y ese camino puede dar muchas vueltas: al
llegar al 6 tiene 6 aristas, cuando BFS encontró uno de 4. dfs_demo lo confirma:
$ build/dfs_demo
BFS desde 0:              0 1 2 3 4 5 6
DFS recursivo desde 0:    0 1 3 2 4 5 6
DFS con pila de marcos:   0 1 3 2 4 5 6
cola de BFS con una pila: 0 2 4 5 6 3 1
componentes de cada nodo: 0 0 0 1 1 2 2 2
con ciclo (no dirigido): si
arbol con ciclo: no
dependencias con ciclo: no
agregando 3 -> 0: si
Por qué DFS no da el camino más corto
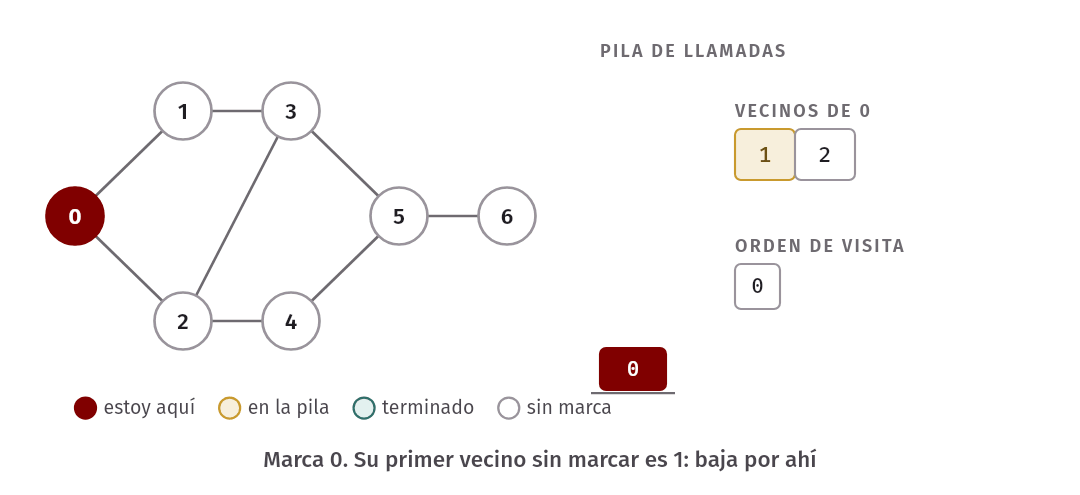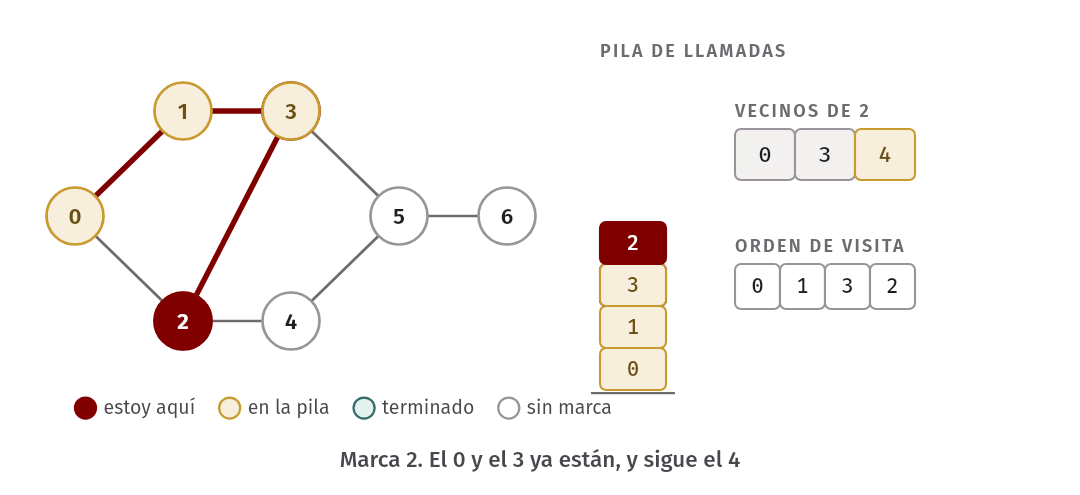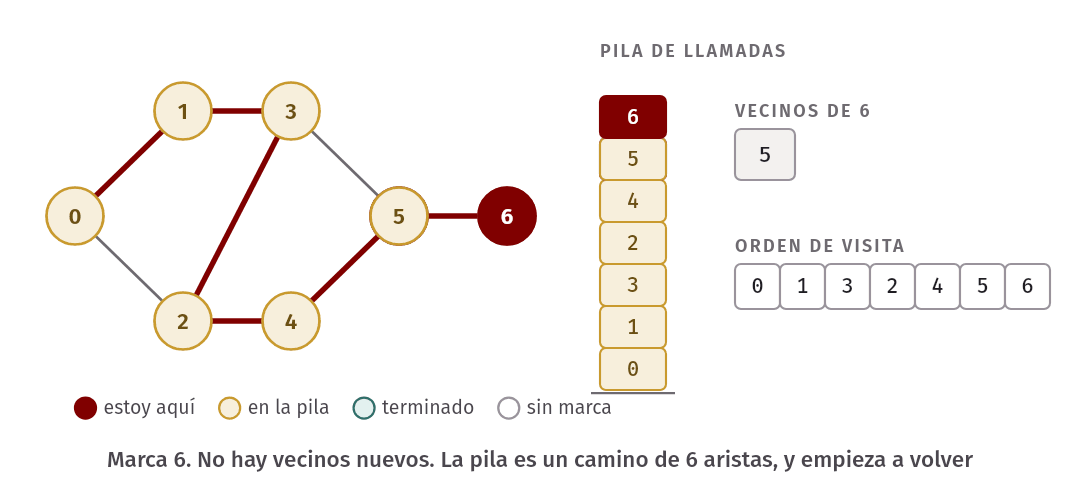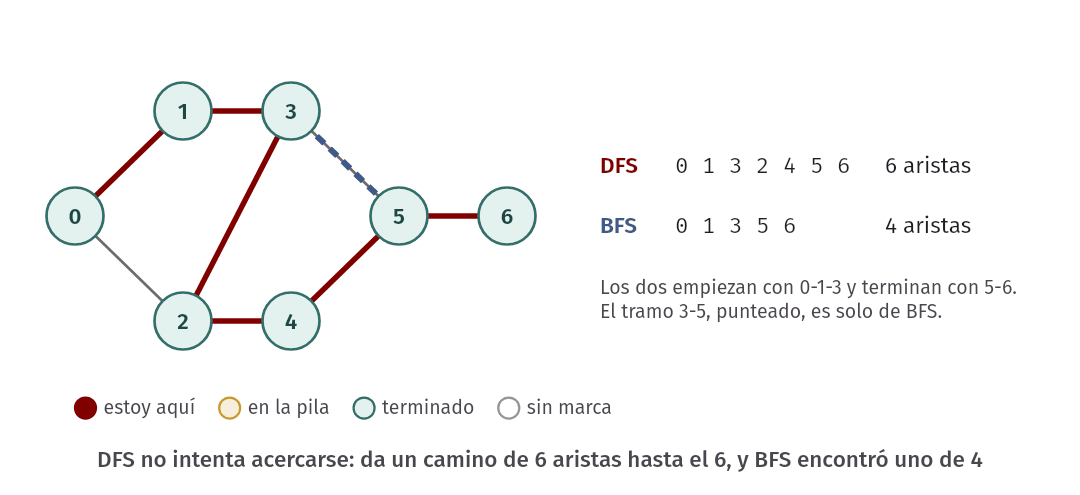
Porque la primera manera que encuentra de llegar a un nodo es la que usa, y nada dice que sea la más corta. DFS marca un nodo apenas lo ve, por el camino por el que iba. Si después hay una forma más directa de llegar, el nodo ya está marcado. En el grafo de la clase, DFS llega al 3 desde el 1, con 2 aristas, y al 2 desde el 3, con 3 aristas, aunque el 2 es vecino directo del origen.
Eso no quiere decir que DFS siempre dé un camino malo. Puede encontrar el más corto si le toca un buen orden de
vecinos, y en un árbol no hay otro camino posible. Lo que no da es la garantía. El mapa lo muestra a otra escala:
en map_tour, de un nodo de la calle Malecón de la Reserva a uno de la Avenida Arequipa, BFS encontró un camino de
18 aristas y 1871 metros, y DFS uno de 393 aristas y 32 805 metros: unos 33 km por las calles de la zona para hacer
menos de 2 km. Sale un camino válido, y no sirve para ir a ninguna parte. El orden de los vecinos es el del archivo,
así que ese número exacto no es una propiedad del mapa. Lo que sí lo es, es que DFS no intenta acercarse.
Con una pila
La recursión gasta un marco de llamada por cada nodo del camino actual. En un grafo con un camino largo, puede agotar
la pila, igual que el destructor recursivo de la semana 10. errors/recursive_dfs_overflow.cpp arma un camino de un
millón de nodos:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/recursive_dfs_overflow.cpp -o build/recursive_dfs_overflow && build/recursive_dfs_overflow 1000000
con pila propia: 1000000 nodos
AddressSanitizer:DEADLYSIGNAL
=================================================================
==42104==ERROR: AddressSanitizer: stack-overflow on address 0xfffffc4f3ff0 (pc 0xaaaadee1f794 bp 0xfffffc4f4040 sp 0xfffffc4f4040 T0)
...
La línea “con pila propia” es de la versión sin recursión, que sí terminó. Para escribirla, hay que guardar lo mismo que guarda un marco: qué nodo es y por qué posición de su lista iba.
inline std::vector<int> dfs_iterative(const Graph& graph, int source) {
    std::vector<bool> marked(graph.node_count(), false);
    std::vector<int> order;
    std::vector<std::pair<int, std::size_t>> stack;
    marked[source] = true;
    order.push_back(source);
    stack.push_back({source, 0});
    while (!stack.empty()) {
        auto& [u, next] = stack.back();
        const std::vector<Edge>& list = graph.neighbors(u);
        if (next == list.size()) {
            stack.pop_back();
            continue;
        }
        int v = list[next].to;
        next++;
        if (!marked[v]) {
            marked[v] = true;
            order.push_back(v);
            stack.push_back({v, 0});  // invalida u y next, que no se vuelven a usar en esta vuelta
        }
    }
    return order;
}
Da exactamente el mismo orden que la recursiva, como muestra la salida de dfs_demo, y las pruebas lo comprueban en
200 grafos al azar. La pila, igual que la de llamadas, es en todo momento un camino desde el origen.
Error común. Creer que basta cambiar la cola de BFS por una pila.
stack_searchhace eso: mete todos los vecinos sin marcar, y marca al sacar. Visita los mismos nodos, pero en otro orden:0 2 4 5 6 3 1, en la cuarta línea de la salida. Sirve para saber qué se alcanza, ycomponent_labelsusa esa misma idea, aunque marcando al meter. No sirve donde importa el camino actual, como en la detección de ciclos dirigidos de más abajo. Además, un nodo puede estar varias veces en esa pila, que llega a tener Θ(E) entradas.
Componentes conexas
¿Cuántos pedazos tiene un grafo? Una búsqueda desde un nodo marca toda su componente, y nada más. Así que se recorren todos los nodos, y por cada uno sin marcar se lanza una búsqueda nueva:
inline std::vector<int> component_labels(const Graph& graph) {
    std::vector<int> label(graph.node_count(), -1);
    int count = 0;
    for (int start = 0; start < graph.node_count(); start++) {
        if (label[start] != -1) {
            continue;
        }
        std::vector<int> stack{start};
        label[start] = count;
        while (!stack.empty()) {
            int u = stack.back();
            stack.pop_back();
            for (const Edge& edge : graph.neighbors(u)) {
                if (label[edge.to] == -1) {
                    label[edge.to] = count;
                    stack.push_back(edge.to);
                }
            }
        }
        count++;
    }
    return label;
}
Aquí el orden de visita no importa, así que basta una pila simple, marcando al meter: cada nodo entra una sola vez, y
se evita el problema de recursión. Una cola serviría igual. El grafo de dfs_demo tiene 8 nodos con las aristas
0-1, 1-2, 3-4, 5-6, 6-7 y 7-5: salen las etiquetas 0 0 0 1 1 2 2 2, tres componentes. En el mapa sale
componentes: 1, lo que era de esperar: el archivo guarda solo la mayor componente conexa de la zona.
Después de esa pasada, responder “¿están conectados a y b?” es comparar dos etiquetas. Recuerden esto para cuando lleguemos a union-find.
Detectar ciclos
En un grafo no dirigido, si DFS encuentra una arista hacia un nodo ya marcado que no es de donde acaba de venir, hay un ciclo: ese nodo ya tenía otro camino hasta aquí.
inline bool undirected_cycle_from(const Graph& graph, int u, int parent, std::vector<bool>& marked) {
    marked[u] = true;
    for (const Edge& edge : graph.neighbors(u)) {
        if (!marked[edge.to]) {
            if (undirected_cycle_from(graph, edge.to, u, marked)) {
                return true;
            }
        } else if (edge.to != parent) {
            return true;  // ya marcado y no es de donde vengo: hay otro camino hasta él
        }
    }
    return false;
}
La excepción del padre es necesaria porque en un grafo no dirigido cada arista aparece en las dos listas: desde v, siempre se ve de vuelta al padre, y eso no es un ciclo. Esta versión supone que no hay aristas repetidas. Con dos aristas entre u y v, sí habría un ciclo, y el código no lo vería, porque miraría solo a qué nodo llega. Los mapas de este curso no tienen aristas repetidas: lo revisamos.
En un grafo dirigido, esa misma revisión está mal. Un nodo ya marcado no significa ciclo: puede ser que dos caminos lleguen al mismo sitio.
$ g++ -Wall -Wextra -std=c++20 errors/directed_false_cycle.cpp -o build/directed_false_cycle && build/directed_false_cycle
revision no dirigida: hay ciclo
revision con tres colores: sin ciclo
Ahí, 0 → 1 → 3 y 0 → 2 → 3 llegan los dos a 3, y de 3 no se vuelve. Es un caso de lo más normal en un Makefile: dos archivos que dependen del mismo encabezado. Lo que importa es si el nodo marcado está en el camino actual, y para eso hacen falta tres estados: blanco es sin ver, gris es en la pila, negro es terminado. Hay ciclo si y solo si se encuentra una arista hacia un nodo gris:
inline bool directed_cycle_from(const Graph& graph, int u, std::vector<Color>& color) {
    color[u] = Color::Gray;
    for (const Edge& edge : graph.neighbors(u)) {
        if (color[edge.to] == Color::Gray) {
            return true;  // volvió a un nodo del camino actual
        }
        if (color[edge.to] == Color::White && directed_cycle_from(graph, edge.to, color)) {
            return true;
        }
    }
    color[u] = Color::Black;
    return false;
}
Este es el motivo de que la pila simple de arriba no baste aquí: su pila no es un camino, así que no sabe quién está
“en el camino actual”. Las últimas líneas de dfs_demo lo prueban en un grafo de dependencias: sin ciclo, y con
ciclo al agregar 3 → 0. Hagan el ciclo con su propio Makefile, y make se quejará con un mensaje de dependencia
circular. Es este mismo problema.
Qué responde cada uno
| Pregunta | BFS | DFS |
|---|---|---|
| ¿Qué se alcanza desde aquí? | Sí | Sí |
| Componentes conexas | Sí | Sí |
| Camino con menos aristas | Sí | No lo garantiza |
| Encontrar algún camino | Sí | Sí |
| Ciclo en grafo no dirigido | También se puede | Sí |
| Ciclo en grafo dirigido | No de esta forma | Sí, con tres colores |
| Memoria auxiliar en el peor caso | Θ(V): la cola | Θ(V): la pila |
La última fila tiene una trampa. En un camino largo, DFS guarda muchos nodos y BFS casi ninguno. En una estrella, un nodo con muchos vecinos, pasa al revés. Ninguno gana siempre.
El costo: Θ(V + E)
Contemos lo que hace BFS. Crear los arreglos cuesta Θ(V). Después:
- Cada nodo que se alcanza entra a la cola una sola vez, porque se marca al entrar. Y sale una sola vez.
- Al salir, se lee su lista completa. Cada lista se lee una sola vez, así que las lecturas son la suma de los grados de los nodos que se alcanzan.
En un grafo no dirigido conexo, esa suma es 2E. Si es dirigido y se alcanzan todos los nodos, es E. El total es Θ(V + E), y no se puede bajar, porque hay que tocar cada nodo y cada arista. DFS hace lo mismo: un nodo solo se marca una vez, y cada lista se recorre una vez.
Hay una precisión que conviene tener. Si el grafo no es conexo, una búsqueda desde un nodo solo paga las aristas
de su componente, más el Θ(V) de los arreglos: es O(V + E), y puede ser bastante menos que E. Si se recorren todas las
componentes, como component_labels, sí es Θ(V + E) siempre.
Con una matriz, en cambio, leer los vecinos de un nodo cuesta Θ(V) lecturas. El mismo BFS pasa a costar Θ(V²) en todo grafo donde se alcancen todos los nodos, por disperso que sea.
Los tres mapas son una buena forma de comprobarlo. bfs_scaling corre BFS desde el nodo 0, cuenta los nodos que
salen y las entradas leídas, y mide el tiempo. Se compiló con -O2 y sin sanitizers. Cada tiempo es la mediana de 11
corridas, y los tiempos dependen de la máquina. Esta es una de 3 corridas, en el contenedor del curso sobre una máquina
arm64, con otros procesos ocupándola:
$ build/bfs_scaling ../../data/mapas/miraflores.txt ../../data/mapas/lima-sur.txt ../../data/mapas/lima.txt
    nodos   aristas  sacados  entradas leidas   ms lista  ns/(V+E)
     2242      3474     2242             6948      0.013       2.3
    19560     29117    19560            58234      0.290       6.0
    79050    116803    79050           233606      1.841       9.4
matriz en el primer mapa: 5026564 celdas leidas, 3.718 ms
listas en el primer mapa: 0.013 ms
Lo que dicen los conteos es exacto, y las pruebas lo comprueban: sacados es V y entradas leidas es 2E, en los tres
mapas. El análisis cuenta bien el trabajo.
El tiempo por unidad de V + E, en cambio, no se mantiene: en las tres corridas, subió de unos 2.4 ns en el mapa
chico a 6-8 ns en el mediano y a 9 ns en el grande. Θ(V + E) no predice esa diferencia, porque habla de cuánto trabajo
hay y no de cuánto tarda cada lectura. Probablemente sea por la cache: un mapa grande no cabe en ella, y cada lista es
un bloque aparte en memoria. No tenemos perf en este entorno para confirmarlo, así que queda como explicación
probable y no como medición.
La última comparación sí es clara: en Miraflores, la matriz lee 5 026 564 celdas y las listas 6948 entradas, 723 veces menos. Tardó unas 280 veces más. La diferencia de tiempo no llega a 723, probablemente porque las celdas están seguidas en memoria y leerlas es más barato que saltar de una lista a otra. Aun así, es enorme.
Union-find
Cambiemos de pregunta. Las aristas no están todas desde el principio: van llegando una a una, y entre una y otra alguien pregunta “¿están conectados a y b?”. Pasa en una red, cuando se van instalando cables. Pasa en un mapa que se va cargando, y pasará en nuestro laberinto cada vez que tiremos una pared.
Con lo que tenemos, hay dos opciones, y ninguna es buena. Podemos correr una búsqueda por cada pregunta, a Θ(V + E)
cada una en el peor caso. O podemos guardar la etiqueta de componente de cada nodo y actualizarla con cada arista. Esa
segunda es la versión ingenua, y viene hecha en lab/naive_union_find.h: preguntar es comparar dos etiquetas, en
Θ(1), pero unir tiene que recorrer todo el arreglo, en Θ(n).
Definición. Un union-find (también disjoint sets, conjuntos disjuntos) mantiene una partición de n elementos en conjuntos, con estas operaciones:
| Operación | Qué hace |
|---|---|
find(x) |
Devuelve el representante del conjunto de x |
unite(a, b) |
Une los conjuntos de a y de b |
connected(a, b) |
¿Tienen a y b el mismo representante? |
Al principio, cada elemento está solo. Dos elementos están en el mismo conjunto si y solo si tienen el mismo representante. Qué elemento es el representante no importa, y puede cambiar. Lo único que importa es que dos preguntas seguidas, sin una unión de por medio, den el mismo.
Fíjense en lo que no hay: no se puede separar un conjunto, ni preguntar por qué camino están unidos. Es una estructura con muy poca ambición, y por eso le sale tan bien lo que hace.
Un bosque
La idea es representar cada conjunto como un árbol, donde cada nodo solo conoce a su padre, y la raíz es el
representante. Un bosque es un conjunto de árboles. Se guarda en un solo arreglo: parent[x] es el padre de x, y
una raíz es su propio padre.
parent: 0 0 0 2 4 4 4 6

     0           4
    / \         / \
   1   2       5   6
       |           |
       3           7
Son dos conjuntos, {0, 1, 2, 3} y {4, 5, 6, 7}. Con esa forma, las dos operaciones se escriben solas. find sube hasta
la raíz. unite busca las dos raíces, y cuelga una de la otra:
algoritmo find(x)
    mientras parent[x] ≠ x hacer
        x ← parent[x]
    fin mientras
    devolver x
fin algoritmo

algoritmo unite(a, b)
    raiz_a ← find(a)
    raiz_b ← find(b)
    si raiz_a = raiz_b entonces
        devolver falso
    fin si
    parent[raiz_a] ← raiz_b
    devolver verdadero
fin algoritmo
Cada operación cuesta lo que mide la altura, igual que en un árbol de búsqueda. Y como en la semana 10, nada impide que la altura se dispare: si se une 0-1, 1-2, 2-3…, siempre colgando el árbol de la izquierda, sale una cadena de altura n − 1. Hay dos mejoras, y las dos son cortas.
Error común. Enlazar los elementos en vez de sus raíces:
parent[a] ← b. Si a ya no era raíz, se corta del árbol en el que estaba, y su conjunto se parte en dos sin que nadie lo pida.
$ g++ -Wall -Wextra -std=c++20 errors/unite_without_find.cpp -o build/unite_without_find && build/unite_without_find
0 y 2: juntos
0 y 1: separados
Se unió 0 con 1 y luego 0 con 2, y al final el 0 y el 1 no están juntos. No hay nada que se caiga: solo una respuesta equivocada.
Primera mejora: unión por rango
Al unir, colgar el árbol más bajo del más alto. Así la altura no cambia, salvo si son iguales, y entonces solo sube 1. Cada raíz guarda un número, su rango (rank), que es una cota de la altura de su árbol. Al principio es 0.
algoritmo unite(a, b)
    raiz_a ← find(a)
    raiz_b ← find(b)
    si raiz_a = raiz_b entonces
        devolver falso
    fin si
    si rango[raiz_a] < rango[raiz_b] entonces
        parent[raiz_a] ← raiz_b
    sino si rango[raiz_b] < rango[raiz_a] entonces
        parent[raiz_b] ← raiz_a
    sino
        parent[raiz_b] ← raiz_a
        rango[raiz_a] ← rango[raiz_a] + 1
    fin si
    devolver verdadero
fin algoritmo
¿Cuánto vale la altura ahora? Una raíz solo llega a rango r si se unen dos árboles de rango r − 1, y cada uno de
esos subió de rango uniendo dos de rango r − 2. Dibujadas, esas uniones forman un árbol binario perfecto de altura r,
como los de la semana 10, y cada una de sus 2^r hojas es un elemento distinto. Entonces un árbol de rango r tiene al
menos 2^r nodos. Con n elementos, r ≤ log₂ n. Mientras no se comprima nada, el rango es exactamente la altura, de modo
que la altura no pasa de ⌊log₂ n⌋, y por tanto find hace como máximo ⌊log₂ n⌋ saltos, en el peor caso. Las pruebas
de CountingForest lo comprueban con 4096 elementos.
Segunda mejora: compresión de caminos
La segunda idea es de otro tipo. Cuando find(x) sube hasta la raíz, ya sabe dónde está la raíz, y ese conocimiento es
caro. Conviene guardarlo: se deja a todos los nodos del camino colgando directamente de la raíz. Así la próxima
pregunta por cualquiera de ellos cuesta un solo salto.
algoritmo find(x)
    raiz ← x
    mientras parent[raiz] ≠ raiz hacer
        raiz ← parent[raiz]
    fin mientras
    mientras x ≠ raiz hacer
        siguiente ← parent[x]
        parent[x] ← raiz
        x ← siguiente
    fin mientras
    devolver raiz
fin algoritmo
Son dos pasadas: la primera encuentra la raíz, y la segunda cuelga a todos de ella. Veámoslo en un árbol. uf_demo hace
siete uniones de árboles iguales, que es el peor armado para ocho elementos, y luego llama a find(7):
$ build/uf_demo
unite(0, 1) parent: 0 0 2 3 4 5 6 7
unite(2, 3) parent: 0 0 2 2 4 5 6 7
unite(0, 2) parent: 0 0 0 2 4 5 6 7
unite(4, 5) parent: 0 0 0 2 4 4 6 7
unite(6, 7) parent: 0 0 0 2 4 4 6 6
unite(4, 6) parent: 0 0 0 2 4 4 4 6
unite(0, 4) parent: 0 0 0 2 0 4 4 6
rangos:  3 0 1 0 2 0 1 0
antes:   0(1,2(3),4(5,6(7)))
altura:  3
find(7) = 0, saltos: 3
despues: 0(1,2(3),4(5),6,7)
parent:  0 0 0 2 0 4 0 0
rangos:  3 0 1 0 2 0 1 0
altura:  2, rango de la raiz: 3
otro find(7), saltos: 1
Esa notación es la de la semana 10: 0(1,2(3)) es un 0 con hijos 1 y 2, donde 2 tiene un hijo, el 3. Dibujado, con sus arreglos:
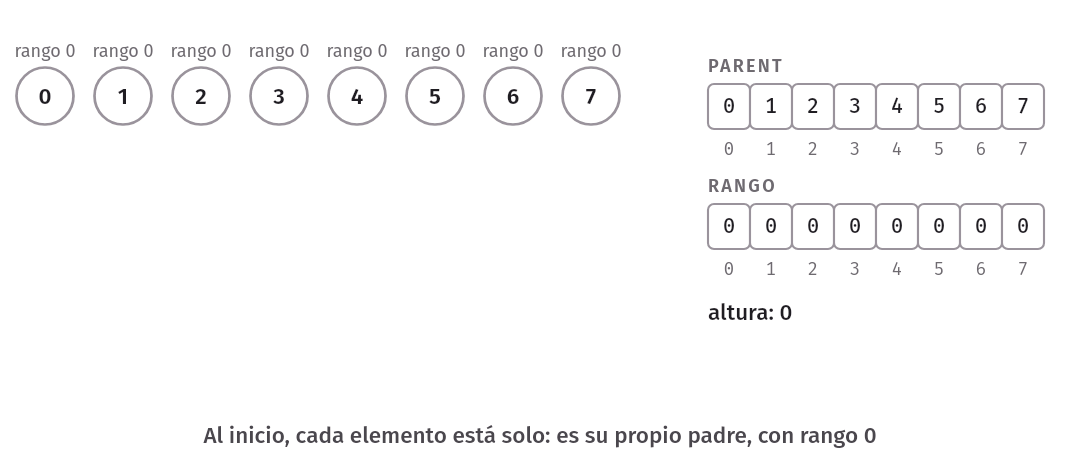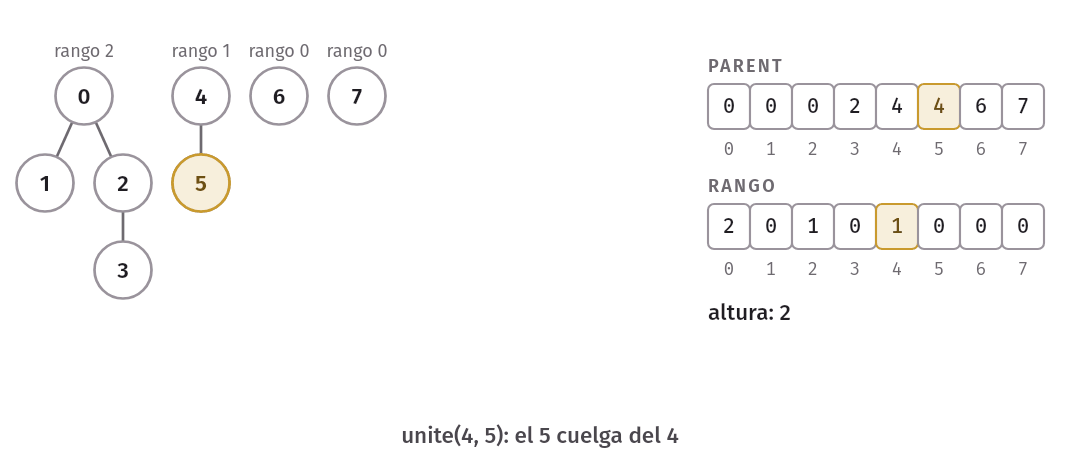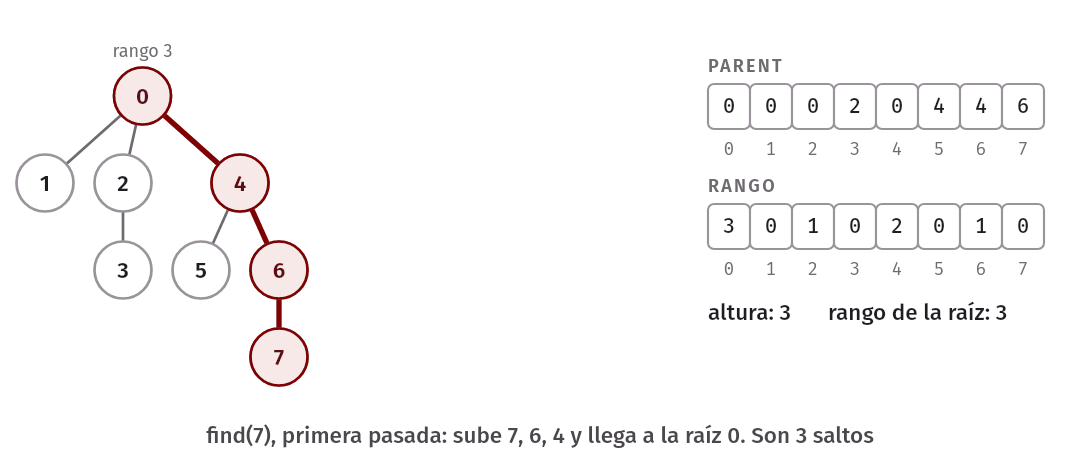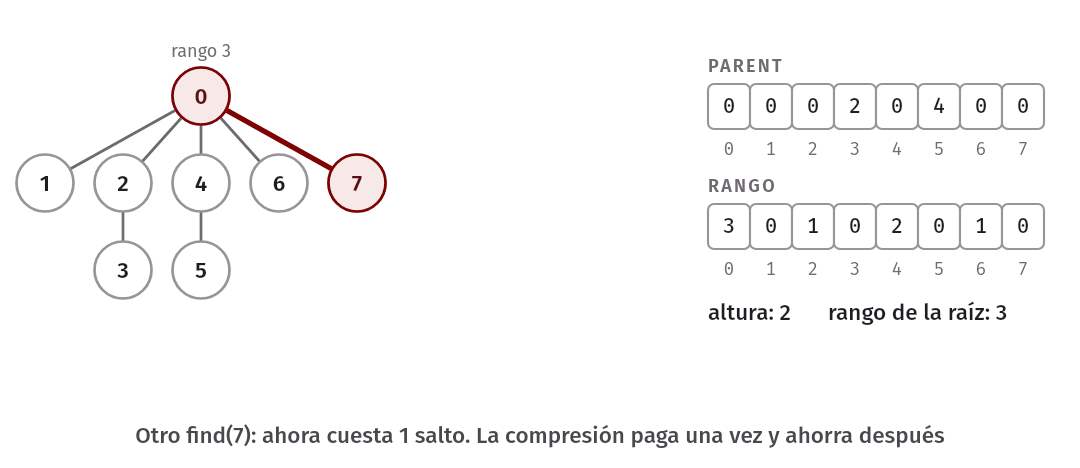
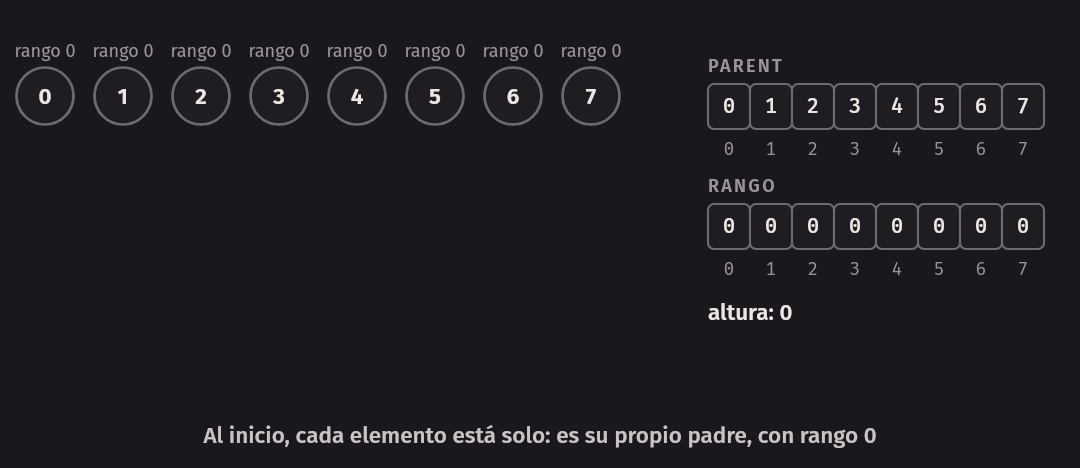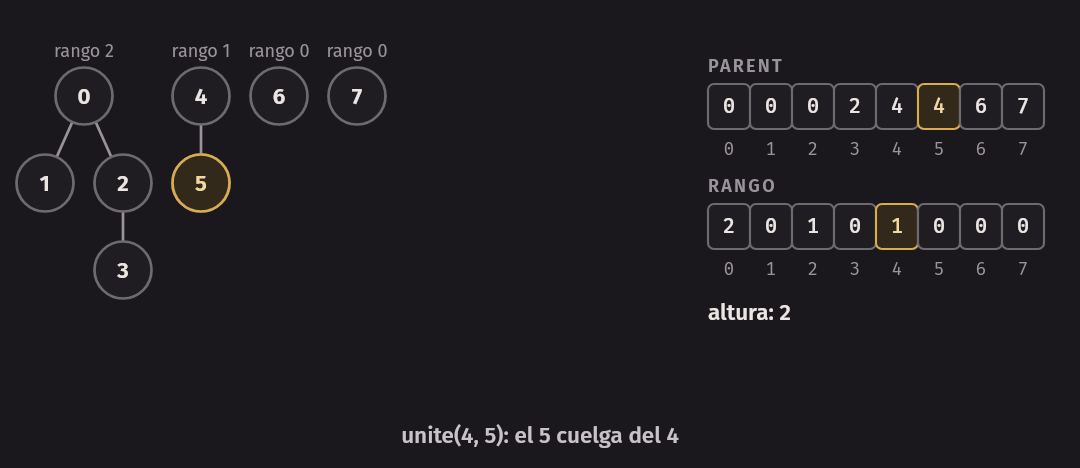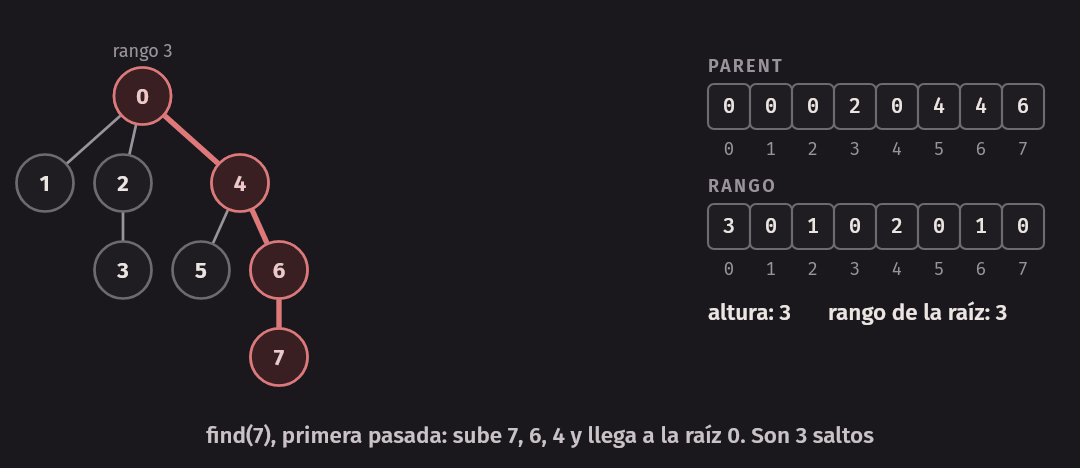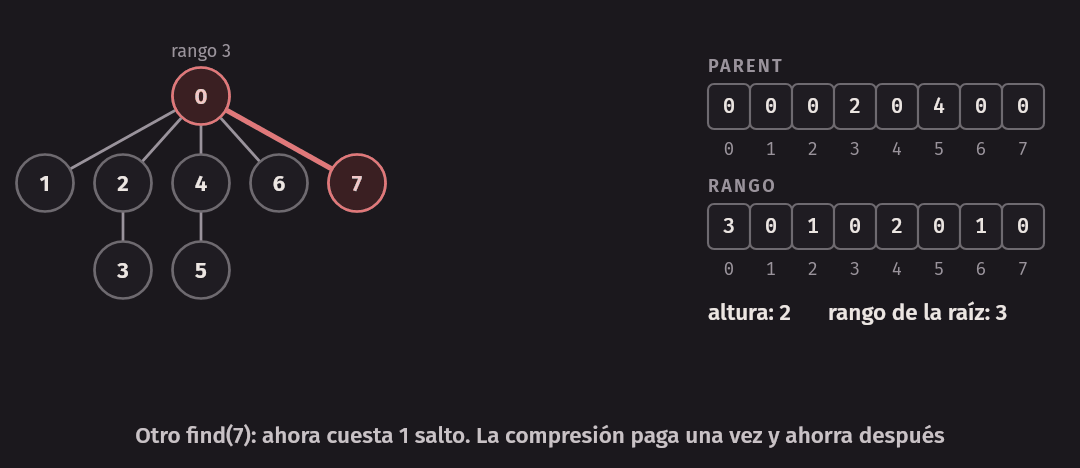
Fíjense en cuatro cosas:
- El 7 y el 6 quedaron colgando de la raíz, y también el 4, que ya lo estaba. El 5 sigue colgando del 4: no estaba en
el camino, y un
findsolo arregla su camino. - Costó 3 saltos, y el siguiente
find(7)solo 1. La compresión es una inversión: paga una vez y ahorra después. - Los rangos no cambiaron. La altura bajó a 2, y el rango de la raíz sigue en 3.
- Y por tanto, con compresión, el rango es una cota de la altura, no la altura. Por eso no se llama altura. Actualizar la altura de verdad obligaría a revisar otras ramas, y justo eso queremos evitar.
La invariante que sí se mantiene es esta: si x no es raíz, rango[x] < rango[parent[x]]. Subir por los padres
siempre sube el rango, y por eso nunca hay ciclos dentro de los árboles.
Cuánto cuesta de verdad
Esta es la parte en la que hay que ser preciso.
Idea clave. Con unión por rango y compresión de caminos, cualquier secuencia de m operaciones sobre n elementos, contando la creación de los n elementos, cuesta O(m · α(n)) en total, en el peor caso. Es un costo amortizado: O(α(n)) por operación, sobre la secuencia completa. Aquí α es la inversa de la función de Ackermann.
Este resultado se enuncia sin demostración. La demostración está en CLRS, en el capítulo Data Structures for Disjoint Sets, y queda fuera de este curso. Lo que sí tienen que poder decir es qué afirma, y qué no:
- Qué es α(n). La función de Ackermann crece de forma explosiva, mucho más rápido que cualquier torre de potencias. Su inversa crece igual de lento. CLRS muestra que α(n) ≤ 4 para cualquier n que pueda aparecer en una computadora real. Por eso se dice “casi constante”.
- No es O(1). α(n) no está acotada: crece sin tope, aunque en la práctica no se note. Es incorrecto escribir que union-find cuesta O(1).
- Es amortizado, no “en promedio”. No hay nada al azar en esa cota. Vale para toda secuencia de operaciones, y
habla de la suma: como en la semana 4 con
push_back, una operación cara se paga con el ahorro de las otras. - Una operación sola puede ser cara. Un solo
findpuede costar Θ(log n), también con las dos mejoras. Lo medimos abajo.
uf_costs cuenta saltos por parent, sin medir tiempo:
$ build/uf_costs
Cadena 0-1, 1-2, 2-3...
variante                          n  altura       saltos  saltos/op
sin mejoras                    1024    1023       523776      255.87
solo rango                     1024       1         2045        1.00
solo compresion                1024    1023         2045        1.00
rango y compresion             1024       1         2045        1.00
sin mejoras                   16384   16383    134209536     4095.87
solo rango                    16384       1        32765        1.00
solo compresion               16384   16383        32765        1.00
rango y compresion            16384       1        32765        1.00

Al azar, 4n operaciones
variante                          n  altura       saltos  saltos/op
solo rango                     1024       5         8757        2.14
rango y compresion             1024       2         5070        1.24
solo rango                    16384       6       144390        2.20
rango y compresion            16384       2        81257        1.24
solo rango                   262144       7      2371160        2.26
rango y compresion           262144       3      1303254        1.24
solo rango                  1048576       8      9529179        2.27
rango y compresion          1048576       3      5210516        1.24

Un solo find en el peor arbol, con las dos mejoras
        n  log2 n  primer find  segundo find
     1024      10           10             1
    16384      14           14             1
   262144      18           18             1
  1048576      20           20             1
La cadena es el desastre sin mejoras: la secuencia hace n − 1 uniones y n preguntas, y sin mejoras los find del
final suman exactamente n(n − 1)/2 saltos, porque el nodo i está a n − 1 − i saltos de la raíz. Con cualquiera de las
dos mejoras, baja a un salto por operación. Solo con compresión, el árbol llega a tener altura 1023, pero el primer
find recorre esa cadena una vez y la aplana, y los demás cuestan muy poco. Solo con rango, la cadena nunca llega a
existir: cada elemento nuevo cuelga directo de la raíz.
Al azar, las dos columnas de saltos por operación casi no se mueven al multiplicar n por 1024: 1.24 con las dos mejoras, y de 2.14 a 2.27 solo con rango. Cuidado con lo que se concluye: esa tabla no demuestra la cota de α(n). Son operaciones al azar, que no son el peor caso, y es imposible ver un α(n) en una medición, porque no se mueve. Solo dice que, en esta prueba, comprimir ahorra casi la mitad de los saltos.
El peor árbol es lo que advertimos. Uniones de árboles iguales dan altura log₂ n, y el primer find del nodo más
hondo cuesta log₂ n saltos, con las dos mejoras. Solo el segundo cuesta 1. El bajo costo es de la secuencia.
Union-find frente a DFS
Ya tenemos dos formas de responder “¿están conectados a y b?”. La pregunta interesante es cuándo gana cada una.
online_connectivity toma las aristas de Miraflores en orden al azar. Por cada una que llega, la agrega y hace una
pregunta sobre dos nodos al azar, respondida de las dos maneras. El programa comprueba que las dos respuestas
coincidan, y cuenta el trabajo:
$ build/online_connectivity ../../data/mapas/miraflores.txt
nodos: 2242, aristas que llegan: 3474, preguntas: 3474
respuestas si: 1143 (todo unido tras la arista 3417)
DFS en cada pregunta, entradas leidas: 3769130
union-find, saltos por parent: 11270
por pregunta: DFS 1084.95, union-find 3.2441
todas primero: una pasada lee 6948 entradas, y cada pregunta compara dos etiquetas: conectados
Unas 330 veces menos trabajo en estas 3474 preguntas, y la cuenta de union-find incluye las uniones. Las dos
unidades se parecen, porque una es leer una entrada y la otra es leer un parent. Y el resultado tiene sentido: un
DFS repite todo lo que ya había descubierto el anterior, y union-find lo guarda.
La última línea dice lo otro. Si todas las aristas están desde el principio, una sola pasada con component_labels
lee 6948 entradas, y luego cada pregunta se responde comparando dos etiquetas en Θ(1). Eso es mejor que union-find,
porque no hay que subir por ningún árbol. Union-find no gana porque sea más rápido en general: gana porque no le
molesta que el grafo cambie.
| DFS o BFS | Union-find | |
|---|---|---|
| ¿Conectados? Con todas las aristas de antemano | Una pasada y Θ(1) por pregunta: lo mejor | Sirve, pero sobra |
| ¿Conectados? Con aristas que van llegando | Hay que repetir la búsqueda | O(α(n)) amortizado |
| Dar el camino | Sí, con padres | No: solo dice sí o no |
| Quitar una arista | Se quita de la lista y se busca otra vez | No se puede |
| Memoria | Las aristas, más marcas | Solo dos arreglos de n: no guarda las aristas |
| Distancias | BFS, sí | No |
Idea clave. Si las conexiones van llegando una a una y solo les importa si hay conexión, usen union-find. Si necesitan un camino, o van a quitar aristas, necesitan el grafo.
Generar un laberinto
Hay una bonita aplicación de todo esto. Piensen en una cuadrícula de celdas, con paredes entre todas las vecinas. Un laberinto perfecto es uno en el que, entre dos celdas cualesquiera, hay exactamente un camino. Todo se alcanza y no hay rutas alternativas.
Tratemos cada celda como un nodo, y cada pared derribada como una arista. Un laberinto perfecto es entonces un grafo conexo y sin ciclos: un árbol. La pregunta para generarlo, cada vez que miramos una pared, es justo la que responde union-find: ¿las dos celdas a los lados de esta pared ya están conectadas?
algoritmo generar(laberinto)
    paredes ← todas las paredes, en orden al azar
    regiones ← un union-find con una región por celda
    para cada pared (a, b) de paredes hacer
        si regiones.unite(a, b) entonces
            abrir la pared (a, b)
        fin si
    fin para
fin algoritmo
unite ya devuelve lo que necesitamos: verdadero si estaban separadas. Si ya estaban conectadas, derribar la pared
crearía un ciclo, así que se deja de pie.
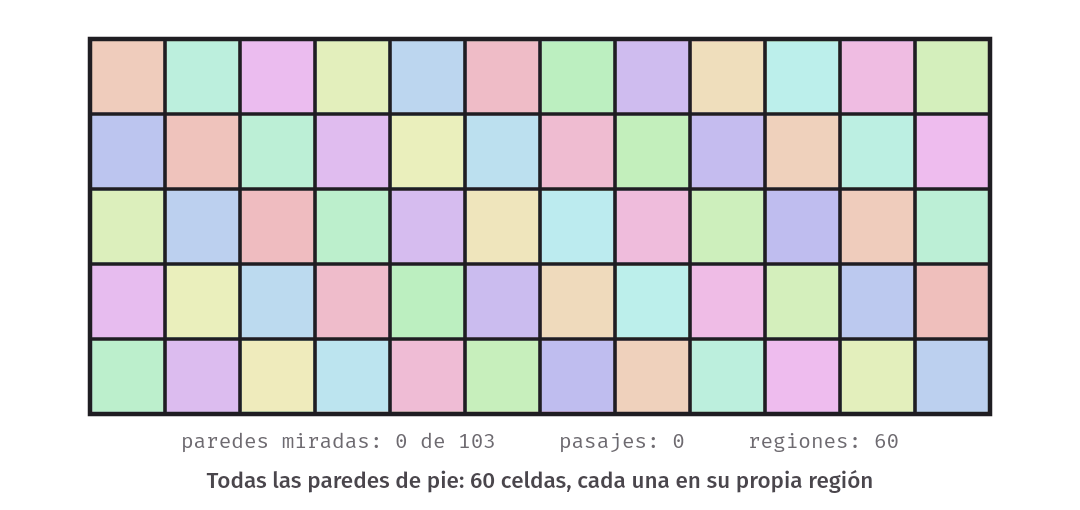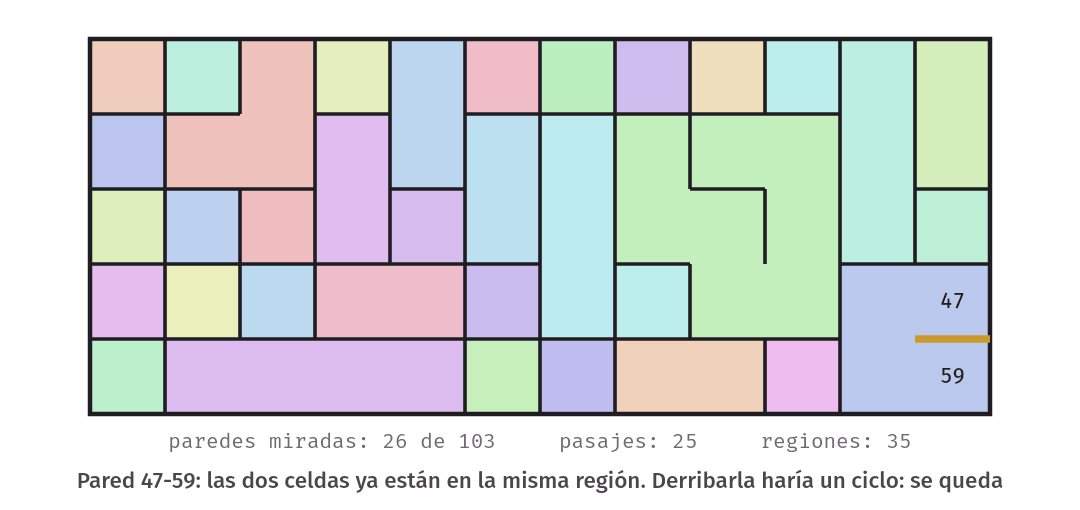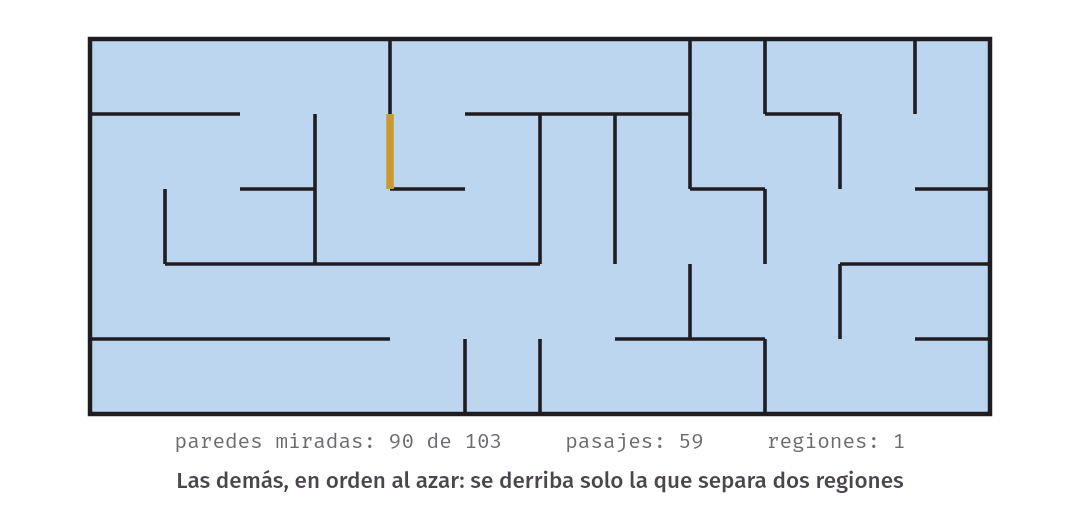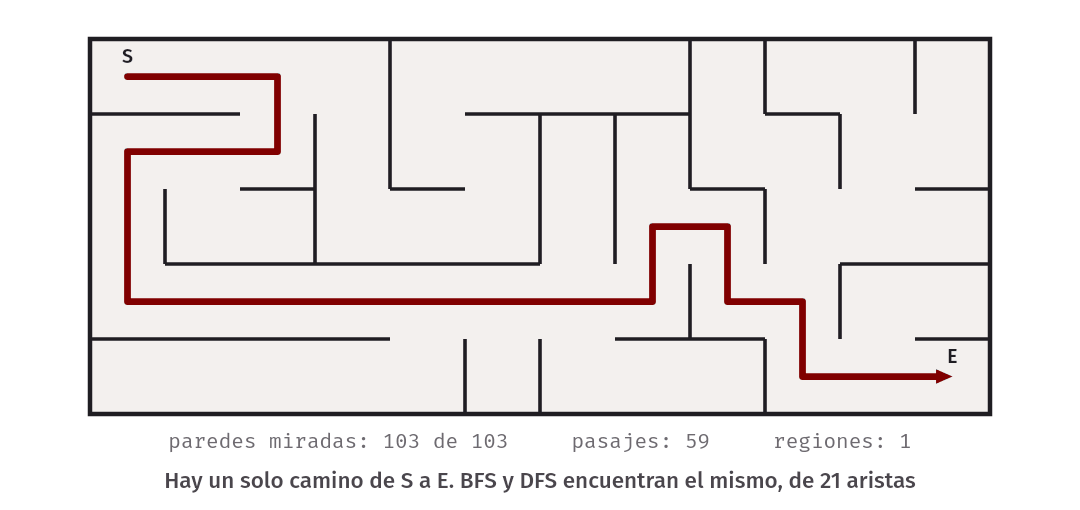
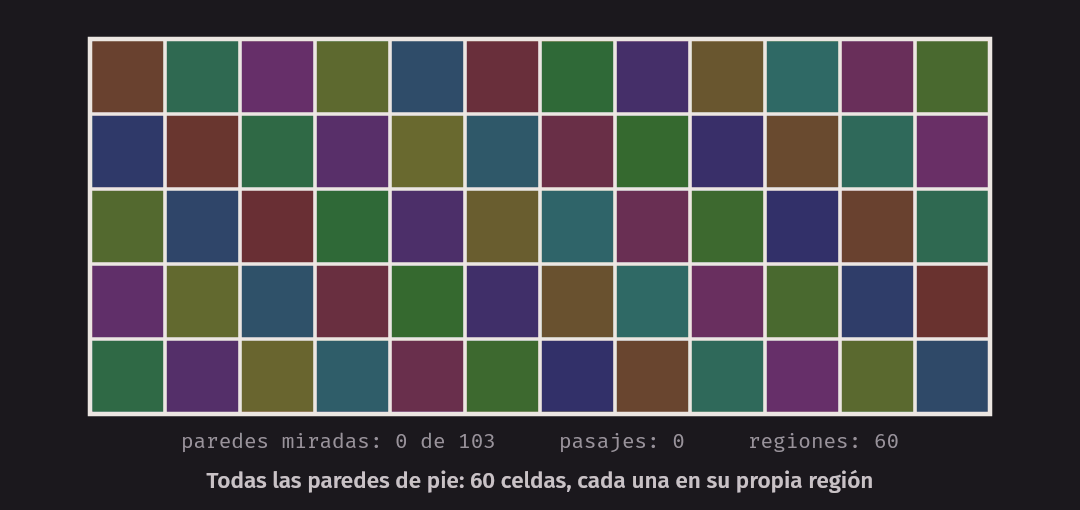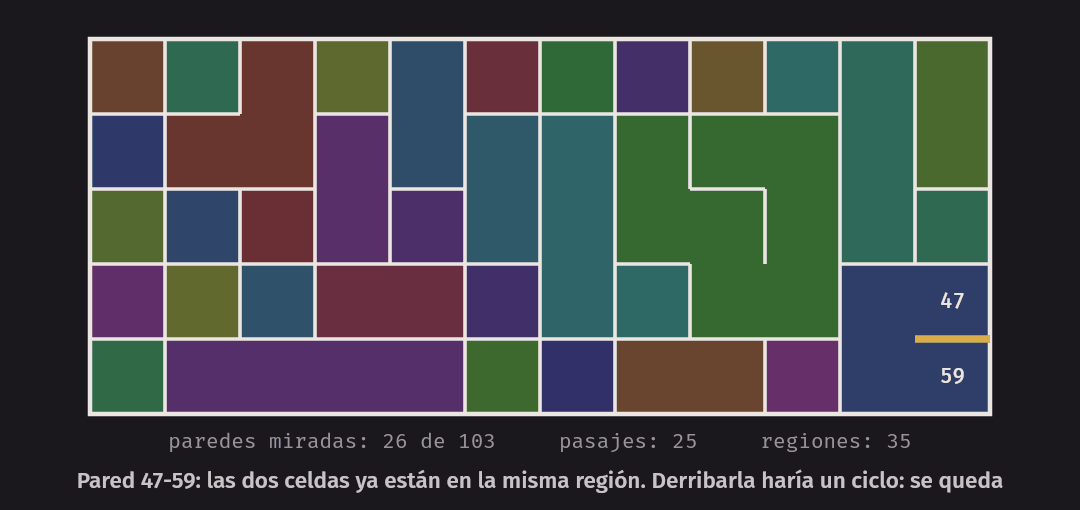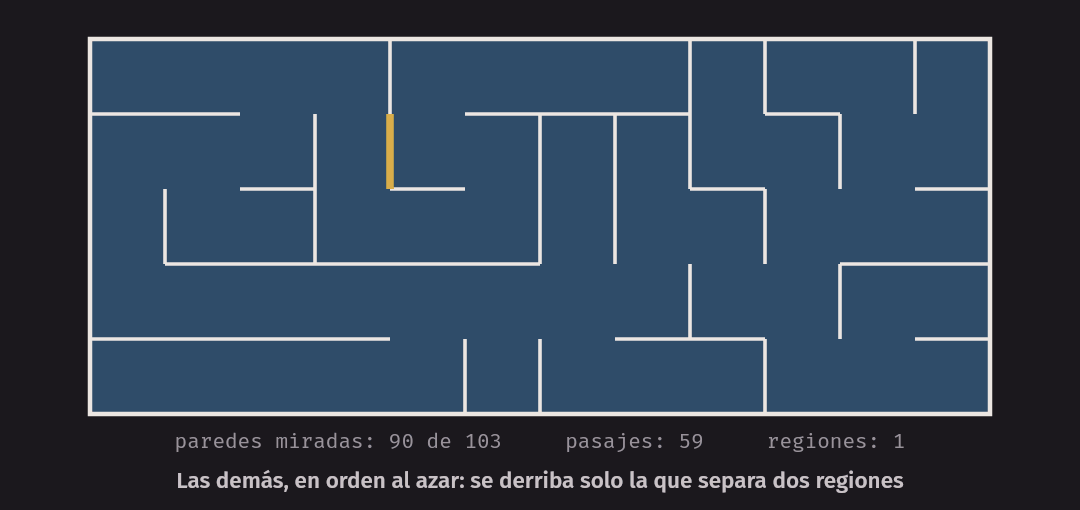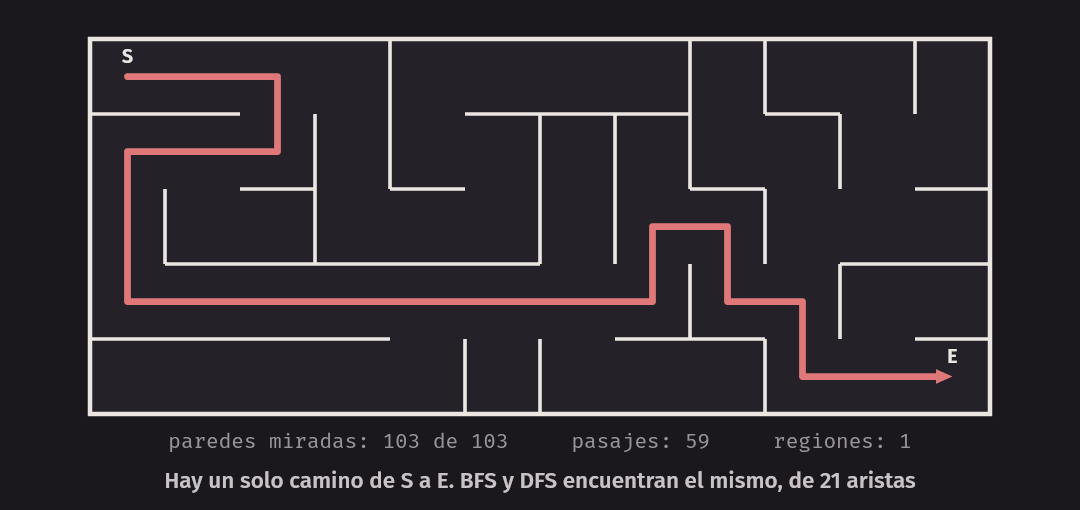
¿Por qué el resultado tiene exactamente un camino entre dos celdas cualesquiera? Se necesitan dos cosas.
Hay al menos un camino. Tomen dos celdas vecinas. Al final, tienen que estar en la misma región: cuando se miró la pared entre ellas, o ya estaban en la misma región, o se derribó y quedaron en la misma. Y las regiones solo crecen, nunca se parten. Si todas las vecinas están en la misma región, y de cualquier celda se llega a cualquier otra por vecinas, toda la cuadrícula es una sola región: hay camino entre cualquier par.
Hay como máximo uno. Una pared solo se derriba si separa dos regiones sin ninguna conexión. Así que esa arista nueva nunca cierra un ciclo, porque para cerrarlo ya tendría que haber otro camino entre sus dos lados. Sin ciclos, no puede haber dos caminos distintos entre dos celdas: si los hubiera, se sigue uno hasta donde se separa del otro, y se vuelve por el otro desde donde se juntan, y eso es un ciclo.
Se puede contar además: se empieza con N regiones, se termina con 1, y cada pared derribada baja la cuenta en 1. Un laberinto de N celdas siempre tiene exactamente N − 1 pasajes, igual que todo árbol de N nodos. Las pruebas del laboratorio comprueban justo esas dos cosas.
Y esto tiene una consecuencia para el laboratorio, que es fácil de pasar por alto. Si entre dos celdas hay un solo
camino, BFS y DFS tienen que encontrar el mismo. La guía del laboratorio pide comparar el largo de los dos
caminos, y en un laberinto perfecto esa comparación siempre da empate. Lo que sí cambia es cuántas celdas visitó cada
uno antes de llegar. Por eso el laboratorio da una función más, open_extra_walls, que después de generar derriba
algunas paredes al azar. Con eso aparecen ciclos, y hay caminos distintos que comparar.
Así queda un laberinto al terminar el laboratorio, primero perfecto y después con paredes extra. Un * es el camino,
y un . es una celda visitada que no quedó en el camino:
$ build/solution/maze 12 5 3
BFS: camino de 21 aristas, 54 nodos visitados
+--+--+--+--+--+--+--+--+--+--+--+--+
|SS ** ** ..|.. .. .. ..|  |     |  |
+--+--+  +  +  +--+--+--+  +--+  +  +
|** ** **|..|.. ..|..|..|.. ..|..   |
+  +  +--+  +--+  +  +  +--+  +  +--+
|**|.. ..|.. .. ..|..|** **|.. .. ..|
+  +--+--+--+--+--+  +  +  +  +--+--+
|** ** ** ** ** ** ** **|** **|..   |
+--+--+--+--+  +  +  +--+--+  +  +--+
|.. .. .. .. ..|..|.. .. ..|** ** EE|
+--+--+--+--+--+--+--+--+--+--+--+--+
DFS: camino de 21 aristas, 38 nodos visitados
+--+--+--+--+--+--+--+--+--+--+--+--+
|SS ** **   |           |..|.. ..|..|
+--+--+  +  +  +--+--+--+  +--+  +  +
|** ** **|  |     |..|..|.. ..|.. ..|
+  +  +--+  +--+  +  +  +--+  +  +--+
|**|     |        |..|** **|.. .. ..|
+  +--+--+--+--+--+  +  +  +  +--+--+
|** ** ** ** ** ** ** **|** **|.. ..|
+--+--+--+--+  +  +  +--+--+  +  +--+
|              |  |        |** ** EE|
+--+--+--+--+--+--+--+--+--+--+--+--+
$ build/solution/maze 12 5 3 8
BFS: camino de 15 aristas, 57 nodos visitados
+--+--+--+--+--+--+--+--+--+--+--+--+
|SS ** ** ..|.. .. .. .. ..|.. | |
+--+--+ + + +--+--+--+ + + + +
|.. .. ** ..|.. ..|.. ..|.. ..|.. |
+ + + + +--+ + + +--+ + +--+
|..|.. **|.. .. ..|..|.. ..|.. .. ..|
+ +--+ +--+--+--+ + + + +--+--+
|.. .. ** ** ** ** ** ** ** ** .. ..|
+--+--+--+--+ + + +--+--+ + +--+
|.. .. .. .. ..|..|.. .. ..|** ** EE|
+--+--+--+--+--+--+--+--+--+--+--+--+
DFS: camino de 23 aristas, 48 nodos visitados
+--+--+--+--+--+--+--+--+--+--+--+--+
|SS ** ** ..|.. .. .. .. ..|.. ..|..|
+--+--+ + + +--+--+--+ + + + +
|** ** ** ..|.. ..|** **|.. ..|.. ..|
+ + + + +--+ + + +--+ + +--+
|**| |.. .. ..|**|** **|.. .. ..|
+ +--+ +--+--+--+ + + + +--+--+
|** ** ** ** ** ** ** ** ** .. ..|
+--+--+--+--+ + + +--+--+ + +--+
| | | |** ** EE|
+--+--+--+--+--+--+--+--+--+--+--+--+Sin paredes extra, el camino es el mismo: los dos tienen 21 aristas, y solo cambian las celdas visitadas. Con 8 paredes extra, BFS encontró un atajo de 15 aristas, y DFS se quedó con el primero que vio, de 23.
Este generador tiene nombre: si en lugar de un orden al azar se ordenan las aristas por peso, es el algoritmo de Kruskal, que construye un árbol de cubrimiento mínimo. Lo verán en Algoritmos.
El código de la semana
En code/week-14:
| Archivo | Qué contiene |
|---|---|
graph.h, matrix_graph.h |
Las dos representaciones |
traversals.h, sample_graphs.h |
BFS, DFS, caminos, componentes y ciclos, y el grafo de la clase |
bfs_trace.cpp, dfs_demo.cpp |
Los recorridos paso a paso, y lo que responden |
representations.cpp |
Memoria y lecturas de cada representación |
map_file.h, map_tour.cpp, bfs_scaling.cpp, bench.h |
Los mapas reales. Las mediciones usan -O2 y no usan sanitizers |
counting_forest.h, uf_demo.cpp, uf_costs.cpp |
Un bosque que cuenta saltos, con cada mejora opcional |
online_connectivity.cpp |
Union-find frente a DFS, con aristas que van llegando |
test_structures.cpp |
Pruebas dirigidas y al azar, contra cálculos por fuerza bruta |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo. Eso incluye volver a correr los comandos de este capítulo. Las mediciones
no se comparan, porque dependen de la máquina. Lo que se compara son conteos, como las entradas leídas y los saltos.
El laboratorio
Esta semana solo hay una sesión de laboratorio, porque la otra es la Práctica 4. Por eso viene mucho hecho. No
tienen que escribir Graph, el dibujo ni las pruebas: solo las partes que son el tema de la semana.
| Paso | Qué escriben | Dónde | Tiempo estimado |
|---|---|---|---|
| 1 | UnionFind: constructor, find, unite, connected |
lab/union_find.h |
30 min |
| 2 | generate_maze |
lab/maze.h |
15 min |
| 3 | maze_graph, bfs_search, dfs_search |
lab/solver.h |
50 min |
| 4 | Correr, dibujar, comparar y responder | lab/report.md |
25 min |
make lab           # compila el laboratorio
make test-uf        # paso 1: contra la versión ingenua
make test-maze      # paso 2: el generador
make test-search    # paso 3: el grafo, BFS y DFS
make test-lab       # todo
make compare        # paso 4: la tabla para su informe
build/lab/maze 30 12 7       # un laberinto de 30 x 12 con semilla 7
build/lab/maze 30 12 7 25    # el mismo, con 25 paredes extra
Algunas cosas que conviene saber antes de empezar:
- Vienen hechos
Graph,NaiveUnionFind, la claseMazeconall_walls,open,passagesyrender, y tambiénshuffle_wallsyopen_extra_walls. Usenshuffle_walls, y nostd::shuffle: el resultado destd::shuffledepende de la biblioteca, y así su laberinto será igual en cualquier máquina con la misma semilla. check_invariantsviene hecha enUnionFind, yparent_ofyrank_ofleen sin comprimir. Las pruebas las usan para mirar la forma del árbol. Revisan que la altura no pase de log₂ n, que el rango suba solo en empates, y que todo el camino quede colgando de la raíz, no solo el primero. Hay una versión de la compresión llamada path halving, que también es buena, pero no es la que se pide y las pruebas la rechazan.- Las dos búsquedas marcan igual y paran igual.
visitedson los nodos marcados, en orden de marca y sin repetir, y las dos se detienen apenas marcan el destino. En BFS eso es seguro, porque la distancia de un nodo ya es la definitiva al marcarlo. Tengan presente que esta frase no valdrá la próxima semana con Dijkstra. dfs_searchlleva pila propia. Una prueba corre un pasillo de 6000 celdas con solo 128 KB de pila. Partan dedfs_iterative: el camino es lo que queda en la pila al llegar.- Recorran los vecinos en el orden de la lista, y armen
maze_graphen el orden demaze.passages(). Las pruebas comparan contra un orden exacto en grafos chicos. - Una prueba de
bfs_searchcorre 40 rombos seguidos. Si marcan al sacar, no termina a tiempo. Ahora saben por qué.
Resumen
- Un grafo son nodos y aristas: dirigido o no, con pesos o sin ellos. La suma de los grados de uno no dirigido es 2E.
- La matriz de adyacencia gasta Θ(V²) memoria y responde
has_edgeen Θ(1). Las listas de adyacencia gastan Θ(V + E) y dan los vecinos en Θ(grado). Casi todo grafo real es disperso, y se usan listas. Miraflores usa el 0.14 % de las aristas posibles. - BFS usa una cola, recorre por niveles, y da el camino con menos aristas, porque las distancias salen en orden. No minimiza metros.
- Se marca al meter a la cola. Marcar al sacar deja distancias mal, y la cola puede crecer de forma exponencial.
- DFS baja todo lo posible, con recursión o con una pila de marcos. Da componentes y ciclos, y no garantiza el camino más corto. La recursión puede agotar la pila en un camino largo.
- Los ciclos en un grafo no dirigido se ven con un nodo marcado que no es el padre. En uno dirigido hacen falta tres colores.
- Los dos recorridos cuestan Θ(V + E) si tocan todo el grafo. Un camino se reconstruye con los padres.
- Union-find responde “¿están conectados?” con un bosque en un arreglo. Unión por rango limita la altura a
⌊log₂ n⌋, y compresión de caminos cuelga de la raíz todo lo que
findrecorre. - Con las dos mejoras, m operaciones cuestan O(m · α(n)) en total. Es amortizado, no es O(1), y un solo
findpuede costar Θ(log n). α(n) ≤ 4 para todo n que quepa en una computadora. - Con todas las aristas de antemano, una pasada y etiquetas son lo mejor. Con aristas que van llegando, gana union-find. No da caminos ni deja quitar aristas.
- Un laberinto generado así es un árbol: N − 1 pasajes y un solo camino entre dos celdas. Por eso BFS y DFS dan el mismo camino hasta que se abren paredes extra.
Una pregunta para la próxima clase: BFS encontró una ruta de 18 aristas y 1871 metros. ¿Puede haber otra con más aristas y menos metros? ¿Qué tendría que cambiar en BFS para encontrarla?
Ejercicios
- Dibujen un grafo de 6 nodos y 7 aristas. Escriban su matriz y sus listas. Corran BFS a mano desde un nodo, con la
cola en cada paso, como en la tabla de
bfs_trace, y luego DFS. Comprueben sus respuestas cambiandoclass_graphensample_graphs.h. - Con un byte por celda en la matriz, y con 8 bytes por entrada y 24 por nodo en las listas, sin capacidad sobrante, ¿para cuántas aristas ocupan lo mismo, si hay 10 000 nodos? ¿Y escrito en función de V? ¿Qué cambia con un bit por celda?
- Sigan a mano
errors/bfs_mark_on_pop.cppcon 2 rombos, sinskip_marked, y expliquen de dónde salen las 13 entradas. ¿Por qué la cuenta se duplica en cada cruce? - Un grafo no dirigido es bipartito si sus nodos se pueden pintar de dos colores, sin aristas entre nodos del
mismo color. Escriban
is_bipartitepara un grafo conexo con BFS, usandodistance % 2. Comprueben que un ciclo de 6 nodos lo es, y que uno de 5 no. ¿Por qué basta con revisar cada arista al final? ¿Qué cambia si no es conexo? - Un grafo no dirigido sin ciclos, con V nodos y C componentes, tiene exactamente V − C aristas. Escriban
has_cycleusando solocomponent_labelsy esa fórmula. ¿Qué tiene de mejor y de peor frente ahas_cycle_undirected?test_structures.cppusa esta idea. - Cambien
stack_searchpara que meta los vecinos en orden inverso, y comprueben con grafos al azar que entonces da el mismo orden quedfs_recursive. Aun así, su pila no representa un camino: muestren un momento del grafo de la clase en que tenga un nodo que no está en el camino actual. ¿Por qué eso impide usarla enhas_cycle_directed? - Sobre
lima-sur.txt, quiten todas las aristas de más de 100 metros, y cuenten las componentes concomponent_labels. ¿Cuál es la mayor? Repitan para 50 y 200 metros. Tomen en cuenta que el archivo guarda una sola componente. - Con
has_cycle_directedcomo base, escribantopological_order: el orden en que los nodos pasan a negro, al revés. Pruébenlo con las dependencias de un Makefile pequeño. ¿Qué pasa si hay ciclo? - Cambien la unión por rango por unión por tamaño en
CountingForest: cada raíz guarda cuántos elementos tiene, y el árbol menor cuelga del mayor. Corranuf_costs. ¿Sigue valiendo que la altura es como máximo log₂ n? Den el argumento, contando cuántas veces puede duplicarse el tamaño del conjunto de un elemento. - Escriban
has_cyclecon suUnionFind: recorran las aristas, y siunitedevuelve falso, hay ciclo. Compárenlo conhas_cycle_undirected. ¿Qué pasa aquí con las aristas repetidas? ¿Y si el grafo es dirigido? - Union-find no puede quitar aristas. Supongan que las calles de Miraflores se van cerrando una a una, y después de cada cierre preguntan si dos nodos siguen conectados. Conociendo de antemano todos los cierres, ¿cómo lo resolverían con union-find? Pista: piensen el tiempo al revés. Escríbanlo.
- Modifiquen
lab/tests/compare_mazes.cpppara correr 100 semillas. Sin paredes extra, ¿con qué frecuencia visita DFS menos nodos que BFS? ¿Y con 5 %, 25 % de paredes extra? Antes de concluir, repitan con dos tamaños de cuadrícula. ¿Qué parte de lo que observan depende del orden de los vecinos? Pruébenlo cambiando el orden enmaze_graph.