Apuntes · Capítulo 15Prioridades y grafos
Caminos mínimos y cierre
Caminos mínimos y cierre
La semana pasada recorrimos grafos sin mirar cuánto pesaba cada arista. BFS encontró una ruta de 18 aristas y 1871 metros entre dos puntos de Miraflores, y la clase terminó con una pregunta: ¿puede haber otra con más aristas y menos metros? Sí la hay, y encontrarla es el trabajo de hoy.
Esta es la última semana con temas nuevos, y usa casi todo lo anterior. Dijkstra es un algoritmo muy corto, porque
el trabajo lo hacen tres estructuras que ya tienen: las listas de adyacencia de la semana 14, un arreglo de distancias y
su MinHeap de la semana 13. En el laboratorio, con él, calcularán rutas sobre el mapa real de Lima.
Después vienen dos temas opcionales, marcados con ✂️: los tries y los filtros de Bloom. Cierra un repaso: cómo elegir una estructura según las operaciones que un problema necesita. Eso mismo les pedirá el examen final, en la semana 16.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatorio): Con pesos, BFS ya no alcanza y Relajar una arista. Si no la tienen fresca, repasen también BFS: recorrer por niveles de la semana 14.
- En clase: Dijkstra, Entradas viejas, Dónde detenerse, Otros tres errores que dan rutas falsas, Pesos negativos, El costo, ✂️ Tries, ✂️ Filtros de Bloom y Repaso: elegir una estructura. Tries y filtros de Bloom se ven solo si alcanza el tiempo; si no, pasan a después de clase.
- Después de clase: repasen con el Resumen y los Ejercicios, y lean Rutas largas, y lo que dicen, Cómo se prueba un Dijkstra y El código de la semana. Opcional: Open Data Structures, cap. 12, para la representación de grafos; CLRS, capítulo Single-Source Shortest Paths, la sección de Dijkstra. Sobre Dijkstra, tries de cadenas y filtros de Bloom, estos apuntes son el texto principal.
Código. Los programas de este capítulo están en
code/week-15. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Con pesos, BFS ya no alcanza
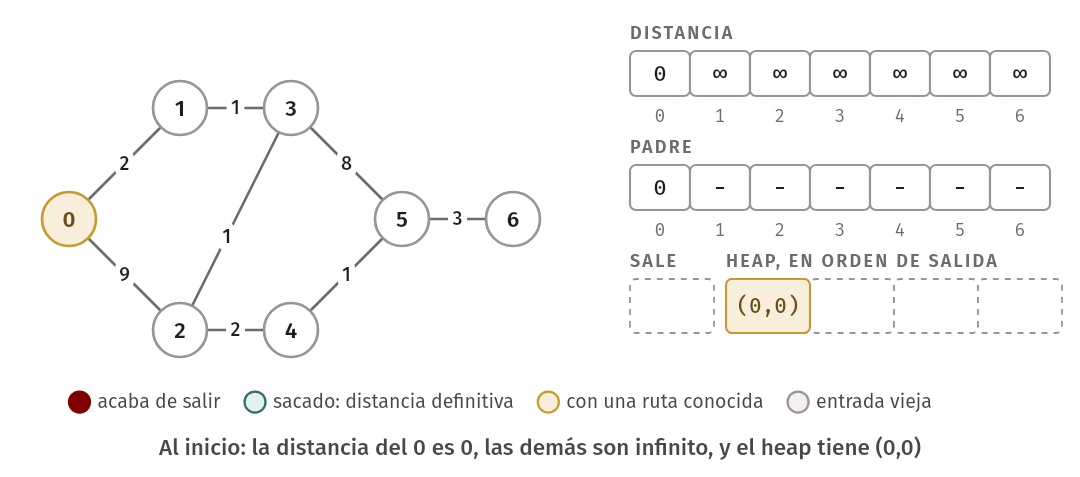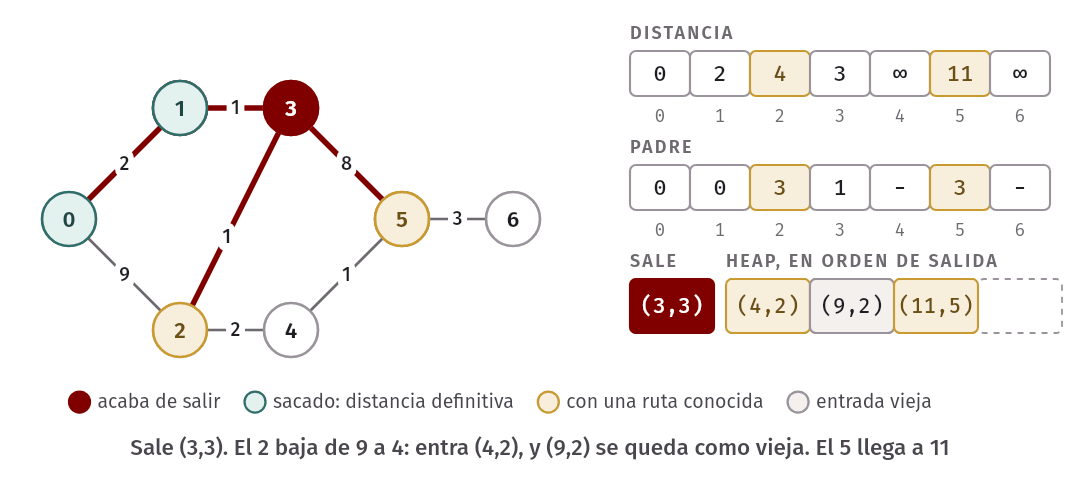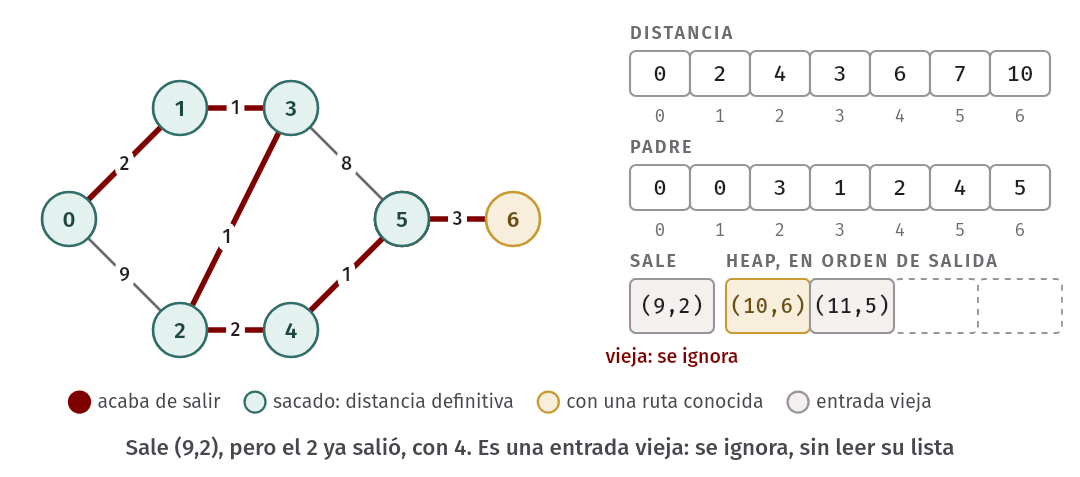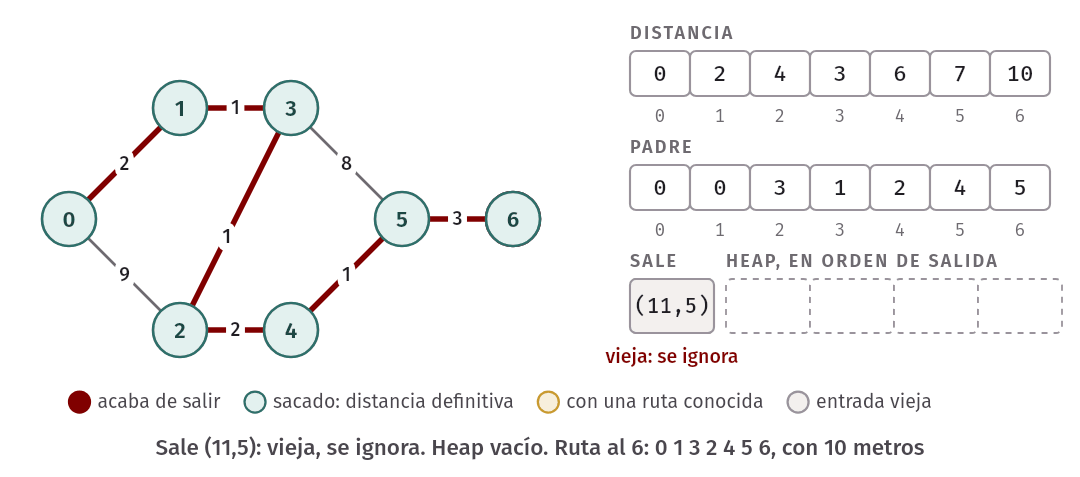
Tomemos el grafo de la clase de la semana 14, con los mismos 7 nodos y las mismas 8 aristas, y pongámosle pesos. Piensen que son metros:
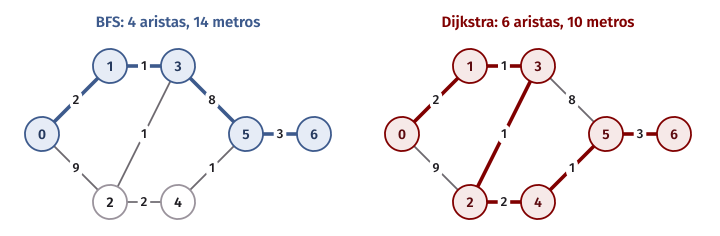
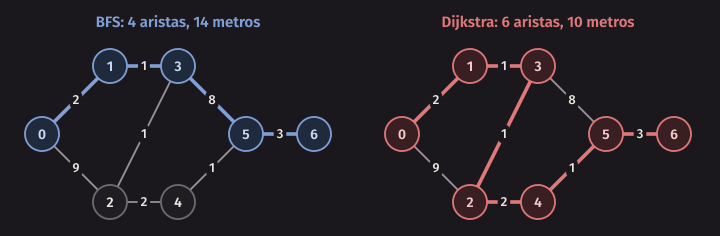
Las aristas son 0-1 (2), 0-2 (9), 1-3 (1), 2-3 (1), 2-4 (2), 3-5 (8), 4-5 (1) y 5-6 (3).
Definición. El peso de un camino es la suma de los pesos de sus aristas. Un camino mínimo (shortest path) de s a t es un camino de s a t cuyo peso es el menor posible. La distancia de s a t es ese peso. Puede haber varios caminos mínimos, todos con el mismo peso.
Hasta hoy, “distancia” quería decir cantidad de aristas. Desde hoy, en un grafo con pesos, es la suma de los pesos. BFS sigue respondiendo lo mismo que antes, porque no mira los pesos. Dijkstra responde la pregunta nueva:
$ build/dijkstra_trace | tail -4
ruta de Dijkstra a 6: 0 1 3 2 4 5 6
  aristas: 6, metros: 10
ruta de BFS a 6: 0 1 3 5 6
  aristas: 4, metros: 14
BFS da 4 aristas y 14 metros. El mínimo son 6 aristas y 10 metros: el camino con menos aristas no es el más corto.
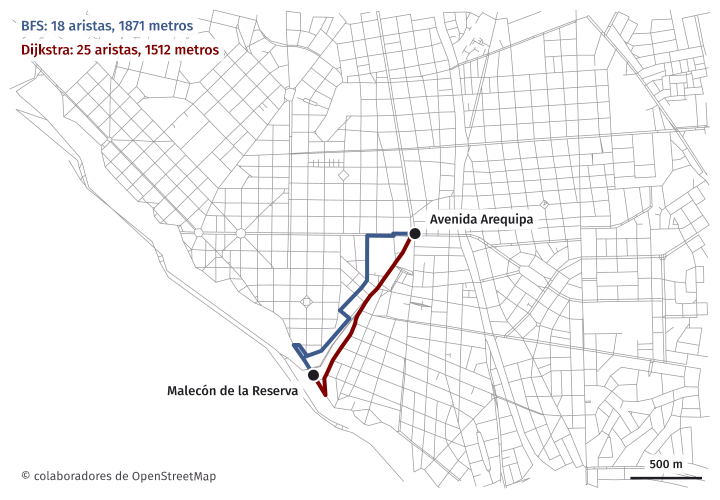
No es una rareza de un grafo inventado. Estos son los dos mismos puntos de la semana pasada, en Malecón de la Reserva y
Avenida Arequipa. route_demo toma los nombres de las calles y busca sus nodos en miraflores-calles.tsv:
$ build/route_demo ../../data/mapas/miraflores.txt ../../data/mapas/miraflores-calles.tsv "Malecón de la Reserva" "Avenida Arequipa"
de Malecón de la Reserva (nodo 1839) a Avenida Arequipa (nodo 1883)
linea recta: 1215 metros
BFS:      18 aristas, 1871 metros
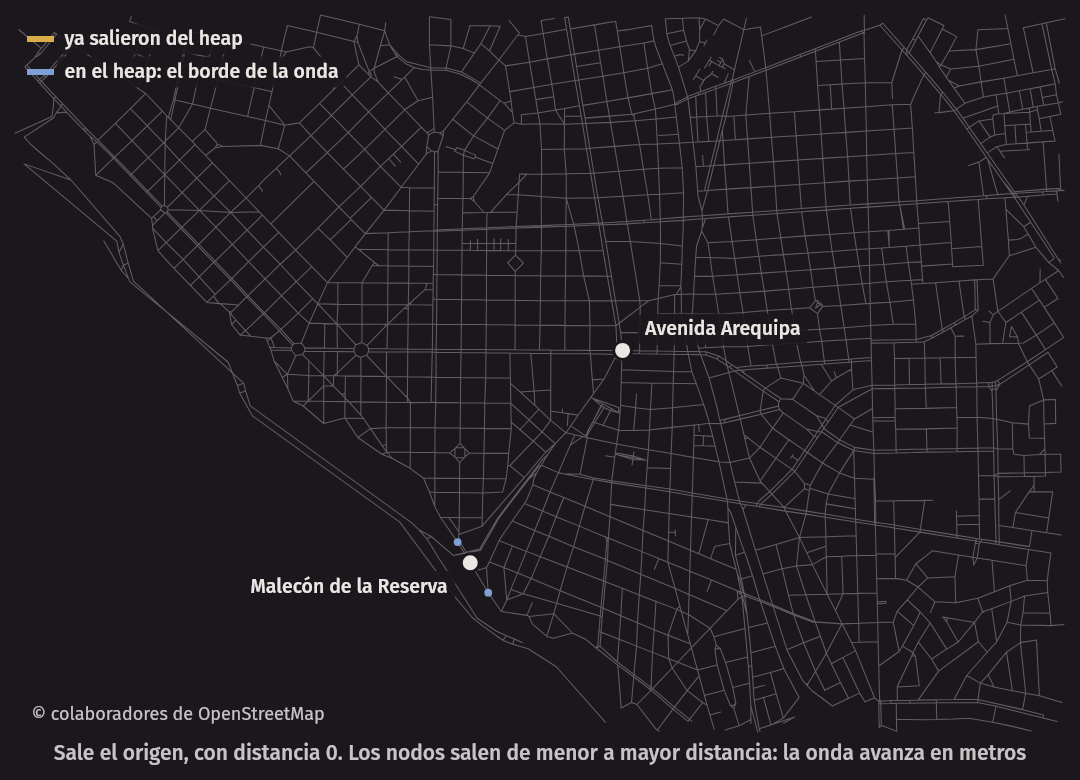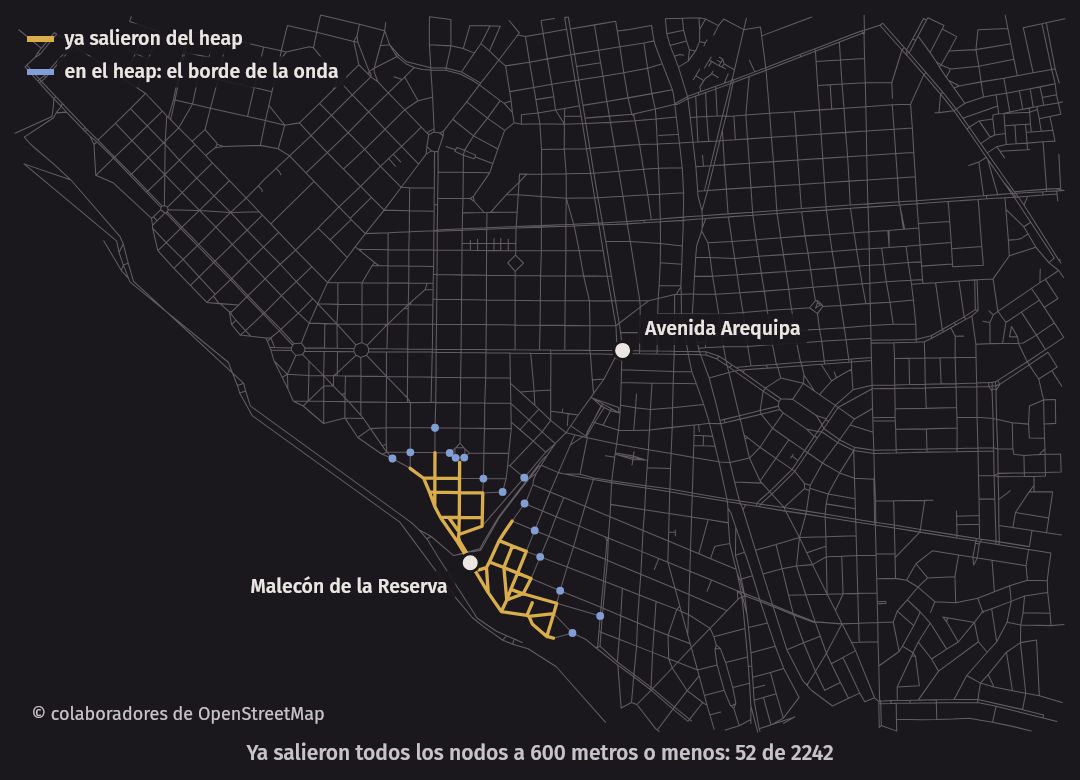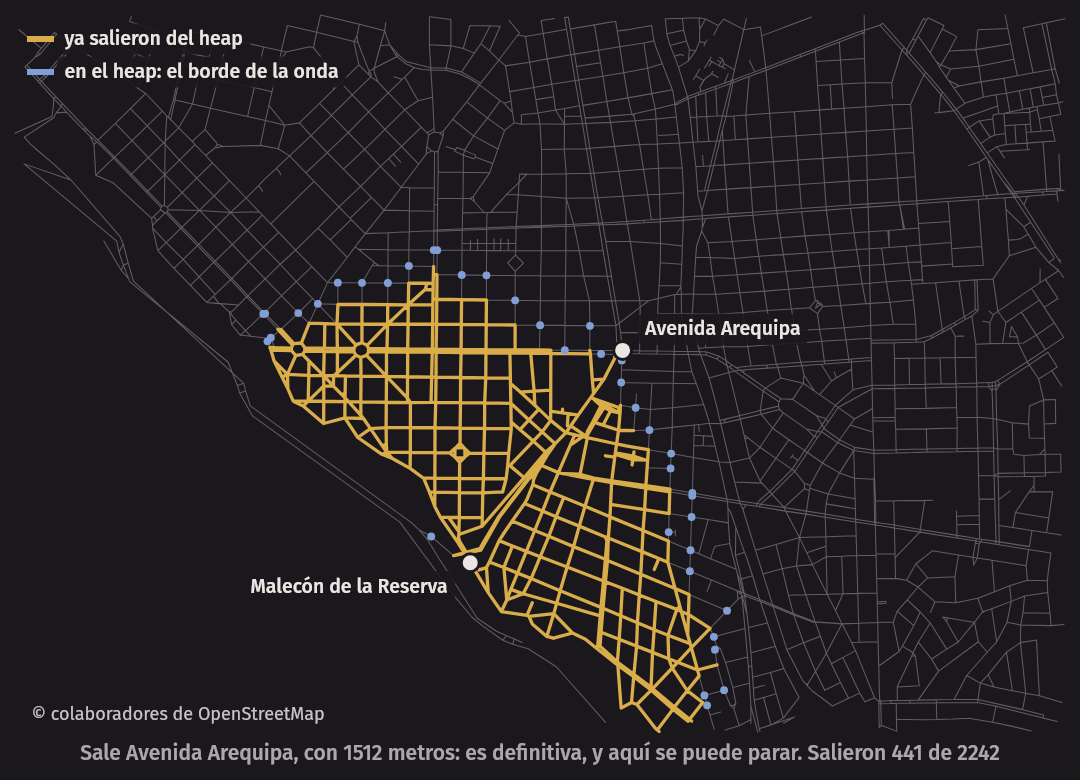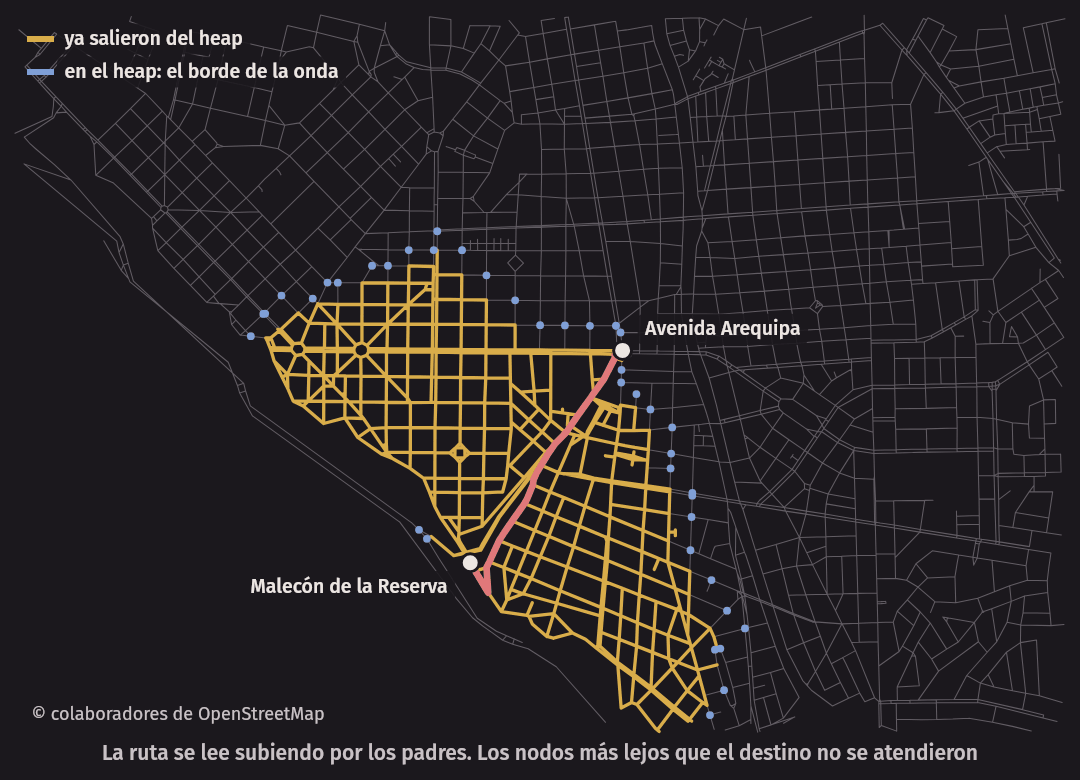
Dijkstra: 25 aristas, 1512 metros
ruta sobre linea recta: 1.24
Ahí está la respuesta a la pregunta de la clase pasada. Con 7 aristas más, la ruta tiene 359 metros menos. Datos
de © colaboradores de OpenStreetMap. data/README.md dice su licencia. Esos mapas ignoran el
sentido de circulación: la ruta trata cada calle como de doble sentido, así que puede servir para caminar y no para un
carro.
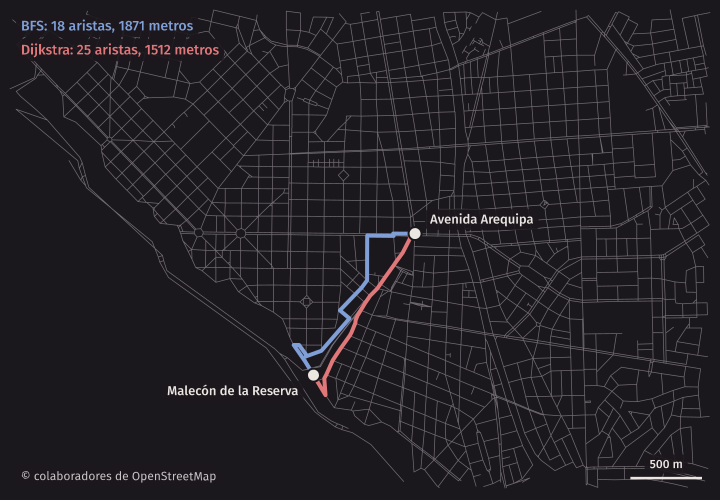
La línea recta es una revisión barata. Ninguna ruta puede ser más corta que ella, y una ruta 1.24 veces más larga en una zona con cuadras es razonable. Esa revisión detecta rutas absurdas, y no prueba que la ruta sea la mejor.
Relajar una arista
Todo el algoritmo se apoya en una sola operación. Supongan que ya conocemos una ruta de s a u, y que distancia[u] es
su peso. Si existe la arista u → v con peso w, entonces conocemos también una ruta de s a v, con peso distancia[u] + w. ¿Es mejor que la que teníamos para v?
Definición. Relajar (relax) la arista u → v con peso w es esto:
algoritmo relajar(u, v, w)
    si distancia[u] + w < distancia[v] entonces
        distancia[v] ← distancia[u] + w
        padre[v] ← u
    fin si
fin algoritmo
Al principio, distancia[s] es 0, y todas las demás valen infinito, porque no conocemos ninguna ruta. Con esa
regla, cada distancia[v] finita es siempre el peso de alguna ruta real de s a v: la que se lee subiendo por los
padres. Por eso una distancia nunca es menor que la verdadera, y relajar solo puede acercarla desde arriba. El nombre es
histórico, y confunde: lo que se hace es ajustar la cota, no aflojarla.
Un ejemplo, con el grafo de arriba. Si distancia[3] = 3 y distancia[2] = 9, relajar 3 → 2, de peso 1, da 3 + 1 = 4 <
9. Se actualiza: distancia[2] = 4, y padre[2] = 3. Relajar luego 2 → 3 da 4 + 1 = 5, que no es menor que 3, y no
cambia nada.
Queda una pregunta: ¿en qué orden se relajan las aristas? Se podría relajar todas, una y otra vez, hasta que nada cambie. Eso funciona, y las pruebas de este capítulo lo usan como cálculo de referencia, pero relee las mismas aristas muchas veces. Dijkstra elige un orden con el que basta relajar cada arista una sola vez desde cada lado.
Dijkstra
La idea es parecida a la onda de BFS, solo que la onda ahora avanza en metros. De todos los nodos que aún no se han atendido, se atiende el que tenga la menor distancia conocida, y se relajan sus aristas. Para encontrar rápido ese nodo está el heap.
algoritmo dijkstra(grafo, origen)
    distancia[v] ← infinito para todo nodo v
    padre[v] ← -1 para todo nodo v
    sacado[v] ← falso para todo nodo v
    distancia[origen] ← 0
    padre[origen] ← origen
    meter (0, origen) al heap
    mientras el heap no esté vacío hacer
        (d, u) ← sacar el menor del heap
        si sacado[u] entonces
            volver al inicio del ciclo
        fin si
        sacado[u] ← verdadero
        para cada arista (u, v, w) de la lista de u hacer
            si distancia[u] + w < distancia[v] entonces
                distancia[v] ← distancia[u] + w
                padre[v] ← u
                meter (distancia[v], v) al heap
            fin si
        fin para
    fin mientras
fin algoritmo
En el heap se guardan pares (distancia, nodo), y manda la distancia. Decimos que un nodo está sacado cuando salió del heap por primera vez. En ese momento, y no antes, su distancia ya es definitiva.
El algoritmo se debe a Edsger Dijkstra, y por eso se le dice así. En C++ se ve igual. En la clase lo escribimos con
std::priority_queue, y ustedes lo escribirán en el laboratorio con su propio MinHeap:
inline DijkstraResult dijkstra(const Graph& graph, int source) {
    int n = graph.node_count();
    DijkstraResult result{std::vector<Meters>(n, UNREACHABLE), std::vector<int>(n, -1), {}};
    std::vector<bool> settled(n, false);
    MinFirstQueue heap;
    result.distance[source] = 0;
    result.parent[source] = source;
    heap.push({0, source});
    result.counts.pushes++;
    result.counts.peak_heap = 1;
    while (!heap.empty()) {
        int u = heap.top().second;
        heap.pop();
        if (settled[u]) {  // entrada vieja: ya salió con una distancia menor
            result.counts.stale++;
            continue;
        }
        settled[u] = true;
        result.counts.settled++;
        for (const Edge& edge : graph.neighbors(u)) {
            result.counts.edges_read++;
            Meters through_u = result.distance[u] + edge.weight;
            if (through_u < result.distance[edge.to]) {  // relajar la arista
                result.distance[edge.to] = through_u;
                result.parent[edge.to] = u;
                heap.push({through_u, edge.to});
                result.counts.pushes++;
                result.counts.peak_heap = std::max(result.counts.peak_heap, heap.size());
            }
        }
    }
    return result;
}
Las líneas de counts no son parte del algoritmo: están para poder medir su trabajo sin mirar el reloj. La clase
Graph y sus listas son las de la semana 14, sin ningún cambio. Lo nuevo son estos tipos:
using Meters = std::int64_t;
const Meters UNREACHABLE = std::numeric_limits<Meters>::max();
using HeapEntry = std::pair<Meters, int>;
using MinFirstQueue = std::priority_queue<HeapEntry, std::vector<HeapEntry>, std::greater<HeapEntry>>;
UNREACHABLE hace de infinito. Nunca se le suma nada, porque solo se suma desde distance[u] con u ya sacado, y un
nodo solo entra al heap si ya tiene una distancia finita.
En C++.
std::paircompara primero porfirsty, si empatan, porsecond. Por esoHeapEntrypone la distancia primero: las entradas salen por distancia, y dos con la misma distancia salen por número de nodo. Ese desempate no afecta las distancias, y hace que el resultado no dependa de qué cola se use.
En la biblioteca. Con el mismo
HeapEntry, suMinHeapystd::priority_queuese escriben al revés.MinHeap<HeapEntry>, con su comparador por defectostd::less, deja arriba al menor, porque en su heapless(a, b)dice que a va más cerca de la raíz.std::priority_queuedeja arriba al mayor con ese mismo comparador, y por eso necesitastd::greater. En los dos,popno devuelve nada: primero se leetop, y luego se saca.
Paso a paso
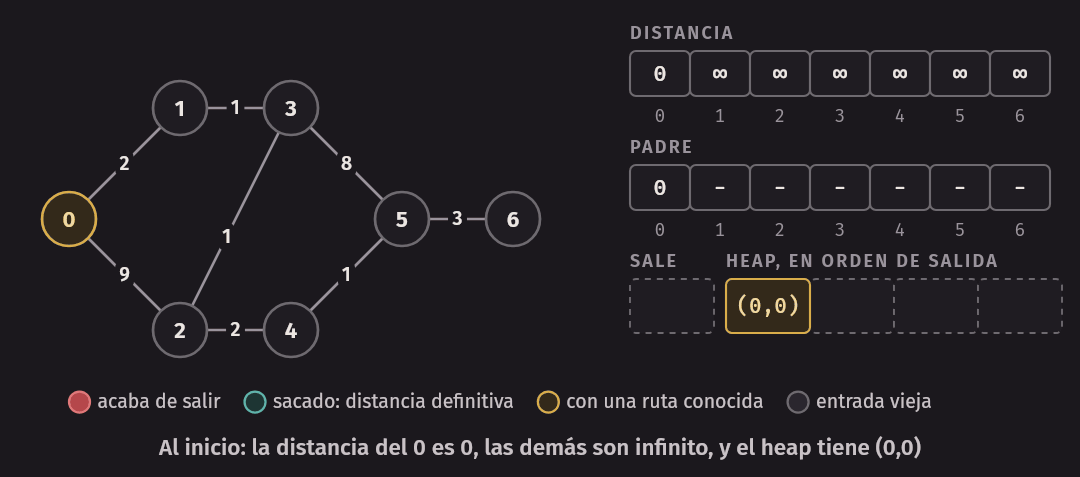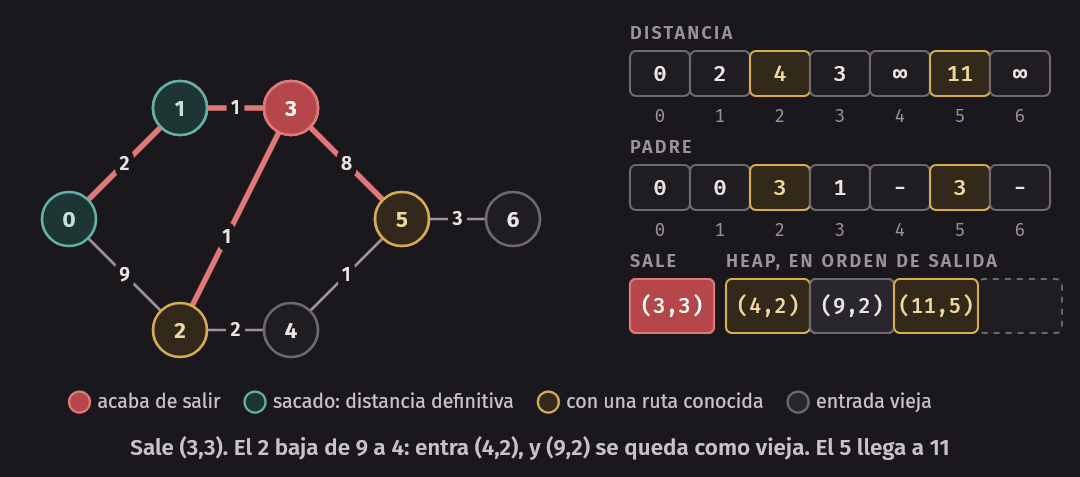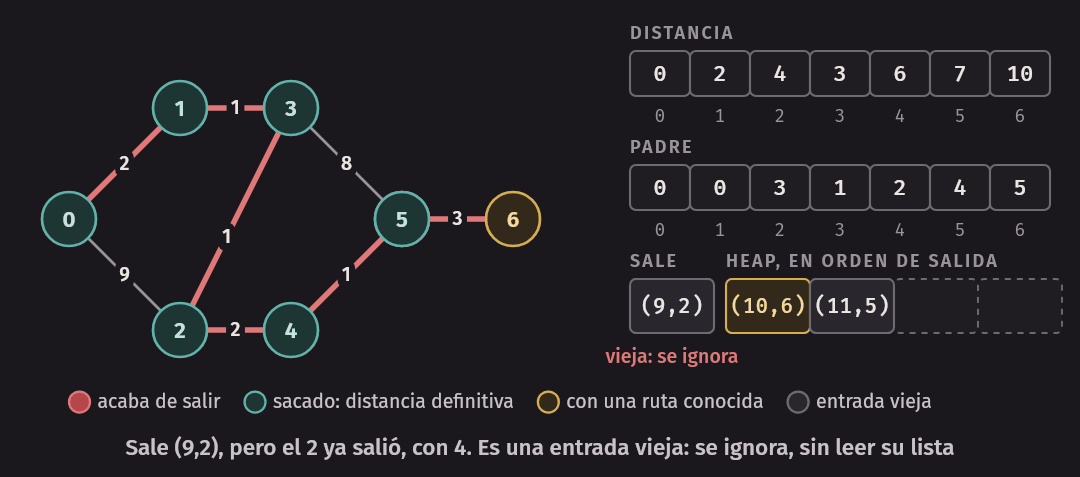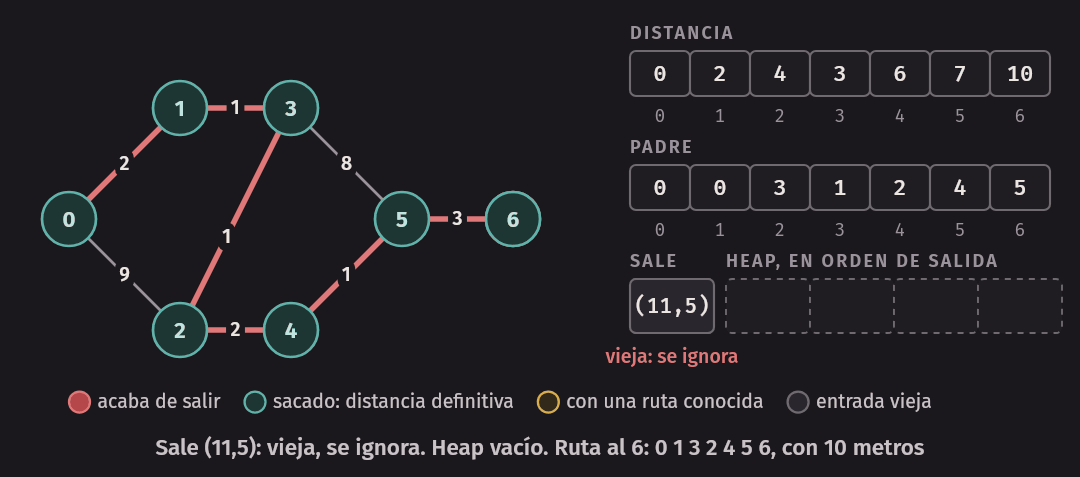
Corramos Dijkstra desde el 0 sobre el grafo con pesos. Cada fila dice qué entrada salió, qué vecinos mejoraron, cómo
quedaron las distancias de los nodos 0 a 6 (- es infinito), y qué hay en el heap. El heap se muestra en orden de
salida, que no es el orden de su arreglo interno:
$ build/dijkstra_trace
sale     relaja     distancias      heap
-        -          0 - - - - - -   (0,0)
(0,0)    1 2        0 2 9 - - - -   (2,1) (9,2)
(2,1)    3          0 2 9 3 - - -   (3,3) (9,2)
(3,3)    2 5        0 2 4 3 - 11 -  (4,2) (9,2) (11,5)
(4,2)    4          0 2 4 3 6 11 -  (6,4) (9,2) (11,5)
(6,4)    5          0 2 4 3 6 7 -   (7,5) (9,2) (11,5)
(7,5)    6          0 2 4 3 6 7 10  (9,2) (10,6) (11,5)
(9,2)    vieja      0 2 4 3 6 7 10  (10,6) (11,5)
(10,6)              0 2 4 3 6 7 10  (11,5)
(11,5)   vieja      0 2 4 3 6 7 10
ruta de Dijkstra a 6: 0 1 3 2 4 5 6
  aristas: 6, metros: 10
ruta de BFS a 6: 0 1 3 5 6
  aristas: 4, metros: 14
Antes de leer la explicación, sigan la tabla con un lápiz. Fíjense en esto:
- Al sacar (3,3), el nodo 2 baja de 9 a 4. La ruta directa 0-2 pesa 9, y la ruta 0-1-3-2 pesa 4. El nodo 2 ya estaba en el heap con 9. Ahora entra otra vez, con 4, y la entrada (9,2) se queda ahí.
- Con el 5 pasa lo mismo. Entra con 11 al sacar el 3, y baja a 7 al sacar el 4. Queda una entrada (11,5).
- Las filas
vieja. Cuando sale (9,2), el nodo 2 ya está sacado, con distancia 4. Esa entrada ya no dice nada, y se ignora. - Los nodos salen de menor a mayor distancia: 0, 2, 3, 4, 6, 7, 10. Esa es la onda: primero se atiende lo cercano.
- La fila (10,6) no relaja nada, porque el único vecino del 6 es el 5, que ya tiene 7.
Son 9 entradas, 7 nodos sacados y 2 viejas. Las pruebas comprueban esos números.
Una corrida a mano
Así se ve un ejercicio de examen, sin programa de por medio. Grafo no dirigido de 5 nodos, con aristas 0-1 (4), 0-2 (1), 1-2 (2), 1-3 (5), 2-3 (8) y 3-4 (3), desde el 0. En cada fila se escribe la entrada que sale, y lo que queda al terminar de atenderla:
| Sale | Qué pasa | distancia de 0 a 4 |
Heap |
|---|---|---|---|
| Inicio | 0 ∞ ∞ ∞ ∞ | (0,0) | |
| (0,0) | Mejoran el 1 y el 2 | 0 4 1 ∞ ∞ | (1,2) (4,1) |
| (1,2) | Mejoran el 1, a 3, y el 3, a 9 | 0 3 1 9 ∞ | (3,1) (4,1) (9,3) |
| (3,1) | Mejora el 3, a 8 | 0 3 1 8 ∞ | (4,1) (8,3) (9,3) |
| (4,1) | Vieja: el 1 ya salió | 0 3 1 8 ∞ | (8,3) (9,3) |
| (8,3) | Mejora el 4 | 0 3 1 8 11 | (9,3) (11,4) |
| (9,3) | Vieja: el 3 ya salió | 0 3 1 8 11 | (11,4) |
| (11,4) | No mejora nadie | 0 3 1 8 11 |
Los padres son 2 ← 0, 1 ← 2, 3 ← 1 y 4 ← 3, así que la ruta al 4 es 0-2-1-3-4, y 1 + 2 + 5 + 3 = 11, igual que la
distancia. Esa última suma es la revisión que conviene hacer siempre. En test_structures.cpp está esta misma corrida.
Fueron 7 entradas al heap para 5 nodos: las 2 de más son las viejas.
Por qué funciona, en una frase
Esto es intuición, no una demostración. Cuando sale u con la menor distancia conocida, todas las demás entradas del heap pesan lo mismo o más. Cualquier otra forma de llegar a u tendría que pasar por uno de esos nodos pendientes, y seguir desde ahí. Si ninguna arista resta, seguir no puede bajar el total, así que no puede salir mejor que lo que ya tenemos.
Esa frase supone algo: que ninguna arista reste. Lo veremos en un momento. La demostración rigurosa y otros algoritmos de caminos mínimos quedan para el curso de Algoritmos.
Empates y pesos 0
En un mapa de verdad hay empates: dos nodos con la misma distancia en el heap. No importa cuál salga antes. Si salen en
otro orden, las distancias quedan iguales, y a lo sumo cambia cuál de dos rutas de igual peso se reporta. Por eso no
pueden esperar una ruta exacta, sino una ruta de ese peso. Tampoco molesta un peso 0: la relajación usa <, así que
una ruta igual de larga no vuelve a meter nada, y el nodo se queda con el primer padre que le dio ese valor.
Reconstruir la ruta
Igual que en BFS: padre[v] dice de dónde se llegó, y se sube desde el destino hasta el origen. La función path_to de
la semana 14 sirve sin cambiar nada. Lo único distinto es cuándo se escribe el padre: en BFS se escribía una sola
vez, y aquí se sobrescribe cada vez que la distancia mejora. En la tabla, padre[2] empieza en 0, y termina en 3.
Al final, los padres forman un árbol con raíz en el origen: el árbol de caminos mínimos. Una sola corrida de Dijkstra responde entonces de un origen a todos los destinos.
Entradas viejas
Cuando la distancia de un nodo que ya está en el heap mejora, hay dos opciones.
Actualizar la entrada: buscar (9,2) dentro del heap, cambiarla por (4,2) y subirla. Subirla es fácil, porque es el
sift_up de la semana 13. Lo difícil es encontrarla: un heap no sabe buscar, y recorrerlo cuesta Θ(n). Habría que
mantener otro arreglo que diga en qué posición del heap está cada nodo, y actualizarlo en cada intercambio de sift_up
y sift_down.
Dejarla, e ignorarla al sacar. Se mete una entrada nueva, y la vieja se queda. Como la nueva tiene una distancia menor, sale antes. Cuando por fin sale la vieja, el nodo ya está sacado, y se descarta con una línea:
if (settled[u]) { // entrada vieja: ya salió con una distancia menorSu heap no necesita ningún método nuevo. El precio es memoria y algunas vueltas de más: el heap guarda hasta una entrada por cada vez que se relaja con éxito, y no una por nodo. Más abajo medimos ese precio: es pequeño.
Idea clave. Una entrada vieja no hace daño: sale tarde y se ignora. Por eso se prefiere esta versión. Su
MinHeapfunciona tal como quedó, sin saber nada de grafos.
Error común. Olvidar esa línea. Las distancias siguen dando bien, porque una entrada vieja no mejora a nadie, pero cada una vuelve a leer toda su lista. El laboratorio cuenta las aristas leídas: en una corrida completa sobre un mapa tienen que ser exactamente 2E.
Hay otra forma común de escribir la misma revisión, sin el arreglo sacado: una entrada es vieja si d ≠ distancia[u].
Con pesos no negativos, las dos ignoran las mismas entradas, y las dos sirven en el laboratorio. Esa forma se comporta
distinto con pesos negativos, como veremos.
Cada estructura en su sitio
| Estructura | Para qué | Operación que más se usa |
|---|---|---|
| Listas de adyacencia | Los vecinos de u, con sus pesos | Recorrer una lista |
| Arreglo de distancias | La mejor distancia conocida de cada nodo | Leer y escribir por índice, en Θ(1) |
| Arreglo de padres | De dónde se llegó, para la ruta | Escribir en Θ(1) |
| Arreglo de sacados | Saber si una entrada es vieja | Leer por índice, en Θ(1) |
| Heap | El siguiente nodo que se atiende | push, top y pop |
Cada estructura hace lo que hace bien. El heap no sabe en qué posición está un nodo, y no le hace falta, porque los arreglos sí lo saben. Los arreglos no saben cuál es el menor, y para eso está el heap.
Un número de 64 bits
Graph guarda pesos en int. ¿Alcanza un int para las distancias? No hay que suponerlo, y se puede revisar:
$ build/distance_range ../../data/mapas/miraflores.txt ../../data/mapas/lima-sur.txt ../../data/mapas/lima.txt
int llega hasta 2147483647
sizeof(HeapEntry): 16
../../data/mapas/miraflores.txt: arista mas larga 938, suma de todas 254773, ruta larga encontrada 6584
../../data/mapas/lima-sur.txt: arista mas larga 1299, suma de todas 2151474, ruta larga encontrada 20082
../../data/mapas/lima.txt: arista mas larga 2574, suma de todas 8540931, ruta larga encontrada 40466
Los mapas son datos de © colaboradores de OpenStreetMap. Una ruta sin nodos repetidos usa cada arista como máximo una
vez, así que no puede pasar de la suma de todas las aristas. En lima.txt, esa suma es 8 540 931 metros, unas 250
veces menos que el límite de int. La ruta larga que se encontró, de 40 466 metros, es apenas una cota inferior de la
más larga, porque sale de dos corridas, y no de probar todos los pares. Basta con la suma para concluir: en estos
mapas, un int no puede hacer overflow.
Y aun así usamos 64 bits, porque dijkstra recibe cualquier Graph, no solo estos mapas. Dos aristas de 2 000 000 000
ya no caben en un int, y el overflow con signo es comportamiento indefinido. Las pruebas corren ese caso. El precio es
memoria: en esta plataforma una entrada del heap ocupa 16 bytes, y con dos int ocuparía 8. Es un precio chico, y es
una decisión que se puede cambiar sabiendo lo que se hace, con estos números a la mano.
Dónde detenerse
Muchas veces solo interesa un destino. Conviene parar apenas se conozca su distancia. ¿Cuándo se conoce?
En la semana 14, BFS se detenía apenas marcaba el destino, al meterlo a la cola. Allí era seguro: los nodos salen por niveles, y el primero en descubrir un nodo ya le da su distancia definitiva. Los apuntes avisaban que esa frase no valdría esta semana. Este es el motivo: en Dijkstra, la primera distancia que recibe un nodo puede mejorar después. Ya lo vimos: el nodo 2 entró con 9, y su distancia es 4.
Error común. Detener Dijkstra al meter el destino al heap, y no al sacarlo. Al meterlo, solo se conoce una ruta. Al sacarlo, ya no puede mejorar.
errors/stop_at_push.cpp hace las dos cosas, primero con 0-2 (5), 0-1 (1) y 1-2 (1), y luego con 1000 pares al azar de
un mapa:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/stop_at_push.cpp -o build/stop_at_push && build/stop_at_push ../../data/mapas/miraflores.txt
de 0 a 2, al meter: 5, al sacar: 2
en el mapa, 158 de 1000 pares dan una distancia equivocada
la peor sobra 334 metros
El mapa es de © colaboradores de OpenStreetMap. En el triángulo, sacar el 0 ya descubre al 2, con 5, y la versión mala para ahí. Falta atender al 1, que llega con 2. En el mapa falla casi uno de cada seis pares, sin caerse, y por hasta 334 metros. Esa diferencia no se ve al mirar el resultado: la ruta tiene una pinta de lo más normal.
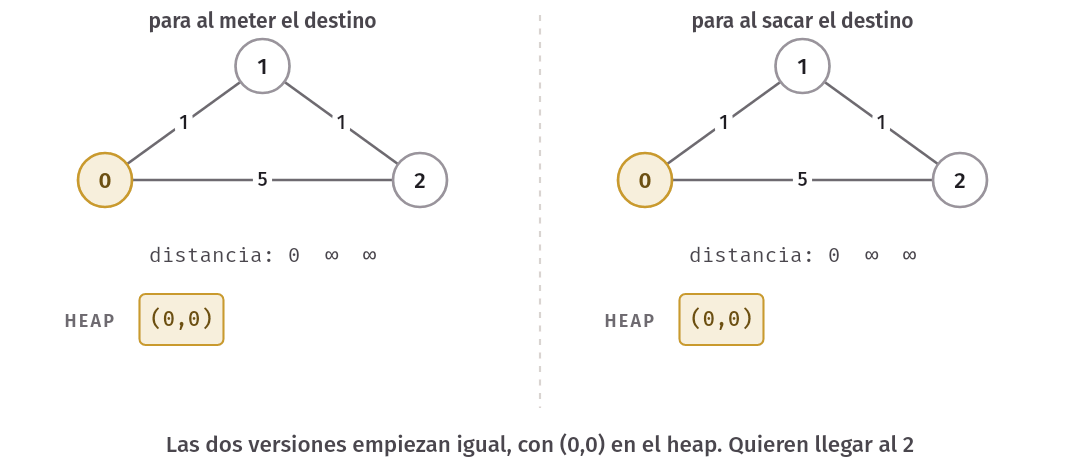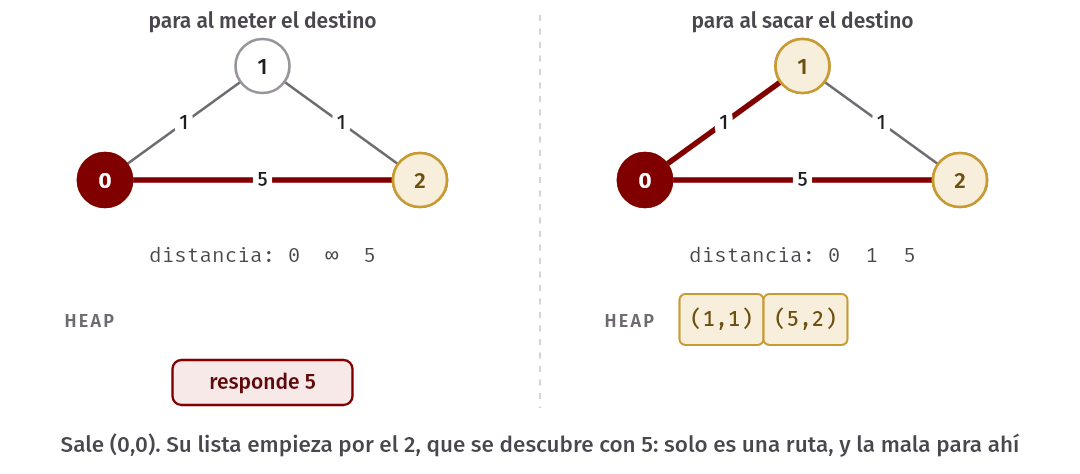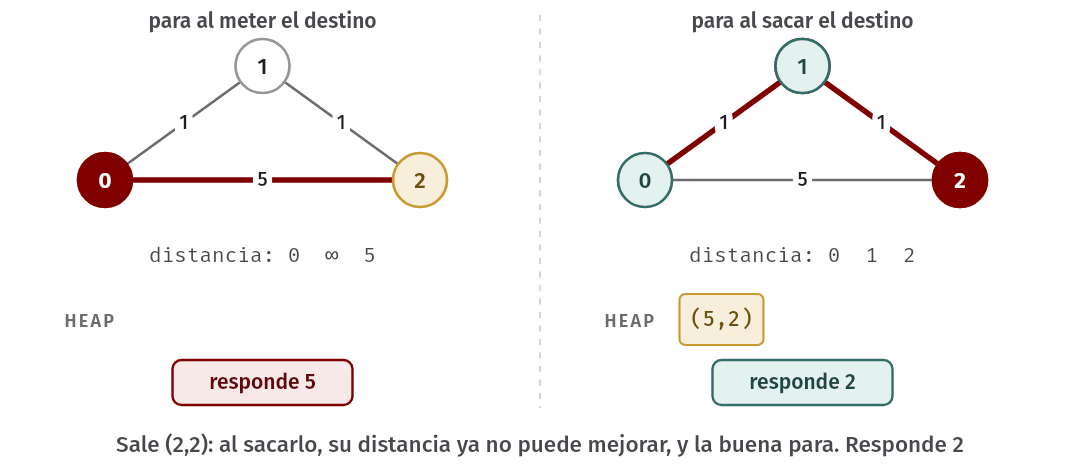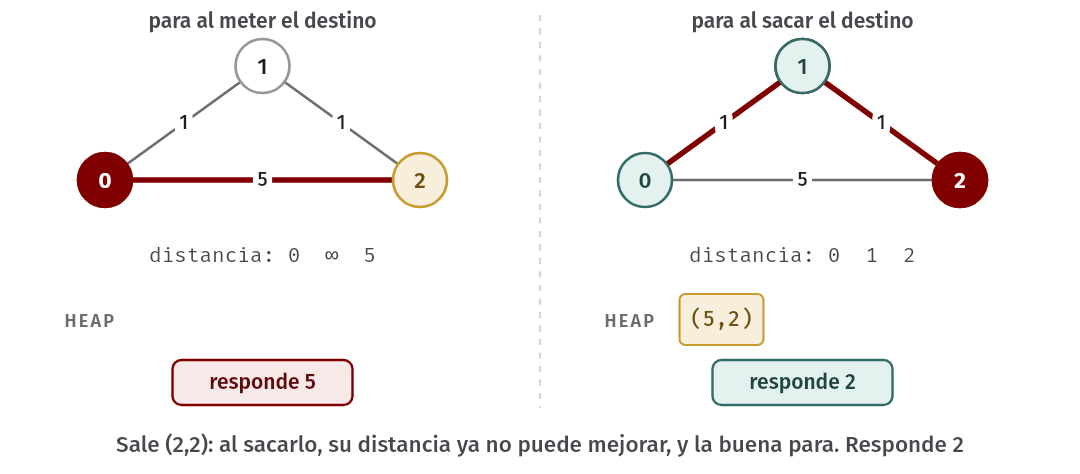
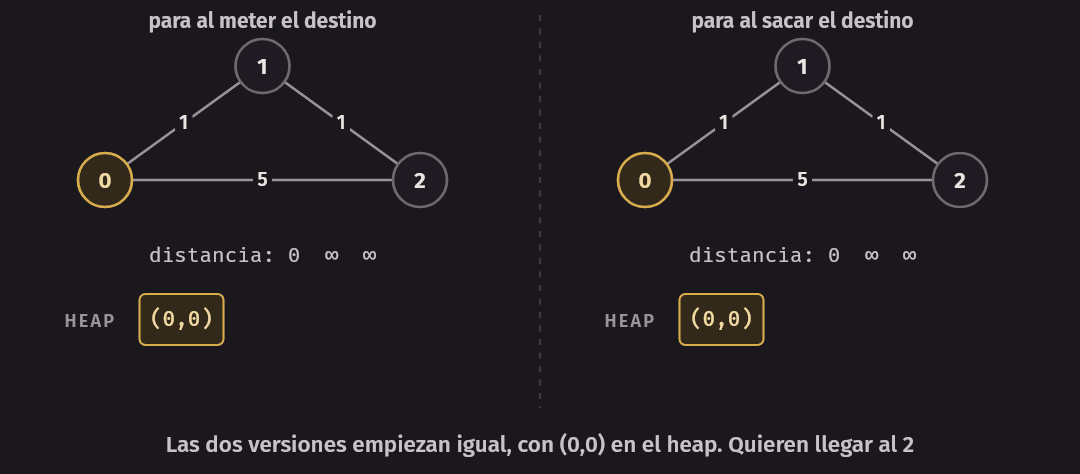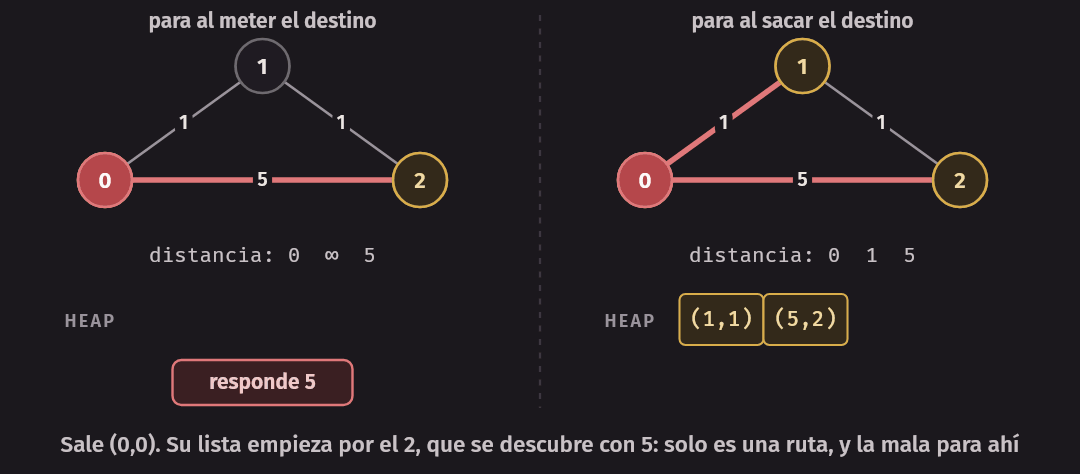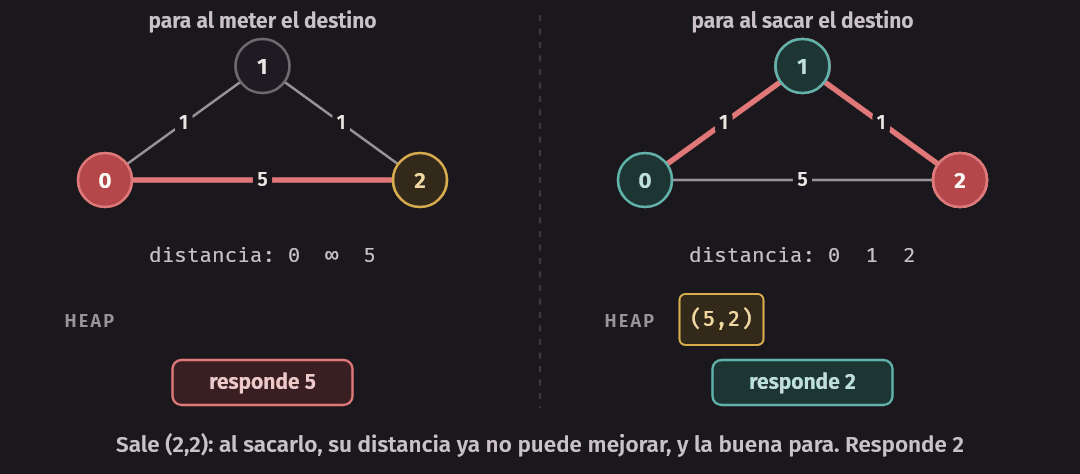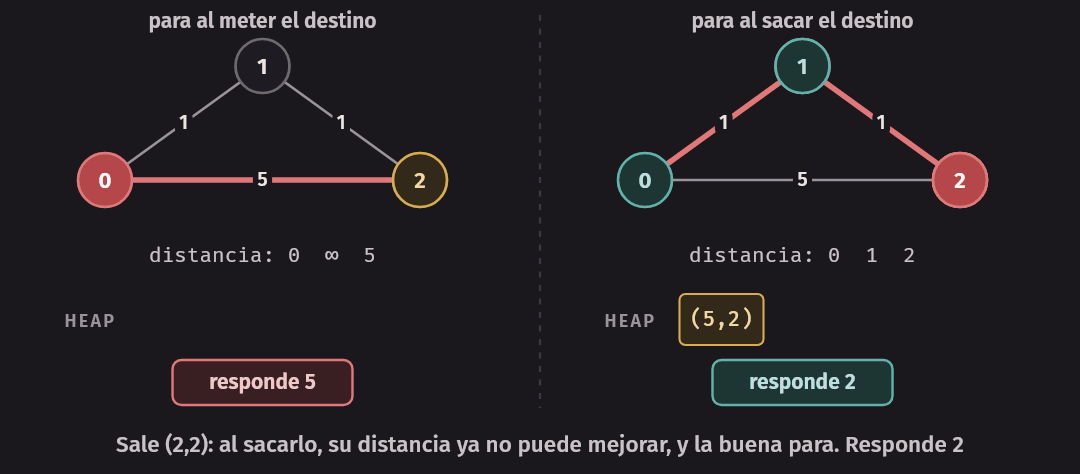
El caso general es este:
    si u = destino entonces
        salir del ciclo
    fin si
Esa revisión va justo después de marcar a u como sacado, y antes de leer su lista. Como los nodos salen de menor a mayor distancia, parar en el destino ahorra todo lo que está más lejos que él: casi todo si está cerca, y nada si es el más lejano. Lo medirán en el laboratorio. Una consecuencia: al parar, solo las distancias de los nodos sacados son definitivas. Las de los que siguen en el heap son solo rutas conocidas.
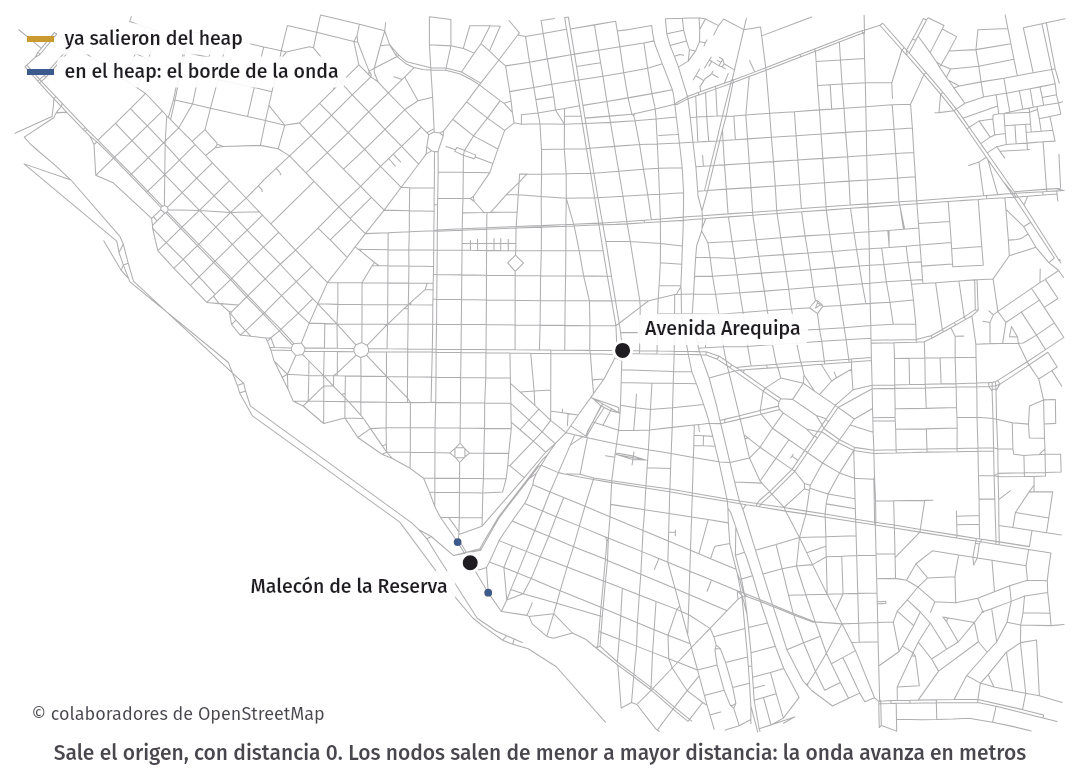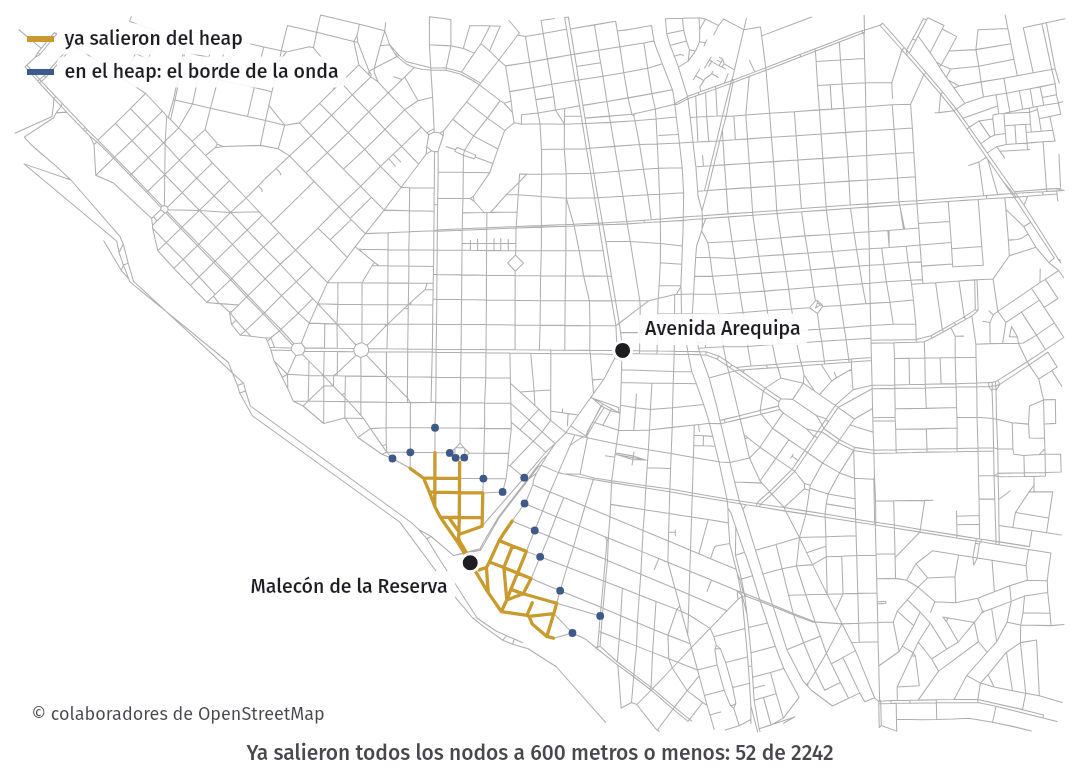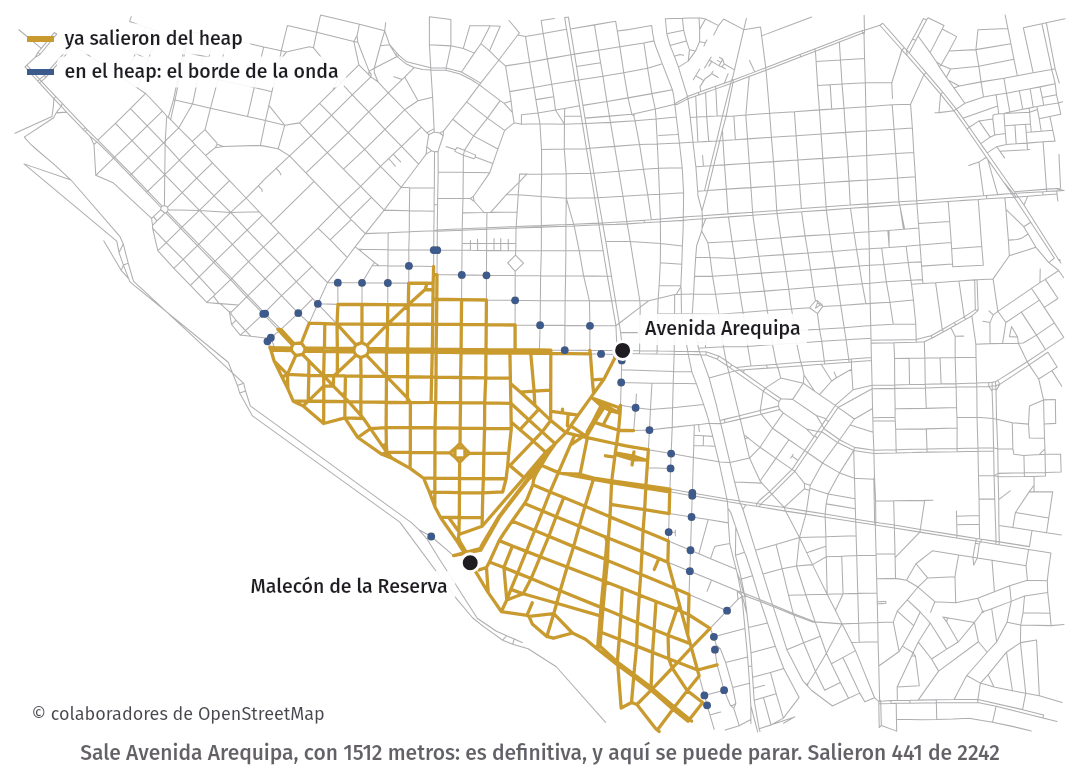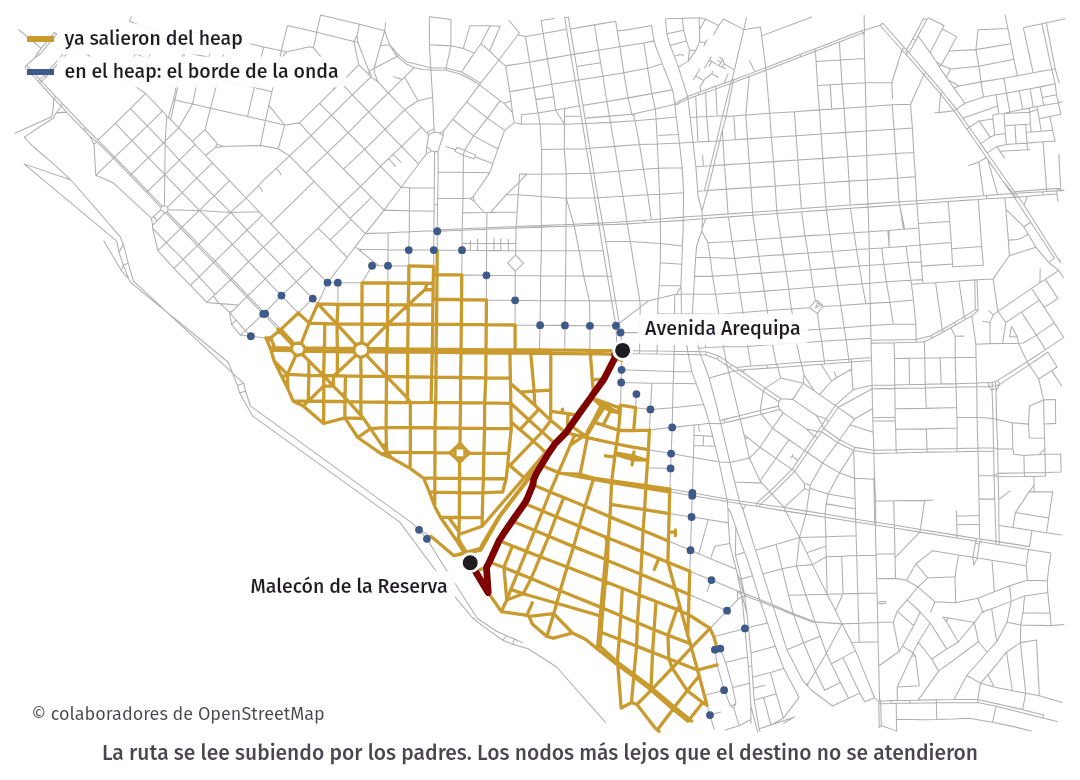
BFS y Dijkstra, lado a lado
Vale la pena mirar los dos juntos, porque casi todo lo que cambia viene de una sola diferencia: el orden en que se atienden.
| BFS | Dijkstra | |
|---|---|---|
| Pregunta | Menos aristas | Menos peso |
| Lo pendiente | Cola, Θ(1) por operación | Heap, O(log n) por operación |
| Cuántas veces entra un nodo | Una, porque se marca al entrar | Una por cada mejora |
| Cuándo es definitiva una distancia | Al marcar, al meter | Al sacar por primera vez |
| Dónde se puede parar | Al marcar el destino | Al sacar el destino |
| Padre de un nodo | Se escribe una vez | Se sobrescribe con cada mejora |
| Costo | Θ(V + E) si se alcanza todo | O((V + E) log V) |
| Requiere | Nada de los pesos | Pesos no negativos |
Hay una forma de unirlos. Si todas las aristas pesan lo mismo, Dijkstra da las mismas distancias que BFS, y las pruebas lo comprueban en 200 grafos al azar con pesos 1: en ese caso, la primera vez que se descubre un nodo ya es la mejor. BFS es lo que queda cuando los pesos no importan, y por eso no necesita pagar el log V del heap.
Error común. Copiar el BFS de la semana 14, y cambiarle solo la cola por un heap. Si marcan al meter, cada nodo se queda con la primera distancia que recibió. En el grafo de la clase, el nodo 2 se quedaría en 9. Son los mismos dos momentos de la semana pasada, y la regla se invierte: en BFS se marca al meter, y en Dijkstra un nodo queda definitivo al sacar.
Otros tres errores que dan rutas falsas
Estos tres errores tienen algo en común: ninguno rompe el programa, y ninguno lo detecta un sanitizer.
Olvidar std::greater. La semana 13 lo advirtió: sin él, std::priority_queue saca primero lo más lejano. Con
la marca de sacados, cada nodo sale con la primera distancia que le tocó:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/forgot_greater.cpp -o build/forgot_greater && build/forgot_greater ../../data/mapas/miraflores.txt
distancias equivocadas: 2230 de 2242
Esa es la misma zona de Miraflores, con datos de © colaboradores de OpenStreetMap.
Guardar una referencia a top(). const HeapEntry& front = heap.top();, seguido de pop(), se ve inofensivo, y
sale mal: la referencia apunta al primer lugar del arreglo, y pop pone ahí otra entrada. Esto vale igual para su
MinHeap:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/reference_to_top.cpp -o build/reference_to_top && build/reference_to_top
antes de pop: (3,2)
despues de pop: (5,1)
Corrió con ASan, y ASan no dijo nada, porque esa memoria sigue siendo del vector. Con una sola entrada en el heap, sería
peor: la referencia quedaría apuntando a una entrada destruida. Por eso el código copia el nodo antes de pop: int u = heap.top().second;. Y auto [d, u] = heap.top(); también copia, porque no lleva &.
Un heap de nodos, con un comparador que lee distancia. Parece más limpio: no hay pares, y less(a, b) compara
distance[a] con distance[b]. Para escribirlo hace falta una lambda que captura el arreglo, y una lambda que captura
no tiene constructor por defecto. Con su heap se construye con MinHeap<int, decltype(closer)> heap(closer), y por eso
existe ese constructor. Compila, y corre, y está mal: al relajar, cambia la clave de un nodo que ya está dentro, sin
que el heap se entere, y su invariante deja de cumplirse.
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/comparator_reads_distance.cpp -o build/comparator_reads_distance && build/comparator_reads_distance ../../data/mapas/miraflores.txt
origenes con alguna distancia equivocada: 2 de 200
distancias equivocadas en total: 3
El mapa es de © colaboradores de OpenStreetMap. Es el peor error de los tres. Casi siempre da bien: aquí falló en 2 de 200 orígenes, con la implementación de esta biblioteca. Una prueba con un solo origen probablemente lo deja pasar. Las claves de un heap no pueden cambiar mientras estén dentro.
Pesos negativos
Dijkstra requiere pesos no negativos. Un peso 0 no molesta, y uno negativo sí, porque rompe la frase de la intuición: seguir por una arista ya puede bajar el total, así que sacar el menor ya no asegura nada.
Un contraejemplo, dirigido, con los nodos 0 a 3 y las aristas 0 → 1 (2), 0 → 2 (3), 2 → 1 (−2) y 1 → 3 (1):
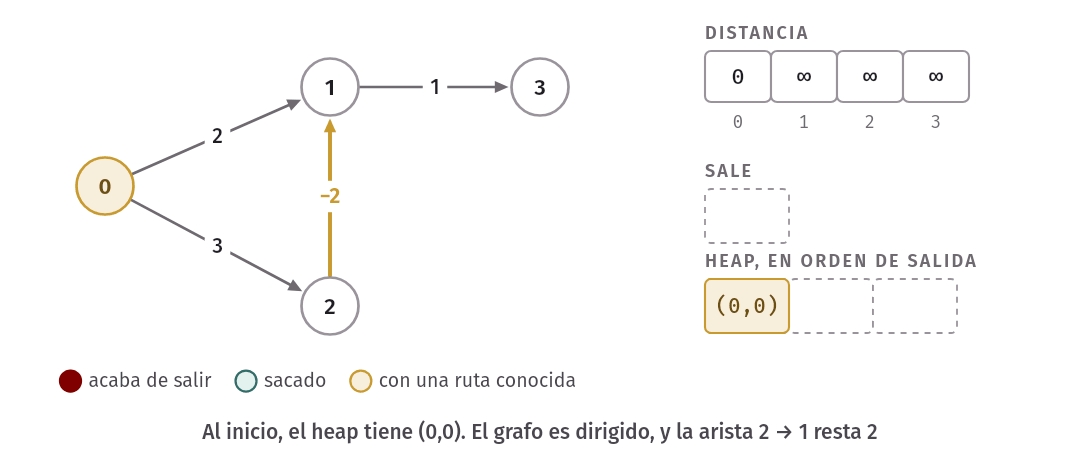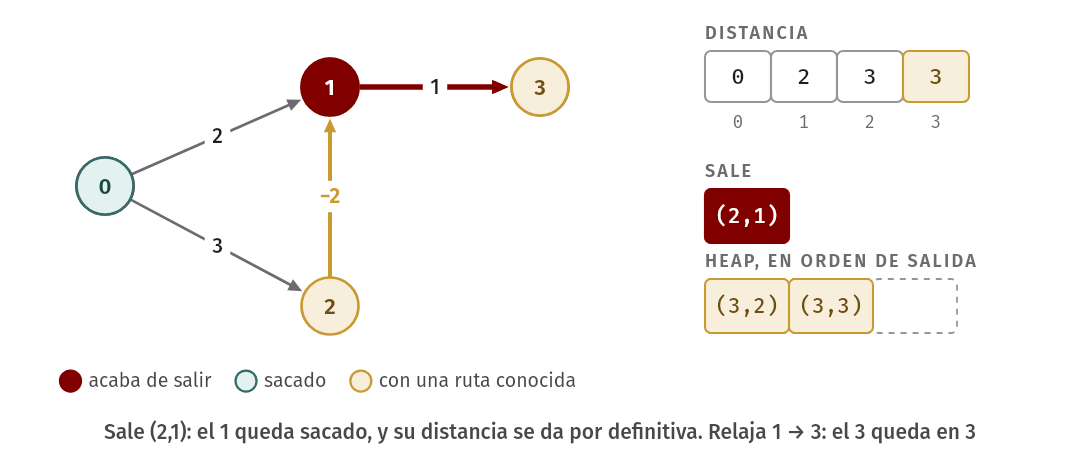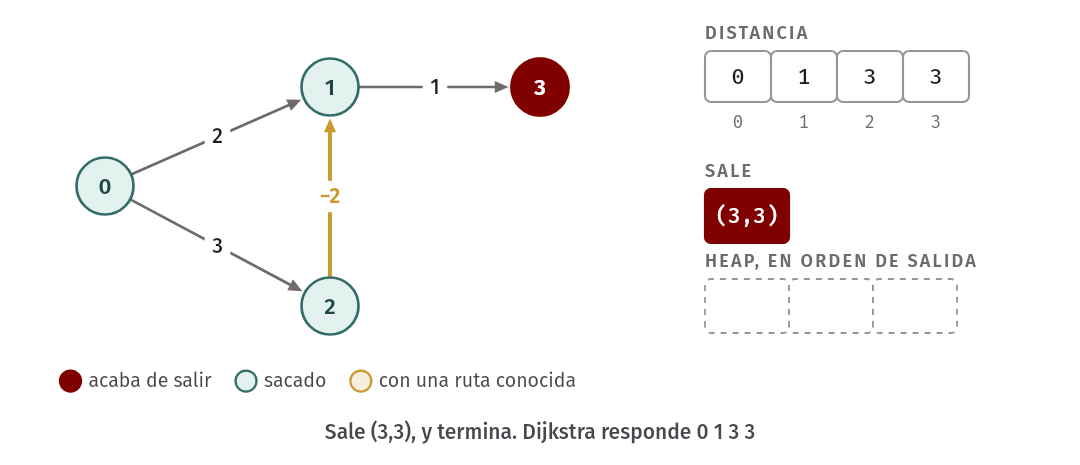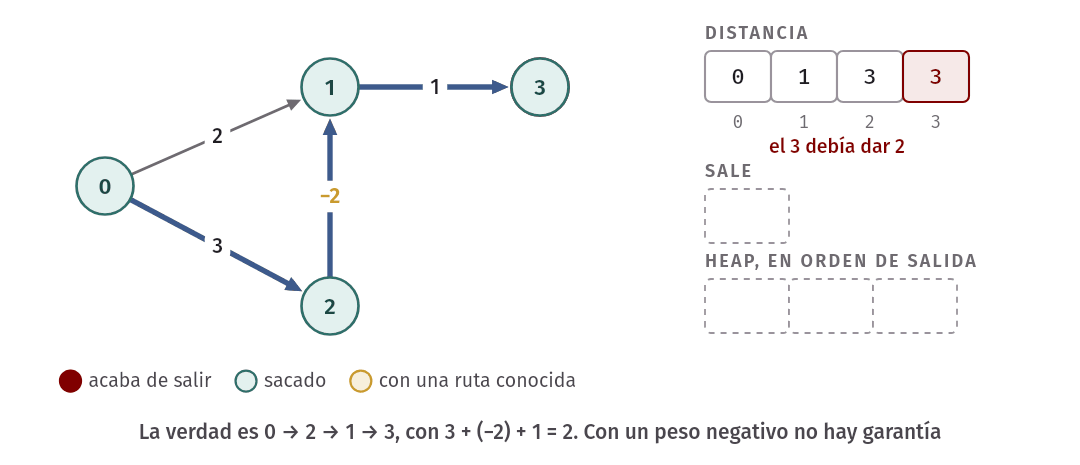
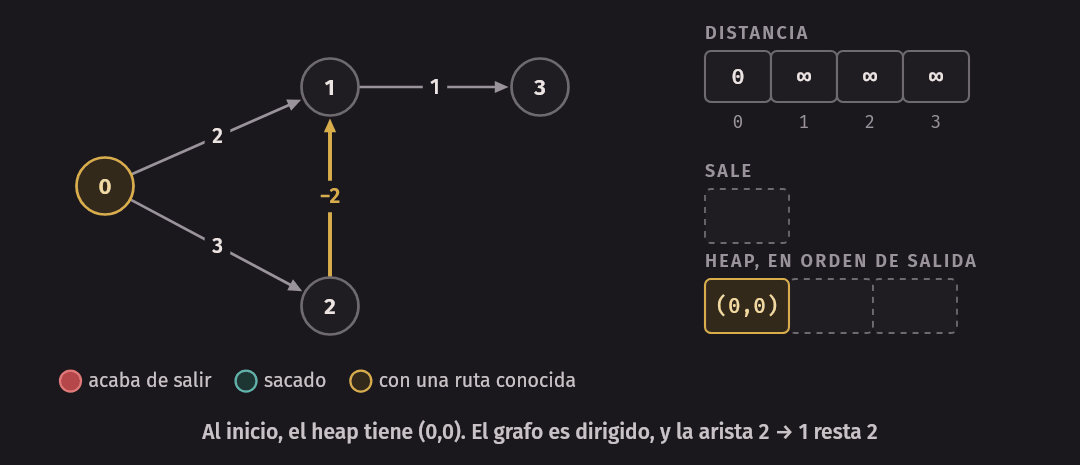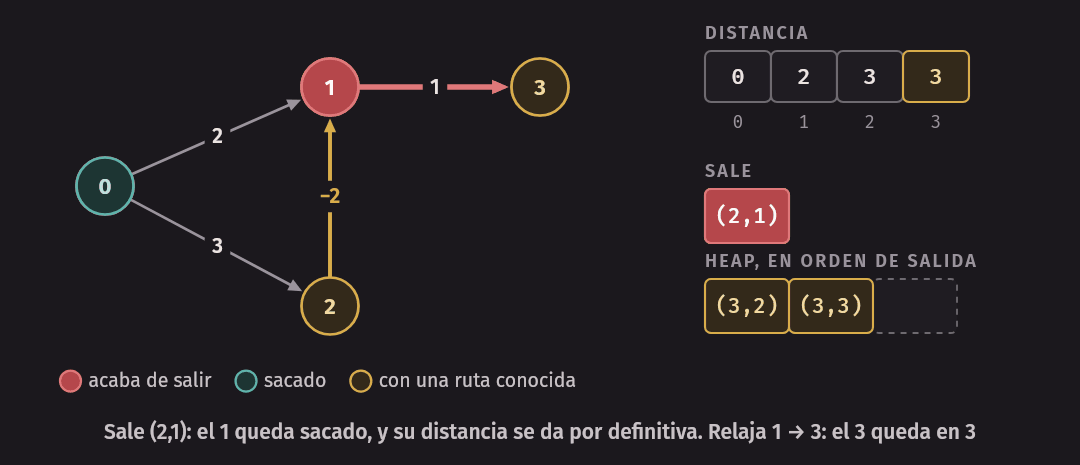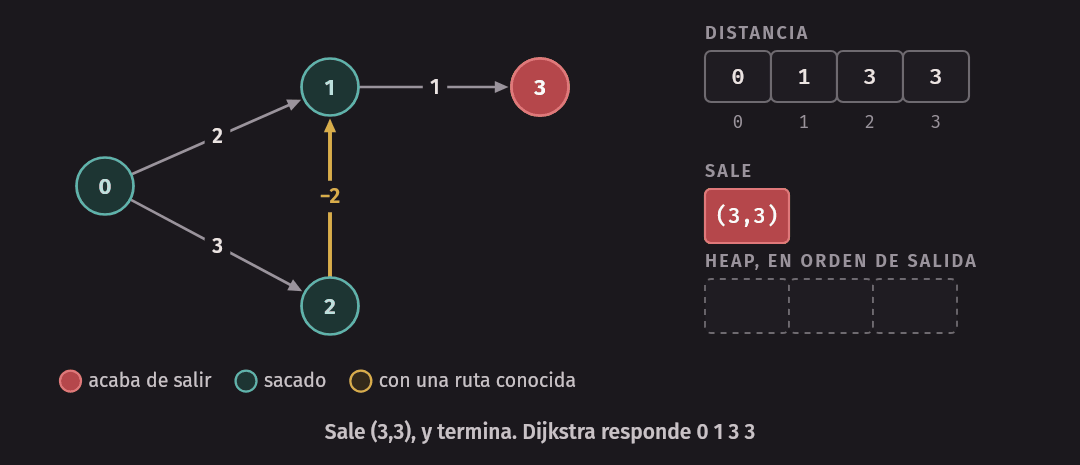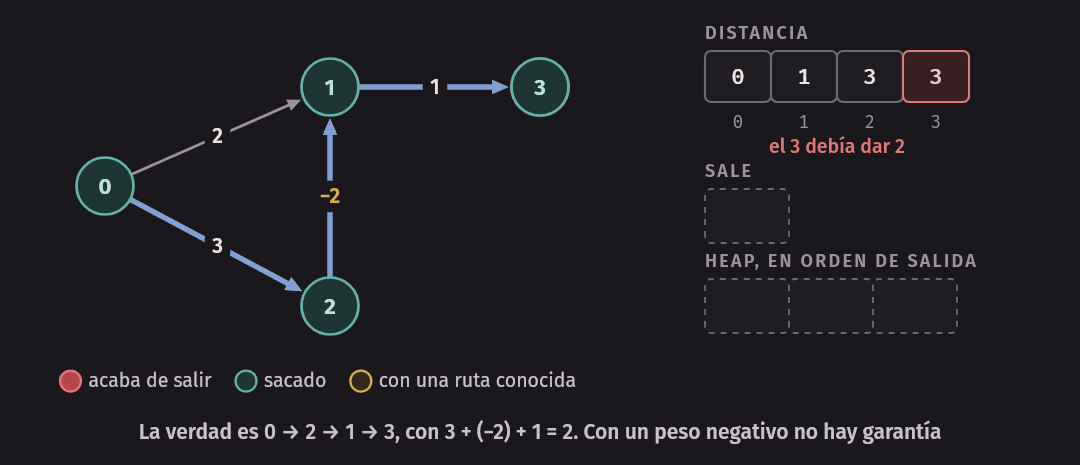
- Sale (0,0): el 1 queda en 2, y el 2 queda en 3.
- Sale (2,1): el 1 queda sacado, y su distancia se da por definitiva. Relaja 1 → 3, y el 3 queda en 3.
- Sale (3,2): relaja 2 → 1, con 3 − 2 = 1 < 2. La distancia del 1 baja a 1 y entra (1,1). Pero el 1 ya salió.
- Sale (1,1): es una entrada vieja, y se ignora. Nadie vuelve a leer la lista del 1.
- Sale (3,3), y termina.
La verdad es 0 → 2 → 1 → 3, con 3 − 2 + 1 = 2, y el resultado dice 3:
$ g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined errors/negative_edge.cpp -o build/negative_edge && build/negative_edge
dijkstra:           0 1 3 3
ruta real a 3: 0 2 1 3, con 3 + (-2) + 1 = 2
sin arreglo:        0 1 3 2
entradas sacadas: 6
sin arreglo, parando al sacar el 1: 2 (la verdad es 1)
con un ciclo negativo, cortado tras 100 entradas sacadas
Tiene que ser dirigido por un motivo: en un grafo no dirigido, una arista negativa u-v ya es un ciclo, porque se puede ir y volver bajando el total sin fin. Si se pueden repetir nodos, no hay ningún recorrido más corto que todos los demás.
Las otras líneas de la salida son honestas sobre un detalle. Si la revisión de entradas viejas se escribe como d ≠ distancia[u], sin el arreglo, la entrada (1,1) sí se atiende, el 1 se procesa de nuevo y en este ejemplo sale 0 1 3 2, que es correcto. No crean por eso que se arregló:
- Si además se para al sacar el destino, responde 2 para el nodo 1, cuando la verdad es 1. Lo dice la línea siguiente.
- Ya no se cumple que cada nodo salga una vez, así que el costo que calculamos abajo deja de valer.
- Con un ciclo negativo no termina: el programa de arriba lo corta a las 100 entradas.
Idea clave. Dijkstra supone que ninguna arista resta. Sin esa condición no hay ninguna garantía, aunque en algún ejemplo acierte. Antes de usarlo, revisen sus pesos. Metros y minutos sirven. Para pesos negativos hay otros algoritmos, que verán en Algoritmos.
El costo
Contemos con un grafo de V nodos y E aristas, sin aristas repetidas.
- Preparar los arreglos cuesta Θ(V).
- Cada nodo sale una sola vez como sacado, gracias a la marca. Ese es el factor V de la fórmula: como máximo V veces se atiende un nodo.
- Cada lista se lee una sola vez, al sacar su nodo. Aquí está el factor E: entre todas las listas hay como
máximo 2E entradas, y por cada una se intenta relajar una vez. Cada relajación exitosa hace un
push. - Por eso entran al heap como máximo 2E + 1 entradas, contando la del origen, y cada una sale una vez. Son O(E) operaciones de heap.
- Cada
pushopopcuesta O(log n), con n entradas en el heap. Ese es el factor log V. Como n ≤ 2E + 1, y E < V² en un grafo sin aristas repetidas, log n ≤ log(2V²) = 2 log V + 1. Es decir, es O(log V). El hecho de tener entradas viejas no cambia el orden.
En total, O((V + E) log V). Es una O, una cota superior, y no una Θ: las relajaciones exitosas pueden ser muchas menos que 2E, y si el origen no alcanza todo el grafo, solo se paga su componente, más el Θ(V) de los arreglos.
¿Qué tan cerca está esa cota de un mapa real? dijkstra_counts hace una corrida completa desde el nodo 0, y cuenta. Se
compiló con -O2 y sin sanitizers, y cada tiempo es la mediana de 11 corridas. Los tiempos dependen de la máquina: esta
es una de 3 corridas, en el contenedor del curso sobre una máquina arm64, con otros procesos ocupándola:
$ build/dijkstra_counts ../../data/mapas/miraflores.txt ../../data/mapas/lima-sur.txt ../../data/mapas/lima.txt
    nodos   aristas  sacados  aristas leidas  entradas  viejas  heap maximo      ms  ns/((V+E)log V)
     2242      3474     2242            6948      2562     320           71   0.045             0.71
    19560     29117    19560           58234     22572    3012          201   1.759             2.54
    79050    116803    79050          233606     91604   12554          594   9.061             2.84
Los mapas son datos de © colaboradores de OpenStreetMap. Primero lo exacto, que las pruebas comprueban:
sacadoses V, yaristas leidases 2E, en los tres mapas. Eso es lo que predice el análisis.entradasqueda muy por debajo de 2E + 1. Enlima.txtson 91 604, frente a un máximo de 233 607: la mayoría de las aristas leídas no mejora nada.- Las entradas viejas son pocas: 12 554, un 14 % de las entradas. Ese era el precio de no actualizar.
heap maximoes 594, con 79 050 nodos. En ningún momento hubo más de 594 entradas en el heap. Probablemente es porque un mapa es casi plano, y lo pendiente es solo el borde de la onda.
Esa última cifra es una propiedad de los mapas, no del algoritmo. El análisis solo dice que el heap no pasa de 2E + 1.
Ahora los tiempos. En todas las corridas que hice, los nanosegundos por unidad de (V + E) log V subieron: unos 0.7-0.8 en
Miraflores, 2.3-2.6 en el mapa mediano y 2.7-3.0 en el grande. La fórmula es una cota, y no predice esa diferencia, igual que
BFS en la semana 14. Probablemente sea la cache: un mapa grande no cabe en ella, y cada lista es un bloque aparte. No tenemos
perf en este entorno para confirmarlo, así que queda como explicación probable.
Sin heap
Quiten el heap: en cada vuelta, recorran todo el arreglo buscando el nodo sin sacar con menor distancia.
algoritmo dijkstra_sin_heap(grafo, origen)
    distancia[v] ← infinito para todo nodo v
    sacado[v] ← falso para todo nodo v
    distancia[origen] ← 0
    mientras haya un nodo sin sacar con distancia finita hacer
        u ← el nodo sin sacar con menor distancia, recorriendo todo el arreglo
        sacado[u] ← verdadero
        para cada arista (u, v, w) de la lista de u hacer
            relajar(u, v, w)
        fin para
    fin mientras
fin algoritmo
No hay entradas viejas, porque no hay entradas. Se hacen como máximo V vueltas, con V lecturas cada una, y además se relaja cada arista: en total Θ(V² + E) si se alcanza todo el grafo. Como E < V², eso es Θ(V²).
Compárenlo con los mapas:
| Mapa | V² | 2E + 1, máximo de entradas | Entradas de verdad |
|---|---|---|---|
miraflores.txt |
5 026 564 | 6 949 | 2 562 |
lima-sur.txt |
382 593 600 | 58 235 | 22 572 |
lima.txt |
6 248 902 500 | 233 607 | 91 604 |
En un grafo disperso, el heap gana de lejos. No es que el heap sea siempre mejor: si el grafo es denso, con E cerca
de V², entonces (V + E) log V se acerca a V² log V, y esa cota ya es mayor que V². Ahí la versión sin heap puede ser la
buena elección, y además no necesita ninguna estructura. Lo medirán en el laboratorio, con tiempos, y con su propio heap
al lado de std::priority_queue.
Idea clave. El heap gana cuando la cantidad de aristas es mucho menor que V². Como en la semana 14, lo que manda es la relación entre E y V².
Rutas largas, y lo que dicen
Un ejemplo sobre el mapa completo, del Jirón de la Unión a la Avenida José Larco, del centro de Lima a Miraflores:
$ build/route_demo ../../data/mapas/lima.txt ../../data/mapas/lima-calles.tsv "Jirón de la Unión" "Avenida José Larco"
de Jirón de la Unión (nodo 52639) a Avenida José Larco (nodo 401)
linea recta: 8970 metros
BFS:      109 aristas, 9970 metros
Dijkstra: 121 aristas, 9253 metros
ruta sobre linea recta: 1.03
Las coordenadas de esos dos nodos están donde tienen que estar, en -12.05 y -12.13 de latitud, casi sobre el mismo meridiano. Unos 9 km en línea recta, y 9.25 km por calles. Datos de © colaboradores de OpenStreetMap. Como el mapa ignora el sentido de circulación, un carro quizá no podría seguir toda esa ruta.
Conviene decir qué significa ese resultado, y qué no:
- Es el mínimo del grafo, no de la ciudad. Si una calle falta en OpenStreetMap, no existe para Dijkstra.
- Mide metros, no tiempo. Con minutos como peso, sería otra ruta. El algoritmo no cambiaría.
- Sentido de circulación. Para respetarlo, bastaría con un grafo dirigido:
Graph(n, true)ya lo permite, y Dijkstra no cambia. Lo que falta es ese dato en nuestros archivos. *-calles.tsvda un nodo por nombre. Una avenida larga tiene muchos nodos, y este es solo uno de ellos. Por eso “la distancia entre dos calles” aquí quiere decir “la distancia entre esos dos nodos”.
Cómo se prueba un Dijkstra
Mirar una ruta y decir “se ve bien” no es una prueba. Ya vimos un error que falla en 2 de 200 orígenes. ¿Contra qué se compara, si la biblioteca no trae grafos? Hay tres revisiones, y usan cosas que no dependen de lo que se quiere probar.
Un cálculo por fuerza bruta. Relajar todas las aristas, una y otra vez, hasta que nada cambie. Es lento, y es tan corto que se puede revisar leyéndolo:
std::vector<Meters> brute_force(const Graph& graph, int source) {
    std::vector<Meters> distance(graph.node_count(), UNREACHABLE);
    distance[source] = 0;
    bool changed = true;
    while (changed) {
        changed = false;
        for (int u = 0; u < graph.node_count(); u++) {
            if (distance[u] == UNREACHABLE) {
                continue;
            }
            for (const Edge& edge : graph.neighbors(u)) {
                if (distance[u] + edge.weight < distance[edge.to]) {
                    distance[edge.to] = distance[u] + edge.weight;
                    changed = true;
                }
            }
        }
    }
    return distance;
}
Se corre sobre cientos de grafos chicos al azar, con semilla fija: dirigidos y no dirigidos, con partes separadas, con empates y con pesos 0.
Que cada padre explique a su hijo. Para todo nodo alcanzado v con padre p, tiene que existir la arista p → v con
distancia[p] + w = distancia[v]. Con eso, la ruta es real, y su peso es el que se dijo. Esta revisión no depende del
orden de los empates.
Contar. En una corrida completa sobre un grafo no dirigido conexo, salen V nodos, se leen 2E entradas, y entradas
= sacados + viejas, porque toda entrada sale una vez. Si se olvidan de ignorar las viejas, la cuenta de aristas
leídas se pasa. Ninguna de estas cuentas mira el reloj.
Las tres están en el laboratorio. Además, las rutas sobre el mapa se revisan contra BFS, con dos desigualdades que siempre se cumplen: Dijkstra nunca da más metros que BFS, y BFS nunca da más aristas que Dijkstra.
✂️ Tries
Esta sección y la siguiente son material opcional: se ven si hay tiempo, y corresponden al paso 6, opcional, del laboratorio. Las soluciones de ese paso no se distribuyen, así que las salidas de esta sección son de la solución del docente.
En la semana 6 hicieron autocompletado con un arreglo ordenado: dos búsquedas binarias dan el rango de términos que empiezan con un prefijo. Hay otra forma de hacerlo, que usa el prefijo para organizar los datos.
Definición. Un trie es un árbol en el que cada nodo representa un prefijo, y cada arista agrega un carácter. Las claves con un mismo prefijo comparten el camino hasta él. El nodo donde termina una clave lleva una marca.
El nombre viene de retrieval, y se pronuncia como try. Con las claves ca, cazo, caña y dos, escritas por
caracteres:
    (raíz)
     /  \
    c    d
    |    |
    a*   o
   / \   |
  z   ñ  s*
  |   |
  o*  a*
Un * indica que ahí termina una clave. Noten que ca es a la vez una clave y el prefijo de otras dos. En un
diccionario común, ese nodo no sería especial.
algoritmo insertar(clave, valor)
    nodo ← raíz
    para i desde 0 hasta largo(clave) - 1 hacer
        si nodo no tiene hijo para clave[i] entonces
            crear ese hijo
        fin si
        nodo ← hijo de nodo para clave[i]
    fin para
    valor del nodo ← valor
fin algoritmo

algoritmo con_prefijo(prefijo)
    nodo ← raíz
    para i desde 0 hasta largo(prefijo) - 1 hacer
        si nodo no tiene hijo para prefijo[i] entonces
            devolver nada
        fin si
        nodo ← hijo de nodo para prefijo[i]
    fin para
    devolver todas las claves del subárbol de nodo
fin algoritmo| Arreglo ordenado (semana 6) | Trie | |
|---|---|---|
| Buscar una clave de m bytes | O(m log n) con búsqueda binaria | O(m): baja m niveles, sin importar n |
| Rango de un prefijo | O(m log n) para ubicarlo | O(m) para llegar a su subárbol |
| Insertar | Θ(n) en el peor caso, por correr elementos | O(m) |
| Memoria | Las claves, seguidas | Un nodo por cada prefijo distinto |
La O(m) del trie supone que elegir un hijo cuesta una constante. Se cumple con un arreglo de 256 hijos, y también con un
std::map por nodo, que tiene como máximo 256 claves. Lo malo del trie es la última fila. Un arreglo de 256 hijos de 4
bytes ocupa 1 KB por nodo, tenga los hijos que tenga. trie_sizes cuenta los nodos de tres listas: las calles de
Lima, los términos de los libros y todas las palabras:
$ build/solution/trie_sizes ../../data/mapas/lima-calles.tsv ../../data/terminos.tsv ../../data/palabras.txt
    claves   bytes de claves      nodos  nodos/byte  con 256 hijos, MB
     11197            197117      88288        0.45              90.41
     28039            229806      76324        0.33              78.16
   1045757          11897295    1884236        0.16            1929.46
Los nombres de calles son datos de © colaboradores de OpenStreetMap. Lean la columna nodos/byte. Baja de 0.45 a 0.16 a
medida que crecen las claves y comparten más prefijos, aunque casi 2 millones de nodos con 256 hijos serían 1.9 GB, para
12 MB de texto. Por eso un trie real no usa un arreglo de 256: usa algo más compacto por nodo, como el std::map del
laboratorio, a costa de más tiempo por byte.
El trie también trabaja con bytes, como el autocompletado de la semana 6, y hereda sus límites. Una letra con tilde
son dos bytes y dos niveles, y ca no ofrece cámara, que está en otra rama. Sus claves salen en orden de bytes: á
va después de z. En el laboratorio lo usan para buscar calles:
$ build/solution/places ../../data/mapas/lima-sur-calles.tsv "Avenida José" 5
15 lugares empiezan con "Avenida José"
  15708  Avenida José Antonio Encinas
  3082  Avenida José Balta
  1691  Avenida José Gálvez
  6550  Avenida José Gálvez Barrenechea
  175  Avenida José Larco
Esos nombres son también de © colaboradores de OpenStreetMap.
En la biblioteca. La biblioteca estándar de C++ no trae un trie. Si tienen pocas inserciones, un
std::vectorordenado constd::lower_boundsuele alcanzar, como en la semana 6, y ocupa mucho menos. El trie vale la pena cuando las inserciones van llegando, o cuando la operación principal es caminar por prefijos.
✂️ Filtros de Bloom
A veces no hace falta guardar las claves: solo interesa una pregunta, “¿está?”, y se acepta un error de vez en cuando, a cambio de muy poca memoria.
Definición. Un filtro de Bloom (Bloom filter) es un arreglo de m bits, todos en 0 al principio, y k funciones hash.
- Agregar una clave: se calculan sus k posiciones, y se encienden esos k bits.
- Preguntar por una clave: se calculan sus k posiciones. Si alguna está apagada, la clave no está. Si todas están encendidas, la clave quizás está.
Con 12 bits, k = 2, y posiciones de ejemplo hechas a mano, no calculadas:
                     0 1 2 3 4 5 6 7 8 9 10 11
al inicio            0 0 0 0 0 0 0 0 0 0  0  0
agregar lima (2, 9)  0 0 1 0 0 0 0 0 0 1  0  0
agregar puno (5, 9)  0 0 1 0 0 1 0 0 0 1  0  0
¿cusco? (3, 9)       el bit 3 está apagado: no está, seguro
¿tacna? (2, 5)       los dos encendidos: quizás está... y no se agregó
Lo que dice la última fila es un falso positivo (false positive): responde que quizás, por bits que encendieron otras claves. Lo contrario no puede pasar.
¿Por qué nunca dice “no está” para una clave que sí se agregó? Las funciones hash dan siempre lo mismo para la misma clave, y al agregarla se encendieron esas k posiciones. Ningún bit se apaga jamás. Entonces, al preguntar, esas k posiciones siguen encendidas, y la respuesta tiene que ser “quizás”. Por eso mismo un filtro de Bloom común no puede borrar: apagar un bit podría apagar uno que otra clave también usa, y esa clave daría un falso negativo.
Error común. Decir que un filtro de Bloom “comprueba que la palabra está”. Lo seguro es el no. Un sí es solo un quizás.
No guarda ninguna clave, así que no se puede listar lo que tiene, ni saber cuántas veces se agregó algo. Su tasa de falsos positivos depende de cuántos bits hay por clave y de k. Para analizarla hace falta probabilidad, que no es de este curso. Así que la vamos a medir.
El experimento es limpio: palabras.txt no tiene palabras repetidas. Se agrega una línea de cada dos, y se pregunta por
las otras. Esas no se agregaron, así que todo sí es un falso positivo, y como FNV-1a es fijo, el conteo es exacto y
se repite:
$ build/solution/bloom_measure ../../data/palabras.txt
agregadas: 522879, preguntadas: 522878
bits por clave   k      MB  positivos     tasa  bits encendidos
             2   1    0.13     205473   39.297 %            39.3 %
             2   4    0.13     292392   55.920 %            86.5 %
             4   1    0.26     115803   22.147 %            22.1 %
             4   4    0.26      83442   15.958 %            63.2 %
             8   1    0.52      61448   11.752 %            11.7 %
             8   4    0.52      12627    2.415 %            39.4 %
            10   1    0.65      49683    9.502 %             9.5 %
            10   4    0.65       6148    1.176 %            33.0 %
            16   1    1.05      31774    6.077 %             6.1 %
            16   4    1.05       1300    0.249 %            22.1 %
con 10 bits por clave, cambiando k:
            10   1    0.65      49683    9.502 %             9.5 %
            10   2    0.65      17104    3.271 %            18.1 %
            10   3    0.65       9132    1.746 %            25.9 %
            10   5    0.65       4944    0.946 %            39.3 %
            10   7    0.65       4325    0.827 %            50.3 %
            10  10    0.65       5332    1.020 %            63.2 %
            10  15    0.65      11804    2.258 %            77.7 %
            10  25    0.65      61328   11.729 %            91.8 %
Qué dice la tabla:
- Más bits por clave, menos falsos positivos. Con k = 4, pasar de 4 a 16 bits por clave baja la tasa de 16 % a 0.25 %.
- k tiene un punto medio. Con 10 bits por clave, la tasa baja de 9.5 % con k = 1, a 0.83 % con k = 7, y vuelve a subir, hasta 11.7 % con k = 25. Con pocos hash, dos claves coinciden fácil. Con muchos, se encienden casi todos los bits: la última columna llega a 91.8 %.
- Con muy pocos bits, más hash empeora. Con 2 bits por clave, k = 4 da 55.9 % y k = 1 da 39.3 %, porque el arreglo se llena: 86.5 % de bits encendidos.
- Sale barato. Con 10 bits por clave y k = 7, 522 879 palabras caben en 0.65 MB, con 0.83 % de error. Solo el texto de esas palabras ocupa unos 6 MB.
Estas k funciones no son k funciones de verdad. De un solo FNV-1a de 64 bits salen dos números, h1 de la mitad baja y h2 de la mitad alta, y la posición i es (h1 + i · h2) mod m. A h2 se le fuerza a impar para que, con un m par como los de esta tabla, nunca sea múltiplo de m, porque entonces todas las posiciones serían la misma. La tabla muestra que en estos datos funciona. No demuestra que funcione siempre.
Se usa delante de una búsqueda cara: si el filtro dice que no, no se busca, y si dice que quizás, se busca de verdad. Los falsos positivos solo cuestan una búsqueda de más, y nunca dan una respuesta equivocada.
Repaso: elegir una estructura
Este curso les dio una caja de herramientas. La pregunta del final no es cómo funciona cada una: es cuál sacar. La regla es la misma de toda la materia: primero escriban qué operaciones necesita el problema, y cuáles son las más frecuentes. Después elijan.
| Si necesitan… | Usen… | Costo | Semana |
|---|---|---|---|
| Agregar al final y leer por índice | Arreglo dinámico, std::vector |
Agregar O(1) amortizado, leer Θ(1) | 4 |
| Último en entrar, primero en salir | Pila | O(1) amortizado | 2 y 4 |
| Primero en entrar, primero en salir | Cola o deque, con buffer circular | O(1) amortizado | 4 y 5 |
| Insertar en medio, con el lugar a la mano | Lista enlazada | Θ(1) con iterador; mala localidad | 5 |
| Buscar en datos fijos, ordenados | Arreglo ordenado y búsqueda binaria | O(log n), y poca memoria | 6 |
| Diccionario, sin orden | Tabla hash, std::unordered_map |
O(1) esperado; al insertar, amortizado por el crecimiento | 7 y 9 |
| Diccionario con orden: rangos, sucesor | Árbol balanceado, std::map |
O(log n) en el peor caso | 10 a 12 |
| El menor o el mayor, una y otra vez | Heap, std::priority_queue |
O(log n) por operación | 13 |
| Conexiones y caminos | Grafo, con listas de adyacencia | Θ(V + E) un recorrido | 14 |
| ¿Están conectados?, con aristas que llegan | Union-find | O(α(n)) amortizado | 14 |
| Rutas con pesos no negativos | Dijkstra | O((V + E) log V) | 15 |
Cuatro casos, como los de un examen:
Las 10 palabras más frecuentes de un texto. Tiene dos partes. Primero contar, con una tabla hash: cada palabra
se suma en O(1) esperado, y no hace falta ningún orden. Después quedarse con las 10 mayores: un heap de tamaño 10,
como top_k de la semana 13. Cuesta O(d log 10) con d palabras distintas, en vez de ordenarlas todas en O(d log d).
Todas las claves entre dos valores. Aquí importa el orden, así que una tabla hash no sirve: tendría que revisarlo
todo. Si las claves cambian, un árbol balanceado, std::map: lower_bound encuentra el inicio en O(log n), y se avanza
con el iterador por las k que correspondan. Si son fijas, un arreglo ordenado hace lo mismo, con menos memoria.
Saber si una palabra está en un diccionario fijo. Una tabla hash, con O(1) esperado. Un arreglo ordenado también sirve, con O(log n) y menos memoria, porque no hay inserciones. Un filtro de Bloom por sí solo no sirve, porque un sí no es seguro: si quieren usarlo, va delante de una de las otras dos, y la respuesta final la da esa.
Un historial con deshacer. Una pila: lo último que se hizo es lo primero que se deshace. Basta std::vector con
push_back y pop_back. Si además hay “rehacer”, son dos pilas.
Cuando dudan entre dos, estas preguntas casi siempre deciden:
- ¿Importa el orden? Rangos, sucesor o “el menor” descartan una tabla hash.
- ¿Los datos cambian, o son fijos? Si son fijos, un arreglo ordenado suele ganar en memoria, y en que no se manejan punteros.
- ¿Cuál operación es la frecuente? Las listas de adyacencia ganan si casi todo es recorrer vecinos, y una matriz si
casi todo es
has_edge. - ¿Cuántos datos hay? Con pocos datos, un arreglo suele ser suficiente. La semana 5 lo mostró: las constantes y la cache también cuentan.
- ¿Me sirve un costo amortizado o esperado? Depende de si una operación lenta de vez en cuando es aceptable.
Esa última pregunta exige leer bien lo que promete cada costo:
| Promesa | Qué dice | Ejemplos |
|---|---|---|
| Peor caso | Vale para cada operación | push y pop de un heap, y find de un AVL, O(log n) |
| Amortizado | Vale para la suma de una secuencia. Una sola puede ser cara. No tiene nada de azar | push_back, O(1) amortizado y Θ(n) una sola vez; union-find |
| Esperado | Depende de que el hash reparta bien o del azar de un algoritmo. El peor caso es peor | Buscar en una tabla hash: O(1) esperado, y Θ(n) en el peor caso |
No es lo mismo. Decir “en promedio” para el push_back es un error, y lo es también decir “O(1)” para union-find, a
secas.
Noten dos cosas de estas respuestas. La primera: algunos problemas necesitan dos estructuras, y Dijkstra necesita cinco. La segunda: “la mejor” depende de lo que el enunciado deja fijo. Una justificación tiene que nombrar la operación que decide. “Porque es O(log n)” no es una justificación. “Porque necesito rangos, y una tabla hash no los da” sí lo es.
El examen final es en la semana 16: cubre todo el curso, con énfasis en las semanas 9 a 15, y
exams/README.md dice cómo prepararlo. El curso de Algoritmos sigue desde aquí: ahí demostrarán
por qué Dijkstra es correcto, y verán lo que ya no cabe en este curso.
El código de la semana
En code/week-15:
| Archivo | Qué contiene |
|---|---|
graph.h, traversals.h |
El grafo y BFS de la semana 14 |
map_file.h |
Lee un mapa y un archivo de calles, y calcula la línea recta |
shortest_paths.h |
Dijkstra con std::priority_queue, con sus conteos |
sample_graphs.h |
El grafo de la clase con pesos, y el contraejemplo |
dijkstra_trace.cpp, route_demo.cpp |
Dijkstra paso a paso, y una ruta sobre un mapa |
distance_range.cpp, dijkstra_counts.cpp, bench.h |
¿Alcanza un int?, y el trabajo sobre los tres mapas |
test_structures.cpp |
Pruebas contra un cálculo por fuerza bruta, y contra BFS |
errors/ |
Los programas con errores a propósito de este capítulo |
lab/ |
Lo que deben completar en el laboratorio, con sus pruebas públicas |
make compila; make test lo comprueba todo, y eso incluye volver a correr los comandos de este capítulo, salvo los
que usan la solución del docente. Las mediciones no se comparan, porque dependen de la máquina. Lo que se compara son
conteos.
El laboratorio
Empiezan copiando su heap. lab/min_heap.h es solo un lugar para el suyo: compila, pero detiene el programa hasta que
lo reemplacen.
cp ../week-13/lab/min_heap.h lab/min_heap.h
make test-heap| Sesión | Paso | Qué escriben | Dónde | Tiempo estimado |
|---|---|---|---|---|
| 1 | Antes | Copiar su MinHeap, y comprobarlo |
lab/min_heap.h |
10 min |
| 1 | 1 | build_map_graph |
lab/routes.h |
15 min |
| 1 | 2 | dijkstra con su MinHeap, y route_to |
lab/routes.h |
60 min |
| 1 | 3 | route_meters, comparar con BFS y responder |
lab/routes.h, lab/report.md |
35 min |
| 2 | 4 | dijkstra_to, medir el ahorro y responder |
lab/routes.h, lab/report.md |
40 min |
| 2 | 5 | dijkstra_priority_queue, dijkstra_array, medir y responder |
lab/routes.h, lab/report.md |
80 min |
| Extra | 6 | Opcional: PlaceTrie o BloomFilter |
lab/trie.h, lab/bloom.h |
Fuera de las 4 horas |
make lab             # compila el laboratorio
make test-heap       # su MinHeap de la semana 13
make test-map        # paso 1
make test-dijkstra   # paso 2
make test-routes     # paso 3
make compare         # paso 3: la tabla para su informe
make test-stop       # paso 4
make savings         # paso 4: la tabla para su informe
make test-queues     # paso 5
make measure         # paso 5: la tabla para su informe, con -O2
make test-lab        # pasos 1 a 5
make test-trie       # paso 6, si eligen el trie
make trie-sizes      # paso 6, si eligen el trie
make test-bloom      # paso 6, si eligen el filtro
make measure-bloom   # paso 6, si eligen el filtro
Algunas cosas que conviene saber antes de empezar:
- Vienen hechos
Graph,bfsypath_tode la semana 14, y la lectura de los archivos enlab/map_file.h. Esa lectura solo les da los nodos y los tramos: armar las listas de adyacencia es el paso 1. Tampoco tienen que escribir los programas que sacan las tablas. - No se puede cambiar
DijkstraCounts. Las pruebas leensettled,pushes,stale,edges_readyscanned. Una corrida completa sobre un mapa tiene que leer 2E aristas. - Usen
HeapEntry, y no un heap de nodos. Ya vieron por qué. - Las pruebas no miran el orden de los empates, salvo en grafos sin empates. Comparan distancias con un cálculo por fuerza bruta, y revisan que cada padre explique la distancia de su hijo.
- En
dijkstra_array, recuerdenUNREACHABLE. Si el grafo tiene partes separadas, llega una vuelta en que todos los nodos sin sacar valen infinito. Sumarle algo a ese valor es overflow, y una prueba lo revisa con sanitizers. Hay que detenerse antes. make measureno corre el arreglo sobrelima.txt. Serían unas 6250 millones de lecturas en cada corrida, y no vale la pena repetirlas varias veces. Sí corre sus dos heaps sobre los tres mapas.- Con el paso 3, revisen la línea recta, y lean las notas del sentido de circulación antes de sacar conclusiones.
Resumen
- Con pesos, BFS no alcanza: el camino con menos aristas puede no ser el más corto. En Miraflores, 25 aristas y 1512 metros le ganan a 18 aristas y 1871 metros.
- Relajar es preguntar si pasar por u mejora la ruta a v. Cada distancia finita es el peso de una ruta real.
- Dijkstra saca el nodo con la menor distancia conocida y relaja sus aristas: listas de adyacencia, un heap y arreglos, cada uno en lo suyo.
- Las entradas viejas se ignoran al sacarlas. Es más simple que actualizar, porque un heap no sabe dónde está un
nodo. En
lima.txtson el 14 % de las entradas. - Se detiene al sacar el destino, no al meterlo. Al meterlo, solo se conoce una ruta, y por eso la frase de BFS no vale aquí.
- Requiere pesos no negativos. Con una arista negativa no hay garantía: hay contraejemplos, y con un ciclo negativo el algoritmo sin marca no termina.
- Cuesta O((V + E) log V): V nodos sacados, hasta 2E relajaciones, y log V por operación de heap. Sin heap, Θ(V²), que puede convenir en grafos densos.
- En estos mapas un
intno hace overflow: la suma de todas las aristas delima.txtes 8 540 931. Se usan 64 bits, porqueGraphadmite cualquier peso. - Las rutas son mínimas en el grafo. Los mapas son de © colaboradores de OpenStreetMap, e ignoran el sentido de circulación.
- ✂️ Un trie organiza las claves por prefijos: O(m) para buscar, y mucha memoria por nodo.
- ✂️ Un filtro de Bloom responde “no está” con seguridad, y “quizás” con un error que depende de bits por clave y de k. Nunca da falsos negativos, porque ningún bit se apaga.
- Para elegir una estructura, primero escriban las operaciones. Después la justificación nombra la operación que decide.
Ejercicios
- Elijan un grafo de 6 nodos y 8 aristas con pesos distintos. Corran Dijkstra a mano desde un nodo, y escriban el heap
y las distancias en cada paso, como en
dijkstra_trace. Luego comprueben sus respuestas cambiandoweighted_class_graph. - En el grafo de la clase, agreguen la arista 1-5 con peso 3. ¿Qué filas de la tabla cambian? ¿Cuántas entradas viejas quedan? Háganlo primero a mano.
- Den un grafo dirigido con una arista negativa, distinto del de estos apuntes, en el que
dijkstradé una distancia incorrecta. Comprueben conerrors/negative_edge.cpp. ¿Por qué no sirve sumar a todas las aristas una constante, para dejarlas positivas? Busquen un grafo pequeño donde eso cambie la ruta mínima. - ¿De dónde sale cada factor de O((V + E) log V)? Después, calculen con esa fórmula cuántas operaciones de heap se
esperan en
lima-sur.txt, en el peor caso, y compárenlas con los conteos dedijkstra_counts. - Modifiquen
dijkstrapara que cuente cuántas veces mejora la distancia de un nodo. ¿Cuál es el máximo de mejoras sobre un mismo nodo en cada mapa? ¿Qué tiene que ver con el grado máximo? - Hagan una variante de
errors/stop_at_push.cpppara ver cómo cambia la tasa de error con la distancia entre los dos nodos. Ordenen los 1000 pares en cuatro grupos según su distancia verdadera. ¿Dónde se equivoca más? Antes de concluir, repitan enlima-sur.txt. - Corran
dijkstraen un grafo denso, de 2000 nodos, con todas las aristas posibles y pesos al azar. Compárenlo, con sudijkstra_array, en tiempo y en entradas al heap. ¿Quién gana? Prueben después con el 1 % de las aristas. ¿Cerca de qué densidad se cruzan, en su máquina? - Hagan que las calles de un sentido sean posibles: creen
Graph(n, true)y un mapa de 5 nodos con dos aristas de un solo sentido. ¿Puede cambiar la distancia si se invierten el origen y el destino? Muestren un ejemplo. ¿Cómo sería el arreglo si guardáramos el sentido endata/mapas/? - Cambien los pesos de
route_demoa minutos: usen 20 km/h en una cuadra de menos de 100 metros y 40 km/h en las demás. ¿Cambia la ruta entre Malecón de la Reserva y Avenida Arequipa? ¿Qué parte de Dijkstra hubo que modificar? ¿Conviene seguir con enteros? - Escriban
count_with_prefixen suPlaceTrie, en O(m), guardando un contador en cada nodo. ¿Qué cambia eninsert, si el nombre ya estaba? ✂️ - Con su
BloomFilter, midan cómo cambia la tasa si dejan fijos 10 bits por clave y k = 7, y agregan 2, 4 y 8 veces menos palabras de lo planeado, o el doble. ¿Qué dice esto sobre calcular el tamaño del filtro antes de llenarlo? ✂️ - Para cada problema, elijan una estructura, y digan cuál operación decide: atender pacientes por prioridad en una emergencia; decidir si dos usuarios pertenecen al mismo grupo cuando los grupos solo se juntan; la lista de reproducción de un celular, con siguiente y anterior; guardar 10 000 precios y consultar cuántos están entre dos valores, si casi nunca cambian. Alguno admite más de una respuesta válida: digan cuál, y qué las separa.